TCP Flow control
send buffer가 receive buffer가 받을 수 있는 data 양만큼 (=available space) 보내는 것을 flow control이라고 부른다. 따라서 receiver에서 다시 보낼때 available space를 header에 담아서 보내준다.
TCP flow control은 1)데이터를 보내는 양, 2)데이터를 보내는 속도 모두와 관련이 있다.
즉, sender 측은 receiver에서 header에 receive buffer 값을 두어 available space에 관한 정보를 sender에게 보내면서 알 수 있다. 따라서 sender는 계속 receiver에 데이터를 보낼때만 알 수 있다.
flow control은 중요한 기능이지만 receiver가 돕기때문에 구현은 단순하다.
TCP 3-way handshake
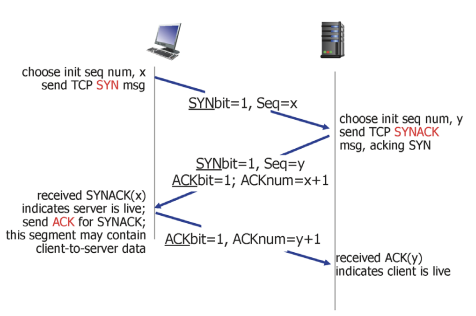
1) client -> server : connection을 열고 싶다고 요청을 보낸다.
connection을 요청할때만 SYN이라는 헤더에서 SYNbit=1이고 seq#=x 라고 상대에게 알린다.
2) server -> client : connection에 대한 응답을 보낸다.
SYN에대한 ACK를 보내주는데 여기서 사용되는게 ACKbit=1, ACK# 은 seq#에 1을 더한 x+1이 되어 client에게 보낸다.
3) client -> server : connection이 생성된 후 데이터 전송
이제 connection이 됐으므로 SYNbit=0이고 데이터 전송에 대한 ACK를 보낸다.
왜? 굳이 3-way handshake를 할까?
(가정) 2-way handshake이라고 한다면?
i) client 입장
server로부터 확실한 응답을 받았다.
ii) server 입장
예를 들면 '야호-' 를 했는데 client가 잘 받았는지에 대한 응답을 받지 못한 것이다.
실제로 3번째 응답이 오기전까지 server입장에서는 buffer를 만들지 않는다.
TCP connection을 닫으려면?
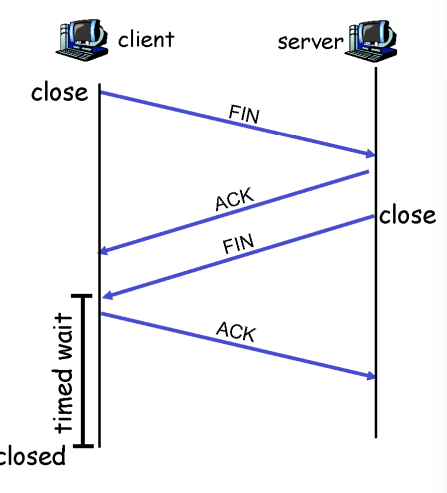
connection을 닫으려면
: client 가 소켓을 닫으면 된다.
clientSocket.close()로 하면 되는데 이 부분도 server와의 응답이 필요하다.
step 1: client가 TCP FIN bit가 있는 segment를 server에게 보낸다.
setp 2: server는 잘 받으면 ACK로 응답하고 server도 connection을 close하기 위한 FIN을 보낸다.
step 3: client도 server에 대한 FIN을 잘 받으면 ACK로 응답한다.
time wait이라는 시간동안에는 client와 server각각의 buffer를 지우지 말고 기다리라는 권고사항이 있다. 왜냐하면 마지막에 보이는 ACK가 유실됐는데 모두 철수해버리면 server는 client 가 제대로 받았는지 알 수가 없기 때문이다.
setp 4: client로부터 ACK를 제대로 전달받으면 server는 connection을 닫는다.
timeout value는 고정된 값이다.
congestion control 간단 요약
TCP에서 가장 중요한 특징 3가지는 다음과 같다.
1) reliable data transfer
2) flow control
보내는 속도와 양은 사실상 다음의 2부분에 의해 좌우된다. i) receiver의 available space 와 ii) 중간 전달자 network의 용량 이렇게 있는데 sender에서의 보내는 양은 Min(network, receiver) 에 맞춰서 보내야 한다.
Q1) network의 상태는 알 수 있나? -> yes (by congestion control mechanism)
Q2) receiver의 상태는 알 수 있나? -> yes (by glow control mechanism)
3) congestion control
TCP는 network가 막히면 모두 망하기 때문에 network가 안막히게 하려면 1) data를 마구잡이로 보내지 않는다 2) data를 보내는 속도를 줄인다 두가지 방법이 있다. 즉 TCP는 network의 상황에 맞춰 유동적으로 데이터를 전송한다.
TCP intuition
앞선 방식으로 동작하기 위해서 TCP는 어떠한 방식을 취하는지?
-> receiver로부터의 feedback을 얻는다.
'pipe가 얇은' network의 상태는 알 수 없으나 end2end 에 대한 상태는 알 수 있다.
TCP의 3가지 단계
step 1. slow start
step 2. additive increase
초반에는 exponential하게 증가하다가 어느 지점 (threshold) 부터는 조심하며 linear 하게 증가한다. 어느 순간부터 packet loss가 감지되면 step 3를 진행한다.
step 3. multiplicative decrease
변화하는 단위는 mms이다.
TCP congestion control
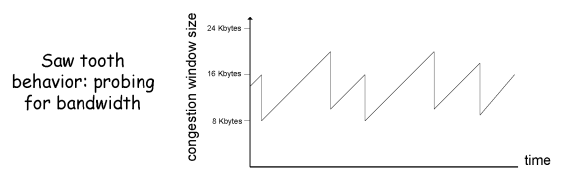
가로축: time
세로축: congestion window size (= CongWin)
step 1. 매 RTT 마다 CongWin을 1MSS 만큼 증가시킨다.
step 2. packet loss 가 감지되면 CongWin을 절반으로 감소시킨다.
데이터 전송속도는 대략적으로 다음과 같다.
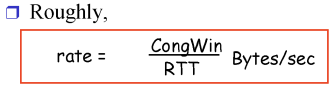
RTT라는 시간동안 CongWin만큼 지나간다.
실제로 변동이 심한 변수는 RTT < CongWin으로 전송속도는 CongWin에 의해 좌우된다.
(여기서의 CongWin은 서로의 참여여부에 따라 달라진다)
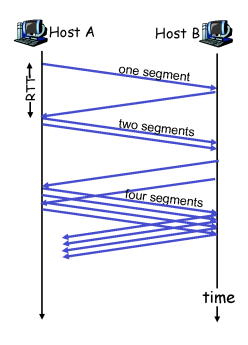
TCP: slow start
- segment크기는 mss
- 실제로는 slow하지 않고 굉장히 빠르게 증가한다.
TCP Tahoe vs TCP Reno
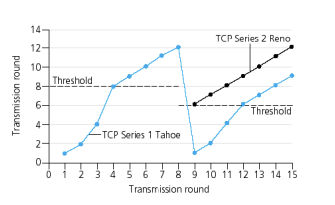
x축: transmission round
y축: congestion window size (그림에 있는 변수설정이 잘못됐음)
- TCP tahoe 버전)
packet 유실이 탐지되면
1) threhold = 1/2 * (packet loss가 발생한 경우의 window size)
2) threshold 이후는 linear increase가 된다. - TCP reno 버전)
packet 유실을 탐지하는 방법은 1) timeout 과 2) 3duplicated ACK 이다.
그러나 network 입장에서는
1) timeout -> 해당 packet 뿐만 아니라 다른 packet들 모두 전송되지 않는 상황이므로 network가 훨씬 안좋은 상황이다.
2) 3duplicated ACK -> 모두 잘가는데 특정 ACK에만 문제가 있는 경우 network는 잘 운영되는상태이다.
즉 2가지 상황에 대해 network의 대응책은 달라야 한다.
2) -> window size를 반으로 줄이고, linear 로 시작 (reno)
1) -> 아예 처음부터 시작한다. (tahoe)
Q. 제일 처음 threshold는 어떻게 잡는가?
A. 구현하는 사람 마음 (다른 tcp에서 가져와서 사용해도 될듯)
TCP 평등성
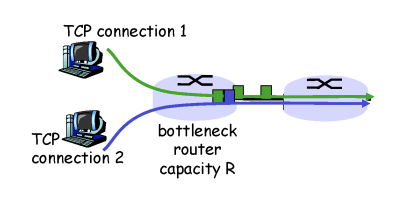
Q. TCP1과 TCP2는 독립적으로 congestion control을 진행하지만 R/2를 각각 사용하는가?
A. 맞다.
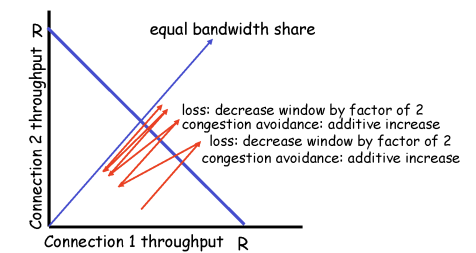
x축: connection 1의 R
y축: connection 2의 R
예를들어 처음에 (3/4R, k)라는 지점에 있다고 하자. 이때 둘의 합은 bandwidth를 넘지 않으므로 충분하다. 여기서 increase를 하다가 packet loss가 발생하면 그의 절반으로 줄어들고 이러한 방식을 반복하면 결국 equal bandwidth share에 근접하게 된다.
(맹점)
TCP connection을 더 많이 연 사람이 그만큼 R의 몫이 많을 것이다.