- 사용자 수준의 스레드와 커널 수준의 스레드의 차이는 무엇인가요?
커널 수준 스레드: 스레드를 생성하고 스케줄링하는 주체가 커널
장점 : 커널이 직접 제공해주므로 안정성과 다양한 기능 제공
단점 : 유저 모드에서 커널 모드로의 전환이 빈번함운영 체제 커널에 의해 직접 관리되며, 스레드 생성 및 관리에 대한 모든 작업이 운영 체제에서 처리됩니다. 사용자 프로그램은 스레드 생성 및 관리와 관련된 API를 사용하여 운영 체제에 요청합니다.
사용자 수준 스레드: 스레드 기능을 제공하는 라이브러리를 이용하므로 커널에 의존하지 않음
장점 : 커널이 스레드를 모르기때문에 모드 간의 전환이 없고 성능 이득 발생
단점 : 하나의 스레드가 커널에 블로킹되면 프로세스 전체가 블로킹됨스레드 간의 문맥 전환에 대한 오버헤드가 낮을 수 있지만, 동시성 문제를 해결하기 위한 추가적인 논리와 동기화 작업이 필요합니다.
성능:
사용자 수준 스레드는 프로그램이 직접 스레드를 관리하기 때문에 더 가벼운 스레드 관리 오버헤드를 가질 수 있으며, 특정 응용 프로그램에 맞게 최적화할 수 있습니다. 그러나 동시성 문제를 해결하기 위한 별도의 논리와 동기화 작업이 필요합니다.
커널 수준 스레드는 운영 체제에서 스레드를 관리하므로 시스템 리소스를 효율적으로 활용할 수 있지만, 스레드 간의 문맥 전환 오버헤드가 높을 수 있으며, 사용자의 프로그램 로직을 중단시켜야 할 때가 있습니다.
- 프로세스 스케줄러에는 어떤 것들이 있고, 각각은 어떤 역할을 하나요?
장기 스케줄러 : 어떤 프로세스를 ready queue에 보낼지, 시분할 시스템에서는 잘 안둠
단기 스케줄러 : 어떤 프로세스를 실행시킬지
중기 스케줄러 : 메모리에 공간이 부족한 경우 어떤 프로세스를 swap out할지
시분할 시스템은 컴퓨터 운영 체제(OS)의 일종으로, 다중 사용자 환경에서 각 사용자에게 공정한 시간을 할당하여 프로그램을 실행하는 시스템을 가리킵니다. 이 시스템은 다음과 같은 특징을 가집니다. 시분할 시스템에서는 주로 단기 스케줄러가 활용됩니다. 단기 스케줄러는 어떤 프로세스를 현재 CPU에 할당할지 결정하고, 빠른 프로세스 전환이 이루어집니다. 이로써 여러 프로세스가 동시에 실행되는 것처럼 느껴집니다.
이러한 시스템은 일반적으로 장기 스케줄러나 중기 스케줄러와는 별도로 구현됩니다. 장기 스케줄러는 프로세스를 선택하고 중기 스케줄러는 메모리 관리와 관련이 있지만, 시분할 시스템은 주로 단기 스케줄러를 강조합니다.
- IPC란 무엇이고, 어떠한 방식이 있는지 간단히 설명해주세요.
IPC는 Inter-Process Communication의 약자로 프로세스간 통신을 의미합니다. 프로세스는 커널이 제공하는 IPC 설비를 이용해 프로세스간 통신을 할 수 있습니다.
IPC설비의 종류는 여섯 가지가 있습니다.
첫번째는, PIPE (익명 파이프) 입니다. PIPE는 두 프로세스간 파이프를 연결해서 통신을 하는 방식입니다. 여기서 한 프로세스는 쓰기만 가능하고 다른 프로세스는 읽기만 가능하다는 특징이 있습니다. 한쪽 방향으로만 통신이 가능하기 때문에 반이중 통신이라고 부르기도 합니다. PIPE는 간단하게 사용할 수 있다는 장점이 있습니다.
두번째는, Named PIPE (FIFO) 입니다. PIPE는 통신하는 프로세스가 명확할 경우 사용하는 반면, Named PIPE는 전혀 모르는 사이의 프로세스들의 통신에 사용합니다. 익명 PIPE는 부모가 동일한 프로세스들 사이에서만 통신이 가능하지만 Named PIPE는 부모 프로세스에 상관없이 프로세스들 사이의 통신을 할 수 있다는 점이 특징입니다. 이는 프로세스 통신을 위해 mkfifo함수를 이용해 파일을 생성하기 때문에 가능합니다. 하지만, 익명 PIPE와 동일하게 동시에 읽기/쓰기가 불가능 합니다. 이는 두개의 파일을 읽기전용, 쓰기전용으로 만들어서 해결할 수 있습니다. 전이중 통신을 위해서는 두 개의 fifo 파일을 만들어서 사용해야 합니다.
세번째는, 메세지 큐 입니다. 메세지 큐는 선입선출의 형태로 통신이 이루어지는 점에서 Named PIPE와 동일합니다. 차이점은 Named PIPE가 데이터의 흐름이라면 메세지 큐는 메모리 공간이라는 점입니다. 이는 여러개의 프로세스가 메세지 큐의 데이터에 접근할 수 있음을 의미합니다.
네번째는, 공유메모리 입니다. 앞서 PIPE, Named PIPE, 메세지 큐가 통신을 이용해 데이터를 주고받는다면, 공유메모리는 프로세스간 메모리 영역을 공유해서 사용할 수 있도록 지원합니다. 프로세스가 공유 메모리 할당을 커널에 요청하면 커널은 해당 프로세스에 메모리 공간을 할당해줍니다. 이후 어떤 프로세스건 해당 메모리영역에 접근할 수 있습니다. 공유 메모리는 곧바로 메모리에 접근할 수 있기 때문에 IPC 방식 중 속도가 제일 빠릅니다.
다섯번째는, 메모리 맵 입니다. 메모리 맵은 공유 메모리와 메모리를 공유한다는 점은 동일합니다. 하지만, 현재 열려져 있는 파일을 공유하는 점에서 차이가 있습니다. 열린 파일이 메모리에 올라가있으면 다른 프로세스가 해당 파일을 사용할 때 또다시 파일을 열지않고 공유한 상태로 사용하는 것이 더 효율적입니다.
여섯번째는, 소켓입니다. 소켓은 소켓을 만들어 통신하는 방법입니다. 소켓 통신은 데이터 교환을 위해 양쪽 PC에서 각각 임의의 포트를 정하고 해당 포트 간의 대화를 통해 데이터를 주고받는 방식입니다. 이 때 각각 PC의 프로세스는 임의의 PORT를 맡아 데이터를 송수신 합니다.
- 자식 프로세스, 고아 프로세스, 좀비 프로세스에 대해 설명해보세요.
-
자식 프로세스 : fork로 자식프로세스를 만든 상태. 부모의 데이터,힙,스택, PCB 복사
Child process는 다른 프로세스, 일반적으로 부모 프로세스(Parent Process)에 의해 생성된 프로세스를 가리킵니다.
부모 프로세스는 자식 프로세스를 생성하고, 자식 프로세스는 독립적인 실행 흐름을 가지며 자신만의 작업을 수행할 수 있습니다.
Child process가 부모 프로세스로부터 생성되면, 부모와 자식 간의 통신 및 데이터 교환을 통해 협력적으로 작업을 수행할 수 있습니다.
자식 프로세스가 종료되면 종료 상태(exit status)를 반환하고, 이 상태는 부모 프로세스에게 전달됩니다. -
좀비 프로세스 : 프로세스가 종료됐는데 메모리상에 정보가 남아있는 상태, 부모가 wait로 보고받지 못함
Zombie process는 이미 종료된(child process) 프로세스의 상태 정보를 가지고 있는 프로세스를 나타냅니다.
자식 프로세스가 종료하면, 해당 프로세스의 자원을 회수하고 프로세스 테이블에서 정보를 제거하지만, 종료 상태(exit status)는 부모 프로세스에게 전달하기 위해 남겨둡니다.
부모 프로세스가 해당 종료 상태를 읽거나 처리하지 않는 경우, 종료 상태가 계속해서 시스템 리소스를 차지하고 있어 "좀비 프로세스"라고 불립니다.
좀비 프로세스는 메모리 등의 시스템 리소스를 무단으로 점유하는 문제를 일으킬 수 있으므로, 부모 프로세스는 종료 상태를 적절히 처리하여 좀비 프로세스를 완전히 제거해야 합니다. 이를 위해 wait() 또는 waitpid()와 같은 시스템 호출을 사용합니다.좀비 프로세스는 프로세스 관리의 중요한 측면 중 하나이며, 부모 프로세스가 종료 상태를 수집하지 않으면 시스템 리소스 누수 문제가 발생할 수 있으므로 주의가 필요합니다.
-
고아 프로세스 : 부모 프로세스가 먼저 종료돼서 부모 프로세스를 잃은 프로세스, init이 자식프로세스 회수함
init 프로세스는 시스템에서 실행 중인 모든 프로세스의 부모 프로세스 역할을 하며, 고아 프로세스를 회수(Reaping)합니다. 이는 고아 프로세스의 종료 상태를 수집하고 해당 자원을 회수하는 역할을 합니다.
- DMA란?
DMA는 "Direct Memory Access"의 약자로, 컴퓨터 시스템에서 주로 입출력(I/O) 작업을 수행할 때 사용되는 기술이나 하드웨어 장치를 가리킵니다. DMA는 CPU의 개입 없이 메모리 간 데이터 전송을 수행하며, 이로 인해 시스템 성능을 향상시키고 CPU 부하를 줄일 수 있습니다.
CPU를 대신하여 I/O장치와 Memory사이의 데이터전송을 담당하는 장치
주변장치(하드디스크, 그래픽카드)들이 메모리에 직접 접근하여 읽거나 쓰도록 하는 기능
CPU의 개입 없이 I/O장치와 기억장치 사이의 데이터를 전송할수있음
인터럽트 발생 횟수 최소화하여 성능 높임
- 거짓 공유에 대해 설명해보세요.
병렬 프로그래밍에서 대표적인 성능 저하 문제 중 하나는 거짓 공유(false sharing) 문제이다.
실제로 쓰레드 간 공유되지 않은 데이터이지만 캐시 구조의 특성으로 마치 공유되는 것으로 인식되어 불필요한 성능 저하 현상이 있어나는 것이다.
즉 각 소켓(프로세서) 또는 코어가 동일한 캐시 라인 내의 서로 다른 위치의 데이터를 지역 캐시를 통해 참조할 때 거짓 공유가 발생한다. 실제 같은 데이터를 참조하지 않은 상황에도 불구하고 캐시 일관성 유지 프로토콜 통신(버스 트래픽)과 공유 캐시, 메모리로의 write-back으로 인한 오버헤드가 발생한다.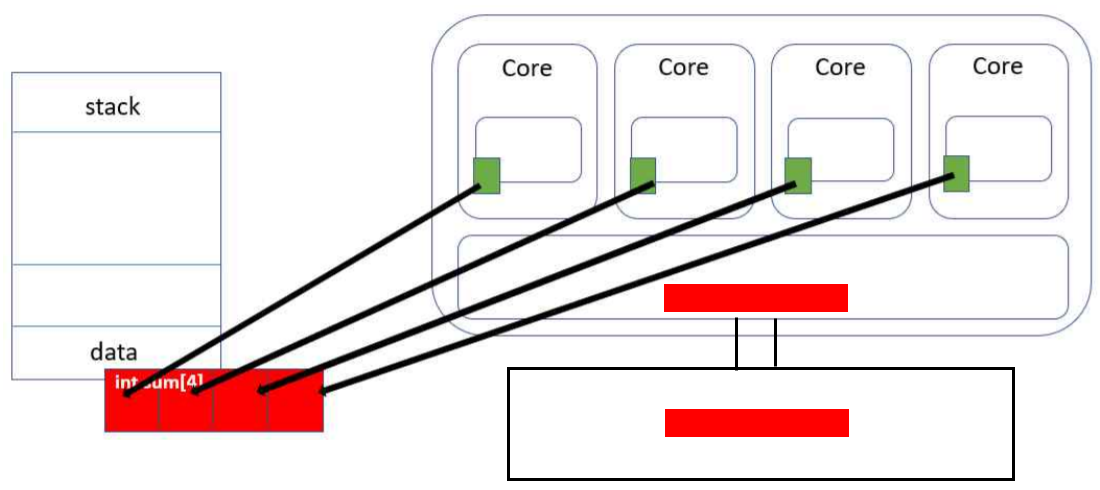
거짓 공유 발생 이유
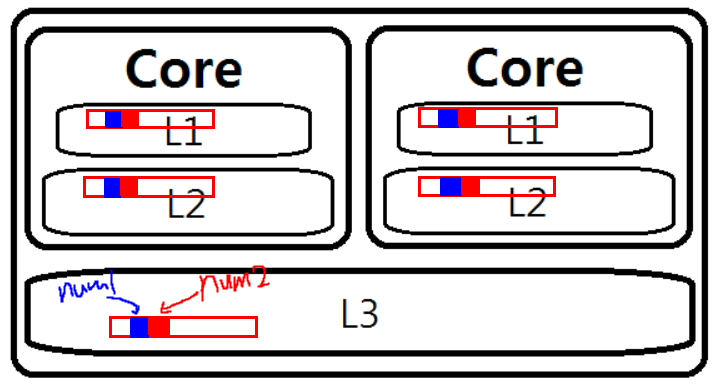
프로그램에서 task1을 수행하는 1번 쓰레드가 num1을 갱신하고, 2번 쓰레드가 num2를 갱신한다. 그리고 쓰레드가 동작하는 각 코어는 각자의 전용 L1 캐시를 가진다.캐시는 읽고 쓰는 단위가 4바이트 같은 작은 단위가 아니라 64바이트 같은 캐시 라인 크기만큼 한꺼번에 처리된다. 이 프로그램에서 num1과 num2는 바로 연이어 선언되었기에 컴파일러가 인접한 주소에 놓는 것이 일반적이다. 이에 따라 인접한 주소에 있는 두 변수는 각 코어의 L1 캐시의 같은 라인에 놓일 확률이 매우 놓다.
문제는 캐시 일관성(cache coherence)에 있다. 멀티코어에서 캐시는 모든 코어가 항상 최신 내용을 볼 수 있도록 처리한다. 그리고 이는 캐시 일관성 프로토콜(MSI, MESI, MOESI)을 통해 실현된다. 어떤 코어가 한 캐시 라인을 쓰려면 다른 코어가 가진 사본을 모두 무효화시키는 신호을 보낸다. 이것이 바로 거짓 공유의 근본 원인이다. num1, num2는 논리적으로는 전혀 공유가 되지 않고, 물리적으로 같은 캐시 라인에 놓여 있다. 그런데 1번 쓰레드가 num1을 갱신하면 다른 코어가 가지고 있을지도 모르는 이 캐시 라인을 무효화시켜야 한다. 2번 쓰레드의 수행에서도 마찬가지이다. 이러한 방식으로 끊임없이 서로의 캐시 라인을 무효화하고 그에 따라 캐시 미스가 게속 발생하고 만다. 이는 결국 성능 문제로 이어진다.
https://velog.io/@jinh2352/%EA%B1%B0%EC%A7%93-%EA%B3%B5%EC%9C%A0False-Sharing
- 메모리의 First Fit, Best Fit, Worst Fit에 대해서 설명해주세요.
메모리 할당 알고리즘은 주로 프로세스가 실행될 때 메모리 내의 어떤 영역을 할당할지 결정하는 방법을 나타냅니다. 이러한 알고리즘 중에는 "First Fit," "Best Fit," 그리고 "Worst Fit"이라는 세 가지 주요 알고리즘이 있습니다.
First fit : 메모리의 처음부터 검사해서 크기가 충분한 첫번째 메모리에 할당
First Fit 알고리즘은 메모리 내에서 가장 먼저 맞는(적합한) 블록을 찾아 프로세스에 할당하는 방법입니다.
메모리를 처음부터 순회하며 처음으로 발견되는 충분한 크기의 빈 메모리 블록을 선택하여 할당합니다.
First Fit은 구현이 간단하고 빠르게 동작하지만, 메모리 단편화가 발생할 수 있습니다.
Best fit : 모든 메모리 공간을 검사해서 내부 단편화를 최소화하는 공간에 할당
Best Fit 알고리즘은 사용 가능한 메모리 블록 중에서 가장 작은 크기의 블록을 찾아 프로세스에 할당하는 방법입니다.
메모리를 순회하여 필요한 크기와 가장 가까운 빈 메모리 블록을 선택하여 할당합니다.
Best Fit은 메모리 단편화를 최소화할 수 있지만, 빈 메모리 블록을 찾는 데 시간이 오래 걸릴 수 있습니다.
Worst Fit : 사용 가능한 메모리 블록 중에서 가장 큰 크기의 블록을 찾아 프로세스에 할당하는 방법
메모리를 순회하여 필요한 크기와 가장 큰 빈 메모리 블록을 선택하여 할당합니다.
Worst Fit은 메모리 단편화를 증가시킬 수 있지만, Best Fit과 마찬가지로 빈 메모리 블록을 찾는 데 시간이 오래 걸릴 수 있습니다.
Next fit : 마지막으로 참조한 메모리 공간에서부터 탐색을 시작해 공간을 찾음
Next Fit는 메모리 내의 빈 메모리 블록을 순차적으로 검색합니다. 이때, 메모리의 처음부터 시작하지 않고 이전에 할당한 블록의 끝 지점 다음부터 시작합니다.
Next Fit은 일부 메모리 단편화 문제를 완화할 수 있지만, Best Fit과 비교하면 메모리 단편화를 줄이는 데 덜 효과적입니다. 이전에 할당된 메모리 블록과 관련이 없이 다음으로 발견되는 빈 메모리 블록을 선택하기 때문입니다.Next Fit 알고리즘은 구현이 간단하며, First Fit과 마찬가지로 메모리 할당을 빠르게 수행할 수 있습니다. 그러나 메모리 단편화 문제를 완벽하게 해결하지는 못하며, Best Fit 알고리즘보다는 단편화 문제가 발생할 가능성이 높습니다. 따라서 Next Fit 알고리즘을 사용할 때에는 메모리 단편화 관리와 성능 간의 균형을 고려해야 합니다.
- Heap Corruption에 대해 설명해주세요.
프로그램의 실행 중에 동적 할당된 메모리(heap) 영역에 손상된 데이터를 쓰거나 메모리 블록의 경계를 벗어나는 행위를 나타냅니다.
힙 커럽션은 메모리 동적 할당이 적절히 이루어지지 않았을 경우에 발생합니다. 보통의 힙 커럽션 문제는 할당된 메모리의 영역 바깥에서 읽기나 쓰기가 이뤄졌거나 메모리 해제를 이중으로 했을 경우에 발생합니다. 그것에 대한 결과(여기선 앱이 꺼지는 버그)는 프로그램이 할당된 메모리를 적절하지 않은 방법으로 조작하려고 했을 떄 바로 나타나지 않기 때문에, 그 이슈를 야기한 근본적인 이유는 여러분의 눈에는 보이지 않을 수 있습니다.
원인:
잘못된 포인터 조작: 유효하지 않은 포인터를 사용하거나 포인터 연산을 부정확하게 수행할 경우 동적 할당된 메모리 영역에 손상을 일으킬 수 있습니다.
메모리 누수: 메모리를 할당한 후 해제하지 않거나 중복으로 해제하는 경우에도 메모리 손상이 발생할 수 있습니다.
배열 범위 초과: 배열을 사용할 때 배열의 경계를 벗어나 데이터를 쓰는 경우 메모리 손상이 발생할 수 있습니다.문제:
프로그램 비정상 종료: Heap corruption은 종종 프로그램의 비정상 종료(크래시)를 일으킵니다. 이로 인해 사용자 경험에 영향을 미치거나, 시스템의 안정성에 문제를 초래할 수 있습니다.
예측 불가능한 동작: Heap corruption은 프로그램의 동작을 예측 불가능하게 만들 수 있으며, 버그를 디버그하거나 수정하기 어렵게 만듭니다.
보안 취약점: Heap corruption은 보안 취약점으로 이어질 수 있으며, 해커가 악의적인 목적으로 프로그램을 공격하는 데 사용될 수 있습니다.방지와 해결:
올바른 메모리 관리: 동적 할당된 메모리를 사용할 때 항상 메모리 할당과 해제를 정확하게 수행해야 합니다.
배열 경계 확인: 배열을 사용할 때 배열의 경계를 벗어나지 않도록 주의해야 합니다.
정적 분석 및 디버깅 도구: 코드를 정적으로 분석하거나 디버깅 도구를 사용하여 메모리 관리 오류를 찾고 수정하는 것이 도움이 됩니다.
cf) Memory Corruption: 버그로 인한 메모리 오염, 예상되지 않은 메모리 값 변경 등에 의해 일어남
https://pilgwon.github.io/blog/2018/03/19/Solving-a-Mysterious-Heap-Corruption-Crash.html
- Caching Locality를 활용하여 Cache Hit Ratio를 높이는 방법에 대해 설명해주세요.
캐시 적중률은 CPU가 사용할 데이터를 캐시에서 탐색 했을 때, 원하는 데이터가 캐시에 존재할 확률을 의미합니다.
캐시 적중률을 높이기 위해서는 캐시 메모리의 크기를 늘리는 방법과 앞으로 많이 사용될 데이터를 캐시에 저장하는 방법이 있습니다.
앞으로 많이 사용될 데이터를 저장하기 위해서는 캐시 지역성을 이용할 수 있습니다. 캐시 지역성은 현재 사용하고 있는 메모리 위치에서 가까운 데이터를 사용할 확률이 높다는 개념입니다. 따라서, 현재 접근하고 있는 메모리 근처의 값들을 캐시에 저장해놓는다면 캐시 적중률을 높일 수 있습니다.
- 메모리가 고갈되면 일어나는 현상에 대해 설명해주세요.
메모리가 고갈되었지만, 프로세스를 실행해야 하기 때문에 Swap이 활발해집니다. 따라서 CPU 이용률이 하락하고, OS는 CPU 이용률이 낮으므로 오히려 프로세스를 추가하게 되는 쓰레싱 현상이 발생합니다. 이를 해소하지 못하면 Out Of Memory 상태로 판단해 중요도가 낮은 프로세스를 강제로 종료하게 합니다.