저자: Lukas Hewing, Kim P. Wabersich, Marcel Menner, Melanie N. Zeilinger
소속: Institute for Dynamic Systems and Control, ETH Zurich
게재: Annual Review of Control, Robotics, and Autonomous Systems, 3:269–296 (2020)
DOI: https://doi.org/10.1146/annurev-control-090419-075625
Abstract 요약: 데이터와 계산 자원의 증가로 제어기에 학습을 결합할 기회가 확대됨. 이 종설은 제약을 다루는 MPC와 학습의 결합을 세 갈래로 정리함. 첫째, 측정 데이터로 예측 모델을 개선하는 방법임. 둘째, 폐루프 성능을 높이도록 비용·제약·종단 요소 등 제어기 설계를 학습하는 방법임. 셋째, 학습 제어기의 제안을 MPC 안전 필터로 검사해 제약을 유지하는 방법임.
핵심 질문과 읽는 순서: 불확실한 실제 시스템에서 성능을 학습하면서도 제약을 어떻게 지킬 것인가가 핵심 질문임. 먼저 이상적인 확률 최적제어와 실제 MPC 사이의 간극을 확인하고, 그 간극을 줄이는 모델 학습과 제어기 설계 학습을 살핀 다음, 성능 학습과 안전 검증을 분리하는 방법으로 이어지는 구성임.
1. INTRODUCTION
- MPC는 상태·입력 제약을 최적화 문제에 직접 넣을 수 있지만, 예측 모델의 오차가 크면 성능과 제약 판단 모두 영향을 받음. 기존 강건·확률 MPC는 불확실성을 체계적으로 다루지만, 설계 이후 운용 중에는 모델과 제어기 구성이 대체로 고정됨.
- 이 종설이 말하는 학습 기반 MPC는 단지 모델을 신경망으로 바꾸는 작업에 한정되지 않음. 데이터를 이용해 모델을 바꾸거나, MPC 비용·제약·종단 조건을 조정하거나, 별도의 학습 제어기에 MPC를 안전장치로 붙이는 세 방향을 포함함.
- 논문의 범위는 매 샘플에서 최적화 문제를 푸는 온라인 MPC임. 명시적 MPC 제어법칙을 학습기로 근사하는 연구, 반복학습제어 전반, 시나리오 최적화의 상세 이론, 강화학습 전반은 범위 밖이거나 간략하게만 다룸.
2. OPTIMAL CONTROL OF UNCERTAIN SYSTEMS
- 저자들은 먼저 실제로 풀고 싶은 확률 최적제어 문제를 제시한 뒤, MPC가 이를 어떻게 근사하는지 설명함. 이 대비가 이후 학습이 무엇을 개선해야 하는지를 결정하는 기준임.
2.1. The General Stochastic Optimal Control Problem
- 실제 이산시간 동역학은 매 시점 달라지는 외란과 시간에 따라 고정된 미지 파라미터를 모두 포함함.
- 는 상태, 는 입력, 는 외란 또는 과정 잡음, 는 고정된 시스템 파라미터의 불확실성임. 아래첨자 는 실제 시스템을 뜻함.
- 제어 목적은 참 비용의 기댓값을 최소화하는 것임.
- 는 실제 단계 비용, 은 전체 제어 구간, 기댓값은 와 의 불확실성에 대한 것임.
- 성능만 좋으면 되는 것이 아니라 상태와 입력의 전체 궤적이 정해진 확률 이상으로 허용 집합에 머물러야 함.
- 는 상태 궤적, 는 번째 상태 제약 집합, 는 요구 확률임.
- 는 입력 궤적, 는 입력 제약 집합임. 이면 가능한 모든 불확실성 실현에 대해 만족해야 하는 경성 제약에 해당함.
- 원래 문제는 측정된 과거 상태에 의존할 수 있는 제어정책 자체를 최적화함.
- 는 정책들 중 최소 참 비용임.
- 식 (4b)는 최적화에 실제 동역학이 포함되어야 함을 뜻함.
- 는 시점 까지 관측된 상태 기록을 이용하는 피드백 정책임.
- 와 는 각각 외란 궤적과 고정 파라미터의 분포임.
- 식 (4e)는 상태 궤적의 확률 제약을 최적화 문제 안에 다시 명시한 것임.
- 식 (4f)는 입력 궤적의 확률 제약임. 원문은 식 (3b)의 궤적 끝점 표기와 식 (4f)의 끝점 표기가 서로 다름을 유의할 필요가 있음.
모든 가능한 피드백 정책을 탐색하면서 모델 불확실성이 미래 관측에서 얼마나 줄어드는지까지 계산해야 하므로 일반적인 식 (4)는 직접 풀기 어려운 문제임. 제약이 없는 선형·이차 비용 문제의 LQR은 예외적 특수 사례임.
2.2. Model Predictive Control
- MPC는 식 (4)의 긴 구간과 일반 정책 탐색을 짧은 예측 구간 의 반복 최적화로 바꿈. 현재 상태를 매번 다시 측정해 예측을 갱신함.
- 와 는 시점 에서 예측한 단계 뒤의 상태와 입력, 는 계산 가능한 예측 모델임. 일반적으로 와 실제 가 완전히 같지는 않음.
- 불확실성을 예측에 명시하지 않는 명목 MPC의 예시는 다음과 같음.
- 은 계산에 쓰는 단계 비용, 는 짧은 구간 이후를 대신하는 종단 비용, 는 예측 입력열임. 이 실제 목적 와 같을 필요는 없음.
- 식 (6b)는 명목 예측이 외란을 직접 포함하지 않음을 보여줌.
- 는 예측 입력열의 제약 집합임. 원문은 식 (6) 전 설명에서 를 까지, 식 (6c)에서 까지 적어 끝점 표기가 일치하지 않음.
- 와 는 각각 예측 상태열과 상태 제약 집합임.
- 는 예측 구간 이후에도 제약을 다룰 수 있게 돕는 종단 집합임.
- 현재 측정 상태가 모든 예측의 출발점임.
- 는 최적 입력열의 첫 성분임. 첫 입력만 적용하고 다음 샘플에서 문제를 다시 푸는 과정이 피드백을 형성함.
재귀적 실행 가능성은 이번에 해가 있으면 적용 후 다음 시점에도 해가 있음을 뜻함. 안정성은 보통 최적 비용을 Lyapunov 함수처럼 이용해 논증함. 두 성질 모두 모든 학습 기반 MPC에 자동으로 주어지는 것은 아님.
2.3. Overview of Learning-Based Model Predictive Control
- 학습은 반복 시행 사이에 수행될 수도 있고 운용 중 측정에 따라 이루어질 수도 있음. 학습 대상에 따라 이 종설은 예측 동역학, MPC 설계, 안전 필터라는 세 갈래로 분류함.
- 아래 표는 원문 Table 1의 분류와 해당 참고문헌 번호를 옮긴 것임. 참고문헌 번호는 이 종설의 문헌 목록을 가리킴.
| 구분 | 세부 주제 | 원문 참고문헌 번호 |
|---|---|---|
| Learning the System Dynamics | Robust models | 37–41 |
| Learning the System Dynamics | Parametric | 44–61 |
| Learning the System Dynamics | Nonparametric | 64–70 |
| Learning the System Dynamics | Stochastic models / robust in probability | 71–73 |
| Learning the System Dynamics | Parametric | 77–84 |
| Learning the System Dynamics | Nonparametric | 86, 87, 90–92, 95–100 |
| Learning the Controller Design | Performance-driven learning | — |
| Learning the Controller Design | Bayesian optimization | 102–108 |
| Learning the Controller Design | Terminal components | 110–113 |
| Learning the Controller Design | Inverse optimal control | 114–126 |
| Model Predictive Control for Safe Learning | — | 72, 73, 127–138 |
3. LEARNING THE SYSTEM DYNAMICS
- 첫 번째 방향은 안전 제약을 평가하는 예측 모델을 데이터로 개선하는 것임. 핵심은 모델 추정값만 아니라 남아 있는 오차의 집합 또는 분포를 어떻게 관리하느냐임.
- 은 명목 모델, 은 학습하거나 불확실성으로 다룰 잔차임. 이 분해는 명목 모델만으로도 데이터를 안전하게 수집할 수 있다는 전제와 연결됨.
- 원문은 강건 모델과 확률 모델을 나누며, 모델 불확실성을 무시한 명목 학습 MPC는 상세 검토 범위에서 제외함.
능동 학습과 dual control 보충: 수집될 데이터의 정보 가치까지 입력 선택에 반영하면 제어 성능과 식별을 동시에 다루는 dual control 문제임. 탐색 보너스·지속 여기 등을 넣는 명시적 방법은 비교적 계산이 쉽지만 절충이 휴리스틱이며, 미래 정보획득을 직접 계산하는 암묵적 방법은 원리에 더 충실하지만 계산 부담이 큼. 이는 원문의 별도 박스 내용에 해당함.
3.1. Robust Models
- 강건 MPC는 가능한 모든 불확실성 실현에 대해 제약을 지키도록 설계함. 데이터로 성능 모델을 개선하되 안전성 검증에 쓰는 모델은 보수적으로 유지하는 방식과, 불확실성 집합 자체를 데이터로 줄이는 방식이 구별됨.
- Aswani 등의 두 모델 구조에서 안전 모델은 , 임. 성능 모델은 임. 는 학습 오차 보정기임. 안전 제약의 근거와 성능 개선의 근거를 분리하는 구조임.
- 고정된 를 사용하면 보수성이 남기 때문에, 이후 방법들은 관측과 양립하는 파라미터나 함수를 추적함.
3.1.1. Robust parametric models
- 집합 소속 식별은 과거 관측을 설명할 수 있는 파라미터만 남김.
- 는 시점 까지 관측과 양립하는 파라미터 집합, 는 허용 외란 집합임.
- 새 관측을 넣어 이전 집합을 거르는 재귀 갱신임.
- 포함 관계는 관측이 쌓일수록 후보 집합이 확대되지 않음을 의미함. 다만 집합 표현의 계산 복잡도가 커질 수 있어 보수적 근사와 제한된 다면체 표현 등이 쓰임.
- 와 는 미지 파라미터에 의존하는 선형 상태공간 모델임. 관련 연구는 를 갱신하면서 제약 보장을 유지하고, 별도의 명목 추정값으로 성능 비용을 평가함.
- 는 알려진 회귀항, 는 미지 계수임. 일부 연구는 집합 소속 식별 대신 파라미터 적응 법칙으로 점추정과 불확실성 집합을 함께 갱신함.
- 관련 결과는 FIR 모델, 다면체 선형계, 연속·이산 비선형계까지 넓어지지만 모델 가정과 제약 보장의 세부 조건이 연구마다 다름.
3.1.2. Robust nonparametric models
- 비모수 방법은 의 형태를 미리 고정하지 않고 관측값과 기울기 상한으로 가능한 함수들의 집합을 구성함. 원문의 예시는 다음과 같음.
- 는 가능한 함수 집합, 은 기울기 상한임. 이는 원문에서 번호가 없는 식임.
- 새 관측을 반영해 함수 집합을 줄이는 갱신식임. 상·하한 중간의 명목 함수는 일반적으로 매끄럽지 않아 MPC의 수치 최적화를 어렵게 만들 수 있음.
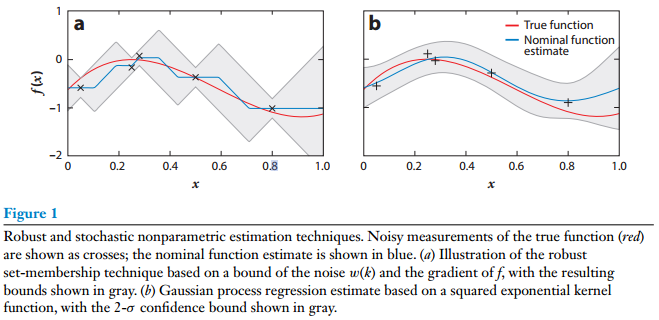
- Fig. 1의 왼쪽은 잡음·기울기 상한에 근거한 강건 경계, 오른쪽은 GP 평균과 불확실성 구간을 보여줌. 두 그림 모두 관측이 없는 곳의 함수값을 어떻게 다루는지가 핵심임.
- 원문은 비모수 강건 모델의 평활화를 위한 주변 데이터의 볼록결합과 기저함수 가중합도 소개함. 계산성을 개선하되 이론적 성질을 유지하려는 시도임.
3.2. Stochastic Models
- 강건 집합은 가능한 오차를 모두 덮어야 하므로 보수적일 수 있음. 확률 모델은 불확실성의 분포를 이용해 제약 만족 확률과 성능 사이를 조정하지만, 보장 조건을 증명하기 더 어려움.
- 데이터에서 얻은 파라미터 사후분포로 신뢰집합 를 만들고 가 되게 한 다음, 그 집합에 대해 강건 MPC를 설계하는 방법이 중간 형태임. 확률 는 집합이 실제 파라미터를 포함할 신뢰 수준임.
- 다만 가우시안 잡음은 비유계일 수 있어 유계 외란을 요구하는 강건 설계와 바로 맞지 않음. 또한 확률 신뢰집합은 식 (11)처럼 항상 축소되는 중첩성을 보장하기 어려워 온라인 갱신 뒤 재귀적 실행 가능성의 증명이 까다로움.
3.2.1. Stochastic parametric models
- 베이지안 방식은 파라미터 하나의 점추정 대신 관측 후의 파라미터 분포를 갱신함.
- 는 사전분포, 는 측정 궤적의 가능도, 분모는 정규화 상수임. 식 (9)의 가능한 파라미터 집합을 확률분포로 바꿔 생각할 수 있음.
- 은 새 상태 측정값, 는 직전 사후분포임. 식 (15)는 데이터를 한 번에 다시 처리하지 않고 사후분포를 순차 갱신하는 관계임.
- 파라미터에 선형인 식 (13)과 가우시안 잡음·사전분포에서는 재귀 베이지안 선형회귀가 가능함. 일반적으로는 분포 계산이 어렵고, 실제 구현의 제약 축소나 안전 여유는 근사에 의존하는 경우가 있음.
- 원문은 로봇 모델 적응과, 시간 상관이 있는 외란의 조건부 예측분포를 이용하는 시나리오 MPC 사례를 소개함. 조건부 분포로 성능을 개선하는 것과 전체 외란분포를 사용해 재귀적 실행 가능성을 확보하는 것은 서로 다른 설계 선택임.
3.2.2. Stochastic nonparametric approaches
- GP 회귀는 함수값 사이의 상관을 커널로 표현해, 데이터가 많은 곳과 부족한 곳을 예측 평균 및 분산으로 구분함. 원문은 설명을 위해 출력이 스칼라인 경우를 사용함.
- 는 기록된 다음 상태, 는 데이터의 커널 Gram 행렬, 는 새 질의점과 기록 데이터의 교차 공분산, 는 관측 잡음 분산임. 원문에서 번호가 없는 결합 가우시안 모델임.
- 와 는 커널의 두 입력, 는 신호 분산, 은 양의 대각 길이척도 행렬임. 원문은 상태를 커널 입력의 예로 적으며, 동역학 학습의 질의점은 상태·입력 쌍임.
- 는 예측 평균, 는 데이터로 조건화한 잔여 불확실성임. 세 식 모두 원문에서 번호가 없는 수식임.
- 이 분포를 MPC의 여러 예측 단계로 전파할 때 선형화, sigma-point 변환, 모멘트 계산 등을 사용하지만 대개 근사임. 따라서 GP 분산에 따라 제약을 줄이는 실용적 설계와 엄밀한 폐루프 안전 보장은 구분해야 함.
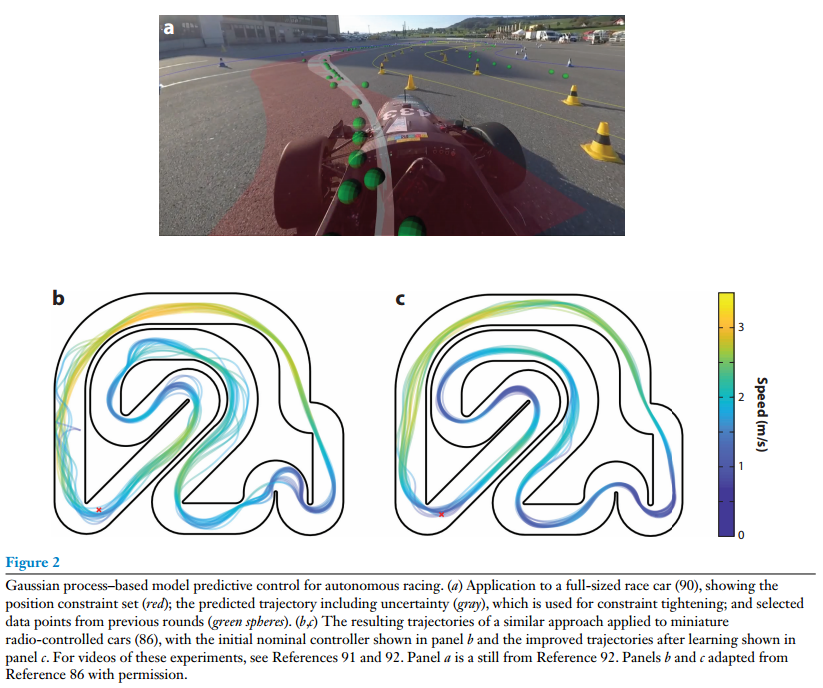
- Fig. 2(a)는 실차에서 위치 제약, 불확실성을 포함한 예측 궤적, 이전 주행 데이터점을 함께 보여주고, (b)·(c)는 소형 차량의 학습 전후 궤적을 비교함. 서로 다른 적용 사례이므로 동일한 실험군의 전후 비교로 혼동하지 않아야 함.
- GP는 데이터 수가 늘면 계산 부담이 커짐. 따라서 제한된 데이터 사전, 유도점, 기저함수 근사, 분산 전파의 단순화 등이 사용됨.
4. LEARNING THE CONTROLLER DESIGN
- 두 번째 방향은 모델이 아니라 MPC 문제의 형태가 실제 폐루프 성능을 좌우한다는 점에서 출발함. 예측 지평, 비용 가중치, 제약과 종단 요소를 학습 대상으로 삼음.
- 은 비용의 설계 파라미터임. 원문은 식 (16a)의 합 상한을 으로 쓰면서 같은 식 묶음의 예측열은 으로 표기함.
- 는 예측 동역학의 파라미터임.
- 는 입력 제약의 조정 파라미터임.
- 는 상태 제약의 조정 파라미터임.
- 현재 상태에서 시작한다는 초기 조건임. 여기서 학습은 이 최적화 문제를 매번 푸는 것뿐 아니라 를 데이터로 조정하는 것임.
4.1. Performance-Driven Controller Learning
- MPC가 짧은 지평과 단순화된 모델로 원래 식 (4)를 근사할 때 실제 시행에서 얻은 성능을 사용해 설계를 개선하는 방향임. 원문은 베이지안 최적화에 의한 튜닝과 종단 요소 학습을 구분함.
4.1.1. Bayesian optimization for controller tuning
- 설계 파라미터 와 실제 폐루프 비용 의 관계는 해석적으로 알기 어려움. 베이지안 최적화는 여러 시행의 로 이 함수를 추정하고, 획득 함수 로 다음 시행의 파라미터를 선택함.
- 원문의 예로는 예측 모델 오차를 보완하기 위한 비용 가중치 튜닝, 잠재적으로 비선형인 실제 시스템에 쓸 선형 MPC 모델 파라미터의 튜닝, 예측 지평의 튜닝 등이 있음. 한 번의 MPC 최적화와 여러 시행에 걸친 파라미터 탐색은 서로 다른 시간 규모임.
시행 비용 를 직접 측정해 튜닝하므로 모델이 완벽하지 않아도 성능 개선을 노릴 수 있음. 다만 안전하지 않은 파라미터를 실제 시스템에 시험할 수 있는지는 별도의 제약 및 시행 정책에 달린 문제임.
4.1.2. Learning terminal components
- 짧은 예측 지평은 구간 밖의 위험이나 비용을 놓치기 쉬움. 종단 집합과 종단 비용을 데이터로 개선하면 짧은 MPC의 한계를 줄일 수 있음.
- 는 원래 제어불변 종단 집합, 는 그 집합에 도착한 기존 궤적의 상태임. 이들의 합집합이 확대된 불변 집합을 이루는 논리는 명목 시불변계에서 해당 궤적의 나머지 입력을 재사용할 수 있다는 점에 근거함. 원문에서 번호가 없는 수식임.
- 선형 시불변계에서는 볼록껍질을 이용한 확장도 가능함. 반복 작업에서는 이전 시행의 안전 상태와 남은 비용을 각각 종단 제약과 종단 비용으로 사용하며, 원문이 소개한 특정 방법에서는 시행별 전체 비용의 비증가가 증명됨. 이는 모든 종단 학습 방법의 보편적 결과는 아님.
4.2. Learning from Demonstration with Inverse Optimal Control
- 목표 행동을 비용·제약으로 직접 기술하기 어려우면 시연 궤적을 설명하는 최적제어 문제를 역으로 찾는 방법임. 단순한 입력 모방과 달리 모델과 최적화 구조를 사용하지만, 시연이 설정한 문제의 최적해라는 가정이 핵심임.
- 비용 파라미터를 가정하고 최적성 조건을 만든 뒤 시연 입력열 에 맞도록 파라미터를 추정함. 제약식이 이면 원문은 KKT 조건을 다음처럼 제시함.
- 은 라그랑주 함수, 은 비용 파라미터, 는 시연 입력열임. 식 (17a)는 정지 조건임.
- 는 제약의 라그랑주 승수임. 식 (17b)는 활성 제약과 승수의 상보성 조건임.
- 식 (17c)는 부등식 제약의 승수 부호 조건임. KKT 해석에는 원문이 전제한 순문제의 실행 가능성과 적절한 정규성·최적성 조건도 중요함.
- 실제 시연은 잡음이나 비최적 행동을 포함하므로 KKT 잔차를 최소화하거나, KKT를 정확히 만족하는 입력열과 관측 시연 사이의 차이를 최소화하는 완화법이 소개됨.
- 비용뿐 아니라 제약까지 추론하는 연구도 다루지만 상대적으로 적음. 특히 시연 상태·입력의 볼록껍질에서 제약 후보를 만들고 활성 승수로 필요한 제약을 선택하는 절차가 소개됨.
5. MODEL PREDICTIVE CONTROL FOR SAFE LEARNING
- 세 번째 방향에서는 학습 제어기가 성능을 위해 입력 를 제안하고, MPC가 이를 실제 시스템에 적용해도 안전한 미래 계획이 있는지 확인함. 성능 목적 가 길고 복잡하거나 수식화하기 어려워도 안전 판단은 별도의 짧은 최적화로 수행할 수 있음.
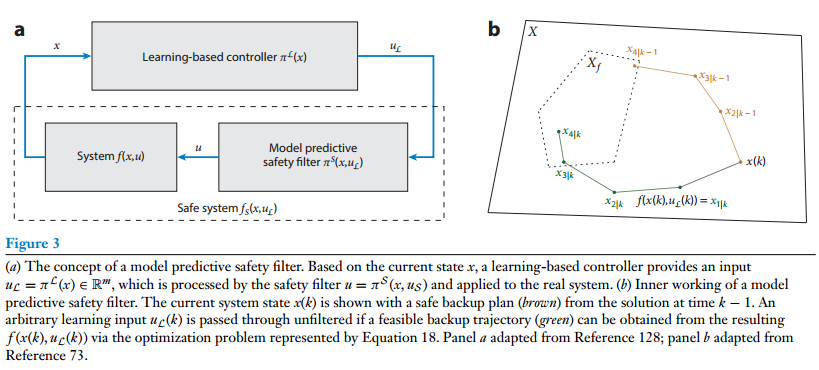
- Fig. 3(a)는 학습 입력이 필터를 거쳐 시스템에 적용되는 구조, (b)는 후보 입력 이후 종단 안전 집합으로 이어지는 백업 궤적의 존재 여부를 보여줌.
- 는 필터가 최종 선택하는 첫 입력, 는 학습 제어기의 제안임. 목적함수는 둘의 차이를 최소화하고 식 (6b)–(6f)는 예측 동역학·제약·종단 안전 조건을 요구함.
- 학습 입력을 그대로 적용해도 안전한 백업 궤적이 있으면 이므로 필터가 통과시킴. 그렇지 않으면 안전 계획을 확보할 수 있는 입력으로 최소한 변경함.
- 종단 집합 는 여기서 비용의 나머지를 근사하는 도구라기보다, 진입 후 안전 제어기로 무한히 제약을 유지할 수 있는 집합임. 이 성질과 모델·외란 가정이 충족되어야 장기 안전 주장으로 이어짐.
- 식 (18)의 기본형은 모델 불확실성을 무시함. 원문은 확률적 모델 학습과 강건-확률적 안전 필터의 결합도 소개하지만, 안전 수준은 각 방법의 추정 오차 가정과 지정 확률에 의존함. 필터와 여러 학습 제어기를 결합했을 때의 전체 성능은 추가 연구 과제로 남음.
6. DISCUSSION
- 동역학 학습: 예측 모델 개선에 가장 많은 연구가 집중되어 있으며, 강건 MPC 기반의 이론이 상대적으로 성숙함. 반대로 확률 모델의 학습 성능과 폐루프 제약 보장을 함께 다루는 일반 이론은 부족함. 능동 학습과 dual control도 열린 문제임.
- 제어기 설계 학습: 데이터에서 종단 요소를 만드는 방법은 상당히 발전했지만 비용·제약 전반을 자동 조정하는 문제는 여전히 어려움. 역최적제어는 시연을 제약이 있는 연속 제어기로 연결할 수 있으나 비최적·확률적 시연의 체계적 처리가 필요함.
- 안전한 학습을 위한 MPC: 성능 최적화와 안전 보장을 분리하면 복잡한 학습 제어기에 필터를 붙일 수 있음. 그러나 계산 규모, 불확실한 모델, 필터를 포함한 전체 폐루프의 성능 분석이 남음.
- 이 글은 여러 선행연구의 메커니즘과 보장 범위를 분류한 종설임. 하나의 공통 실험이나 수치표로 세 방법의 우열을 직접 비교한 연구가 아님. 세 갈래 전체에 공통인 과제는 학습에 필요한 계산량과 실시간 제약 보장을 함께 만족시키는 것임.
해석상 유의점: ‘학습 기반 MPC’라는 이름만으로 안전이 보장되는 것은 아님. 어떤 불확실성을 어떻게 추정하고, 어느 집합이나 확률 수준에 대해 제약을 검증하며, 온라인 갱신 뒤에도 실행 가능성이 유지되는지를 개별 방법마다 확인해야 함.
DISCLOSURE STATEMENT
- 저자들은 이 종설의 객관성에 영향을 미칠 것으로 여겨질 만한 소속·회원 자격·재정적 이해관계를 인지하지 못한다고 밝힘.
ACKNOWLEDGMENTS
- 저자들은 Swiss National Science Foundation의 과제 번호 PP00P2_157601/1 지원을 명시함.
LITERATURE CITED
- 원문에는 참고문헌 138편이 수록됨. 위 Table 1과 본문의 괄호 번호는 원문의 문헌 번호를 따름. 전체 서지정보는 DOI의 원문 참고문헌 목록을 참조할 수 있음.