Hello World가 보여주는 eBPF 앱의 최소 분업
1주차 글은 eBPF를 “커널 안에서 검증된 작은 program을 event에 붙여 실행하는 모델”로 정의하고, loader·bpf() syscall·verifier·hook·helper·map 여섯 조각으로 이 모델을 나눠 봤다. 그 글은 조각의 이름과 역할만 짚었을 뿐, 실제 코드에서 이 조각들이 어떤 줄로 나타나는지는 보여주지 않았다.
이번 글은 그 빈틈을 코드로 채운다. 다루는 질문은 셋이다.
- eBPF program은 어떤 구조로 작성되는가?
- map은 실제 코드에서 어떻게 정의하고 읽는가?
- loader와 user space code는 어떤 역할을 나눠 갖는가?
1주차가 남긴 네 번째 질문, “verifier는 어떤 program을 거절하는가?”는 이번 글에서 답하지 않는다.
verifier는 이번 글에서도 load 전에 존재하는 문지기로만 등장하고, 거절 기준과 로그 해석은 6주차로 미룬다. bpf() syscall의 세부 동작은 4주차, BTF·CO-RE·libbpf는 5주차 몫이다.
2주차의 질문은 코드를 눈으로 보는 것이다
이번 글이 따라가는 코드는 BCC(BPF Compiler Collection)의 Python 프레임워크로 짠 네 가지 예제(hello.py, hello-map.py, hello-buffer.py, hello-tail.py)다. BCC는 eBPF를 처음 만져보는 사람에게 가장 접근성이 좋은 도구이지만, 컴파일·로드·attach·검증의 세부 단계를 대부분 감춘다. 그 편의성 덕분에 이번 글은 “구조를 낱낱이 해부하는 글”이 아니라 “코드 한 줄이 kernel 쪽인지 user space 쪽인지 먼저 구분해 보는 글”이 될 수 있다. 감춰진 세부 단계를 여는 일은 3주차(program 구조)와 4주차(bpf() syscall)에서 이어간다.
네 예제는 각각 정확히 하나의 데이터 통로를 보여주도록 짜여 있다 — hello.py는 trace_pipe(가장 단순한 문자열 출력), hello-map.py는 hash map(누적되는 상태), hello-buffer.py는 perf buffer(구조화된 event), hello-tail.py는 tail call(program 사이의 분기)이다. 이 지도를 염두에 두고 아래 코드를 하나씩 따라간다.
독자는 Linux와 backend/platform 운영 경험은 있지만 eBPF 코드를 직접 읽어본 적은 없다고 가정한다. 1주차에서 만든 독자상과 같다.
eBPF를 다루는 언어는 여러 개다 — 이 장이 Python(BCC)을 고른 이유
이 장의 eBPF program은 C(정확히는 restricted C)로 쓴다. 일반적으로는 C뿐 아니라 Rust 같은 다른 언어도 LLVM을 거쳐 같은 eBPF bytecode로 컴파일될 수 있지만, 그 program을 컴파일·로드·attach하고 map을 읽는 loader/user space 쪽은 언어 선택지가 더 다양하다.
| 언어 | 대표 프레임워크 | 특징 |
|---|---|---|
| Python | BCC | 런타임에 clang으로 컴파일한다. 설치와 시작이 가장 쉽지만, 실행할 때마다 컴파일하는 비용이 있어 배포용으로는 잘 안 쓰인다. |
| C | libbpf + bpftool / CO-RE | 커널이 실제로 제공하는 하부 인터페이스에 가장 가깝다. 빌드 단계가 늘고 문법이 더 장황하다. |
| Rust | aya | Rust의 타입·메모리 안전성 모델을 user space loader와 eBPF 개발 흐름에 최대한 활용한다(eBPF program 자체는 kernel의 verifier·helper 제약을 여전히 그대로 받는다). 생태계가 상대적으로 젊고, Learning eBPF는 다루지 않는다. |
| Go | cilium-ebpf | Cilium 같은 프로덕션 네트워킹 프로젝트가 실제로 쓰는 조합이다. Go 런타임(GC, goroutine)과 얽힌 별도 고려사항이 있다. |
이 장이 Python/BCC로 시작하는 이유는 단순하다 — 책이 그렇게 짜여 있고, eBPF를 처음 보는 독자가 “커널 코드가 어떻게 event에 붙는지” 감을 잡는 데 설치 장벽이 가장 낮다. 다만 BCC가 실행마다 다시 컴파일하는 방식이라는 건 비용이기도 하다 — 3주차부터는 C+bpftool로, 5주차부터는 C+libbpf/CO-RE로 넘어가면서 이 비용을 뺀 툴체인을 본다. Rust(aya)나 Go(cilium-ebpf)는 이 시리즈가 따라가는 책의 범위 밖이라 직접 다루지 않지만, 프로덕션에서 eBPF를 쓸 때 실제로 검토되는 선택지라는 것만 여기서 짚어 둔다.
첫 예제는 Python 문자열 안에 있는 C 코드다
BCC로 짠 eBPF “Hello World”는 파일 하나에 두 언어가 섞여 있다. 아래는 hello.py의 구조를 최소화한 예시다.
#!/usr/bin/python3
from bcc import BPF

program = r"""
int hello(void *ctx) {
    bpf_trace_printk("Hello World!");
    return 0;
}
"""

b = BPF(text=program)
syscall = b.get_syscall_fnname("execve")
b.attach_kprobe(event=syscall, fn_name="hello")
b.trace_print()
이 파일 안에는 두 개의 서로 다른 실행 주체가 있다. program 문자열 안의 C 코드(hello 함수)는 kernel 안에서 실행될 eBPF program이고, 그 바깥의 Python 코드는 user space에서 실행되는 loader다. BPF(text=program) 한 줄이 이 C 코드를 컴파일하고 커널에 올리는 과정을 전부 감춘다 — clang으로 컴파일하고, bpf() syscall로 검증·로드를 요청하는 과정이 이 한 줄 뒤에 숨어 있다. 그 안이 실제로 어떻게 동작하는지는 3주차와 4주차에서 연다.
아래 코드는 GitHub 원본의 함수·변수 이름을 그대로 쓴다. 네 예제 모두 커널 쪽 진입 함수 이름이 hello로 같으니, 본문에서 hello()를 언급할 때는 그 시점에 다루는 예제 파일(직전 문장에서 밝힌 파일명) 기준으로 읽는다.
이 파일 한 장에서 어느 코드가 user space이고 어느 코드가 kernel event에 붙어 실행되는지 정리하면 다음과 같다.
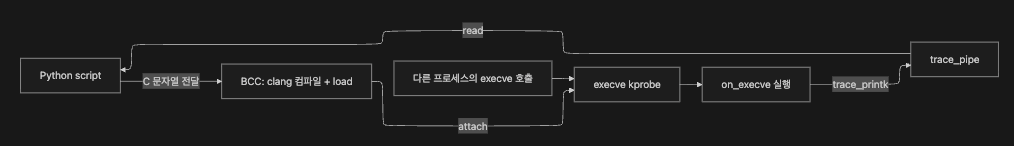
화살표 두 개는 서로 다른 시점을 가리킨다. 위쪽(Script → Compile → Kprobe)은 프로그램을 시작할 때 한 번 일어나는 준비 과정이고, 아래쪽(Exec → Kprobe → Prog → Pipe → Script)은 그 이후 execve가 호출될 때마다 반복되는 실행 경로다. hello는 이 그림에서 유일하게 kernel 안에서 실행되는 상자다.
execve kprobe에 붙으면 새 프로그램 실행이 이벤트가 된다
hello 함수 본문은 이미 완성돼 있지만, 커널의 특정 지점에 attach되기 전까지는 어떤 이벤트에서도 호출되지 않는다. 위 코드는 execve syscall에 kprobe로 붙인다.
execve는 새 프로그램을 실행할 때 호출되는 syscall이다 — 호출이 성공하면 지금 실행 중이던 프로세스 이미지가 새 프로그램으로 통째로 교체되고 원래 실행하던 코드로는 돌아오지 않는다(실패하면 원래 코드로 되돌아온다). b.get_syscall_fnname("execve")는 이 syscall이 실제로 구현된 커널 함수 이름을 architecture에 맞게 찾아 준다 — 이름 자체는 아키텍처와 커널 버전에 따라 달라질 수 있어서, BCC가 이 차이를 대신 감춰준다. attach_kprobe()가 이 커널 함수 진입 지점에 hello를 붙인다.
이 attach는 동적으로 걸린다 — 커널을 다시 빌드하거나 머신을 재부팅할 필요 없이, 이미 떠서 돌아가고 있는 머신에 바로 적용된다. 이 시점부터 이 머신에서 새 프로그램이 실행될 때마다(정확히는 execve가 호출될 때마다) hello가 트리거된다. 다만 attach 이전에 이미 있었던 event는 보이지 않는다 — attach 이후에 새로 발생하는 event만 관측 대상이다. echo처럼 shell에 내장된 명령은 새 실행 파일을 fork/exec하지 않으므로 이 kprobe에 잡히지 않는다. 확인하려면 ls, id처럼 실제 실행 파일을 부르는 명령을 다른 터미널에서 실행해야 한다.
쉽게 말하면, attach는 관측 장치를 켜는 시점이다. 켜기 전에 지나간 이벤트는 보이지 않고, echo처럼 새 실행 파일을 부르지 않는 동작은 애초에 execve 지점을 지나가지 않는다.
이 장은 단순함을 위해 kprobe를 쓴다. Linux 5.5부터는 fentry/fexit처럼 kprobe보다 더 빠른 attach 방식도 있는데, 그 차이는 이후 주차에서 program·attachment type을 다룰 때 짚는다.
trace_printk는 Hello World에는 좋지만 데이터 통로로는 좁다
bpf_trace_printk()는 eBPF program이 커널 안에서 문자열을 하나 남기는 가장 쉬운 방법이다. 이 출력은 커널 트레이싱 인프라가 공용으로 쓰는 pseudo 파일에 쓰인다. 배포판에 따라 /sys/kernel/debug/tracing/trace_pipe이거나 /sys/kernel/tracing/trace_pipe이며, b.trace_print()는 이 파일을 계속 읽어 화면에 뿌리는 역할만 한다.
sudo python3 hello.py를 실행해 둔 채로 다른 터미널에서 ls처럼 실제 실행 파일을 부르면, trace_pipe에 Hello World! 문자열이 포함된 줄이 나타난다. 줄의 형식은 커널 트레이싱 인프라(ftrace)가 공통으로 쓰는 형태를 따른다 — 프로세스 이름·PID·CPU 번호·플래그·타임스탬프 뒤에 메시지가 붙는다.
<comm>-8421 [002] d... 12345.678901: bpf_trace_printk: Hello World!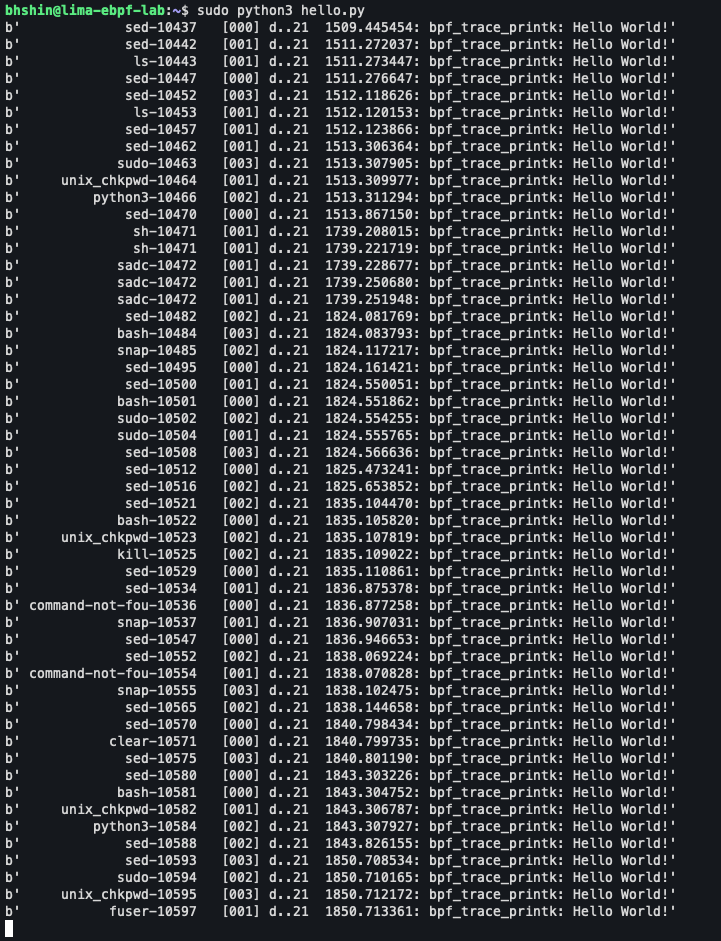
여기 적힌 PID·CPU 번호·타임스탬프는 실행마다 달라지는 예시 값이고, <comm>도 실제로는 구체적인 이름이 찍히는 자리표시자다 — 다만 이 이름이 꼭 ls는 아닐 수 있다. execve 진입 시점의 kprobe는 커널이 태스크 이름을 새 실행 파일명으로 바꾸기 전에 걸리는 경우가 많아서, 실제로는 ls를 실행한 셸(bash, zsh 등)의 이름이 찍히기 쉽다. 이 줄에서 고정된 부분은 형식과 Hello World! 메시지뿐이고, 앞쪽 필드의 정확한 형식은 커널 버전과 배포판에 따라 달라질 수 있다.
이 통로는 세 가지 이유로 좁다. 첫째, 머신 전체에 pipe가 하나뿐이라 여러 eBPF program이 동시에 쓰면 출력이 뒤섞인다. 둘째, 결과가 한 줄짜리 텍스트 로그로만 나와서 — %d 같은 포맷 지정자로 값 몇 개를 찍을 수는 있지만(tail call 예제의 bpf_trace_printk("Another syscall: %d", opcode)처럼) — 여러 필드를 갖춘 구조화된 이벤트를 보내기는 불편하다. 셋째, bpf_trace_printk()는 디버깅용으로 설계돼 있어 프로덕션에서 쓰기에는 느리다. 이 세 가지 한계 때문에 실제로 값을 저장하거나 구조화된 데이터를 보내려면 map이 필요하다.
BPF map은 kernel과 user space가 공유하는 데이터 구조다
hello 함수는 execve가 일어날 때마다 그 event 하나에 대해 처음부터 다시 실행된다. C 함수의 지역 변수가 함수 호출이 끝나면 사라지듯, 이 함수 안에서 선언한 값도 다음 execve가 왔을 때는 남아 있지 않다. "지난 번까지 몇 번 호출됐는지"를 세려면 함수 바깥, 커널 안에 있는 별도의 저장 공간이 필요하다 — 그게 map이다.
map은 eBPF program과 user space가 함께 접근할 수 있는 데이터 구조다. classic BPF에는 없던 기능이라, eBPF를 “확장된” BPF로 만드는 핵심 요소 중 하나다. map의 쓰임새는 크게 세 가지로 나뉜다 — user space가 설정 값을 eBPF program에 전달하는 용도, eBPF program이 event 사이에 상태를 저장하는 용도, eBPF program이 결과나 지표를 남기고 user space가 읽어가는 용도.
map을 전부 “key-value store”로 뭉뚱그리면 놓치는 부분이 있다. array는 4바이트 정수 index를 key로 쓰고, hash map은 임의 타입을 key로 쓴다. queue·stack·LRU·longest-prefix-match·Bloom filter처럼 특정 연산에 최적화된 map type도 있고, perf buffer·ring buffer처럼 key-value 모델과는 다른 스트림형 map, program array처럼 eBPF program 자체를 값으로 담는 map도 있다. sockmap·devmap처럼 소켓이나 네트워크 인터페이스를 값으로 담아 패킷을 다른 소켓·인터페이스로 바로 redirect하는 네트워킹 전용 map도 있다(8주차에서 다룬다). 이번 글은 이 중 hash map과 perf buffer 두 가지를 코드로 확인한다 — CPU 코어별로 별도 메모리를 쓰는 per-CPU map, map을 값으로 담는 map-of-maps, 여러 CPU가 동시에 map을 갱신할 때의 동시성 제어(spin lock)는 다루지 않는다.
아래는 hello-map.py의 program 문자열 안에 들어가는 C 코드만 보여준다 — Python 래퍼 없이 이 코드만 파일로 저장해 실행하면 python3가 C 문법을 그대로 파싱하려다 SyntaxError를 낸다. 전체 파일은 아래 실습 절("네 예제를 끝까지 실행해 본다")에 있다. 아래는 그중 execve를 호출한 user ID별로 횟수를 세는 부분이다.
BPF_HASH(counter_table);

int hello(void *ctx) {
    u64 uid = bpf_get_current_uid_gid() & 0xFFFFFFFF;
    u64 counter = 0;
    u64 *p = counter_table.lookup(&uid);
    if (p != 0) {
        counter = *p;
    }
    counter++;
    counter_table.update(&uid, &counter);
    return 0;
}BPF_HASH(counter_table)은 BCC macro로, hash map을 정의한다 — 크기를 지정하지 않으면 BCC가 기본 상한만큼 커널에 공간을 미리 확보(preallocate)해 둔다(정확한 기본 상한 값과, 그 상한을 넘는 새 key로 update했을 때의 정확한 동작은 BCC 버전마다 달라질 수 있어 여기서 특정 수치를 단정하지 않는다 — 이 실습처럼 key가 UID인 경우에는 이 상한에 부딪힐 일이 거의 없다). bpf_get_current_uid_gid()는 현재 event를 일으킨 process의 UID를 돌려주는 helper인데, 반환값의 lower 32비트가 UID이고 upper 32비트가 GID라서 & 0xFFFFFFFF로 lower 32비트만 꺼낸다. counter_table.lookup()은 이 UID에 해당하는 값을 찾고, 없으면 0으로 취급한다. counter_table.update()가 새 값을 map에 써 넣는다.
이 C 코드는 일반 C 문법이 아니다. counter_table.lookup()처럼 구조체에 메서드를 붙이는 문법은 C에 없다 — BCC가 이 코드를 컴파일러에 넘기기 전에 실제 C로 다시 써 준다.
// BCC 문법
counter_table.lookup(&uid);

// 실제로는 이런 계열의 helper 호출로 풀린다고 이해하면 된다
bpf_map_lookup_elem(&counter_table, &uid);
정확한 생성 코드는 BCC가 만든 C를 직접 봐야 확인할 수 있지만, 초심자는 "메서드 호출처럼 보이는 BCC 편의 문법이 커널 helper 호출로 낮아진다"고 이해하면 충분하다. user space 쪽 코드는 b["counter_table"].items()로 이 map의 모든 key-value 쌍을 순회해서 읽는다. 즉 kernel program은 map에 쓰기만 하고, user space code가 주기적으로 map을 읽어 화면에 보여주는 방식으로 역할이 나뉜다.
이 코드는 map 사용 흐름을 보여주는 학습용 예제다. lookup과 update 사이는 원자적이지 않아서, 여러 CPU가 같은 UID로 동시에 execve를 호출하면 두 CPU가 같은 옛 값을 읽고 각자 1을 더해 쓰는 바람에 증가분이 일부 사라질 수 있다(lost update). 정확한 concurrent counter를 만드는 방법은 이 글의 범위 밖이다.
Perf buffer는 구조화된 이벤트를 user space로 보낸다
hash map은 상태를 “누적”하기에는 좋지만, event 하나마다 여러 필드를 실어 보내기엔 불편하다. 이럴 때 쓰는 것이 perf buffer다. 아래는 hello-buffer.py의 program 문자열 안에 들어가는 C 코드 중 일부로, execve가 호출될 때마다 process ID, user ID, 실행 파일 이름을 구조체 하나로 묶어 보낸다.
BPF_PERF_OUTPUT(output);

struct data_t {
    int pid;
    int uid;
    char command[16];
};

int hello(void *ctx) {
    struct data_t data = {};
    data.pid = bpf_get_current_pid_tgid() >> 32;
    data.uid = bpf_get_current_uid_gid() & 0xFFFFFFFF;
    bpf_get_current_comm(&data.command, sizeof(data.command));
    output.perf_submit(ctx, &data, sizeof(data));
    return 0;
}bpf_get_current_pid_tgid()는 (TGID << 32) | PID 형태의 64비트 값을 돌려준다. upper 32비트가 TGID(thread group ID, user space가 보통 “process ID”라고 부르는 값)이고, lower 32비트가 현재 thread의 kernel PID(= thread ID)다. 단일 스레드 프로세스에서는 이 둘이 같은 값이지만, 스레드가 여러 개면 lower 32비트(PID/TID)만 스레드마다 달라지고 upper 32비트(TGID)는 같은 값을 공유한다. bpf_get_current_comm()은 실행 중인 명령 이름을 복사해 오는데, 이 이름은 커널이 관리하는 고정 길이(16바이트)라 긴 명령줄 전체가 아니라 명령 이름만 담기며 잘릴 수 있다. 어떤 contextual helper를 쓸 수 있는지는 eBPF program의 type과 붙은 event에 따라 달라진다 — 이런 정보를 kernel 안에서 동기적 context switch 없이 곧바로 모을 수 있다는 점이 eBPF가 observability 도구로 강한 핵심 이유다.
원문 예제에는 bpf_probe_read_kernel()로 문자열 필드를 하나 더 복사해 넣는 부분이 있지만(이 helper는 커널 메모리의 값을 eBPF program이 쓸 struct 필드로 안전하게 복사할 때 쓴다 — eBPF program은 검증되지 않은 포인터를 직접 역참조할 수 없어 이런 전용 helper를 거쳐야 한다), 이 글은 “구조체 하나에 여러 필드를 묶어 event로 보낸다”는 흐름 자체에 집중하려고 pid·uid·command 세 필드로 단순화했다. 실제로 실행할 때 쓰는 코드(아래 실습 절에 있음)는 이 단순화 이전의 원본이다 — message 필드와 bpf_probe_read_kernel() 호출이 그대로 들어 있으니, 코드를 눈으로 볼 때와 실행할 때 파일이 다르다는 점을 미리 알아 둔다.
output.perf_submit()이 이 구조체를 perf buffer map에 써 넣는다. user space 쪽은 open_perf_buffer()로 콜백을 등록하고, perf_buffer_poll()을 반복 호출해 새 데이터가 있을 때마다 콜백을 실행한다 — 이때 BCC는 C 코드에서 본 struct data_t 정의를 그대로 이용해 전달된 바이트를 data.pid, data.uid, data.command처럼 필드 단위로 다시 해석해 콜백에 넘겨준다. 이 map은 Linux 5.8부터 쓸 수 있는 BPF ring buffer(BPF_MAP_TYPE_RINGBUF)와는 다른, 그보다 먼저 있었던 per-CPU perf buffer다. Linux 5.8이 보편화된 지금은 새 코드에서 ring buffer가 더 권장되는 경우가 많지만(CPU 코어 수만큼 버퍼를 나누는 perf buffer와 달리 단일 공유 버퍼를 쓰기 때문에 메모리를 덜 쓰고, event가 발생한 순서를 여러 CPU 사이에서도 더 쉽게 보존할 수 있다는 것이 주된 이유다), 이 장이 따라가는 책 예제는 BCC가 오래전부터 지원해 온 perf buffer를 쓴다. 두 buffer 모두 "읽기/쓰기 포인터가 있는 순환 버퍼" 모델을 쓴다 — 쓰기 포인터가 읽기 포인터를 추월할 만큼 데이터가 쌓이면 그 데이터는 기록되지 않고 drop counter가 증가해 유실을 알린다. buffer 크기는 event 발생 속도에 맞춰 조정해야 하며, 세부 구현 차이는 이번 글의 범위 밖이다.
hash map과 perf buffer 모두 kernel program이 쓰고 user space가 읽는다는 방향은 같지만, 데이터가 오가는 방식은 다르다.
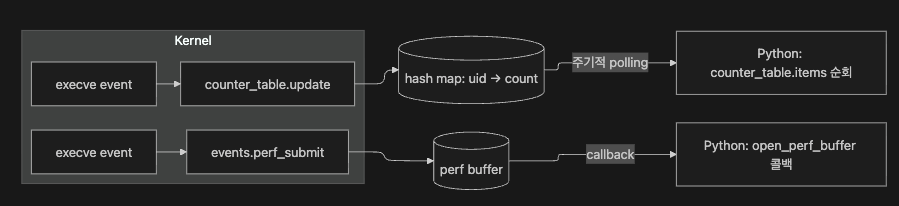
hash map 쪽은 user space가 필요할 때마다 map 전체를 조회하는 pull 방식이고, perf buffer 쪽은 kernel이 데이터를 밀어 넣으면 등록해 둔 콜백이 곧바로 실행되는 push에 가까운 방식이다. 어떤 map을 쓸지는 “누적된 상태를 보고 싶은가, event가 발생한 그 순간의 구조화된 정보를 보고 싶은가”로 갈린다.
Function call 제약이 tail call을 이해하는 배경이다
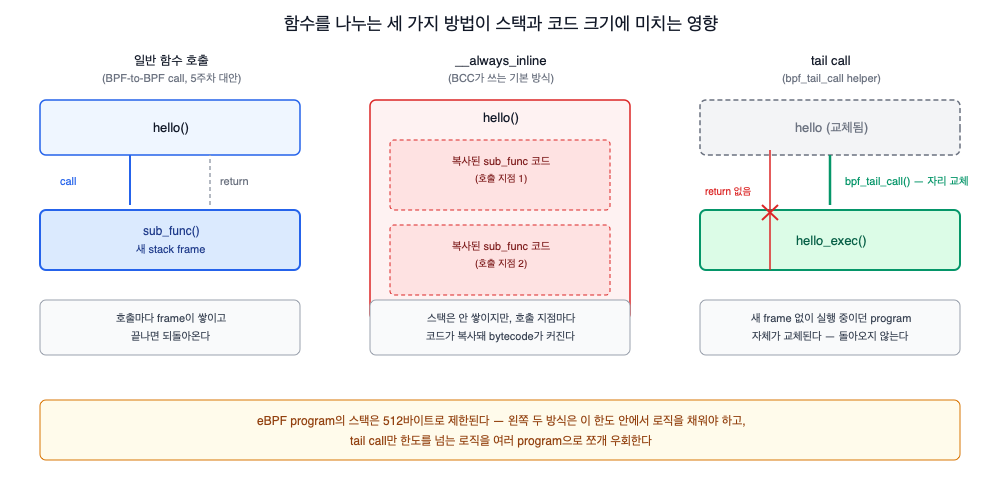
지금까지 본 예제는 모두 함수 하나(hello)로 끝났다. eBPF program을 여러 함수로 나누고 싶다면 어떻게 될까. 초기 eBPF는 helper 함수 호출 말고는 다른 함수 호출을 허용하지 않았고, 프로그래머들은 __always_inline을 강제로 붙여 컴파일러가 함수 호출을 만들지 않고 코드를 복사해 넣게 하는 방식으로 이 제약을 피했다.
이 제약은 Linux kernel 4.16과 LLVM 6.0부터 풀렸다 — eBPF program 안에서 다른 eBPF 함수(“subprogram”)를 direct call로 부를 수 있게 됐다. 다만 이 책이 예로 드는 BCC 프레임워크는 이 “BPF-to-BPF function call”을 지원하지 않는다고 설명한다. BCC로 함수를 나누고 싶다면 __always_inline을 써야 한다는 뜻이다 — 2026년 현재도 BCC가 이 상태인지는 확인하지 못했으므로 최신 지원 여부를 단정하지 않는다. 다른 프레임워크(libbpf 기반 CO-RE)에서는 사정이 다를 수 있다 — 이 차이는 5주차에서 다룬다.
다만 __always_inline은 함수 호출을 없애는 대신 대가를 치른다 — 컴파일러가 호출 지점마다 함수 본문을 그대로 복사해 넣으므로, 같은 함수를 여러 곳에서 부를수록 최종 bytecode는 그만큼 커진다. 이 크기는 뒤에서 볼 verifier의 complexity limit과 맞닿아 있다 — program 하나가 감당할 수 있는 로직의 양에는 한계가 있고, tail call은 그 한계를 program을 여러 개로 쪼개는 방식으로 피해 간다.
tail call은 이 BPF-to-BPF call과는 처음부터 별도로 있던 메커니즘이다 — Linux kernel 4.2부터 지원됐지만, 오랫동안 두 메커니즘을 한 program 안에서 같이 쓸 수 없었고 이 제약은 Linux 5.10에서 풀렸다. BCC로 여러 개의 독립적인 eBPF program을 엮고 싶을 때 쓰는 것이 바로 이 tail call이다.
Tail call은 다른 eBPF program으로 돌아오지 않는 점프다
tail call은 한 eBPF program이 다른 eBPF program을 실행하고 원래 program으로 돌아오지 않는 방식이다. 일반 함수 호출과 다르다 — 호출한 program의 스택 프레임을 새로 쌓지 않고, 실행 중이던 program 자체를 다른 program으로 교체한다.
이 동작은 프로세스의 execve와 성격이 닮았다 — 구현 방식은 전혀 다르지만, execve가 새 프로그램으로 프로세스 이미지를 그 자리에서 통째로 교체하고 원래 코드로 돌아오지 않는 것처럼, tail call도 새 스택 프레임을 쌓는 대신 실행 중이던 eBPF program 자체를 다른 program으로 그 자리에서 교체하고 원래 program으로 돌아오지 않는다. 공교롭게도 이 글이 처음부터 hook해 온 바로 그 syscall이다.
이 방식이 필요한 이유는 스택이다. eBPF program의 스택은 512바이트로 제한돼 있어서, 함수 호출을 거듭해 스택 프레임을 계속 쌓는 방식으로는 복잡한 로직을 감당하기 어렵다. tail call은 새 프레임을 쌓지 않고 program 자체를 교체하기 때문에 이 제한을 피해 여러 program으로 로직을 나눌 수 있다.
이 그림은 지금까지 본 세 가지 방식 — 일반 함수 호출, __always_inline, tail call — 이 스택과 코드 크기에 각각 어떤 영향을 주는지 나란히 비교한 것이다.
아래는 hello-tail.py의 program 문자열 중 핵심만 발췌했다 — 실제 파일에는 timer 관련 syscall을 처리하는 hello_timer, 나머지를 무시하는 ignore_opcode 두 함수가 더 있고 배열 크기도 500이다(전체 파일은 아래 실습 절에 있다). 아래는 그중 opcode에 따라 처리가 갈라지는 핵심 로직만 보여준다.
BPF_PROG_ARRAY(syscall, 500);

int hello(struct bpf_raw_tracepoint_args *ctx) {
    int opcode = ctx->args[1];
    syscall.call(ctx, opcode);
    bpf_trace_printk("Another syscall: %d", opcode);
    return 0;
}

int hello_exec(void *ctx) {
    bpf_trace_printk("Executing a program");
    return 0;
}BPF_PROG_ARRAY는 eBPF program의 file descriptor를 값으로 담는 특수한 map이다. hello는 모든 syscall의 공통 진입점인 sys_enter raw tracepoint에 붙는다. raw tracepoint의 context는 struct bpf_raw_tracepoint_args 형태이고, syscall opcode(커널이 각 syscall에 매긴 고유 번호 — CPU 명령어의 opcode와는 다른 뜻이다)는 ctx->args[1]에 있다. syscall.call(ctx, opcode)가 BCC 문법이고, 컴파일 전 단계에서 실제로는 bpf_tail_call() helper 호출로 바뀐다.
tail call 대상 program도 hello와 같은 program/attach type(여기서는 raw tracepoint)을 만족해야 한다 — 아무 eBPF program으로나 점프할 수 있는 것은 아니다. 아래 hello_exec가 void *ctx로 선언된 것은 raw tracepoint의 인자를 실제로 쓰지 않아 단순하게 표기했을 뿐, program type 제약 자체가 없어지는 것은 아니다.
user space 코드가 syscall[execve의 opcode] = hello_exec의 file descriptor처럼 program array(syscall map)에 항목을 채워 넣는다. opcode에 해당하는 항목이 있으면 tail call이 그 program으로 넘어가 실행하고 원래 hello로 돌아오지 않는다. 항목이 없으면 tail call은 그냥 실패하고, hello는 다음 줄(bpf_trace_printk("Another syscall..."))을 계속 실행한다.
다만 실제 실행 파일(아래 실습 절의 hello-tail.py)은 이 항목을 채우기 전에 배열 500칸 전부를 ignore_opcode(아무 것도 안 하고 반환하는 program)로 먼저 채운 뒤, execve(59)와 timer 관련 syscall(222-226) 6개만 hello_exec/hello_timer로 덮어쓴다. 그래서 이 실습에서는 대부분의 syscall에서 tail call이 (내용이 없더라도) "성공"해 ignore_opcode로 넘어가고, 방금 설명한 "항목이 없어 실패하는" 경로는 사실상 관측되지 않는다 — 아래 다이어그램은 두 경로의 개념을 보여줄 뿐, 이 실습 코드에서 어느 쪽이 더 자주 일어나는지를 그대로 나타내지는 않는다.
sys_enter에서 opcode에 따라 다른 program으로 어떻게 갈라지는지 그리면 다음과 같다.
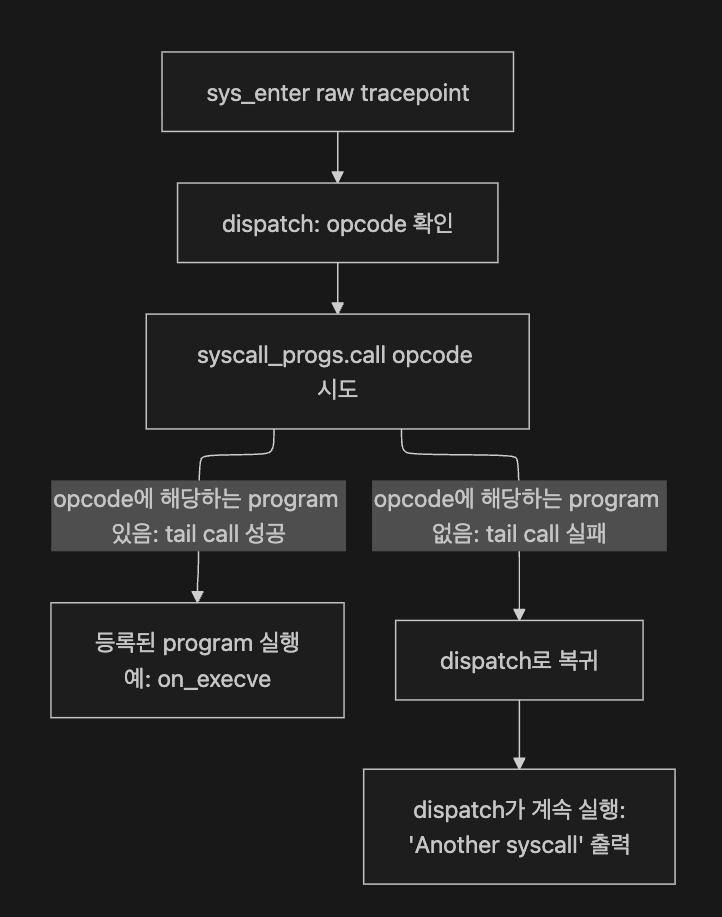
hello는 opcode를 미리 판단하지 않고 매번 syscall.call(ctx, opcode)(tail call)를 시도한다. program array에 그 opcode에 해당하는 program이 등록돼 있으면 tail call이 성공해 그 program으로 넘어가고 hello로 돌아오지 않는다(Lookup → Other). 등록돼 있지 않으면 tail call은 실패하고 hello로 실행이 돌아와 나머지 코드를 계속 실행한다(Lookup → Fallback → Default). 이 성공/실패는 hello가 미리 아는 것이 아니라 tail call을 시도한 결과로 정해진다.
한 가지 유의할 점은 opcode 숫자다. syscall 번호는 architecture마다 다르게 배정되므로, 특정 숫자(예: execve의 opcode)를 코드에 그대로 쓰면 x86_64가 아닌 환경에서는 다른 syscall을 가리킬 수 있다. 이식성이 필요하면 숫자 대신 이름으로 조회하는 방식을 써야 한다.
tail call 연쇄 횟수에는 상한이 있다 — 커널 상수 MAX_TAIL_CALL_CNT는 33이다. 이 상수는 Linux 5.16(2022-01)에 32에서 33으로 바뀌었지만, 해당 커밋 원문에 따르면 실제 동작을 바꾼 변경이 아니라 인터프리터와 대부분의 JIT(x86-64 등)가 이미 허용하던 33에 상수를 맞춘 정정이다 — 32비트 x86 JIT만 이때 실제로 32에서 33으로 늘었다. 정확히 몇 개의 program이 실행되는지까지 단정하지는 않는다. 이 상한 덕분에 하나의 program이 감당하기엔 큰 로직을 여러 program으로 쪼갤 여지가 생긴다. 이 여지가 의미 있는 이유는 verifier가 program 하나를 분석할 때 정적 명령어 개수가 아니라 탐색 가능한 명령어 수(complexity limit)로 제한을 두기 때문이다 — 이 제한이 정확히 무엇을 재는지는 6주차 verifier 글에서 더 다룬다.
BCC가 감춘 일은 다음 주차의 질문이다
네 예제 모두 BPF(text=program) 한 줄 뒤에 compile, load, map 생성이 숨어 있고, 그 다음에 오는 attach_kprobe()(또는 raw tracepoint attach) 호출이 attach를 맡는다. load 과정에는 verifier가 끼어 있다는 사실만 여기서 짚는다 — 커널에 올라가기 전에 이 program이 안전한지 정적으로 검사하는 단계가 있다는 것. 이 검사가 정확히 무엇을 거절하는지는 6주차로 넘긴다.
compile부터 load, attach, map 생성/읽기까지 BCC가 대신 해 주는 각 단계, 그리고 그 밑에 있는 bpf() syscall의 실제 인터페이스는 3주차(eBPF program의 구조)와 4주차(bpf() syscall)에서 하나씩 연다. BCC가 매번 새로 컴파일하는 방식은 배포 편의성과 맞바꾼 비용이기도 하다 — 이 비용과 대안(CO-RE, libbpf)은 5주차에서 다룬다.
여기까지 네 예제(hello.py, hello-map.py, hello-buffer.py, hello-tail.py)의 코드를 하나씩 코드 단위로 뜯어봤다. 이제 직접 돌려서 눈으로 확인할 차례다.
실습 환경은 preview를 따른다
공통 실습 환경(Linux VM 필요성, Lima/WSL2 선택 근거)은 preview를 따른다.
이 장의 코드는 chapter2 디렉터리에 있고, BCC(BPF Compiler Collection)를 쓴다. 이 장 예제는 kprobe와 raw tracepoint 같은 tracing 계열에만 붙는다 — 최신 커널의 capability 분리 기준으로는 CAP_BPF와 CAP_PERFMON 조합에 해당하고, networking program에 필요한 CAP_NET_ADMIN은 이 장에서 쓰지 않는다.
네 예제를 끝까지 실행해 본다
아래 명령은 preview로 만든 셸(Lima VM이든 WSL2 Ubuntu-26.04든) 안에서 그대로 동작한다. 둘 다 같은 Ubuntu 26.04 userspace(apt 패키지, Python 버전)를 쓰므로 설치·실행 명령이 갈릴 이유가 없다 — Windows에서만 코드를 /mnt/c/...가 아니라 WSL Linux 홈 디렉터리(~) 아래에서 받는다는 점만 다르다. 다만 WSL2는 커널 자체가 Ubuntu 커널이 아니라 Microsoft가 관리하는 별도의 WSL2 Linux kernel이라는 점은 week00을 참고한다.
BCC를 설치하고 예제 코드를 받는다
sudo apt-get update
sudo apt-get install -y python3-bpfcc bpfcc-tools
python3 -c 'from bcc import BPF; print("bcc ok")'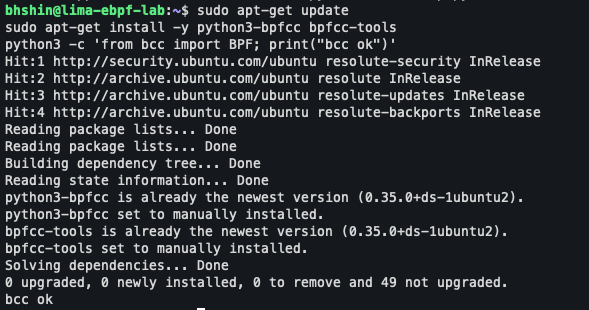
bpfcc-tools와 python3-bpfcc는 Ubuntu/Debian이 BCC를 배포하는 실제 패키지 이름이다(upstream 이름 bcc-tools가 아니라 bpfcc-tools로 바뀌어 있다). week00의 Lima VM(macOS·Linux 호스트) 경로는 이미 linux-headers-$(uname -r)를 설치해 뒀으므로 BCC의 런타임 컴파일에 필요한 헤더가 준비돼 있다. WSL2 경로는 사정이 다르다 — WSL2 커널용 linux-headers 패키지가 일반 apt 저장소에 없어 같은 명령으로 설치할 수 없는 사례가 실제로 보고돼 있다(iovisor/bcc#5046). 이 경우 week00의 WSL2 “자주 틀리는 지점”에 나온 kheaders 경로를 먼저 확인한다.
이제 예제 파일을 받는다. 아래 clone 명령까지 실행해야 이후 실습 명령이 그대로 동작한다.
git clone --depth=1 https://github.com/lizrice/learning-ebpf.git
cd learning-ebpf/chapter2
아래 네 코드 블록은 방금 받은 파일의 내용을 확인하기 위한 것이며, 직접 타이핑해서 새로 만들 필요는 없다.
- hello.py
#!/usr/bin/env python3
from bcc import BPF
import sys

program = r"""
int hello(void *ctx) {
    bpf_trace_printk("Hello World!");
    return 0;
}
"""

b = BPF(text=program)
syscall = b.get_syscall_fnname("execve")
b.attach_kprobe(event=syscall, fn_name="hello")

try:
    b.trace_print()
except KeyboardInterrupt:
sys.exit(0)- hello-buffer.py
#!/usr/bin/env python3
from bcc import BPF

program = r"""
BPF_PERF_OUTPUT(output);

struct data_t {
   int pid;
   int uid;
   char command[16];
   char message[12];
};

int hello(void *ctx) {
   struct data_t data = {};
   char message[12] = "Hello World";

   data.pid = bpf_get_current_pid_tgid() >> 32;
   data.uid = bpf_get_current_uid_gid() & 0xFFFFFFFF;

   bpf_get_current_comm(data.command, sizeof(data.command));
   bpf_probe_read_kernel(data.message, sizeof(data.message), message);

   output.perf_submit(ctx, &data, sizeof(data));

   return 0;
}
"""

b = BPF(text=program)
syscall = b.get_syscall_fnname("execve")
b.attach_kprobe(event=syscall, fn_name="hello")

def print_event(cpu, data, size):
   data = b["output"].event(data)
   print(f"{data.pid} {data.uid} {data.command.decode()} {data.message.decode()}")

b["output"].open_perf_buffer(print_event)
while True:
   b.perf_buffer_poll()
- hello-map.py
#!/usr/bin/env python3
from bcc import BPF
from time import sleep

program = r"""
BPF_HASH(counter_table);

int hello(void *ctx) {
   u64 uid;
   u64 counter = 0;
   u64 *p;

   uid = bpf_get_current_uid_gid() & 0xFFFFFFFF;
   p = counter_table.lookup(&uid);
   if (p != 0) {
      counter = *p;
   }
   counter++;
   counter_table.update(&uid, &counter);
   return 0;
}
"""

b = BPF(text=program)
syscall = b.get_syscall_fnname("execve")
b.attach_kprobe(event=syscall, fn_name="hello")

# Attach to a tracepoint that gets hit for all syscalls
# b.attach_raw_tracepoint(tp="sys_enter", fn_name="hello")

while True:
    sleep(2)
    s = ""
    for k,v in b["counter_table"].items():
        s += f"ID {k.value}: {v.value}\t"
    print(s)
- hello-tail.py
#!/usr/bin/env python3
from bcc import BPF
import ctypes as ct

program = r"""
BPF_PROG_ARRAY(syscall, 500);

int hello(struct bpf_raw_tracepoint_args *ctx) {
    int opcode = ctx->args[1];
    syscall.call(ctx, opcode);
    bpf_trace_printk("Another syscall: %d", opcode);
    return 0;
}

int hello_exec(void *ctx) {
    bpf_trace_printk("Executing a program");
    return 0;
}

int hello_timer(struct bpf_raw_tracepoint_args *ctx) {
    int opcode = ctx->args[1];
    switch (opcode) {
        case 222:
            bpf_trace_printk("Creating a timer");
            break;
        case 226:
            bpf_trace_printk("Deleting a timer");
            break;
        default:
            bpf_trace_printk("Some other timer operation");
            break;
    }
    return 0;
}

int ignore_opcode(void *ctx) {
    return 0;
}
"""

b = BPF(text=program)

ignore_fn = b.load_func("ignore_opcode", BPF.RAW_TRACEPOINT)
exec_fn = b.load_func("hello_exec", BPF.RAW_TRACEPOINT)
timer_fn = b.load_func("hello_timer", BPF.RAW_TRACEPOINT)

prog_array = b.get_table("syscall")

# Ignore all syscalls initially
for i in range(len(prog_array)):
    prog_array[ct.c_int(i)] = ct.c_int(ignore_fn.fd)

# Only enable few syscalls which are of interest
prog_array[ct.c_int(59)] = ct.c_int(exec_fn.fd)
prog_array[ct.c_int(222)] = ct.c_int(timer_fn.fd)
prog_array[ct.c_int(223)] = ct.c_int(timer_fn.fd)
prog_array[ct.c_int(224)] = ct.c_int(timer_fn.fd)
prog_array[ct.c_int(225)] = ct.c_int(timer_fn.fd)
prog_array[ct.c_int(226)] = ct.c_int(timer_fn.fd)
b.attach_raw_tracepoint(tp="sys_enter", fn_name="hello")

b.trace_print()
위 네 파일은 모두 방금 받은 chapter2 디렉터리 안에 있다. 아래부터는 이 디렉터리 안에서 실행한다고 가정한다.
아래 네 예제는 모두 같은 방식으로 실행한다. 터미널 A에서 sudo python3 <파일명>을 실행하면 프롬프트가 곧바로 돌아오지 않는데, 이는 프로그램이 event를 계속 기다리는 정상 상태다. 그 상태로 터미널 B(같은 셸에 새로 접속)에서 실제 실행 파일을 호출해 이벤트를 만든다 — echo처럼 shell에 내장된 명령은 새 프로세스를 만들지 않아 잡히지 않으므로, /bin/ls나 /usr/bin/id처럼 경로가 있는 실행 파일을 쓴다. 한 예제를 확인했으면 터미널 A에서 Ctrl+C로 종료하고 다음 예제로 넘어간다. 명령 끝의 >/dev/null은 그 명령 자신의 출력만 화면에서 숨기는 것이고, eBPF가 관측하는 execve 이벤트 자체에는 영향을 주지 않는다.
hello.py — 가장 단순한 kprobe
# 터미널 A
sudo python3 hello.py
# 터미널 B
/bin/ls >/dev/null
/usr/bin/id >/dev/null터미널 A에 아래와 비슷한 줄이 찍힌다(PID·CPU·timestamp는 환경마다 다르다).
... bpf_trace_printk: Hello World!메시지가 보이면 Ctrl+C로 종료하고 다음 예제로 넘어간다.
hello-map.py — UID별 누적 카운터
# 터미널 A
sudo python3 hello-map.py
# 터미널 B
/bin/ls >/dev/null
sudo /usr/bin/id >/dev/null터미널 A에는 2초 간격으로 UID별 누적 횟수가 탭으로 구분돼 출력된다(이벤트가 없어도 계속 출력된다).
ID 1000: 3 ID 0: 1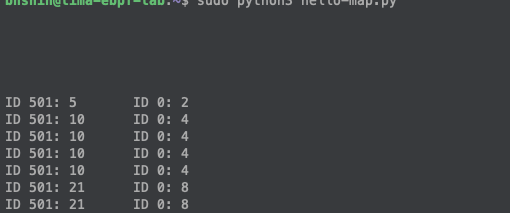
1000은 VM/배포판 기본 사용자 UID, 0은 sudo로 실행한 root다. 정확한 UID는 id -u로 확인한다.
hello-buffer.py — 구조화된 이벤트
# 터미널 A
sudo python3 hello-buffer.py
# 터미널 B
/bin/ls >/dev/null터미널 A에는 pid uid command message 순서로 한 줄씩 찍힌다.
12345 1000 ls Hello World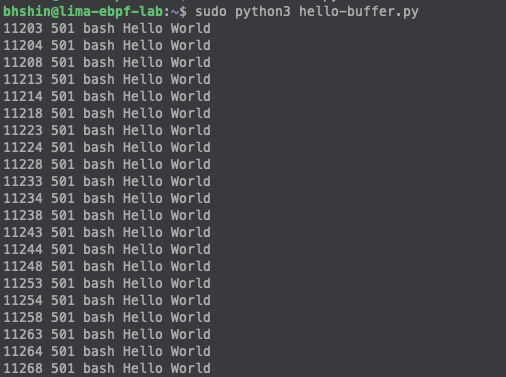
hello-tail.py — syscall opcode에 따른 분기
실행 전에 uname -m으로 현재 환경이 x86_64인지 aarch64인지 확인해 둔다(Apple Silicon 위의 Lima VM은 기본값이 aarch64다). aarch64라면 아래 명령을 그대로 실행해도 책과 같은 출력이 나오지 않는다 — 먼저 아래 “자주 틀리는 지점”의 aarch64 opcode 수정 방법을 적용한 뒤 실행한다.
uname -m# 터미널 A
sudo python3 hello-tail.py# 터미널 B
/bin/ls >/dev/null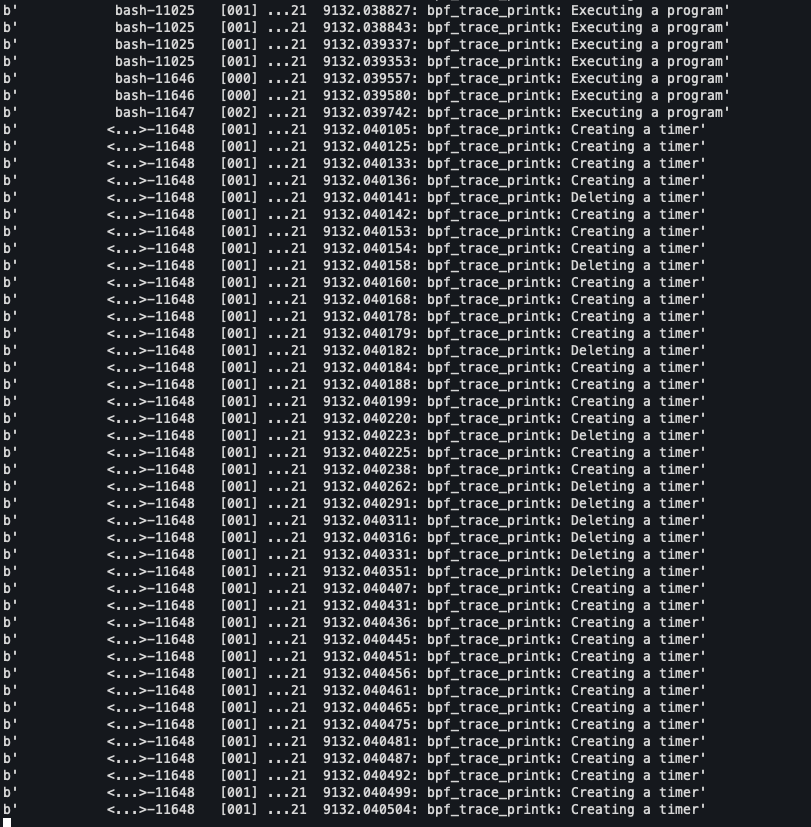
x86_64 환경이면 터미널 A에 아래와 같이 찍힌다.
... bpf_trace_printk: Executing a program확인
python3 -c 'from bcc import BPF; print("bcc ok")'가bcc ok를 출력한다.hello.py실행 중/bin/ls를 실행하면Hello World!트레이스가 찍힌다.hello-map.py는 UID별 counter가 2초마다 출력되고, 명령을 실행할수록 값이 늘어난다.hello-buffer.py는pid uid command message형태의 구조화된 이벤트를 출력한다.- x86_64 환경이라면
hello-tail.py실행 중Executing a program이 출력된다.
자주 틀리는 지점
먼저 아래 네 줄을 확인한다.
uname -m
pwd
python3 -c 'from bcc import BPF; print("bcc ok")'
sudo python3 -c 'from bcc import BPF; print("sudo bcc ok")'
마지막 두 줄이 모두 ... ok를 출력하지 않으면 아래 ModuleNotFoundError 항목을 먼저 본다. pwd가 chapter2가 아니면 실행 파일을 찾지 못해 No such file or directory 에러가 난다.
셸 자체의 문제(커널 헤더, Operation not permitted, trace pipe 등)는 week00의 “자주 틀리는 지점”을 먼저 본다. 아래는 BCC와 이 장 예제에 한정된 문제다.
hello-tail.py가 aarch64에서 Executing a program 대신 Creating a timer 같은 엉뚱한 메시지를 찍는다
hello-tail.py는 execve의 syscall opcode를 59로 하드코딩한다 — x86_64 syscall table 기준이다. aarch64에서 execve의 실제 syscall 번호는 221이라서, 코드를 고치지 않으면 opcode 59(aarch64에서는 다른 syscall)가 execve로 오인되고 Executing a program은 찍히지 않는다. 이 문제는 macOS·Windows·Linux라는 호스트 OS 차이가 아니라 VM/WSL2가 실제로 어떤 CPU 아키텍처로 도는지에 달려 있다 — Apple Silicon과 aarch64 Linux 호스트는 기본값이 aarch64이고, WSL2는 거의 항상 x86_64라서 이 문제가 드물다.
같은 이유로 timer 관련 opcode(x86_64 기준 222-226, timer_create~timer_delete)도 aarch64에서는 다른 syscall을 가리킨다 — 특히 222는 aarch64에서 mmap이다(aarch64의 실제 timer_create/timer_delete는 각각 107/111). 새 프로그램을 실행할 때마다 공유 라이브러리 매핑으로 자주 호출되는 mmap이 hello_timer로 잘못 라우팅돼 Creating a timer 같은 메시지가 반복적으로 찍힐 수 있다 — 단순히 "출력이 안 보이는" 정도가 아니라 오해를 부르는 출력이 나온다는 뜻이다.
| syscall | x86_64 opcode | aarch64 opcode |
|---|---|---|
execve | 59 | 221 |
mmap | — | 222 |
timer_create | 222 | 107 |
timer_delete | 226 | 111 |
chapter2/hello-tail.py의prog_array[ct.c_int(59)]를prog_array[ct.c_int(221)]로, timer 관련 4줄(222/223/224/225/226)도 aarch64 번호(timer_create계열은107부터 시작)로 맞춰 aarch64용으로 직접 고친다 —59만 고치면execve오탐지는 없어지지만222(aarch64의mmap)가 여전히 timer opcode로 잘못 등록된 채 남는다.- 코드를 고치지 않고 책과 동일한 출력을 보고 싶다면, week00의
ebpf-lab.yaml에arch: x86_64를 추가한 뒤 VM을 새로 만든다(Lima 전용 옵션이다 — WSL2에는 이 옵션이 없다).
아래 “syscall 번호는 architecture마다 다르게 배정된다”는 설명을 직접 겪어보는 예제이기도 하다.
hello-tail.py를 실행해도 Another syscall: N이 거의 안 보인다
2026-07-13 기준 GitHub chapter2/hello-tail.py는 BPF_PROG_ARRAY(syscall, 500)의 500개 항목을 먼저 전부 ignore_opcode(아무 것도 안 하고 반환하는 handler)로 채운 뒤, execve(59)와 timer 관련 syscall(222-226) 항목만 hello_exec/hello_timer로 덮어쓴다. 이 경우 대부분의 syscall에서 tail call은 (내용이 없더라도) “성공”해서 ignore_opcode로 넘어가므로, 아래에서 설명하는 “항목이 없어 tail call이 실패했을 때”의 Another syscall: N 출력 경로는 이 버전에서 사실상 발생하지 않는다. 개념 자체는 정확하지만, 지금 GitHub 코드로 그 fallback 경로를 직접 보려면 ignore_opcode 할당 루프를 지우거나 일부 syscall 번호를 프로그램 배열에서 빼야 한다.
ModuleNotFoundError: No module named 'bcc'
python3-bpfcc가 시스템 Python에만 연결돼 있다. pyenv/venv 안에서 실행하면 이 에러가 난다. 가상환경 밖에서 시스템 python3(또는 sudo python3)로 실행한다.
/usr/bin/python3 -c 'from bcc import BPF; print("bcc ok")'WSL2에서 hello-buffer.py의 PID가 ps와 정확히 맞지 않는다
WSL2는 각 배포판을 별도의 child PID namespace에서 실행하는 반면 eBPF 프로그램은 root(top-level) PID namespace 기준의 PID/TGID를 본다. 이 구조적 차이 때문에 bpf_get_current_pid_tgid()가 보고하는 값이 배포판 안 ps/ls 출력과 어긋나는 사례가 실제로 보고돼 있다(microsoft/WSL#12408, 근본 원인 설명 있음 — 버그 수정이 아니라 1년 무활동으로 자동 종료됨). Lima VM에는 이 이슈가 없다 — VM 전체가 하나의 PID namespace이기 때문이다. 이 예제에서는 PID 정확한 매칭보다 “ls 실행 시 구조화된 이벤트가 도착하는지”를 성공 기준으로 둔다.
직접 바꿔볼 것
원문은 다섯 가지 변형 과제를 제안한다. 전부 풀지 않더라도 방향만 옮겨 적는다.
- perf buffer 예제를 process ID의 홀짝에 따라 다른 메시지를 내도록 바꿔 본다.
- hash map 예제를
execve말고 다른 syscall(예:openat,write)에도 붙여 같은 map을 여러 program이 공유하게 만들어 본다. - hash map 예제를
sys_enterraw tracepoint에 붙여, user ID별 “execve 횟수”가 아니라 “전체 syscall 횟수”를 세도록 바꿔 본다. RAW_TRACEPOINT_PROBEmacro를 써서hello-tail.py류 예제의 attach 코드를 줄여 본다. BCC가 tracepoint 이름만으로 attach를 대신 처리해 준다는 걸 확인할 수 있다.- hash map의 key를 user ID가 아니라 syscall 번호로 바꿔서, 시스템 전체에서 어떤 syscall이 가장 많이 호출되는지 세어 본다.
2주차에서 남길 모델
- eBPF program은 helper 함수를 부르는 C 함수 하나로 시작하고, 필요하면 tail call로 다른 program과 엮인다. 책이 예로 드는 BCC 기준으로는 함수 사이의 일반적인 호출을
__always_inline으로 처리해야 한다. - map은 kernel program과 user space code가 공유하는 데이터 구조이며, hash map처럼 상태를 누적하는 용도와 perf buffer처럼 구조화된 event를 흘려보내는 용도로 나뉜다. kernel program이 쓰고 user space가 읽는 역할 분담은 두 map type 모두 같다.
- loader(user space Python 코드)는 컴파일·로드·attach·map 읽기를 맡고, eBPF program(C 코드)은 event가 발생했을 때 실행되는 로직만 맡는다. 이 분리는 BCC가 감추고 있을 뿐, 3주차부터는 이 분리를 코드 레벨에서 직접 다룬다.
verifier가 정확히 무엇을 거절하는가라는 질문은 여전히 남아 있다. 이 질문은 6주차에서 다룬다.
용어
- BCC(BPF Compiler Collection): Python(또는 다른 언어) 코드 안에 C로 작성한 eBPF program을 문자열로 담아 즉석에서 컴파일·로드·attach하는 프레임워크. 학습과 빠른 프로토타이핑에 적합하지만, 실행마다 컴파일해야 해서 프로덕션 배포에는 CO-RE 기반 libbpf가 더 널리 쓰인다.
- context(ctx): eBPF program이 event에 붙어 실행될 때 커널이 넘겨주는 인자 뭉치를 가리키는 포인터. kprobe에서는 레지스터 상태, raw tracepoint에서는
struct bpf_raw_tracepoint_args처럼 hook 종류마다 실제 타입이 다르다.hello.py처럼 이 값을 안 쓰는 예제에서는 범용 포인터(void *)로만 선언한다. - trace_pipe:
bpf_trace_printk()가 남긴 문자열을 커널이 모아 두는 공용 pseudo 파일. 배포판에 따라/sys/kernel/debug/tracing/trace_pipe또는/sys/kernel/tracing/trace_pipe경로를 쓴다. - BPF_HASH: BCC가 제공하는 hash map 정의 macro. key-value 쌍을 저장하며, event 사이에 상태를 누적하는 용도로 쓴다.
- perf buffer: kernel program이 구조화된 event를 user space로 스트리밍하는 per-CPU 순환 버퍼. Linux 5.8부터 쓸 수 있는 BPF ring buffer의 이전 세대 메커니즘이며, 최근에는 ring buffer가 더 권장되는 경우가 많다.
- tail call: 한 eBPF program이 다른 eBPF program을 실행하고 원래 program으로 돌아오지 않는 점프. 연쇄 횟수 상한은 커널 상수
MAX_TAIL_CALL_CNT(현재 33)로 정해진다. - program array: eBPF program의 file descriptor를 값으로 담는 map. tail call이 다음에 실행할 program을 찾을 때 이 map을 조회한다.
- raw tracepoint: 커널이 미리 정의해 둔 이벤트 지점 중, 커널이 넘겨주는 원본 인자에 그대로 접근할 수 있는 attach 방식.
sys_enter는 모든 syscall 진입 시점에 공통으로 걸리는 raw tracepoint다. - CAP_PERFMON, CAP_NET_ADMIN: Linux capability. tracing program을 로드하려면
CAP_BPF와CAP_PERFMON이, networking program을 로드하려면CAP_BPF와CAP_NET_ADMIN이 함께 필요하다. - TGID(Thread Group ID): 같은 프로세스에 속한 모든 스레드가 공유하는 식별자로, user space가 보통 “process ID”라고 부르는 값과 같다. 개별 스레드의 kernel PID(=thread ID)와는 다른 값이다.
참고 자료와 이미지 출처
이 글의 로컬 SVG 다이어그램은 BCC 예제 코드 흐름과 아래 자료의 개념 설명을 참고해 직접 작성했다.
- Liz Rice,
Learning eBPF, Chapter 2: https://www.oreilly.com/library/view/learning-ebpf/9781098135119/ch02.html - Liz Rice,
What Is eBPF?, O’Reilly - Brendan Gregg,
BPF Performance Tools - BCC 프로젝트: https://github.com/iovisor/bcc
- BCC 설치 안내: https://github.com/iovisor/bcc/blob/master/INSTALL.md
- BCC reference guide: https://github.com/iovisor/bcc/blob/master/docs/reference_guide.md
- Learning eBPF 예제 코드(2장): https://github.com/lizrice/learning-ebpf (이 저장소의
code/에도 원본 그대로 포함, Apache License 2.0) - Rust eBPF 프레임워크 aya: https://aya-rs.dev/
- Go eBPF 프레임워크 cilium/ebpf: https://github.com/cilium/ebpf
- Linux
bpf(2)manual: https://man7.org/linux/man-pages/man2/bpf.2.html - Linux
capabilities(7)manual: https://man7.org/linux/man-pages/man7/capabilities.7.html - Linux kernel BPF maps 문서: https://docs.kernel.org/bpf/maps.html
- Linux kernel BPF ring buffer 문서: https://docs.kernel.org/bpf/ringbuf.html
- Linux kernel BPF Design Q&A(verifier complexity/instruction limit): https://docs.kernel.org/bpf/bpf_design_QA.html
- eBPF Docs, Linux: https://docs.ebpf.io/linux/
- eBPF Docs,
bpf_trace_printk: https://docs.ebpf.io/linux/helper-function/bpf_trace_printk/ - eBPF Docs,
bpf_get_current_pid_tgid: https://docs.ebpf.io/linux/helper-function/bpf_get_current_pid_tgid/ - eBPF Docs, tail calls: https://docs.ebpf.io/linux/concepts/tail-calls/
- eBPF Docs, functions/BPF-to-BPF calls: https://docs.ebpf.io/linux/concepts/functions/
- eBPF Docs,
BPF_MAP_TYPE_PROG_ARRAY: https://docs.ebpf.io/linux/map-type/BPF_MAP_TYPE_PROG_ARRAY/ - Cilium BPF and XDP Reference Guide(Linux 4.16 + LLVM 6.0 function call 지원 서술): https://docs.cilium.io/en/stable/reference-guides/bpf/architecture/
- Andrii Nakryiko, BPF ring buffer: https://nakryiko.com/posts/bpf-ringbuf/
- Alexei Starovoitov, BPF trampoline/fentry/fexit 관련 패치 노트: https://lwn.net/Articles/804937/
- Linux 커널 커밋,
MAX_TAIL_CALL_CNT32→33 정정(Tiezhu Yang, 2021, Linux 5.16): https://github.com/torvalds/linux/commit/ebf7f6f0a6cdcc17a3da52b81e4b3a98c4005028 - Linux 커널 커밋, 인터프리터 tail call count off-by-one 관련 배경(Daniel Borkmann, 2021): https://github.com/torvalds/linux/commit/f9dabe016b63c9629e152bf876c126c29de223cb