C 파일이 object file이 되고, load된 뒤, attach되어 실행되는 흐름 보기
2주차의 BCC 예제에서는 BPF(text=program) 한 줄과 BCC helper 뒤에 많은 과정이 숨어 있었다.
3주차에서는 Learning eBPF 3장의 chapter3/hello.bpf.c 예제로 그 과정을 직접 펼쳐 본다.
이번 주차는 아래 흐름을 끝까지 따라가면 된다.
source -> object -> load -> attach
소스 파일은 아직 실행되는 program이 아니다.
object file은 커널 밖에 있는 파일이고, load된 program도 attach되기 전에는 호출되지 않는다.
이 차이를 잡으면 bpftool 출력이 훨씬 덜 낯설어진다.
처음에는 네 가지만 확인한다.
- C 함수가 object file 안에서 어떤 section으로 표시되는가?
- object file 안의 bytecode에서 return value는 어떻게 보이는가?
- load된 program과 attach된 program은 무엇이 다른가?
- 전역 변수
counter는 왜 map처럼 보이는가?
bpf() syscall의 세부 인자, BTF/CO-RE, verifier 내부 규칙, XDP packet parsing은 뒤 주차에서 다룬다.
여기서는 eBPF program의 상태가 어떻게 바뀌는지에만 집중한다.
핵심 모델은 source, object, loaded program, attached program이다
명령을 실행하기 전에 상태를 네 개로 나눠 둔다.
hello.bpf.c는 사람이 읽는 C 소스다.hello.bpf.o는 eBPF bytecode를 담은 ELF object file이다.bpftool prog load는 object file 안의 program을 verifier를 거쳐 커널에 load한다.bpftool net attach는 load된 program을 특정 network interface의 XDP hook에 attach한다.
이 네 단계를 섞으면 eBPF program의 상태를 잘못 읽기 쉽다.
load만 된 program은 커널 안에 존재하지만 아직 어떤 event도 그 program을 호출하지 않는다.
반대로 attach는 이미 load된 program을 event 지점에 연결하는 작업이다.
3주차는 이 차이를 분리해서 보는 데서 시작한다.
이 그림은 C 소스가 eBPF bytecode와 JIT machine code로 변환되고, 각 단계에서 어떤 명령으로 확인할 수 있는지 보여준다.

llvm-objdump는 object file에 들어 있는 bytecode를 본다.
bpftool prog dump xlated는 커널에 load된 뒤 verifier를 통과한 translated bytecode를 본다.
bpftool prog dump jited는 JIT 컴파일 뒤 CPU가 실행할 machine code를 본다.
세 출력은 같은 program을 서로 다른 지점에서 보는 창이다.
예제 코드와 도구를 준비한다
실습은 week00의 Linux 환경에서 진행한다고 가정한다.
책 예제 저장소를 새로 받는다면 chapter3 디렉터리로 들어간다.
git clone https://github.com/lizrice/learning-ebpf.git
cd learning-ebpf
git checkout 91ded4ac7b188de02cdad24a743d4d18a6898cc2
cd chapter3
필요한 도구는 배포판마다 이름이 조금 다르다.
Ubuntu/Debian 계열에서는 보통 아래 조합으로 시작한다.
sudo apt-get update
sudo apt-get install -y clang llvm libbpf-dev bpftool make gcc
실습 코드는 Liz Rice의 learning-ebpf/chapter3 예제를 기준으로 한다.
이 글에서 확인한 기준은 91ded4a 커밋이다.
현재 chapter3 디렉터리에는 Makefile, hello.bpf.c, hello-func.bpf.c가 있다.
README 기준으로는 이 디렉터리에서 make를 실행해 object file을 만든다.
이 글에서는 Makefile이 내부에서 실행하는 clang 명령까지 풀어서 본다.
SEC("xdp")와 함수 이름이 eBPF program의 표지가 된다
3장의 예제는 네트워크 패킷이 interface에 들어오는 순간 실행되는 XDP program이다.
핵심만 줄이면 구조는 이렇다.
#include <linux/bpf.h>
#include <bpf/bpf_helpers.h>

int counter = 0;

SEC("xdp")
int hello(struct xdp_md *ctx) {
    bpf_printk("Hello World %d", counter);
    counter++;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "Dual BSD/GPL";
이 코드에서 먼저 볼 것은 세 줄이다.
SEC("xdp"): 이 함수가 XDP program이라는 표시int hello(...): eBPF program의 이름return XDP_PASS: packet을 계속 통과시키겠다는 verdict
SEC("xdp")는 이 함수가 object file의 xdp section에 들어가야 한다는 표시다.
지금은 이 section 이름을 “이 program은 XDP 타입이다”라고 알려주는 표식으로 이해하면 된다.
section 이름을 libbpf가 어떻게 해석하고 attach 지점과 어떻게 연결하는지는 5주차에서 다시 본다.
eBPF에서 program 이름은 C 함수 이름이다.
위 예제의 program 이름은 hello다.
bpftool prog show name hello처럼 이름으로 조회할 수 있는 이유가 여기에 있다.
다만 이름은 고유하지 않을 수 있으므로, 운영 중인 시스템에서는 ID, tag, pinned path까지 같이 봐야 한다.
마지막 줄의 LICENSE section도 장식이 아니다.
커널의 일부 BPF helper는 GPL 호환 license를 선언한 program에서만 쓸 수 있다.
program type에 따라서도 GPL 호환 license가 요구될 수 있다.
선언한 license와 program이 호출하는 helper가 맞지 않으면 verifier가 load를 거절한다.
bpf_printk()는 libbpf 쪽 wrapper 이름이다.
2주차 BCC 예제의 bpf_trace_printk()와 이름은 다르지만, 둘 다 trace 출력용 helper를 감싼다.
kernel version과 libbpf macro 구현에 따라 내부 호출 모양은 달라질 수 있다.
여기서는 “trace 출력용 wrapper” 정도로만 보면 된다.
이 helper는 여전히 디버깅용 통로로 봐야 한다.
구조화된 event 전달은 2주차에서 본 perf buffer나 이후에 볼 ring buffer가 더 맞다.
eBPF bytecode는 register 위에서 움직인다
eBPF program은 최종적으로 eBPF bytecode instruction의 배열이 된다.
커널 소스의 include/uapi/linux/bpf.h에는 한 instruction을 나타내는 struct bpf_insn이 정의되어 있다.
각 instruction은 대략 opcode, destination register, source register, offset, immediate 값으로 구성된다.
여기서 bytecode를 전부 읽지는 않는다.
이번 예제에서는 return XDP_PASS가 bytecode에서 R0 = 2로 보인다는 점만 확인한다.
이때 register는 CPU의 실제 register가 아니라 eBPF virtual machine이 정의한 register다.
모델은 작다.
R0: program의 return valueR1: program 시작 시 context, helper/function call 시 첫 번째 인자R1-R5: helper/function call 인자R6-R9: 일반 용도의 callee-saved registerR10: stack frame pointer, 읽기 전용
이 그림은 bytecode가 실행되면서 register 값이 어떻게 바뀌는지 보여준다.

모든 register와 encoding을 한 번에 외울 필요는 없다.
처음에는 R0, R1, R10만 기억해도 출력 읽기를 시작할 수 있다.
R0은 return value이고, XDP program에서는 그 값이 packet 처리 결과가 된다.
R1은 program이 처음 받은 context이고, R10은 stack을 가리키는 기준점이다.
bpf_insn의 8바이트 구조는 뒤의 hex byte가 아무 숫자열이 아니라 하나의 instruction이라는 정도로만 읽고 넘어간다.
3장에서 눈여겨볼 줄은 두 개다(책 예시 출력, 실제 offset·바이트는 컴파일 옵션과 컴파일러 버전에 따라 달라질 수 있다).
5:  b7 02 00 00 0f 00 00 00  r2 = 15
10: b7 00 00 00 02 00 00 00  r0 = 2
첫 줄은 R2에 즉시값 15를 넣는다.
이 예제에서는 bpf_printk()에 넘기는 format string 길이와 연결된다.
두 번째 줄은 R0에 2를 넣는다.
XDP program에서 return value는 packet verdict이고, XDP_PASS의 값이 2이므로 커널은 이 packet을 평소처럼 계속 처리한다.
r0 = 2 줄을 조금 더 풀면 다음과 같다.
| 조각 | 값 | 의미 |
|---|---|---|
| opcode | b7 | 64-bit immediate 값을 register에 넣는 ALU instruction |
| register byte | 00 | destination register가 R0 |
| offset | 00 00 | 이 instruction에서는 사용하지 않음 |
| immediate | 02 00 00 00 | little endian 값 2 |
| 해석 | r0 = 2 | XDP program의 return value를 XDP_PASS로 설정 |
즉 hex byte 전체를 외울 필요는 없지만, 오른쪽의 r0 = 2가 임의의 주석이 아니라 instruction encoding을 사람이 읽기 쉽게 풀어 쓴 결과라는 점은 기억해 두면 좋다.
여기서 오해하기 쉬운 지점이 있다.
C에서는 return 0이 성공을 뜻하는 경우가 많지만, XDP program에서 0은 XDP_ABORTED다.
eth0에 붙은 XDP program이 모든 packet에 0을 반환하면 네트워크가 끊길 수 있다.
SSH로 접속한 VM에서 이 실험을 직접 하면 접속을 잃고 재부팅이 필요할 수 있으므로, 이 글의 실습에서는 XDP_PASS를 바꾸지 않는다.
object file은 ELF이고, 그 안의 section을 llvm-objdump로 본다
repo 기준으로는 make를 실행하면 된다.
makechapter3/Makefile은 hello.bpf.c와 hello-func.bpf.c를 각각 hello.bpf.o, hello-func.bpf.o로 컴파일한다.
이 글에서 주로 따라가는 대상은 XDP 예제인 hello.bpf.o다.
Makefile이 내부에서 실행하는 핵심 명령은 아래와 같다.
clang \
  -target bpf \
  -I/usr/include/$(uname -m)-linux-gnu \
  -g \
  -O2 \
  -c hello.bpf.c \
-o hello.bpf.o-g는 단순히 사람이 디버깅하기 편하게 하는 옵션만은 아니다.
이 옵션을 켜면 BTF 정보도 object file에 들어간다.
뒤에서bpftool map dump가counter같은 필드 이름을 보여줄 수 있는 것도 이 정보 덕분이다.
make를 썼든 위 clang 명령을 직접 실행했든, 생성된 object file을 먼저 file로 확인한다.
file hello.bpf.o성공하면 이 파일이 eBPF code를 담은 64-bit ELF relocatable object라는 식의 설명이 나온다.
이 단계에서 program은 아직 커널에 load되지 않았다.
단지 커널에 올릴 수 있는 형식의 파일이 생겼을 뿐이다.
다음은 object file 안의 instruction을 확인하는 명령이다.
llvm-objdump -S hello.bpf.o출력에서 먼저 Disassembly of section xdp와 <hello>를 찾는다.
이 두 줄이 보이면 SEC("xdp")가 object file section으로 남았고, 함수 이름 hello가 program entry로 잡혔다는 뜻이다.
출력 왼쪽의 offset은 instruction 위치다.
대부분의 eBPF instruction은 8바이트라 offset이 1씩 증가한다.
64비트 값을 넣는 wide instruction은 16바이트를 써서 다음 offset이 2만큼 이동한다.
이 단계에서 봐야 할 것은 assembly 전체가 아니다.
소스 코드의 세 줄이 어떤 바이트코드 덩어리로 낮아지는지만 보면 된다.
| C 소스 | bytecode에서 볼 단서 |
|---|---|
bpf_printk(...) | helper call, format string 주소, 길이 인자 |
counter++ | map-backed storage에서 값을 읽고 1을 더해 다시 저장 |
return XDP_PASS | R0에 2를 넣고 exit |
bpftool prog load는 program을 커널에 올리지만 실행시키지는 않는다
object file을 커널에 load한다.
sudo bpftool prog load hello.bpf.o /sys/fs/bpf/hello출력이 없으면 성공이다.
bpftool은 load한 program을 /sys/fs/bpf/hello에 pin한다.
pinning은 program에 파일 경로 형태의 reference를 남기는 작업이다.
이 reference 덕분에 나중에 같은 program을 pinned path로 다시 조회한다.
load 상태는 이렇게 확인한다.
sudo bpftool prog show pinned /sys/fs/bpf/hello출력을 처음 볼 때는 모든 필드를 외우지 말고 세 묶음만 나눠 본다.
| 묶음 | 필드 | 읽는 법 |
|---|---|---|
| 정체 | id, type, name, tag | 커널 안에 올라간 program이 무엇인지 확인한다. |
| load 결과 | xlated, jited, btf_id | verifier를 통과했고, bytecode/BTF/JIT 정보가 생겼는지 본다. |
| 연결된 객체 | map_ids | 이 program이 참조하는 map이 있다는 뜻이다. |
처음에는 type=xdp, name=hello, map_ids부터 찾는다.
id는 지금 커널에 올라간 program을 가리키는 임시 번호이고, tag는 같은 bytecode인지 비교할 때 쓰는 힌트로 보면 된다.
여기서 map_ids가 보이면 처음에는 이상해 보인다.
소스 코드에는 BPF_HASH 같은 map 선언이 없기 때문이다.
하지만 libbpf 스타일 BPF-side C 소스의 전역 변수와 read-only data는 map semantics로 구현된다.
int counter = 0은 뒤에서 hello.bss map으로 보이고, format string은 hello.rodata map으로 보인다.
translated bytecode는 object dump와 비슷하지만 더 구체적이다
load된 program의 translated bytecode는 bpftool로 본다.
sudo bpftool prog dump xlated pinned /sys/fs/bpf/hellollvm-objdump 출력과 구조는 비슷하지만, translated dump는 커널이 아는 map ID와 helper 이름을 더 구체적으로 보여준다.
아래는 책 예시 출력이다. map ID 숫자는 매 load마다 달라진다.
0: (18) r6 = map[id:165][0]+0
3: (18) r1 = map[id:166][0]+0
6: (85) call bpf_trace_printk
10: (b7) r0 = 2
11: (95) exit
이 짧은 출력만으로도 두 가지가 보인다.
첫째, counter는 그냥 전역 메모리처럼 보이지만 실제로는 map을 가리키는 register를 거쳐 읽고 쓴다.
둘째, bpf_printk()는 load 뒤에는 커널 helper call로 보인다.
JIT된 machine code까지 보고 싶으면 다음 명령을 쓴다.
sudo bpftool prog dump jited pinned /sys/fs/bpf/hello이 출력은 CPU architecture에 따라 달라진다.
x86_64, arm64에서 같은 모양을 기대하면 안 된다.
책은 libbfd(binutils) 지원 없이 빌드된 bpftool에서 이 덤프가 No libbfd support 계열 오류로 실패한다고 설명한다.
최근 bpftool은 LLVM 디스어셈블러를 기본으로 쓰고 libbfd는 폴백으로만 쓰인다.
그래서 어떤 디스어셈블러 지원도 없이 빌드된 환경에서만 이 덤프가 실패한다고 보는 편이 더 안전하다.
이 경우에는 bytecode 확인까지만 하고 넘어가도 된다.
attach 전에는 trace가 찍히지 않는다
load된 program은 아직 event와 연결되지 않았다.
XDP program은 network interface의 XDP hook에 attach해야 packet 수신 때 실행된다.
load와 attach는 커널 안에서 서로 다른 대상을 만든다.
bpftool prog load는 program object를 만들고 pinned path에 연결하지만, 이 상태만으로는 어떤 event도 이 program을 호출하지 않는다.
bpftool net attach가 XDP hook과 연결한 뒤에야 packet 도착이 program 실행을 trigger한다.
detach는 이 hook 연결만 끊을 뿐, load된 program 자체를 곧바로 지우지 않는다.
먼저 interface 이름을 고른다.
ip -br link책 예제는 eth0를 사용한다.
SSH로 접속한 VM에서 실습한다면 지금 올리는 program이 XDP_PASS를 반환하는지 다시 확인한다.
이 글의 예제 그대로라면 packet을 통과시키지만, return value를 바꾼 실험 코드를 eth0에 붙이면 접속을 잃을 수 있다.
program ID를 구해 attach한다.
IFACE=eth0  # 위 ip -br link에서 확인한 인터페이스 이름으로 바꾼다. 책 예제는 eth0를 쓴다.
PROG_ID=$(sudo bpftool prog show pinned /sys/fs/bpf/hello | awk -F: 'NR==1 {print $1}')
sudo bpftool net attach xdp id "$PROG_ID" dev "$IFACE"
다만 bpftool net attach xdp를 다른 program type까지 일반화하면 안 된다.
최근 bpftool은 k(ret)probe, u(ret)probe, tracepoint 쪽 자동 attach 범위도 넓혀 왔다.
그래도 모든 program type이 같은 명령으로 붙는 것은 아니다.
attach 상태는 두 명령으로 확인한다.
sudo bpftool net list
ip link show dev "$IFACE"
bpftool net list의 xdp 아래에 interface와 program ID가 보이면 attach된 상태다.
ip link show 출력에는 prog/xdp id ... tag ... jited 같은 줄이 붙는다.
trace 출력은 다음 명령으로 본다.
sudo bpftool prog tracelog또는 trace pipe를 직접 읽는다.
sudo cat /sys/kernel/debug/tracing/trace_pipetrace를 켜 둔 상태에서 다른 터미널에서 packet을 하나 만든다.
ping -c 1 1.1.1.1패킷이 들어오면 Hello World 4531처럼 counter가 증가하는 줄이 보인다.
여기서 2주차의 execve kprobe 예제와 다른 점이 있다.
XDP event는 user space process가 syscall을 호출해서 발생한 event가 아니다.
packet이 interface에 도착한 순간에는 커널이 아직 그 packet을 어떤 process에 전달할지 모른다.
그래서 trace 앞쪽에 명령 이름이나 PID 대신 <idle>-0처럼 보일 수 있다.
이 차이는 context의 차이다.
kprobe가 syscall 진입점에 붙으면 현재 process가 context의 일부가 된다.
XDP가 packet receive path 초입에 붙으면 context는 process가 아니라 packet metadata에 가깝다.
전역 변수는 hello.bss map으로 보인다
소스 코드에는 int counter = 0;만 있다.
하지만 load된 program을 보면 map ID가 붙어 있다.
전역 변수와 정적 데이터가 map으로 표현되기 때문이다.
이 지원은 2019년에 추가됐다고 책은 설명한다.
그 전에는 이 목적으로 map을 직접 선언해야 했다.
map 목록을 본다.
sudo bpftool map list이 예제와 관련된 map은 보통 이런 이름으로 보인다(책 예시).
array name hello.bss
array name hello.rodata
hello.bss는 counter 같은 mutable global data를 담는다.
hello.rodata는 format string처럼 read-only data를 담는다.
rodata 쪽 map이 frozen으로 보이면 user space에서 더 바꿀 수 없는 읽기 전용 상태라는 뜻이다.
BTF 정보가 있으면 bpftool은 map 값을 field 이름으로 보여준다.
sudo bpftool map dump name hello.bss예상할 수 있는 핵심 모양은 이렇다(책 예시 값, 실제 숫자는 packet 수신 횟수에 따라 달라진다).
"counter": 11127같은 명령을 다시 실행했을 때 숫자가 늘었다면, packet 수신 때마다 XDP program이 실행되어 counter++를 실행한 것이다.
-g없이 컴파일하면 이 출력이 훨씬 불친절해진다.
counter라는 field 이름 대신 16진수 바이트만 보인다.
그 바이트가 little endian으로 저장된 숫자라는 점까지 직접 추론해야 한다.
이 때문에-g는 단순한 선택 옵션처럼 보여도 eBPF 실습에서는 켜 두는 편이 낫다.
detach와 unload는 별도 작업이다
실습을 끝낼 때는 attach부터 끊는다.
sudo bpftool net detach xdp dev "$IFACE"성공하면 출력은 없다.
다음 명령에서 xdp 아래에 아무 항목도 없으면 network interface와 program의 연결은 끊긴 상태다.
sudo bpftool net list하지만 detach했다고 program이 곧바로 커널에서 사라지는 것은 아니다.
아직 /sys/fs/bpf/hello pinned path가 reference로 남아 있기 때문이다.
sudo bpftool prog show pinned /sys/fs/bpf/hellounload까지 하려면 pinned file을 지운다.
sudo rm /sys/fs/bpf/hello그 뒤 같은 bpftool prog show pinned /sys/fs/bpf/hello 명령이 더 이상 program을 찾지 못하면 정리된 상태다.
attach와 load를 나눠 이해해야 cleanup도 헷갈리지 않는다.
network hook에서 떼는 작업과 커널 안의 reference를 제거하는 작업은 서로 다른 단계다.
BPF-to-BPF call은 돌아오는 함수 호출이고 tail call은 돌아오지 않는 점프다
2주차에서 본 tail call은 다른 eBPF program으로 넘어간 뒤 원래 program으로 돌아오지 않았다.
3장 후반의 hello-func.bpf.c 예제는 다른 흐름을 보여준다.
eBPF program 안에서 일반 함수처럼 다른 eBPF 함수를 호출하고 돌아오는 BPF-to-BPF call이다.
예제의 모양은 단순하다.
static __attribute__((noinline)) int get_opcode(struct bpf_raw_tracepoint_args *ctx) {
    return ctx->args[1];
}

SEC("raw_tp")
int hello(struct bpf_raw_tracepoint_args *ctx) {
    int opcode = get_opcode(ctx);
    bpf_printk("Syscall: %d", opcode);
    return 0;
}__attribute__((noinline))은 설명을 위한 장치다.
이 함수는 너무 작아서 컴파일러가 알아서 inline할 가능성이 높다.
그러면 bytecode에서 함수 호출을 보여줄 수 없으므로 예제가 강제로 inline을 막는다.
일반 코드에서는 특별한 이유가 없으면 컴파일러 최적화에 맡기는 편이 낫다.
translated bytecode에서는 호출이 이런 식으로 보인다(책 예시).
0: (85) call pc+7
8: (79) r0 = *(u64 *)(r1 +8)
9: (95) exit
call pc+7은 다음 instruction으로 가지 않고 뒤쪽의 get_opcode() bytecode로 점프한다.
호출된 함수는 return value를 R0에 남기고 exit한다.
그 다음 호출한 쪽으로 돌아와 R0 값을 syscall opcode로 사용한다.
이 구조는 stack을 쓴다.
호출한 함수의 상태를 보존해야 돌아올 수 있기 때문이다.
eBPF stack은 512바이트로 제한되므로 BPF-to-BPF call을 깊게 중첩하는 방식으로 큰 로직을 만들기는 어렵다.
로직을 program 단위로 나누고 돌아오지 않아도 되는 흐름이라면 tail call이 다른 선택지가 된다.
실습: 전체 흐름 다시 보기
앞 절들을 그대로 따라왔다면 이미 필요한 명령은 모두 실행했다.
처음부터 다시 한다면 아래 순서대로 실행한다.
각 명령 블록 아래에 실행 결과를 붙이면, 독자가 같은 흐름으로 따라가기 쉽다.
1. 원본 예제 코드를 받는다
learning-ebpf 저장소를 받고, 이 글에서 확인한 고정 커밋으로 맞춘 뒤 chapter3으로 들어간다.
git clone https://github.com/lizrice/learning-ebpf.git
cd learning-ebpf
git checkout 91ded4ac7b188de02cdad24a743d4d18a6898cc2
cd chapter3
2. object file을 만든다
chapter3/Makefile 기준으로 hello.bpf.o와 hello-func.bpf.o를 만든다.
sudo apt-get update && sudo apt-get install -y make linux-libc-dev libbpf-dev clang llvm
make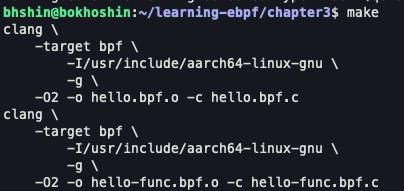
3. object file 상태를 확인한다
아직 커널에 올라간 program이 아니라, 커널에 올릴 수 있는 파일이 생긴 상태다.
file hello.bpf.o
llvm-objdump -S hello.bpf.o
4. kernel에 load하고 상태를 읽는다
hello.bpf.o를 /sys/fs/bpf/hello에 load하고 pin한다.
sudo bpftool prog load hello.bpf.o /sys/fs/bpf/hello
sudo bpftool prog show pinned /sys/fs/bpf/hello
sudo bpftool prog dump xlated pinned /sys/fs/bpf/hello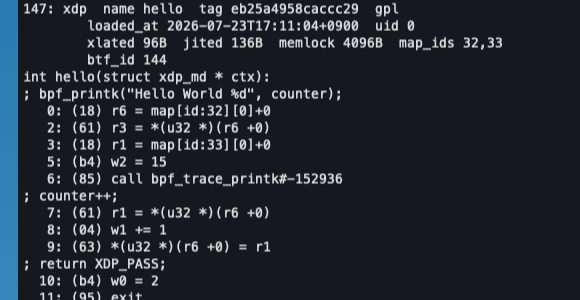
전역 변수와 read-only data가 map으로 보이는지도 확인한다.
sudo bpftool map list
sudo bpftool map dump name hello.bss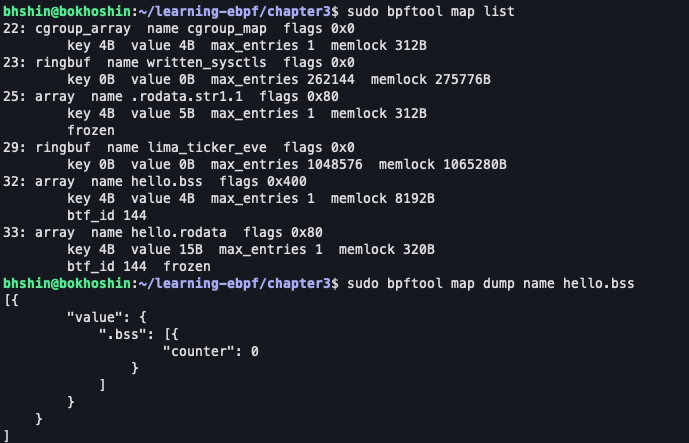
재실습 중 bpftool prog load가 실패하면 같은 이름의 pin이 남아 있는지 먼저 본다.
이 예제라면 sudo rm /sys/fs/bpf/hello로 기존 pin을 지운 뒤 다시 load하면 된다.
5. XDP hook에 attach한다
IFACE=eth0는 실습 환경의 실제 interface 이름으로 바꾼다.
IFACE=eth0
PROG_ID=$(sudo bpftool prog show pinned /sys/fs/bpf/hello | awk -F: 'NR==1 {print $1}')
sudo bpftool net attach xdp id "$PROG_ID" dev "$IFACE"
sudo bpftool net list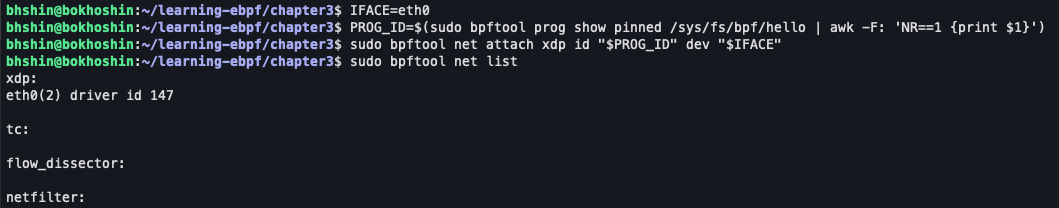
6. trace로 실행 여부를 확인한다
터미널을 두 개로 나눠서 보는 편이 편하다.
한쪽에서는 trace를 열어 둔다.
sudo bpftool prog tracelog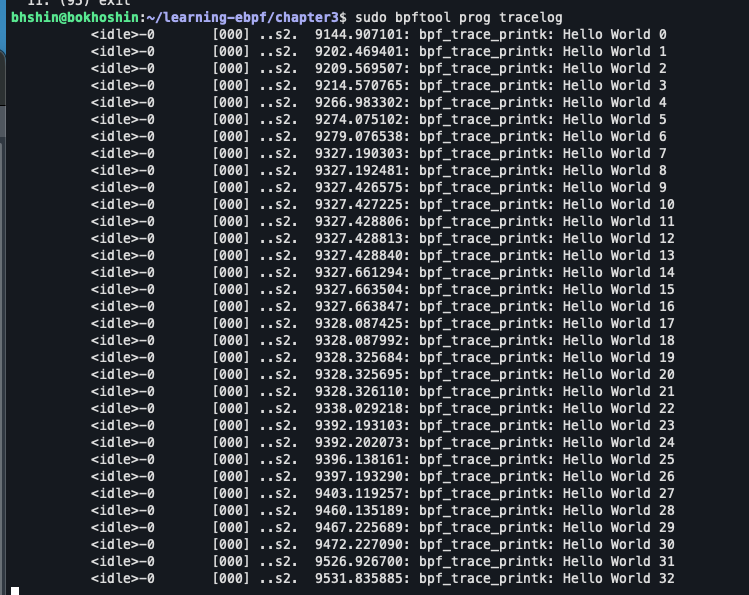
다른 터미널에서는 packet을 하나 만든다.
packet이 지나가면, trace를 열어 둔 터미널에 Hello World 로그가 추가된다.
ping -c 1 1.1.1.1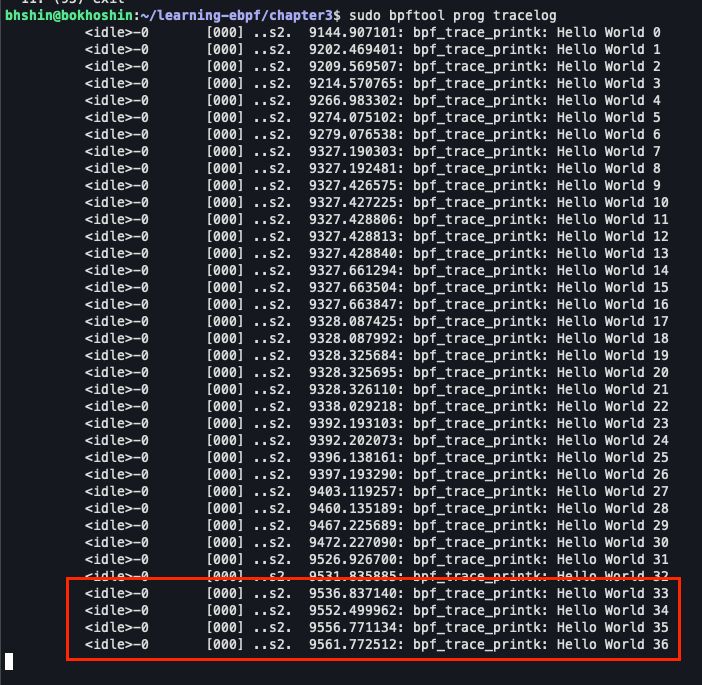
7. attach를 끊고 정리한다
확인이 끝나면 attach를 먼저 끊고 pinned path를 지운다.
sudo bpftool net detach xdp dev "$IFACE"
sudo rm /sys/fs/bpf/hello
오해하기 쉬운 지점
- object file은 실행 중인 program이 아니다.
hello.bpf.o는 아직 파일일 뿐이다.
bpftool prog load이후에야 kernel에 program이 생긴다.
그 뒤에도 attach하지 않으면 event가 program을 호출하지 않는다. map_ids가 보인다고 해서 map 선언이 빠진 것은 아니다.
libbpf 스타일 BPF-side C 소스의 global variable과 read-only data는 map으로 표현된다.hello.bss와hello.rodata를 보면 이 변환을 눈으로 확인한다.id,name,tag,pinned path는 같은 역할이 아니다.
ID는 load할 때마다 달라질 수 있고, name은 중복될 수 있다.
tag는 instruction 내용에서 계산되므로 같은 program을 식별하는 데 유용하다.
다만 같은 tag를 가진 program instance가 여러 개 있을 수 있다.
pinned path는 filesystem 경로라서 고유하게 다루기 쉽지만, 지우면 reference가 사라진다.- XDP return value는 C의 일반적인 성공/실패 관습으로 읽으면 안 된다.
0은 성공이 아니라XDP_ABORTED다. network interface에 붙는 program은 return value 하나가 packet 처리 결과를 바꾼다.
다음 장으로 이어지는 질문
지금까지 C 소스가 object file이 되고, 커널에 load된 뒤, XDP hook에 attach되어 실행되는 흐름을 bpftool 출력으로 확인했다.
하지만 bpftool prog load 내부에서 실제로 커널에 어떤 요청이 들어가는지는 아직 열지 않았다.
다음 장의 질문은 더 낮다.
- user space loader는
bpf()syscall에 어떤 command를 넘기는가? - program load와 map create는 syscall 수준에서 어떻게 다르게 표현되는가?
- pinning과 file descriptor reference는 program lifetime을 어떻게 바꾸는가?
3주차의 결론은 짧다.
eBPF program을 읽을 때는 C 코드만 보지 말고, object file, loaded program, attached hook, map 상태를 따로 확인해야 한다.
이 네 상태가 분리되어 보여야 4주차의 bpf() syscall도 덜 추상적으로 읽힌다.
용어
- XDP(eXpress Data Path): 네트워크 인터페이스에 패킷이 도착할 때 트리거되는 eBPF program 이벤트 타입.
bpftool: 커널에 로드된 eBPF program과 map을 로드·검사·attach·삭제하는 데 쓰는 유틸리티.- pin: eBPF program이나 map을
/sys/fs/bpf아래 파일 경로에 연결해, 그 경로를 통해 참조할 수 있게 하는 것. - tag: program 명령어의 SHA 합으로 만들어지는 식별자. id와 달리 로드마다 바뀌지 않는 것이 원칙이다.
bytes_xlated: verifier를 통과한 뒤의 eBPF bytecode 크기.bytes_jited: JIT 컴파일된 실제 machine code 크기.- BTF(BPF Type Format): 컴파일 시
-g플래그로 생성되는 타입 정보. 5주차에서 다룬다. - BPF-to-BPF call: 같은 eBPF program 안에서 다른 함수를 호출하고 caller로 복귀하는 함수 호출. tail call과 달리 호출한 쪽으로 돌아온다.
참고 자료
- Liz Rice,
Learning eBPF, Chapter 3 - Liz Rice,
Learning eBPF, Chapter 3 “Anatomy of an eBPF Program” — ELF object file, user space loader,bpf()load/attach 흐름 참고 - Brendan Gregg,
BPF Performance Tools, Appendix E “BPF Instructions” — BPF instruction format과bpftoolopcode dump 참고 - Learning eBPF 예제 코드(3장,
91ded4a기준): https://github.com/lizrice/learning-ebpf/tree/91ded4ac7b188de02cdad24a743d4d18a6898cc2/chapter3 - Linux
bpf(2)manual: https://man7.org/linux/man-pages/man2/bpf.2.html - Linux kernel BPF instruction set specification: https://docs.kernel.org/6.8/bpf/standardization/instruction-set.html
- bpftool 프로젝트(libbfd 지원 빌드 안내 포함): https://github.com/libbpf/bpftool
- Iovisor 프로젝트, eBPF opcode 문서: https://github.com/iovisor/bpf-docs