BCC 코드 한 줄을 syscall, file descriptor, map, attach 수명으로 분해하기
2~3주차에서 BCC Python 코드가 eBPF C source → ELF object → verifier 통과 → load → attach로 바뀌는 과정을 봤다. 4주차는 그 경계, 즉 loader가 kernel에 요청을 보낼 때 쓰는 문인 bpf() syscall을 연다.
int bpf(int cmd, union bpf_attr *attr, unsigned int size);이 함수 하나가 eBPF program과 BPF map을 만들고, BTF를 등록하고, map 값을 읽고 쓰고, object 정보를 조회한다. eBPF program이 실행 중 map을 읽고 쓸 때는 다르다 — 이미 kernel 안에서 실행 중이므로 bpf()가 아니라 BPF helper function을 쓴다.
bpf()는 eBPF program을 실행하는 syscall이 아니라, user space loader가 map·program·BTF 같은 BPF kernel object를 만들고 관리하는 control-plane API다. kernel 안에서 실행 중인 eBPF program은 이 syscall을 다시 부르지 않고, BPF helper function으로 같은 map과 kernel context에 접근한다. FD·reference count·attach 관계가 이 object들의 수명을 결정한다.
이 구분이 strace의 BPF_MAP_CREATE/BPF_PROG_LOAD/BPF_MAP_UPDATE_ELEM과 eBPF C 코드의 bpf_map_lookup_elem() 계열이 서로 다른 층위인 이유다.
예제는 Learning eBPF 4장의 hello-buffer-config.py(BCC, kprobe/perf event attach)를 쓴다. libbpf 기반 코드는 가능한 attach 유형에서 BPF link를 함께 쓰는 경우가 많다 — 두 방식을 같은 것으로 섞지 않는다.
확인할 것
bpf()의 모든 command를 암기할 필요는 없다. 다음 질문에 답할 수 있으면 4장의 목표를 달성한 것이다.
- BCC Python 코드가 kernel에 어떤 BPF object를 만들고 어떤 file descriptor를 받는가?
BPF_MAP_CREATE와BPF_PROG_LOAD는 무엇을 만들며, verifier는 어느 시점에 동작하는가?- user space의
BPF_MAP_UPDATE_ELEM과 eBPF program의bpf_map_lookup_elem()은 왜 다른 interface인가? - load, attach, pinning, process 종료는 program과 map의 수명에 어떤 영향을 주는가?
- perf buffer와 ring buffer는 어떤 문제를 해결하며, 언제 예제의 흐름이 달라지는가?
BTF와 CO-RE의 세부 구조는 5주차, verifier의 register state 추적은 6주차에서 다룬다. 이번 초점은 object lifecycle과 syscall 경계다.
설명
먼저 map 공유 모델을 본다
hello-buffer-config.py에는 map이 두 개 있다. user space가 UID별 설정을 넣고 eBPF program이 읽는 config map, eBPF program이 event를 쓰고 user space가 읽는 output map이다. map은 한 process만 사용하는 local variable이 아니라, kernel 안에 존재하며 여러 eBPF program과 여러 user space process가 접근할 수 있는 shared object다.
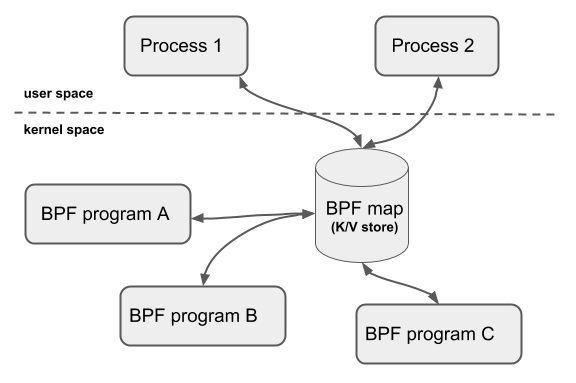
출처: Cilium BPF Architecture - Maps.
Process 1/2는 BCC loader, bpftool, 관리 daemon처럼 서로 다른 user space process, BPF program A/B/C는 서로 다른 hook에 attach된 program일 수 있다 — 이들이 같은 map을 공유할 수 있다는 것이 핵심이다.
이 그림은 시간 순서도가 아니다. 4주차 예제의 lifecycle은 다음 순서로 읽는다(BPF_BTF_LOAD는 환경에 따라 생략될 수 있는 선행 단계라 별도 노드로 표시했다).
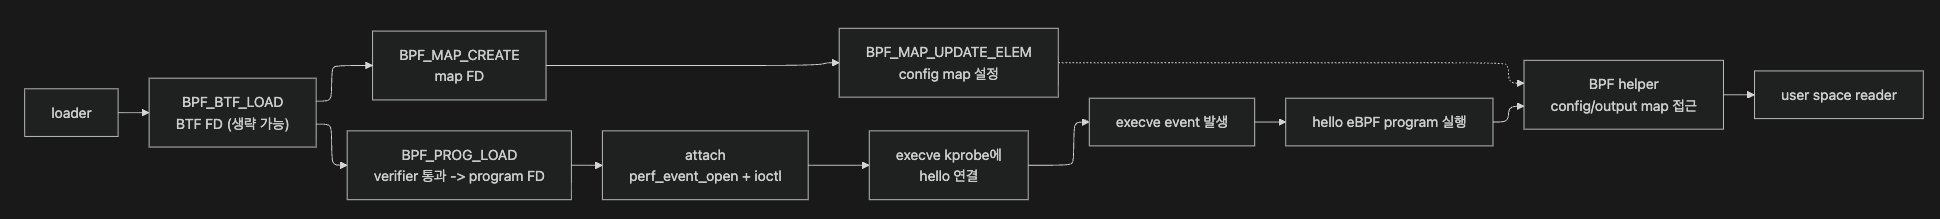
BPF_PROG_LOAD 뒤에는 verifier가 있고, 통과해야 program FD가 나온다. config map 값을 넣는 일은 user space의 syscall이고, execve() 이후 hello가 config을 lookup하는 일은 kernel 안에서 helper function으로 수행된다.
핵심 용어를 실행 위치로 나눈다
| 용어 | 실행 위치 | 이 장에서 하는 일 |
|---|---|---|
| user space loader | 일반 process | source/object를 준비하고 syscall로 kernel에 요청한다. BCC, libbpf, bpftool이 여기에 해당한다. |
bpf() syscall | user/kernel 경계 | map/program/BTF 같은 BPF object를 생성, 조회, 갱신한다. |
| BPF map | kernel | user space와 eBPF program이 공유하는 storage다. hash table, array, perf event array, ring buffer 등 type마다 동작이 다르다. |
| eBPF program | kernel | attach된 event가 발생하면 실행되는 bytecode 또는 JIT machine code다. |
| BPF verifier | kernel, load 시점 | 모든 실행 경로가 안전한지 검사하고 통과한 program만 load한다. |
| BPF helper function | kernel, program 실행 중 | eBPF program이 허용된 kernel 기능과 map에 접근하는 제한된 API다. |
| file descriptor(FD) | user space process | kernel BPF object를 가리키는 process-local handle이다. |
| attach/hook | kernel | load된 program을 kprobe, tracepoint, XDP, cgroup 같은 실행 지점에 연결한다. |
| BPF link | kernel object | 일부 attach 유형에서 program과 hook의 관계를 별도 object로 표현하고 수명을 관리한다. |
FD는 object ID와 다르다. FD는 한 process의 열린 handle 번호라, 두 process가 같은 map을 열어도 서로 다른 FD를 받을 수 있고 우연히 같은 숫자여도 같은 object라는 뜻은 아니다. kernel object의 ID는 kernel 전역에서 조회에 쓰이는 식별자다.
예제 코드를 control path와 data path로 분리한다
BCC loader의 핵심 부분이다. 주석에 적은 syscall 수준 의미를 함께 읽는다.
from bcc import BPF
import ctypes as ct

# eBPF C source를 compile하고, map/program을 kernel에 load한다.
# 내부적으로 BPF_MAP_CREATE, BPF_PROG_LOAD 등이 발생한다.
b = BPF(text=bpf_program_source)

# load된 hello program을 execve kprobe에 연결한다.
# 이 책의 BCC 예제는 perf_event_open()과 ioctl() attach 경로를 사용한다.
b.attach_kprobe(event=b.get_syscall_fnname("execve"), fn_name="hello")

# user space가 config map의 key/value를 설정한다.
# Python dict assignment처럼 보이지만 BPF_MAP_UPDATE_ELEM에 대응한다.
b["config"][ct.c_int(0)] = ct.create_string_buffer(b"Hey root!")
b["config"][ct.c_int(501)] = ct.create_string_buffer(b"Hi user 501!")

# eBPF program이 output perf buffer map에 쓴 event를 읽는다.
b["output"].open_perf_buffer(print_event)
while True:
b.perf_buffer_poll()print_event는 open_perf_buffer()에 등록한 user space callback이다. BCC가 perf buffer record를 전달하면 data_t byte layout으로 decode해 PID/UID/command/message를 출력한다 — 새 bpf() syscall을 호출하는 코드가 아니라, kernel이 output map에 넣은 event를 사람이 읽을 값으로 바꾸는 마지막 단계다.
이 코드가 준비하는 kernel 쪽은 다음과 같다.
struct user_msg_t {
    char message[13];
};

// user ID(u32)를 key로, message 구조체를 value로 가지는 hash map이다.
// loader가 이 정의를 바탕으로 BPF_MAP_CREATE를 요청한다.
BPF_HASH(config, u32, struct user_msg_t);

// kernel -> user space event 전달에 쓸 perf event array map이다.
BPF_PERF_OUTPUT(output);

struct data_t {
    int pid;
    int uid;
    char command[16];
    char message[12];
};

// 이 함수는 Python이 직접 호출하지 않는다.
// execve kprobe가 trigger될 때 kernel이 호출한다.
int hello(void *ctx) {
    struct data_t data = {};
    struct user_msg_t *p;
    char default_message[12] = "Hello World";

    // 모두 eBPF program이 호출하는 helper다. syscall이 아니다.
    data.pid = bpf_get_current_pid_tgid() >> 32;
    data.uid = bpf_get_current_uid_gid() & 0xffffffff;
    bpf_get_current_comm(&data.command, sizeof(data.command));

    // BCC 문법의 config.lookup()은 map lookup helper 호출로 컴파일된다.
    p = config.lookup(&data.uid);
    if (p) {
        bpf_probe_read_kernel(&data.message, sizeof(data.message), p->message);
    } else {
        bpf_probe_read_kernel(&data.message, sizeof(data.message), default_message);
    }

    // perf event array map에 event를 기록한다.
    // user space의 perf_buffer_poll()이 이 record를 꺼낸다.
    output.perf_submit(ctx, &data, sizeof(data));
    return 0;
}
C source는 config를 먼저, output을 나중에 선언하지만 이 순서가 kernel의 map 생성 순서를 정하지는 않는다. 아래 strace 예시에서 output이 먼저 생성된 것은 이 BCC loader와 kernel에서 관찰한 결과다 — 실행 환경의 실제 순서는 strace로 확인한다.
config는 configuration channel(user space가 쓰고 eBPF program이 읽음)이고, output은 event channel(eBPF program이 쓰고 user space가 읽음)이다. 둘 다 map이지만 data direction과 선택 기준이 다르다.
| map | 주된 writer | 주된 reader | 이 예제의 역할 |
|---|---|---|---|
config hash map | user space | eBPF program | UID별 message 설정 |
output perf event array | eBPF program | user space | execve event 전달 |
bpf()는 command dispatcher다
bpf()는 object마다 별도 syscall을 만들지 않는다. cmd가 operation을 고르고, union bpf_attr가 operation별 parameter를, size가 그 attr 구조체의 크기를 담는다.
int bpf(int cmd, union bpf_attr *attr, unsigned int size);개념적으로는 아래처럼 읽으면 된다.
// map을 하나 만들고 map FD를 받는다.
bpf(BPF_MAP_CREATE, &map_attr, sizeof(map_attr));

// bytecode를 verifier에 제출하고 program FD를 받는다.
bpf(BPF_PROG_LOAD, &prog_attr, sizeof(prog_attr));

// 이미 가진 map FD를 이용해 key/value를 넣는다.
bpf(BPF_MAP_UPDATE_ELEM, &update_attr, sizeof(update_attr));
union bpf_attr는 command에 따라 사용하는 field가 다르다. BPF_MAP_CREATE에서는 map type, key/value size, max entries가 핵심이고, BPF_PROG_LOAD에서는 program type, instruction 배열, license, verifier log buffer가 핵심이다. command별 ABI가 하나의 union을 공유하므로 사용하지 않는 field와 padding은 zero로 초기화한다.
이 글에서 반복해서 볼 command를 역할별로 정리하면 다음과 같다.
| command | 대상 | 성공 시 결과 | 예제에서 보이는 위치 |
|---|---|---|---|
BPF_BTF_LOAD | BTF metadata | BTF FD | BCC가 type information을 등록할 때 |
BPF_MAP_CREATE | BPF map | map FD | config, output map 생성 |
BPF_PROG_LOAD | eBPF instruction | program FD | hello bytecode load와 verifier 검사 |
BPF_MAP_UPDATE_ELEM | map entry | 0 | UID별 message 및 perf event FD 등록 |
BPF_MAP_LOOKUP_ELEM | map entry | 0과 value | user space가 특정 key의 value를 읽을 때 |
BPF_MAP_GET_NEXT_KEY | map key set | 0과 next key | bpftool map dump 같은 순회 작업 |
BPF_OBJ_GET_INFO_BY_FD | BPF object | 0과 metadata | FD가 가리키는 map/program 정보 조회 |
BPF_OBJ_PIN / BPF_OBJ_GET | bpffs path | 0 / object FD | object를 path로 유지하거나 다시 열 때 |
BPF_PROG_BIND_MAP | program + map | 0 | program이 직접 참조하지 않는 map(예: 전역변수 metadata map)의 reference를 program에 묶을 때 |
성공 return value도 command마다 다르다. object를 새로 만드는 command는 보통 새 FD를, map entry update 같은 command는 성공 시 0을 반환한다. 오류는 -1을 반환하고 errno로 원인을 준다 — strace의 = -1 EACCES (...) 형태로 읽는다.
EACCES가 보인다고 곧장 권한 문제로 단정하면 안 된다. BPF_PROG_LOAD에서는 verifier가 program을 거부했을 때도 같은 errno가 나올 수 있다. capability 부족인지 verifier 거부인지는 errno 하나만으로 구분되지 않으므로, log_buf에 남긴 verifier log(아래 "verifier log를 남기지 않으면 원인을 잃는다" 참고)와 실행 환경의 capability 설정을 함께 봐야 한다.
strace 출력에서 object 생성 순서를 해석한다
strace 출력은 kernel 주소, pointer, 생략된 attr field가 섞여 복잡해 보인다. object lifecycle과 반복 초기화를 분리해 읽는다.
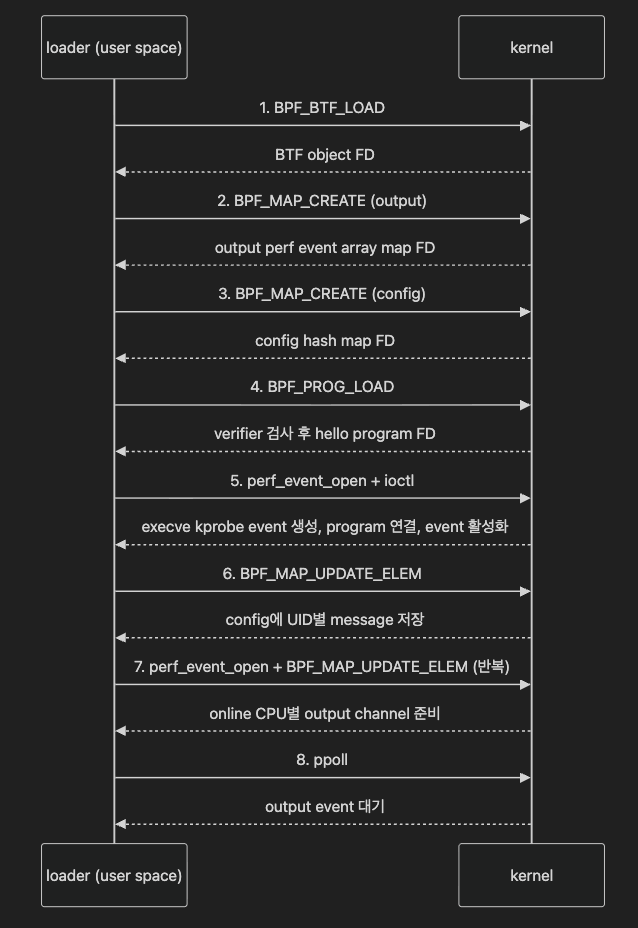
책의 4 CPU 예제를 단순화한 앞부분이다(전체 순서는 뒤의 실습 1단계에서 확인한다). FD 숫자는 실행마다 달라진다 — 중요한 것은 어떤 object를 가리키는지다.
bpf(BPF_BTF_LOAD, ...) = 3
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_PERF_EVENT_ARRAY, ...}) = 4
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, map_name="config", ...}) = 5
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_KPROBE, prog_name="hello", ...}) = 6
...
이 출력에서 3, 4, 5, 6은 kernel 전역 object ID가 아니라 이 loader process가 받은 FD다.
output이 config보다 먼저 생성되는데, 이는 위 C source의 선언 순서와 다른 BCC loader의 관찰 결과다 — map declaration 순서가 BPF_MAP_CREATE 순서를 보장하는 API contract는 아니다.
위 FD 3-6에 이어, attach 단계에서 나타나는 FD 7(실습 1단계에서 전체 순서로 확인한다)까지 정리한 표다.
| FD 예시 | 가리키는 object | 다음에 쓰이는 곳 |
|---|---|---|
3 | BTF data | map/program type metadata 지정 |
4 | output perf event array map | per-CPU perf event FD 저장, event 전달 |
5 | config hash map | BPF_MAP_UPDATE_ELEM의 map_fd |
6 | hello BPF program | kprobe event와 연결 |
7 | execve kprobe perf event | PERF_EVENT_IOC_SET_BPF, ENABLE |
이 번호는 BPF_BTF_LOAD가 실제로 일어난 경우를 전제로 한다. 이 호출이 생략되는 환경에서는 FD 번호가 하나씩 앞으로 당겨지고(output이 3, config가 4, hello가 5, kprobe event가 6), btf_fd=3/prog_btf_fd=3 같은 field도 없거나 값이 달라질 수 있다.
map 생성은 data structure 계약을 kernel에 등록하는 일이다
config map 생성은 대략 다음 attr를 전달한다.
bpf(BPF_MAP_CREATE,
    {map_type=BPF_MAP_TYPE_HASH,
     key_size=4,
     value_size=13,
     max_entries=10240,
     map_name="config",
     btf_fd=3, ...},
    128) = 5
각 field는 C source와 대응한다.
map_type=BPF_MAP_TYPE_HASH: key를 hashing하는 map이다.key_size=4: key인u32user ID의 크기다.value_size=13:struct user_msg_t의message[13]크기다."Hi user 501!"(12글자)처럼ct.create_string_buffer()가 만드는 null-terminated 문자열까지 담으려면 문자열 길이보다 1 byte 커야 한다.max_entries=10240: 이 map이 가질 수 있는 entry의 상한이다. BCC 선언에서 size를 생략했을 때의 default가 관찰된 것이다.map_name="config": 운영 도구에서 object를 식별하기 쉽게 하는 이름이다. 이름만으로는 고유성을 보장하지 않는다.btf_fd=3: key/value의 type metadata와 연결할 수 있는 BTF object FD다.
map type은 단순한 container 선택이 아니다 — eBPF program이 어떤 helper로 접근할 수 있는지, value pointer를 어떻게 다뤄야 하는지, concurrency와 memory model까지 함께 결정한다. 이 장의 hash map은 configuration 조회에 맞는 가장 단순한 예다.
output의 BPF_MAP_TYPE_PERF_EVENT_ARRAY는 일반 hash map과 다르다. key/value 크기가 4 byte로 보여도 핵심은 임의 key/value 저장이 아니라 CPU별 perf event channel 연결이다. BCC는 각 online CPU에 대해 perf event를 만들고 해당 FD를 map에 등록한다(앞의 strace 분류 7단계). perf buffer와 ring buffer의 구조 차이는 뒤 절에서 비교한다.
user space의 map update는 syscall이다
Python의 이 한 줄을 다시 보자.
b["config"][ct.c_int(501)] = ct.create_string_buffer(b"Hi user 501!")의미상 다음 syscall과 같다.
bpf(BPF_MAP_UPDATE_ELEM,
    {map_fd=5, key=&uid_501, value=&message, flags=BPF_ANY},
sizeof(attr)) = 0BPF_ANY는 "반드시 새 entry를 만들라"는 뜻이 아니라 "key가 없으면 create, 있으면 update"하는 policy다. 새 key만 허용하려면 BPF_NOEXIST, 기존 key만 update하려면 BPF_EXIST를 쓴다 — 지원 flag는 map type과 operation마다 다를 수 있다.
ctypes를 쓰는 이유도 여기서 보인다. user space가 넘기는 bytes는 eBPF C source가 기대하는 key/value layout과 정확히 맞아야 한다. int의 크기, structure padding, 문자열의 null terminator를 잘못 맞추면 syscall은 성공해도 의도한 값을 읽지 못할 수 있다. BCC가 이 경계를 편하게 만들어 줘도, map은 결국 byte-oriented ABI라는 사실은 변하지 않는다.
kernel 안의 map lookup은 helper다
반면 eBPF C 코드의 다음 줄은 syscall이 아니다.
p = config.lookup(&data.uid);BCC가 제공하는 문법이며, 최종 eBPF program에서는 bpf_map_lookup_elem() helper 계열 호출로 표현된다. 반환값은 map value pointer 또는 NULL일 수 있으므로 verifier가 안전성을 증명하려면 null check가 필요하다.
p = bpf_map_lookup_elem(&config, &data.uid);
if (p) {
    /* p가 map value를 가리킨다는 것이 이 분기 뒤에 증명된다. */
}
이 구분은 eBPF를 읽을 때 가장 자주 생기는 오해를 없앤다.
| 질문 | 답 |
|---|---|
eBPF program이 event마다 bpf() syscall을 호출하는가? | 아니다. bpf()는 user space가 kernel에 요청하는 syscall이다. |
| eBPF program은 map을 어떻게 읽는가? | verifier가 허용한 BPF helper와 map value pointer 규칙을 따른다. |
| user space는 map을 어떻게 읽고 쓰는가? | map FD를 인자로 하는 BPF_MAP_*_ELEM syscall command를 사용한다. |
| map이 왜 양쪽 사이의 통신 channel인가? | 두 실행 위치가 같은 kernel object에 서로 다른 interface로 접근하기 때문이다. |
BPF_PROG_LOAD는 verifier를 통과해야 끝난다
hello program load는 다음과 비슷하다.
bpf(BPF_PROG_LOAD,
    {prog_type=BPF_PROG_TYPE_KPROBE,
     insn_cnt=44,
     insns=0x...,
     license="GPL",
     prog_name="hello",
     expected_attach_type=BPF_CGROUP_INET_INGRESS,
     prog_btf_fd=3, ...},
128) = 6expected_attach_type=BPF_CGROUP_INET_INGRESS가 찍혀 있다고 이 kprobe program이 cgroup ingress에 연결된다는 뜻은 아니다. 이 field는 program type 일부에서만 쓰이고 BPF_PROG_TYPE_KPROBE는 해당하지 않는다 — 미사용 field가 0으로 남아 있고, strace가 그 값을 BPF attach type enum의 0번째 이름으로 그대로 보여준 것뿐이다. union bpf_attr가 command마다 다른 field를 재사용한다는 사실(위 표 참고)을 strace 출력에서 실제로 마주치는 사례다.
insns는 struct bpf_insn 배열의 user space address, insn_cnt는 instruction 수다. kernel은 이 bytecode를 곧바로 실행하지 않는다 — BPF_PROG_LOAD 처리 중 verifier가 program type, helper 사용 가능 여부, register와 stack의 initialization, pointer provenance, memory access boundary, control flow 등을 검사한다.
따라서 "load했다"에는 두 단계가 접혀 있다.
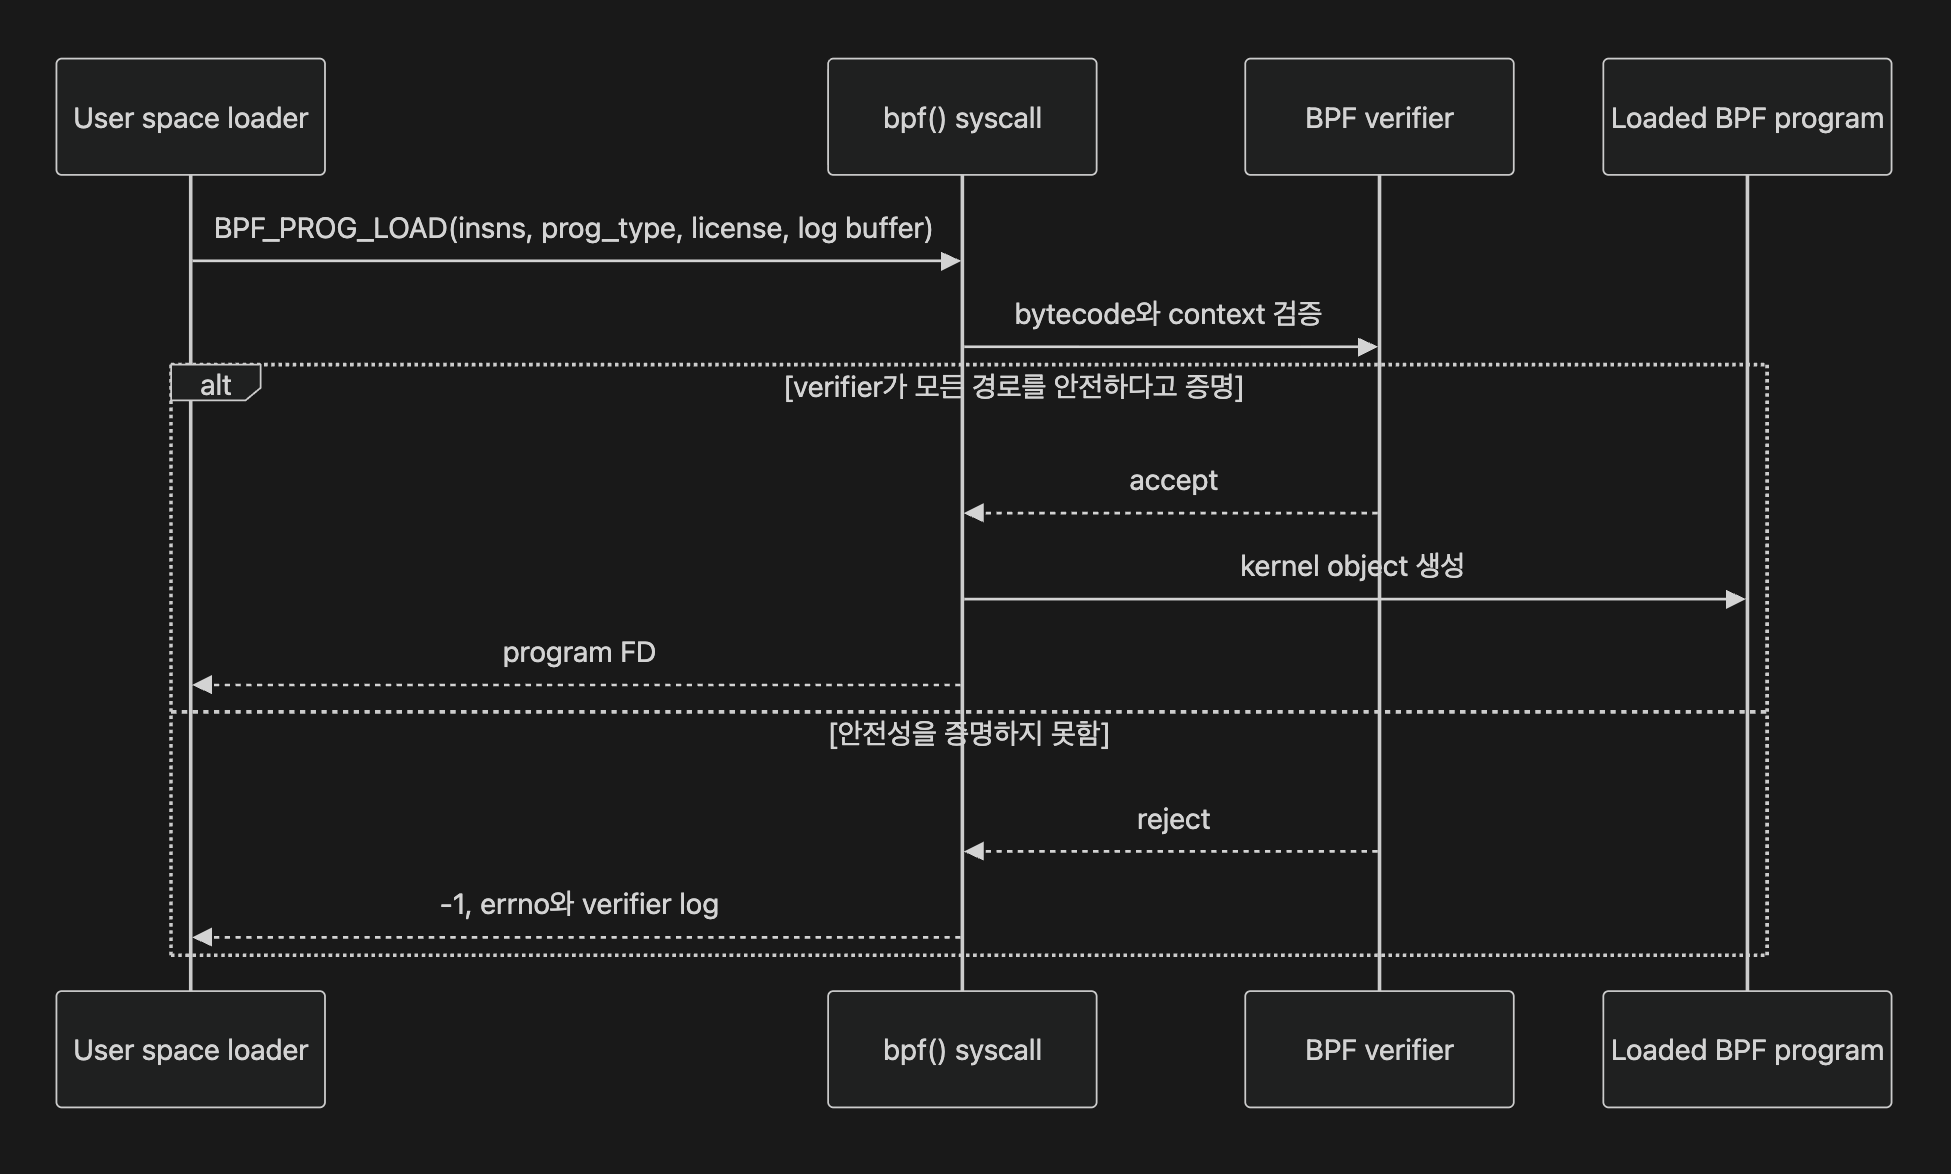
BPF_PROG_LOAD가 실패했다고 항상 instruction opcode가 틀린 것은 아니다. map lookup 결과가 NULL일 수 있는데 바로 dereference했거나, uninitialized stack 값을 helper에 넘겼거나, program type이 지원하지 않는 helper를 호출해도 거절될 수 있다.
verifier log를 남기지 않으면 원인을 잃는다
loader는 log_buf, log_size, log_level을 BPF_PROG_LOAD attr에 넣어 verifier log를 받을 수 있다. load 실패 시 이 log를 충분한 크기로 수집해 남기는 편이 좋다. 단, verifier log의 형식은 verifier 구현과 함께 변할 수 있으므로 특정 log 문장을 안정 API처럼 파싱하면 안 된다.
처음에는 다음처럼 읽으면 충분하다(아래 두 줄은 실제 log가 아니라 흔히 나타나는 형태의 예시다).
R1 type=ctx expected=fp
invalid mem access 'map_value_or_null'
이는 보통 "이 register가 어떤 pointer type인지 verifier가 추적하고 있으며, null 가능 pointer를 안전 확인 전에 사용했다"는 계열의 신호다. register state와 control-flow path 관점의 해석은 6주차에서 다룬다.
license="GPL"도 단순 metadata가 아니다. 일부 helper는 GPL-compatible license 선언이 있어야 사용할 수 있다. license, program type, kernel version, helper availability가 조합으로 작동하므로, 다른 시스템에서 같은 object가 load되지 않는다면 verifier log와 kernel feature를 같이 확인한다.
load와 attach는 별도 상태다
3주차의 핵심을 4주차에도 그대로 적용한다.
source/object -> BPF_PROG_LOAD -> loaded program -> attach -> event 발생 시 실행BPF_PROG_LOAD가 성공해 program FD를 받았다고 해서 hello()가 실행되는 것은 아니다. program은 kernel에 존재하지만 아직 어떤 event도 그 program을 호출하지 않는다. execve kprobe에 연결하는 attach가 있어야 한다.
책 예제의 attach: perf event FD와 ioctl()
이 장의 BCC 예제는 kprobe event를 나타내는 perf event FD를 먼저 만들고, 그 FD와 program FD를 ioctl()로 연결한다.
perf_event_open({type=kprobe_type, ...}) = 7
ioctl(7, PERF_EVENT_IOC_SET_BPF, 6) = 0
ioctl(7, PERF_EVENT_IOC_ENABLE, 0) = 06은 hello program FD, 7은 execve kprobe perf event FD다. SET_BPF는 둘을 연결하고 ENABLE은 event를 활성화한다. FD 번호와 /sys/bus/event_source/devices/kprobe/type에서 읽는 PMU type 값은 실행/machine마다 달라질 수 있으므로 고정값으로 가정하면 안 된다.
이 attach 경로가 중요한 이유는 두 가지다.
- BCC 예제를
strace로 보았을 때bpf()만으로 attach가 끝나지 않는 이유를 설명한다. - program FD와 target/event FD를 연결하는 일이 attach의 본질이라는 점을 보여 준다.
현재 libbpf에서 자주 만나는 attach: BPF link
모든 attach가 perf event와 ioctl()을 쓰는 것은 아니다. program type과 kernel feature에 따라 BPF_PROG_ATTACH, BPF_RAW_TRACEPOINT_OPEN, netlink, perf event 등 API가 다르고, 현대적인 libbpf API는 가능한 attach 유형에서 BPF link를 반환하는 high-level attach helper를 제공한다.
BPF link는 "어떤 program이 어떤 hook에 attach되어 있는가"를 별도 kernel object로 표현한다. link FD 또는 pinned link가 살아 있는 동안 attach 관계도 관리할 수 있어 loader process의 수명과 hook 연결을 더 명시적으로 다룰 수 있다. 다만 모든 program type과 모든 오래된 kernel이 같은 link model을 지원하는 것은 아니므로, "BPF link가 항상 legacy attach를 대체한다"라고 단정하면 안 된다.
| 관점 | 책의 BCC kprobe 예제 | 현대 libbpf에서 가능한 link 기반 attach |
|---|---|---|
| 학습 포인트 | perf_event_open, event FD, ioctl의 관계 | attach 관계도 kernel object로 관리 |
| 주된 handle | program FD + perf event FD | program FD + link FD |
| 수명 관리 | event/FD를 누가 유지하는지 추적해야 함 | link FD와 pinning으로 관계를 명시하기 쉬움 |
| 적용 범위 | BCC 예제의 실제 관찰 경로 | 지원되는 program/attach 유형과 kernel에서 선택 |
새 도구를 작성한다면 BCC 예제를 그대로 복제하기보다, target kernel 범위와 program type을 먼저 정하고 libbpf의 bpf_program__attach_*() 계열 API가 어떤 attach mechanism을 선택하는지 확인하는 편이 안전하다.
FD, attach, pinning이 object lifetime을 만든다
BPF program과 map은 kernel object이며 reference count로 수명을 관리한다. user space process가 가진 FD, 다른 BPF object의 참조, attach 관계, bpffs pin path가 reference source가 될 수 있다.

출처: Cilium BPF Architecture - Object Pinning.
Process A는 BPF_MAP_CREATE로 map FD를 받고 BPF_OBJ_PIN으로 bpffs path에 reference를 만든다. Process B는 BPF_OBJ_GET으로 같은 pinned object의 새 FD를 얻는다. Process C가 다른 map을 pin하는 모습은 여러 BPF object가 같은 bpffs mount 아래 독립 path를 가질 수 있음을 보여준다.
loader가 종료되면 그 process의 FD는 닫힌다. 그것이 마지막 reference였다면 object는 release된다. bpftool로 program을 load한 뒤 process가 끝났는데도 계속 남기고 싶으면 pinning이나 지속되는 attach 같은 별도 reference가 필요하다.
program type마다 "프로세스 종료 시 사라지는가"가 다르다
이 reference 규칙은 program type에 따라 다르게 나타난다. kprobe·tracepoint처럼 tracing에 쓰이는 program은 그것을 attach한 user space process(로더)와 강하게 묶여 있어서, 그 process가 종료되면 kernel의 reference count도 함께 줄어든다 — 아래 실습 3단계가 보여주는 "loader 종료 → hello program·map이 사라짐" 현상이 정확히 이 경우다.
반면 network stack이나 cgroup에 attach된 program(XDP가 대표적)은 특정 user space process에 묶이지 않는다. ip link set dev eth0 xdp obj hello.bpf.o sec xdp로 XDP program을 attach하면, 그 ip link 명령이 끝난 뒤에도 program은 커널에 남는다 — attach 자체가 만든 reference가 살아있기 때문이다. 즉 "로더 프로세스가 끝나면 program이 사라진다"는 관찰은 kprobe·tracepoint류에 한정된 것이지, 모든 program type의 보편 규칙이 아니다. 이 글의 실습은 kprobe 하나만 다루므로, 다른 program type에서는 그대로 일반화하면 안 된다.
map의 reference count도 비슷한 함정이 있다. eBPF C source가 global variable로 map을 정의만 하고 program bytecode가 실제로 읽거나 쓰지 않으면, 그 program에서 자동으로 reference를 받지 못한다. 이런 경우를 위한 것이 위 표의 BPF_PROG_BIND_MAP이다 — map을 program에 명시적으로 묶어서, user space loader가 종료돼 자신의 map FD를 놓아도 program이 남아있는 한 map이 함께 유지되게 한다.
pinning은 object를 disk file로 저장하는 것이 아니다
bpffs(BPF filesystem)의 path에 object를 pin할 수 있다.
sudo bpftool prog load hello.bpf.o /sys/fs/bpf/hello
sudo bpftool prog show pinned /sys/fs/bpf/hello/sys/fs/bpf/hello는 regular ELF file을 저장한 path가 아니라 kernel object에 연결된 bpffs entry다. 이 path가 유지되는 동안 object를 다시 열 수 있고 reference도 유지된다. bpffs는 memory-backed pseudo filesystem이므로 "pin했으니 reboot 후에도 자동으로 영구 보존된다"라고 이해하면 안 된다. 재부팅 뒤 복구하려면 object를 다시 load/attach하는 boot-time lifecycle을 따로 설계해야 한다.
map도 pin할 수 있다. 이 경우 다른 user space process는 pinned path를 열어 기존 map에 접근할 수 있다. map schema와 owner, 권한, cleanup 주체를 정하지 않으면 오래된 pinned map이 다음 배포의 ABI와 충돌할 수 있다 — 운영 도구라면 map name만 믿기보다 pinned path, map type, key/value size, BTF 정보까지 확인하는 편이 좋다.
unload와 detach도 같은 말이 아니다
"unload"는 program이나 map object 자체의 reference가 사라져 kernel에서 release되는 것이고, "detach"는 program을 hook에서 분리하는 것이다. attach를 detach해도 program FD나 pin이 남아 있으면 program은 unload되지 않는다.
- program FD가 사라져도 attach나 pin이 reference를 유지하면 program은 남을 수 있다.
- attach를 제거해도 map FD나 pinned map이 남아 있으면 map은 남을 수 있다.
- pinned path를 지워도 다른 FD나 program reference가 있으면 object는 즉시 사라지지 않을 수 있다.
"프로세스를 종료했는데 왜 BPF program이 남아 있지?", "pin을 지웠는데 왜 map이 남아 있지?"라는 문제는 object graph의 남은 reference를 보는 문제다. bpftool prog show, bpftool map show, pinned path, 실제 attach 상태를 함께 확인해야 한다.
event 전달은 perf buffer와 ring buffer를 구분해서 본다
output map은 eBPF program이 event data를 user space로 전달하는 channel이다. 책 예제는 BPF_MAP_TYPE_PERF_EVENT_ARRAY(perf buffer) 경로를 사용한다.
perf buffer에서는 각 CPU가 자기 perf ring buffer를 갖는 구조가 일반적이다. BCC loader는 CPU별 perf event FD를 준비하고, eBPF program은 실행 중인 CPU의 event buffer에 record를 쓴다. user space는 여러 FD를 poll해 event를 수집한다.
CPU 0 eBPF -> perf event FD 8  -> user space poll
CPU 1 eBPF -> perf event FD 9  -> user space poll
CPU 2 eBPF -> perf event FD 10 -> user space poll
CPU 3 eBPF -> perf event FD 11 -> user space poll
이 때문에 4 CPU 책 예제에서는 output map 초기화가 네 번 반복된다. CPU 수는 실행 machine에 따라 달라지므로 이 숫자를 portable constant로 쓰면 안 된다.
ring buffer가 해결하려는 문제
Linux의 BPF ring buffer는 여러 producer CPU와 하나 이상의 user space consumer를 위한 shared buffer model을 제공한다. 공식 kernel 문서는 perf buffer의 두 한계를 주요 동기로 든다.
- CPU별 buffer를 두면 메모리가 CPU별로 나뉘어 여유 공간을 공유하기 어렵다.
- 서로 다른 CPU에서 시간 순서대로 발생한 event의 전역 순서를 보존하기 어렵다.
ring buffer는 이 문제를 해결하기 위해 하나의 shared MPSC(multi-producer, single-consumer) ring buffer를 사용한다. eBPF program은 bpf_ringbuf_output()으로 복사하거나, bpf_ringbuf_reserve() 후 데이터를 채우고 bpf_ringbuf_commit()할 수 있다. user space는 map을 memory-map하고 epoll notification 또는 polling으로 record를 소비한다.
| 항목 | perf buffer | BPF ring buffer |
|---|---|---|
| 기본 구조 | CPU별 perf ring buffer | CPU들이 공유하는 MPSC buffer |
| event 순서 | CPU 간 전역 순서 복원이 어려울 수 있음 | reservation 순서 기준 전역 ordering을 보존하도록 설계됨 |
| 메모리 활용 | CPU별 capacity가 분리됨 | buffer capacity를 CPU 간 공유 |
| eBPF 쪽 API 예 | bpf_perf_event_output() | bpf_ringbuf_output(), reserve/submit/discard |
| BCC 예 문법 | BPF_PERF_OUTPUT, perf_submit | BPF_RINGBUF_OUTPUT, ringbuf_output |
| 고려 사항 | 기존 도구/구형 kernel 호환성 | target kernel 지원과 shared buffer 용량 설계 |
ring buffer가 더 새로운 선택지라는 사실만으로 perf buffer가 잘못된 것은 아니다. target kernel, 기존 library의 지원 수준, event size, ordering 필요성, migration cost를 보고 선택해야 한다. "순서"는 user space가 event를 읽은 시각이 아니라 kernel에서 record를 reserve한 순서라는 점을 구분해야 한다.
예제의 BCC API를 ring buffer 방식으로 바꾸면 대략 다음 표처럼 변한다.
| perf buffer 예제 | ring buffer 대응 |
|---|---|
BPF_PERF_OUTPUT(output); | BPF_RINGBUF_OUTPUT(output, page_cnt); |
output.perf_submit(ctx, &data, sizeof(data)); | output.ringbuf_output(&data, sizeof(data), 0); |
open_perf_buffer(callback) | open_ring_buffer(callback) |
perf_buffer_poll() | ring_buffer_poll() |
BPF_RINGBUF_OUTPUT의 두 번째 인자 page_cnt는 buffer의 byte 크기가 아니라 2의 거듭제곱 페이지 개수다. 실제 buffer 크기는 page_cnt * PAGE_SIZE가 된다.
API 이름의 차이만 보지 말고, CPU별 FD를 output map에 채우는 perf buffer 초기화 단계가 ring buffer에서는 사라진다는 구조 차이를 함께 봐야 한다.
bpftool map dump도 결국 bpf() syscall이다
sudo bpftool map dump name config는 사람에게는 "이름으로 map을 찾아 dump한다"로 보이지만, user space utility인 bpftool도 kernel object를 직접 읽지 못한다. 내부적으로 syscall command를 조합한다.
전체 map 찾기
  BPF_MAP_GET_NEXT_ID
  -> BPF_MAP_GET_FD_BY_ID
  -> BPF_OBJ_GET_INFO_BY_FD
  -> name == "config" 인지 확인

entry 순회
  BPF_MAP_GET_NEXT_KEY
  -> BPF_MAP_LOOKUP_ELEM
-> 다음 key가 없을 때까지 반복BPF_MAP_GET_NEXT_KEY에서 더 이상 key가 없으면 -1과 errno=ENOENT가 돌아올 수 있다. 이 값은 dump 실패가 아니라 iterator의 정상 종료 조건일 수 있다. map 내용을 자체 tooling으로 순회할 때는 이 protocol을 정확히 처리해야 한다.
BTF가 key/value type을 제공하면 bpftool은 raw hex 대신 structure field를 사람이 읽기 쉬운 형태로 보여줄 수 있다. 다만 BTF는 map data의 도메인 의미까지 보장하지 않는다 — ABI의 byte layout을 설명할 뿐이며, value가 현재 코드 버전에서 무엇을 뜻하는지는 loader와 eBPF program의 계약이다.
권한과 보안은 verifier와 별개로 본다
verifier가 안전성 검사를 통과시킨다고 해서 모든 eBPF program을 아무나 load할 수 있는 것은 아니다. BPF program load와 attach 권한은 Linux capability, unprivileged BPF 관련 sysctl/policy, program type, LSM 및 container runtime의 제한에 영향을 받는다. kernel과 배포판 설정에 따라 관찰되는 errno도 달라질 수 있다.
실무에서 지켜야 할 최소 기준은 간단하다.
- 신뢰할 수 있는 source와 build pipeline에서 나온 BPF object만 load한다.
- observability tool도 process, file path, network metadata처럼 민감한 정보를 수집할 수 있음을 전제로 접근 권한을 설계한다.
CAP_BPF또는 더 넓은 권한을 주는 것만으로 해결하려 하지 말고, 필요한 program type과 attach target을 최소화한다.- pinned object의 owner, path, cleanup lifecycle을 정한다. 남은 map과 link는 다음 배포의 동작을 바꿀 수 있다.
이 글의 BCC kprobe 예제는 학습용으로 execve를 관찰한다. 운영 환경에서 kernel function 이름에 기대는 probe는 kernel version과 configuration 변화에 영향을 받을 수 있다. 안정된 tracepoint가 제공되는 상황이라면 tracepoint를 우선 검토하고, kprobe를 써야 한다면 target 존재 여부와 fallback을 loader에서 처리해야 한다.
실습해보기
위 개념을 확인하는 실습이다. 목적은 hello-buffer-config.py 실행 자체가 아니라, BCC Python 코드가 다음 네 가지 사실로 바뀌는 과정을 직접 증명하는 데 있다.
- loader가
BPF_MAP_CREATE와BPF_PROG_LOAD로 kernel object를 만들고 FD를 받는다. - Python의 map assignment가
BPF_MAP_UPDATE_ELEMsyscall로 나타난다. execve()event가 발생하면 eBPF program이 perf buffer를 통해 user space로 event를 보낸다.- loader process가 종료되면 pin하지 않은 BPF object의 reference가 사라진다.
실습은 3개의 기본 단계와 1개의 선택 단계로 구성한다.
| 단계 | 실습 내용 | 남길 기록 |
|---|---|---|
| 1 | strace로 loader control path 기록 | strace log, command와 반환 FD의 대응표 |
| 2 | map control path와 event data path 확인 | bpftool map dump, execve event output |
| 3 | load, attach, process lifetime 확인 | 실행 중/종료 후 bpftool object 상태 비교 |
| 선택 | bpffs pinning 확인 | BPF_OBJ_PIN, BPF_OBJ_GET, cleanup 결과 |
준비
git clone https://github.com/lizrice/learning-ebpf
cd learning-ebpf/chapter4

command -v python3
command -v strace
command -v bpftool
test -r /sys/kernel/btf/vmlinux && echo "BTF is available"

LAB_DIR=/tmp/week04-bpf-system-call
mkdir -p "$LAB_DIR"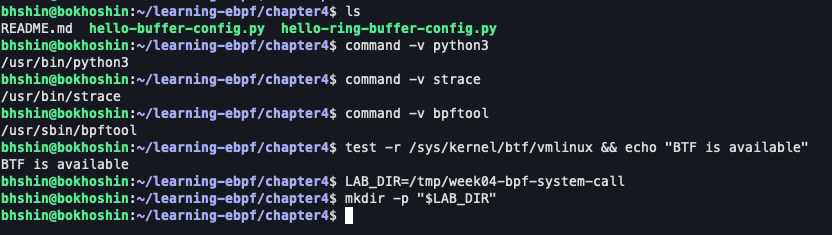
LAB_DIR은 이 shell에서만 유효하다. terminal을 여러 개 오가므로, 새로 여는 terminal에서 $LAB_DIR을 쓰기 전에는 LAB_DIR=/tmp/week04-bpf-system-call을 그 terminal에서도 먼저 실행한다.
1. strace로 loader control path를 기록한다
첫 번째 terminal에서 실행하고 계속 켜 둔다.
sudo strace -f \
  -o "$LAB_DIR/strace-bpf.log" \
  -e trace=bpf,perf_event_open,ioctl,ppoll \
  python3 hello-buffer-config.py
두 번째 terminal에서 중요한 syscall만 추린다. (이 terminal은 새로 연 shell이므로 LAB_DIR을 먼저 다시 설정한다.)
LAB_DIR=/tmp/week04-bpf-system-call

grep -E 'BPF_(BTF_LOAD|MAP_CREATE|PROG_LOAD|MAP_UPDATE_ELEM)|perf_event_open|PERF_EVENT_IOC_(SET_BPF|ENABLE)' \
  "$LAB_DIR/strace-bpf.log"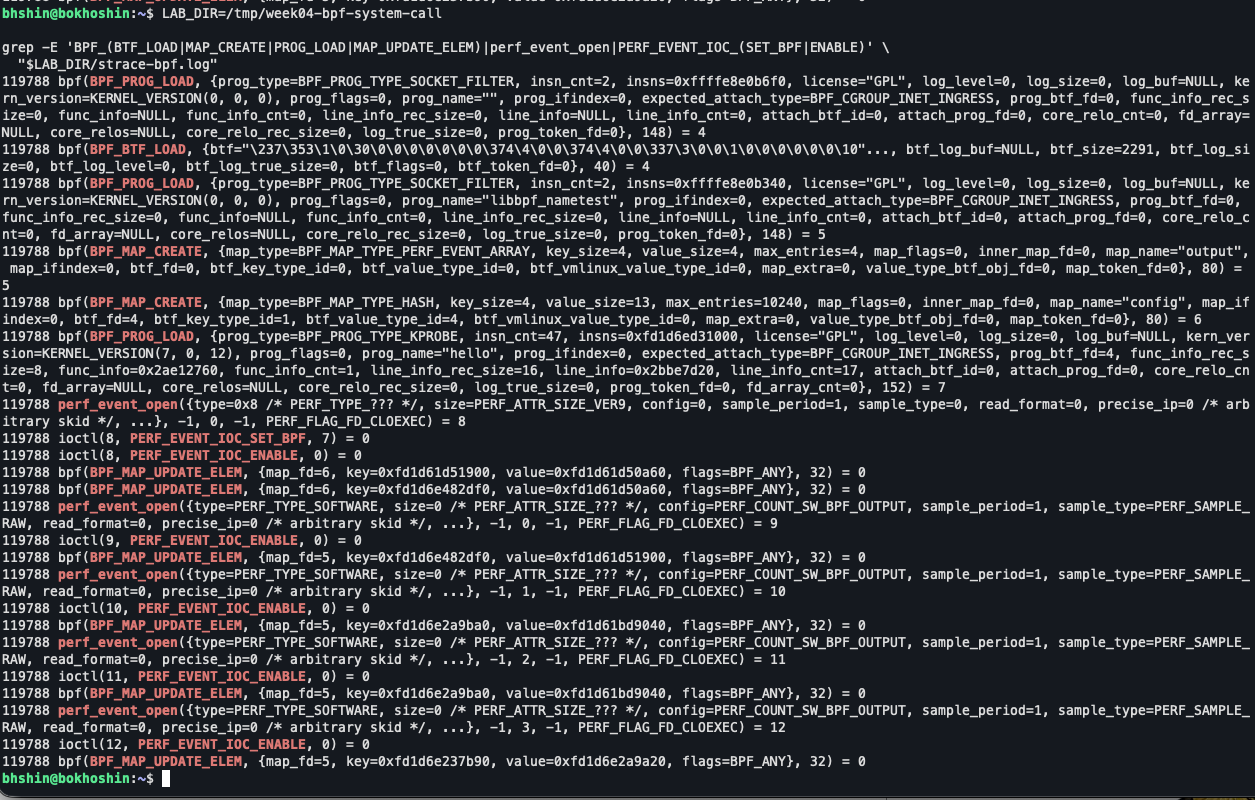
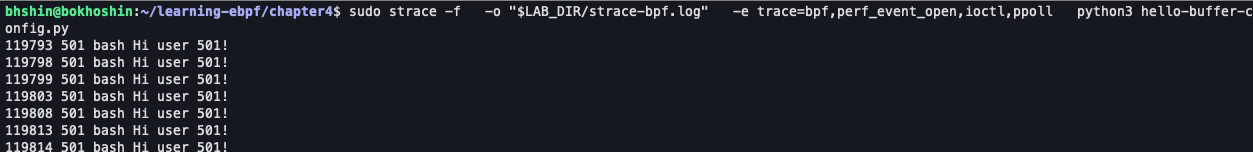
kernel/BCC 조합에 따라 BPF_BTF_LOAD 호출 자체가 없을 수 있다 — 첫 줄이 빠져도 실패로 보지 말고 나머지 command 순서만 비교한다.
$LAB_DIR/fd-object-table.md에 아래 표를 채운다.
| 관찰한 syscall | 기록할 값 |
|---|---|
BPF_BTF_LOAD | 반환 FD 또는 call 생략 여부 |
BPF_MAP_CREATE | map name, type, 반환 FD |
BPF_PROG_LOAD | program name, 반환 FD |
BPF_MAP_UPDATE_ELEM | map_fd, flags, return value |
perf_event_open과 ioctl | event FD, program FD |
BPF_MAP_CREATE처럼 같은 syscall이 여러 번 나오면(예: output, config map 생성) map별로 별도 줄에 적는다.
2. map의 설정값이 event output에 반영되는지 확인한다
첫 번째 terminal에서 loader가 실행 중인 상태로 둔 채, 두 번째 terminal에서 실행한다.
sudo bpftool map show name config
sudo bpftool map dump name config
sudo /usr/bin/true
첫 번째 terminal의 event output에 root UID(0)와 Hey root! message가 나타난다.
특정 user ID 설정도 확인하려면, 실행 중인 loader를 Ctrl-C로 멈춘다. hello-buffer-config.py에서 다음 줄을 찾는다.
b["config"][ct.c_int(501)] = ct.create_string_buffer(b"Hi user 501!")파일 맨 위(from bcc import BPF 다음 줄)에 아래 한 줄을 한 번만 추가한다.
import os그리고 위에서 찾은 줄을 다음 두 줄로 교체한다.
target_uid = ct.c_int(int(os.environ["TARGET_UID"]))
b["config"][target_uid] = ct.create_string_buffer(b"Hi lab user!")
첫 번째 terminal(방금 Ctrl-C로 멈춘 자리)에서 수정한 파일을 다시 실행한다.
TARGET_UID="$(id -u)"
sudo strace -f \
  -o "$LAB_DIR/strace-bpf.log" \
  -e trace=bpf,perf_event_open,ioctl,ppoll \
  env TARGET_UID="$TARGET_UID" python3 hello-buffer-config.py
두 번째 terminal에서 sudo 없이 실행한다.
/usr/bin/true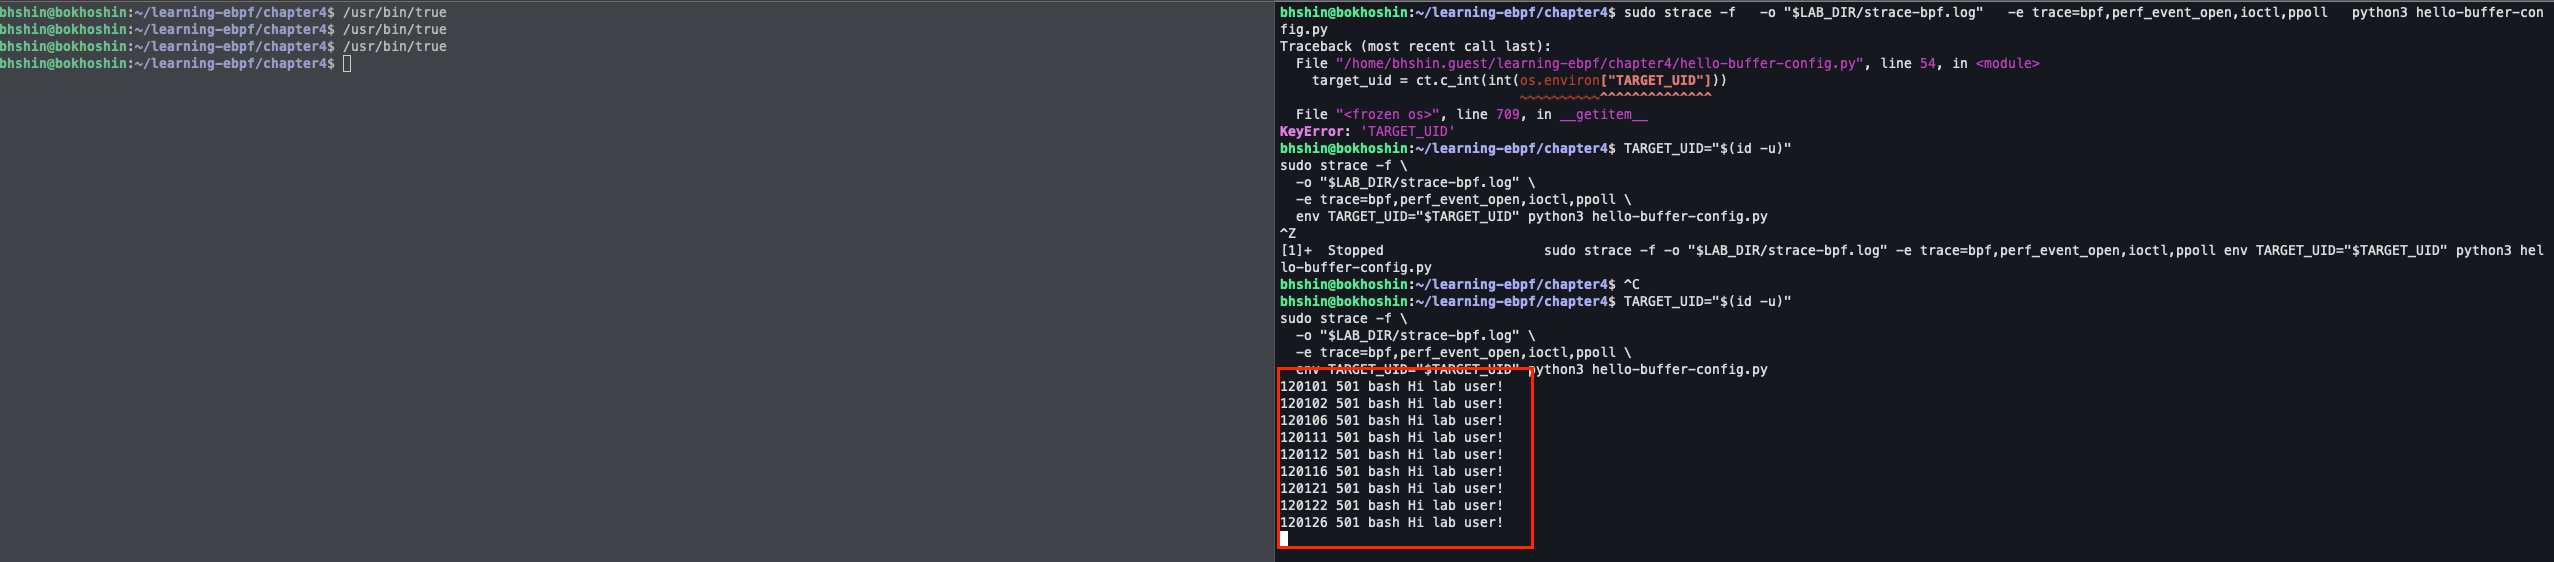
event output의 message도 Hi lab user!로 나타난다.
3. attach된 program의 lifetime을 확인한다
이전 단계에서 띄워둔 loader가 남아있지 않은지 먼저 정리한다. Ctrl-C가 항상 바로 먹히는 것은 아니다 — sudo가 strace용으로 pty를 새로 할당하는 방식과 터미널의 job control이 겹치면, 프로세스가 종료되지 않고 정지(stopped, ps의 STAT 컬럼이 T/t) 상태로만 남을 수 있다. 정지된 프로세스는 SIGKILL(-9) 외의 신호는 무시하므로, 확실히 정리하려면 강제 종료한다.
sudo pkill -9 -f hello-buffer-config.py
ps aux | grep hello-buffer-config.py   # grep 자기 자신 말고는 안 나와야 정상
이 terminal도 새로 연 shell이라면 LAB_DIR을 먼저 다시 설정한다.
LAB_DIR=/tmp/week04-bpf-system-call
TARGET_UID="$(id -u)"
sudo strace -f \
  -o "$LAB_DIR/strace-bpf.log" \
  -e trace=bpf,perf_event_open,ioctl,ppoll \
  env TARGET_UID="$TARGET_UID" python3 hello-buffer-config.py
첫 번째 terminal의 loader가 실행 중일 때, 별도 terminal에서 기록한다.
sudo bpftool prog show name hello
sudo bpftool map show name config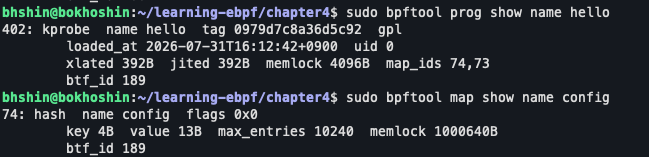
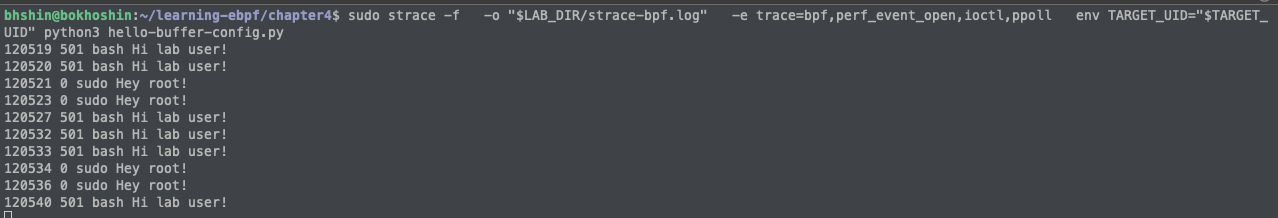
첫 번째 terminal에서 Ctrl-C로 종료를 시도한다. 몇 초 뒤에도 ps aux | grep hello-buffer-config.py에 여전히 프로세스가 보이면(위에서 설명한 정지 상태일 가능성이 높다), 별도 terminal에서 강제 종료한 뒤 같은 명령을 다시 실행한다.
sudo pkill -9 -f hello-buffer-config.py
ps aux | grep hello-buffer-config.py

sudo bpftool prog show
sudo bpftool map show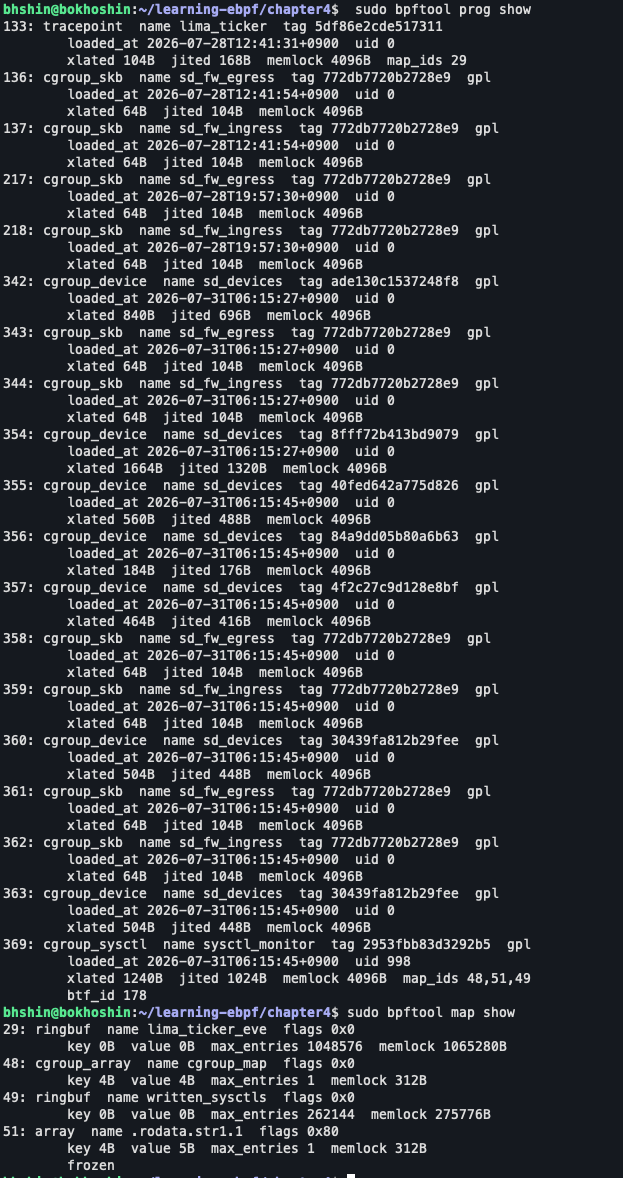
위 스크린샷(구체적인 ID는 환경마다 다르게 나온다)처럼, 실행 중일 때 보였던 hello kprobe program과 output/config map이 loader 종료 후 목록에서 모두 사라진다.
4주차에서 남길 모델
bpf() syscall은 "BPF를 실행하는 syscall"이 아니라 user space loader가 BPF kernel object를 관리하는 control-plane API다. eBPF tool은 보통 아래의 두 경로를 동시에 가진다.
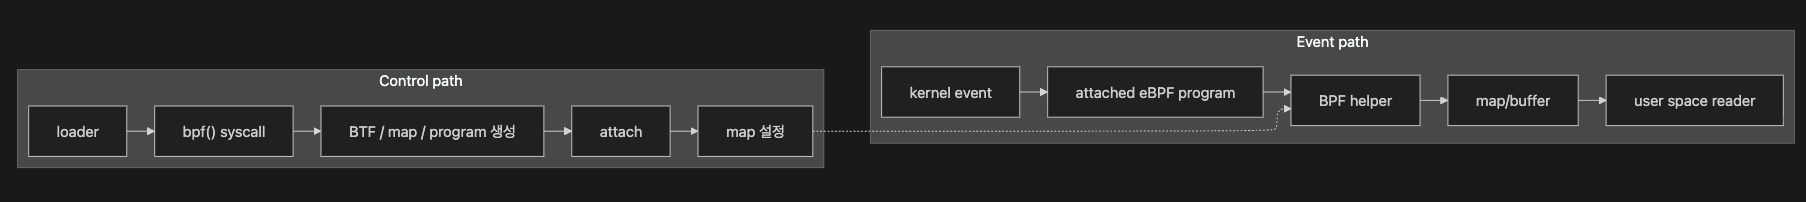
이 두 경로를 분리해 두면 다음을 자연스럽게 설명할 수 있다.
- BCC loader가 BTF, map, program object를 만들고 각각의 FD를 받는 과정
BPF_PROG_LOAD처리 중 verifier가 언제, 무엇을 검사하는가- BCC의 Python map assignment가 왜
BPF_MAP_UPDATE_ELEM으로 보이는가 - eBPF C code의 map lookup이 왜 syscall trace에 매 event마다 나타나지 않는가
BPF_PROG_LOAD성공과 attach 성공을 왜 따로 확인해야 하는가- loader 종료, pinning, BPF link가 왜 object 수명에 영향을 주는가
- perf buffer와 ring buffer가 event payload의 data plane 설계 선택인 이유는 무엇인가
5주차에서는 이 BTF FD가 담는 type metadata와, CO-RE와 libbpf가 kernel version 차이를 어떻게 흡수하는지 살펴본다. 4주차의 bpf() syscall은 그 모든 high-level abstraction 아래에 있는 kernel ABI다.
용어
bpf(): eBPF map, program, BTF, link 같은 BPF object를 조작하는 Linux syscall.union bpf_attr:bpf()command별 input/output parameter를 담는 ABI 구조체.- BPF helper: kernel에서 실행 중인 eBPF program이 map과 제한된 kernel 기능에 접근하는 함수.
- BPF map: user space와 eBPF program 또는 여러 eBPF program이 데이터를 공유하는 kernel object.
- BPF verifier: load 전 모든 실행 경로의 memory access와 control flow 등을 검사하는 kernel component.
- file descriptor(FD): 한 process가 열린 kernel object를 가리키는 local handle.
- pinning: bpffs path로 BPF object를 참조해 loader process 종료 뒤에도 object에 접근하고 수명을 유지하는 방법.
- BPF link: program과 attach target의 관계를 나타내는 BPF object. 지원되는 attach 유형에서 lifecycle 관리에 사용된다.
- perf buffer:
BPF_MAP_TYPE_PERF_EVENT_ARRAY기반의 event 전달 경로. 보통 CPU별 perf buffer를 사용한다. - BPF ring buffer: shared MPSC buffer 기반의 event 전달 map. CPU 간 event ordering과 memory utilization 문제를 해결하기 위해 추가됐다.
참고 자료
시리즈 원전 — 이 글이 따라간 챕터와 예제 코드
- Liz Rice,
Learning eBPF, Chapter 4 "The bpf() System Call" — 이 글의 BCChello-buffer-config.py,strace, FD/reference 예제의 원전 - Learning eBPF Chapter 4 예제 코드: https://github.com/lizrice/learning-ebpf/tree/main/chapter4 — 실습에서 그대로 clone해 쓰는 소스
공식 정의·매뉴얼 — bpf() ABI 자체를 1차 자료로 확인할 때
- Linux
bpf(2)manual: https://man7.org/linux/man-pages/man2/bpf.2.html —cmd/union bpf_attr필드의 공식 정의 - Linux kernel BPF syscall API: https://docs.kernel.org/userspace-api/ebpf/syscall.html — man page보다 최신 커널 기준 syscall 표
커널 내부 동작 — 이 글이 다룬 각 object의 구현 배경을 더 파고들 때
- Linux kernel BPF documentation: https://www.kernel.org/doc/html/latest/bpf/ — BPF 서브시스템 전체 목차
- Linux kernel BPF maps documentation: https://docs.kernel.org/bpf/maps.html — map type별 동작 차이(이 글의 hash map/perf event array 이해에 직결)
- Linux kernel BPF ring buffer design: https://docs.kernel.org/bpf/ringbuf.html — perf buffer와 ring buffer를 비교한 절의 근거
- Linux kernel eBPF verifier documentation: https://docs.kernel.org/bpf/verifier.html — 이 글이 6주차로 미룬 verifier 내부의 다음 읽을거리
비교·설계 맥락 — 책 예제 이후 생태계가 어떻게 바뀌었는지 볼 때
- Cilium BPF Architecture - Maps and Object Pinning: https://docs.cilium.io/en/stable/reference-guides/bpf/architecture/ — 이 글의 map 공유·pinning 그림 2장의 출처
- libbpf
bpf_link_createdocumentation: https://docs.ebpf.io/ebpf-library/libbpf/userspace/bpf_link_create/ — 책 예제(perf event+ioctl)와 대조한 현대 libbpf attach의 근거
배경 지식 — 이 장의 개념이 왜 그렇게 설계됐는지 더 넓게 볼 때
- Liz Rice,
What Is eBPF?, Chapters 2-3 — verifier, dynamic loading, map과 user space loader의 역할 설명 - Brendan Gregg,
BPF Performance Tools, Chapter 2 "BPF" — BPF API, tracing과 observability에서 BPF를 쓰는 맥락