커널마다 다시 컴파일하지 않고, load 시점에 필드 오프셋을 다시 맞추는 방법
확인할 것
다음 질문에 답할 수 있으면 5장의 목표를 달성한 것이다.
- BCC는 왜 target machine에서 compile하고, 그 방식은 production 배포에서 왜 부담이 되는가?
task->pid같은 field access가 compile 후 실제로는 어떤 형태로 바뀌는가?- BTF는 무엇을 설명하는 metadata이고,
.BTF와.BTF.ext는 각각 무엇을 담는가? vmlinux.h는 kernel header를 완전히 대체하는가, 아니면 어떤 한계가 있는가?- libbpf는 load phase에서 정확히 무엇을 patch하는가?
SEC()section name은 libbpf에게 어떤 정보를 주는가?- CO-RE가 해결하지 못하는 경우에는 어떤 fallback이 필요한가?
BTF 인코딩 세부 구조, CO-RE relocation kind 13종 전체, verifier 내부 동작은 이 글의 범위 밖이다.
verifier는 6주차에서 다룬다.
설명
BCC는 target machine에서 다시 컴파일해 이식성을 해결한다
BCC는 Python user space program 안에 eBPF C source를 문자열로 넣고, target machine에서 실행할 때 compile한다.
from bcc import BPF

program = r"""
int hello(void*ctx) {
    bpf_trace_printk("hello\n");
    return 0;
}
"""

b = BPF(text=program)
target machine의 kernel header를 보고 compile하므로 field offset도 target kernel 기준으로 자동으로 맞다.
그래서 BCC는 학습과 실험에 좋다.
하지만 이 방식의 본질은 target host가 build environment 역할까지 한다는 점이다.
- 모든 target machine에 Clang/LLVM과 kernel header가 있어야 한다.
- tool을 시작할 때마다 compile delay가 생긴다.
- 같은 fleet에서 같은 compile 작업이 반복된다.
- compile error가 build/CI가 아니라 runtime에 드러날 수 있다.
- 소스와 toolchain을 container image로 패키징해도 문제가 완전히 풀리지 않는다.
kernel header가 여전히 필요하다. 같은 BCC container가 여러 machine에 중복 설치되는 문제도 그대로 남는다. - embedded 환경에서는 compiler toolchain 자체가 부담이다.
학습·탐색·one-off tracing에는 잘 맞지만, 널리 배포할 production tool에는 부담이 커진다.
Kubernetes DaemonSet처럼 노드마다 커널 버전·이미지가 제각각인 환경(GKE·EKS·AKS 등)에서는 이 부담이 특히 커진다.
CO-RE는 컴파일을 늦추는 게 아니라 binding을 늦춘다
CO-RE(Compile Once, Run Everywhere)라는 이름은 방향은 잘 보여준다.
다만 문자 그대로 모든 kernel·모든 architecture에서 조건 없이 돈다는 뜻은 아니다.
실무적으로는 "같은 architecture 계열과 지원 kernel 범위 안에서, target host runtime compilation 없이 portable하게 배포하는 방식"으로 이해하는 편이 정확하다.
CO-RE는 BCC처럼 source를 target host로 가져가 compile하지 않는다.
대신 build time에 object file 안에 충분한 metadata(compiler가 본 type 정보, instruction이 어떤 field access에서 왔는지 설명하는 relocation record)를 남긴다.
target host에서는 libbpf가 running kernel의 BTF를 읽고, object 안의 정보와 비교해 field offset이 다르면 bytecode instruction을 patch한다.
가장 좁혀서 보면, 이 절의 핵심은 field offset이 "언제" 확정되고 그때 "무엇"이 필요한가다.
| 방식 | field offset이 확정되는 시점 | 필요한 정보 |
|---|---|---|
| BCC | target host에서 runtime compile할 때 | target kernel headers |
| CO-RE/libbpf | target host에서 object를 load할 때 | object BTF, CO-RE relocation record, target kernel BTF |
이 시점 차이는 배포 단위, map 문법, 강점과 비용까지 이어진다. 전체를 한 번에 비교하면 다음과 같다.
| 주제 | BCC | CO-RE/libbpf |
|---|---|---|
| 배포 단위 | Python + embedded BPF C source | pre-built .bpf.o, skeleton, executable |
| compile 위치 | target host runtime | build machine |
| kernel layout 대응 | target kernel header로 compile | BTF + relocation으로 load-time patch |
| map 정의 | BPF_HASH, BPF_PERF_OUTPUT | SEC(".maps"), __uint, __type |
| map 접근 | map.lookup(), map.update() | bpf_map_lookup_elem(), bpf_map_update_elem() |
| field access | BCC가 bpf_probe_read()로 rewrite | BPF_CORE_READ() 등으로 명시 |
| 강점 | 빠른 실험, 짧은 code, 낮은 진입 장벽 | production 배포, no runtime compiler, explicit lifecycle |
| 비용 | runtime compiler/header 의존성 | 초반 학습 비용, 장황한 boilerplate |
이 표에서 중요한 것은 "문법이 다르다"가 아니라 배포 모델이 다르다는 점이다.
BCC는 target host가 build environment 역할까지 한다.
CO-RE/libbpf는 target host가 load environment 역할만 하게 만든다.
두 방식이 build·target machine을 몇 개 쓰는지 그림으로 보면 이 차이가 더 분명하다.
이 그림은 BCC와 CO-RE/libbpf가 machine을 몇 개 쓰는지를 보여준다.
BCC는 target machine 하나가 compile과 load를 모두 담당하므로, 그 machine에 항상 compiler와 kernel header가 있어야 한다.
CO-RE는 build machine에서 compile해 BTF와 relocation record를 담은 .bpf.o를 만들고, target machine에는 완성된 object만 배포한다.
target machine에서 하는 일은 compile이 아니라 libbpf가 object BTF와 target BTF를 비교해 instruction을 patch하는 것뿐이다.
field access는 결국 offset access가 된다
다음 C code를 사람은 “task_struct 안의 pid field를 읽는다”고 이해한다.
pid_t pid = task->pid;하지만 compile된 BPF instruction은 field 이름을 그대로 들고 실행되지 않는다.
개념적으로는 다음과 같은 access로 내려간다.
read sizeof(pid_t) bytes at task + OFFSET_OF_PID문제는 OFFSET_OF_PID가 kernel마다 달라질 수 있다는 점이다.
개발 machine의 kernel에서는 pid field가 offset 100에 있었다.
target machine의 kernel에서는 앞에 다른 field가 추가되어 offset 112가 됐을 수 있다.
source code는 같은 task->pid였다.
하지만 compile 결과에 박힌 offset이 target kernel에 맞지 않으면 program은 틀린 값을 읽는다.
eBPF portability의 핵심은 “field 이름으로 표현한 의도를 어떻게 target kernel의 실제 offset과 다시 연결할 것인가”다.
offset이 밀리는 원인은 필드 추가만이 아니다. char 1바이트 뒤에 u64가 오면, 왜 구조체 크기는 9바이트가 아니라 16바이트가 될까?
compiler는 각 필드를 CPU가 다루기 좋은 메모리 경계(alignment)에 놓으려고 필드 사이에 padding을 끼워 넣는다. u64가 8바이트 경계에서 시작하도록 char 뒤에 7바이트짜리 hole이 생기는 것이다. 소스 코드가 안 바뀌어도 다른 필드가 추가되거나 타입 크기가 바뀌면 이 padding 계산이 달라져 뒤 필드의 offset이 밀릴 수 있다.
근본적으로 task_struct 같은 kernel 내부 struct는 고정된 공개 ABI가 아니다. kernel 개발자는 새 기능을 위해 필드를 추가·삭제·재배치할 뿐 아니라, #ifdef CONFIG_XXX로 필드를 감싸서 그 config 옵션이 켜진 build에서만 필드가 존재하게 만들기도 한다. 이 세 가지(필드 추가/삭제/재배치, 정렬 변화, config 조건부 필드) 중 어느 것이든 그 필드보다 뒤에 있는 모든 필드의 offset을 함께 밀어낸다 — state 필드 자신은 한 글자도 안 바뀌었어도, 그 앞의 다른 필드가 바뀌면 offset이 통째로 달라질 수 있다.
BTF는 kernel type schema다
BTF(BPF Type Format)는 C type 정보를 compact하게 표현하는 metadata format이다.
“debug information 비슷한 것”처럼 보일 수 있다.
하지만 CO-RE를 이해할 때는 “kernel type schema”로 보는 편이 낫다.
task_struct에 어떤 field가 있는지 설명한다.- 각 field가 몇 bit offset에 있는지 설명한다.
- map value의 raw bytes를 어떤 field와 type으로 해석할지 알려준다.
- function signature와 line information을 tool이 활용할 수 있게 한다.
- CO-RE relocation에서 field access를 target kernel layout에 맞출 기준이 된다.
예를 들어 4주차 예제의 struct user_msg_t { char message[12]; }가 BTF로 전달되면, bpftool은 map value의 12 bytes를 그냥 byte array가 아니라 message[12] field로 해석할 수 있다.
이 12바이트가 BTF 관점에서 실제로 어떻게 나뉘어 해석되는지 그림으로 보면 더 분명하다.
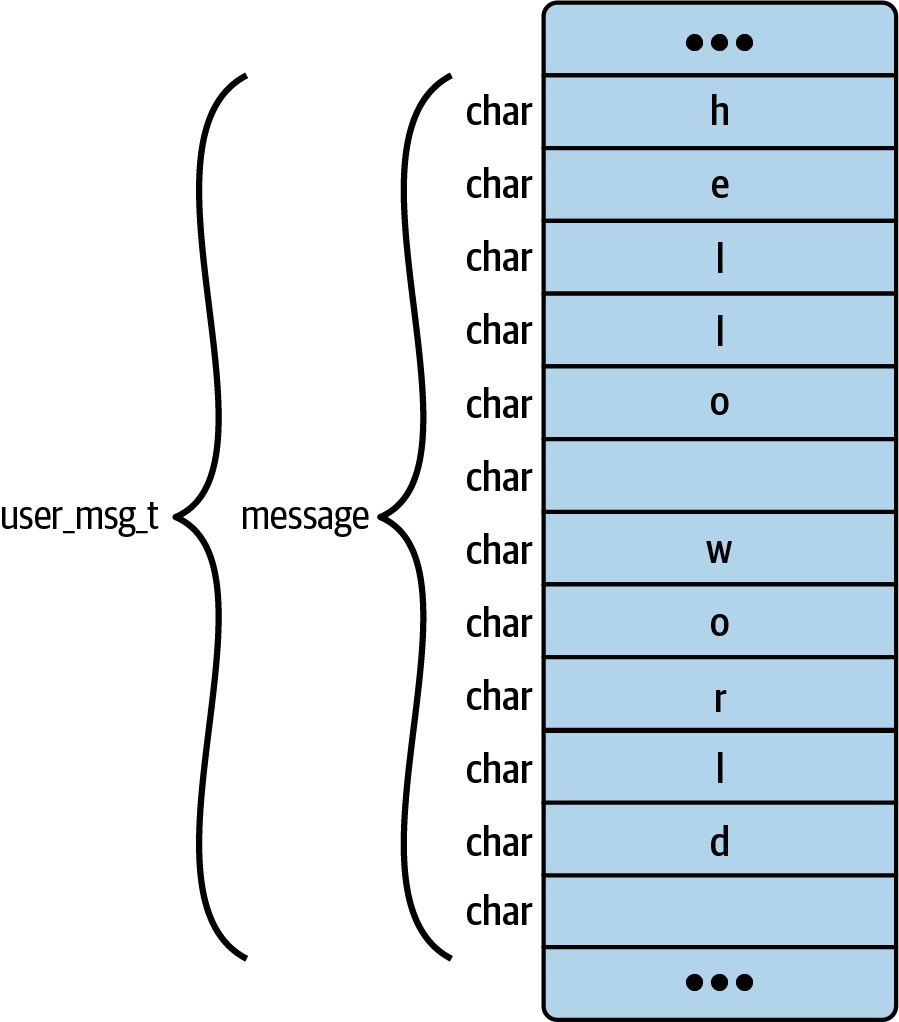
출처: Liz Rice, Learning eBPF, Figure 5-1(O’Reilly, 2023) 기반 재작도
이 그림은 12바이트짜리 message 필드가 BTF 관점에서 char 1바이트씩 12개의 연속된 요소로 해석된다는 것을 보여준다.
bpftool이 map value를 "Hello World" 같은 문자열로 예쁘게 출력할 수 있는 건 바로 이 필드 단위 정보 덕분이다.
BTF가 없다면 이 12바이트는 그냥 opaque한 raw byte 뭉치로만 보인다.
.BTF ELF section은 header, type section, string section 세 부분이 순서대로 이어진 blob이다.
.BTF는 이 type/string data를 담고, .BTF.ext는 function info·line info·CO-RE relocation record를 담는다.
이 구분은 뒤에서 볼 CO-RE relocation의 전제가 된다.
BTF 자체의 정확한 byte-level 인코딩(header 필드, btf_type의 20가지 kind)은 이 글의 범위 밖이다.
BTF의 쓰임은 CO-RE relocation만이 아니다.
BPF_MAP_CREATE에 쓰이는 bpf_attr에는 btf_fd, btf_key_type_id, btf_value_type_id 같은 field가 있어 kernel이 map value의 구조를 introspect할 수 있게 한다.
bpf_spin_lock()/bpf_spin_unlock()도 “BTF information이 structure 안에서 lock field 위치를 설명할 수 있을 때만” 쓸 수 있다.
BTF가 단순 pretty-print용 부가 정보가 아니라, kernel이 map value의 정체를 실제로 판단하는 데도 쓰인다는 뜻이다.
vmlinux.h는 build-time snapshot이지 항상 같은 header가 아니다
CO-RE BPF program도 compile하려면 C type definition이 필요하다.
BTF-enabled kernel에서는 running kernel의 BTF에서 C header를 생성할 수 있다.
bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.h이 generated header를 관례적으로 vmlinux.h라고 부른다.
다만 이걸 “모든 kernel에서 영원히 같은 header”로 이해하면 안 된다.
vmlinux.h는 build 시점에 compiler가 type을 이해하도록 돕는 snapshot일 뿐이다.
실제 portability는 이 snapshot과 target kernel BTF를 libbpf가 비교·보정하는 과정에서 나온다.
| 항목 | 역할 |
|---|---|
vmlinux.h | build-time C type definition |
object .BTF | object가 compile 시점에 본 type metadata |
object .BTF.ext | function info, line info, CO-RE relocation record |
/sys/kernel/btf/vmlinux | target kernel의 실제 type/layout metadata |
BTF는 C preprocessor의 #define macro constant를 기록하지 않는다.
Ethernet protocol number 같은 값이 필요하면 직접 정의하거나 별도 header를 include해야 한다.
/sys/kernel/btf/vmlinux가 있으려면 kernel이 CONFIG_DEBUG_INFO_BTF=y로 build돼야 한다.
이 옵션은 DWARF debug info를 pahole이 deduplicated BTF로 변환하는 과정에 의존한다.
최신 mainline(6.9+)은 pahole v1.22 이상을 요구한다.
“이 machine에 BTF가 있는가”는 커널 버전뿐 아니라 그 커널을 빌드한 배포판의 pahole 버전에도 달려 있다는 뜻이다.
CO-RE object는 특정 compile 옵션이 있어야 만들어진다
CO-RE object를 만드는 compile 명령은 대략 다음과 같은 형태다.
clang -target bpf -D __TARGET_ARCH_x86 -O2 -g -c hello.bpf.c -o hello.bpf.o-g는 BTF·CO-RE relocation에 필요한 type 정보를 만들지만 불필요한 DWARF debug 정보도 함께 만든다 — 배포 전 llvm-strip -g로 .debug_*만 지우면 .BTF/.BTF.ext는 남기고 크기를 줄일 수 있다.
-O2는 관례가 아니라 사실상 필수다. 최적화 없이(-O0) compile하면 Clang이 일부 helper 호출을 callx <register>로 만드는데, eBPF는 이 간접 호출을 지원하지 않아 kernel이 unknown opcode로 load를 거부한다.
-D __TARGET_ARCH_x86은 이 둘과 종류가 다른 설정이다. -O2/-g는 같은 소스를 어떻게 컴파일할지의 문제지만, 아키텍처 지정은 애초에 다른 소스(다른 pt_regs layout)를 만드는 문제다. 그래서 이 값은 나중에 CO-RE가 흡수해주지 못하고, 배포 대상 아키텍처별로 각각 compile해야 한다 — 이 글 뒷부분의 "CO-RE가 해결하지 않는 것"과 이어지는 지점이다.
libbpf는 CO-RE가 실제로 적용되는 지점이다
libbpf를 단순히 “C로 된 BPF library”로만 보면 이 장의 핵심을 놓치기 쉽다.
CO-RE 문맥에서 libbpf는 metadata를 실제 load 가능한 BPF program으로 바꾸는 지점이다.
이 변환이 몇 단계로 이뤄지는지 그림으로 보면 더 분명하다.
libbpf는 ELF section 해석부터 hook attach까지 7단계를 순서대로 거친다.
그중 CO-RE relocation이 실제로 적용되는 구간은 4~5단계뿐이다.
4단계에서 target kernel BTF와 type/field를 matching한다.
5단계에서 그 결과로 instruction offset을 patch한다.
나머지 단계(1~3단계 파싱·준비, 6~7단계 kernel load·attach)는 CO-RE가 없는 일반 BPF program을 load할 때도 똑같이 거치는 과정이다.
4~5단계가 6단계(kernel load·verifier 통과)보다 반드시 먼저 끝나야 하는 이유는 verifier가 검사하는 대상 자체가 patch 이후의 bytecode이기 때문이다. verifier는 target kernel의 실제 struct layout을 모르고, 그저 자신에게 주어진 bytecode의 pointer·memory access가 안전한 범위 안에 있는지만 정적으로 검사한다. 그래서 target kernel 기준으로 올바른 offset이 이미 박혀 있는 상태로 bytecode가 verifier에 도착해야 한다.
kernel이 CO-RE source code를 이해하는 게 아니다.
libbpf가 load 전에 bytecode를 target kernel에 맞게 준비하고, kernel verifier는 그렇게 준비된 BPF bytecode를 검증한다.
이 patch가 정확히 어느 시점에, 무엇과 무엇을 비교해서 일어나는지 그림으로 보면 더 분명하다.
이 이미지는 CO-RE가 source code를 target machine에서 다시 compile하는 방식이 아니라, compiled bytecode 안의 field offset을 load 시점에 patch하는 방식임을 보여준다.
libbpf는 object 안의 build 시점 BTF·relocation record와, target machine에 이미 존재하는 target kernel BTF를 나란히 놓고 비교해 두 정보가 다르면 그 차이만큼 instruction을 고쳐 쓴다.
여기서 target kernel BTF는 object로부터 만들어지는 값이 아니라 target 커널에 원래부터 있던 정보라는 점에 주의한다.
libbpf가 하는 일은 “새로 만들기”가 아니라 이미 존재하는 두 정보를 “비교해서 patch”하는 것이다.
이 patch가 실제로 어떻게 기록되는지는 bpftool -d prog load hello.bpf.o /sys/fs/bpf/hello로 -d(debug) flag를 켜면 볼 수 있다. 책이 실제로 보여주는 출력은 다음과 같다.
libbpf: CO-RE relocating [24] struct user_pt_regs: found target candidate [205]
struct user_pt_regs in [vmlinux]
libbpf: prog 'hello': relo #0: <byte_off> [24] struct user_pt_regs.regs[0]
(0:0:0 @ offset 0)
libbpf: prog 'hello': relo #0: matching candidate #0 <byte_off> [205] struct
user_pt_regs.regs[0] (0:0:0 @ offset 0)
libbpf: prog 'hello': relo #0: patched insn #1 (LDX/ST/STX) off 0 -> 0
hello program의 BTF type ID 24(struct user_pt_regs)를 target kernel의 type ID 205와 매칭해 regs[0] 필드의 offset을 비교한다. 이 예제는 build와 load를 같은 머신에서 해 두 offset이 우연히 같아(0 → 0) patch가 사실상 no-op으로 끝났다 — 머신이 달랐다면 off 0 -> 108처럼 숫자가 바뀌었을 것이다. 이 비교·patch는 load 시점에 딱 한 번 일어난다: hook이 발동해 program이 실행될 때마다 다시 BTF를 비교하는 게 아니라, load 시점에 이미 patch된 bytecode가 그대로 실행된다.
SEC()와 map 정의는 BCC의 편의 문법을 대체한다
BCC의 map definition은 짧다.
BPF_HASH(config, u32, struct user_msg_t);libbpf style은 더 길지만, 이 definition은 ELF object의 .maps section에 그대로 들어가고 libbpf가 이 정보를 읽어 kernel map을 만든다.
struct {
    __uint(type, BPF_MAP_TYPE_HASH);
    __uint(max_entries, 10240);
    __type(key, u32);
    __type(value, struct user_msg_t);
} my_config SEC(".maps");
helper call도 마찬가지다.
BCC의 config.lookup(&uid)는 compile 전 rewrite를 거쳐 실제로는 helper call이 된다.
libbpf style에서는 그 helper call을 직접 쓴다.
p = bpf_map_lookup_elem(&my_config, &uid);SEC() 자체는 libbpf 소스 안에서 #define SEC(name) __attribute__((section(name), used))로 정의된 macro일 뿐이다.
symbol을 그 이름의 ELF section에 넣으라는 컴파일러 지시일 뿐, section name 문자열 자체에 어떤 의미도 부여하지 않는다.
그 의미(program type·attach 방식)를 읽어내는 건 컴파일 이후, object를 로드하는 libbpf다.
section name이 달라지면 libbpf가 해석하는 program type과 attach 방식이 달라진다.
SEC("kprobe/do_execve"), SEC("ksyscall/execve"), SEC("xdp")가 그 예다.
이 해석은 C compiler가 아니라 libbpf가 담당한다.
예전에는 section name 규칙이 더 느슨했다.
modern libbpf에서는 문서화된 section format을 따라야 한다.
새 program type을 쓸 때는 libbpf의 “Program Types and ELF Sections” 문서를 먼저 확인하는 편이 안전하다.
CO-RE memory access는 field access의 의도를 보존한다
tracing BPF program은 아무 pointer나 따라가 kernel memory를 읽을 수 없다.
보통 bpf_probe_read_kernel() 같은 helper를 통해 읽는다.
CO-RE에서는 이 memory access가 relocatable해야 하므로, libbpf는 bpf_core_read()와 BPF_CORE_READ() 계열 macro를 제공한다.
u64 inode = BPF_CORE_READ(task, mm, exe_file, f_inode, i_ino);이 macro의 정체는 __builtin_preserve_access_index()라는 Clang builtin이다.
이 builtin은 field access를 그 자리에서 memory read로 컴파일하지 않는다.
대신 "이 field access에 대해 CO-RE relocation entry를 만들라"고 Clang에게 지시만 남긴다.
그 표시 덕분에 나중에 libbpf가 target kernel BTF를 보고 field offset을 맞출 수 있다.
real-world program에서는 target kernel에 field·type·enum value가 없을 수도 있다.
그런 경우 bpf_core_field_exists(), bpf_core_type_exists(), bpf_core_enum_value_exists() 같은 check로 fallback path를 둬야 한다.
kernel 5.14에서 task_struct.state가 __state로 이름이 바뀐 것처럼 field 이름 자체가 버전마다 달라지는 경우, libbpf는 이름 뒤에 ___(underscore 3개)를 붙인 “flavor” struct를 여러 개 정의해 두는 기법도 제공한다.
CO-RE relocation은 ___ suffix를 무시하고 같은 이름으로 매칭을 시도한다.
그래서 target kernel에 실제로 존재하는 필드명을 가진 flavor 쪽이 자동으로 매칭된다.
다만 이 매칭이 항상 저절로 되는 것은 아니다.
코드는 여전히 existence check로 fallback path를 함께 둬야 한다.
relocation kind 13종 전체와 flavor 기법의 구체적인 코드 패턴은 이 글의 범위 밖이다.
skeleton은 object file을 user space API로 만든다
BPF skeleton은 .bpf.o에서 생성한 C header다.
bpftool gen skeleton hello-buffer-config.bpf.o > hello-buffer-config.skel.hskeleton은 BPF object 안의 program, map, global variable을 C structure와 lifecycle function으로 노출한다.
struct hello_buffer_config_bpf *skel;

skel = hello_buffer_config_bpf__open_and_load();
err = hello_buffer_config_bpf__attach(skel);
...
hello_buffer_config_bpf__destroy(skel);| phase | 의미 |
|---|---|
| open | ELF object를 읽고 program, map, global variable을 발견한다 |
| load | map을 만들고 relocation을 적용한 뒤 program을 kernel에 load하고 verifier를 통과시킨다 |
| attach | program을 hook에 연결해 event가 발생하면 실행되도록 한다 |
| destroy | link, program, map 등 resource를 정리한다 |
load와 attach는 다르다.
load는 kernel에 올리고 검증받는 단계고, attach는 program이 실제 event에 연결되는 단계다.
load만 했다고 program이 일을 시작하는 것은 아니다.
skeleton object는 user space representation이지만, load 후 그 값을 바꾸면 kernel-side에 반영되는지는 전역변수 종류에 따라 다르다.
.rodata(예: const volatile int 전역)는 load 시점에 kernel이 값을 동결(freeze)해 이후 변경이 안 된다. 반면 .data/.bss 전역은 mmap되는 global data map으로 올라가 load 이후에도 user space에서 값을 읽고 갱신할 수 있고, 그 값이 kernel 쪽 program 실행에도 그대로 반영된다.
이게 가능한 이유는 별도의 syscall 왕복이 아니라 mmap 자체의 성질에 있다 — mmap된 영역은 user space와 kernel이 같은 물리 메모리 페이지를 가리키므로, user space가 그 주소에 값을 쓰면 kernel이 다음에 그 map을 읽을 때 곧바로 새 값을 보게 된다.
CO-RE가 해결하지 않는 것
CO-RE는 강력하지만 만능이 아니다.
- target kernel에 BTF가 없으면 기본 CO-RE flow가 어렵다. 일부 distribution이나 오래된 kernel에서는 BTFHub 같은 외부 BTF archive를 검토해야 한다. 반대로 embed된 BTF 자체를 줄여야 하면
bpftool gen min_core_btf(BTFGen)로 실제 쓰는 relocation에 필요한 타입만 남길 수도 있다. - field나 type이 target kernel에 아예 없으면 offset을 맞출 수 없다. program은 existence check와 fallback logic을 가져야 한다.
- CPU architecture 차이는 별도 문제다.
BPF_KPROBE/BPF_KPROBE_SYSCALL이 의존하는pt_regslayout 자체가 아키텍처마다 다르다(예: ARM64엔 x86_64의di/si/dx필드가 없다) — CO-RE로도 이 차이는 못 흡수한다. “architecture별로 compile하고, kernel version 차이만 CO-RE로 흡수한다”는 모델이 더 정확하다. - verifier는 여전히 최종 관문이다. CO-RE relocation이 성공해도 verifier가 program을 unsafe하다고 판단하면 load는 실패한다.
책 시점 이후 달라진 점
BPF_KPROBE_SYSCALL은 libbpf 1.0부터BPF_KSYSCALL로 이름이 바뀌었다. 이 장의BPF_KPROBE_SYSCALL은 여전히 동작하지만 지금은BPF_KSYSCALL의 호환 alias일 뿐이라, 새 코드를 볼 때는BPF_KSYSCALL을 기준으로 생각하는 편이 낫다.- libbpf 1.0(2022-08-22) 이후
SEC()해석이 엄격해졌다. 이전에는 program type prefix만 맞으면 나머지 section 이름은 자유롭게 붙여도 인식됐지만, 1.0부터는 문서화된 정확한 section name만 인식된다(SEC("classifier")→SEC("tc")등 일부는 이름 자체도 바뀜). 이 장의SEC("ksyscall/execve")는 여전히 유효하다. - libbpf의 실제 최신 안정 릴리스는
v1.7.0(2026-03-16)이다(libbpf releases). 이 장의 CO-RE 기본 모델·vmlinux.h·skeleton 개념은 이 버전에서도 유지된다. CONFIG_DEBUG_INFO_BTF의 pahole 버전 요구가 계속 올라갔다. kernel 5.4 도입 시점엔 pahole v1.16이면 충분했지만, 최근 mainline(6.9+)은 v1.22 이상을 강제한다.- 이 목록은 핵심만 추린 것이다. CO-RE relocation kind 확장, BTF kind 추가, 배포판별 BTF 기본 활성화 현황 등 더 세부적인 최신성 조사는 이 글에서 다루지 않는다.
5주차에서 남길 모델
CO-RE는 “컴파일을 안 한다”가 아니라 “field offset이 확정되는 시점을 compile time에서 load time으로 옮긴다”는 것이다.
이 하나만 잡으면 이 장의 대부분이 정리된다.
- BCC가 target host에서 다시 compile해 이식성을 해결하는 이유와, 그게 production 배포에서 왜 부담이 되는가
- BTF가 “kernel type schema”로서 field access·map introspection·spin lock 위치 확인에 모두 쓰이는 이유
vmlinux.h가 kernel header를 완전히 대체하지 않고 build-time snapshot일 뿐인 이유- libbpf가 load phase에서 target kernel BTF를 보고 정확히 무엇을 patch하는가
SEC()section name이 C 문법이 아니라 libbpf가 해석하는 약속인 이유- CO-RE가 해결하는 것(field offset 차이)과 해결하지 않는 것(field 자체의 부재, BTF 부재, architecture 차이)의 경계
용어
- CO-RE(Compile Once, Run Everywhere): object에 남긴 type 정보를 target kernel BTF와 비교해 load 시점에 field offset을 보정하는 eBPF portability 방식.
- BTF(BPF Type Format): C type과 구조를 compact하게 표현하는 kernel metadata format. CO-RE relocation, map introspection, pretty-print, verifier log의 근거 자료로 쓰인다.
vmlinux.h: running kernel의 BTF에서 생성한 build-time C header. kernel header를 대체하지만 매 kernel마다 영구히 유효한 것은 아니다.- CO-RE relocation: compile 시점의 field/type access 정보를 담아, load 시점에 target kernel 기준으로 instruction을 patch하기 위한 record.
- libbpf: ELF object를 읽어 map을 만들고, CO-RE relocation을 적용하고, program을 kernel에 load·attach하는 user space C library.
- BPF skeleton:
.bpf.o에서 생성한 C header로, BPF program·map의 open/load/attach/destroy lifecycle을 감싼 편의 API. SEC(): eBPF program을 ELF section에 배치하는 macro. section name을 program type·attach point로 해석하는 것은 compiler가 아니라 libbpf다.
참고 자료
시리즈 원전 — 이 글이 따라간 챕터와 예제 코드
- Liz Rice,
Learning eBPF, Chapter 5 “CO-RE, BTF, and Libbpf” — 이 글의 CO-RE/BTF/libbpf 설명과hello-buffer-config예제의 원전 - Learning eBPF Chapter 5 예제 코드: https://github.com/lizrice/learning-ebpf/tree/main/chapter5
공식 정의·매뉴얼 — BTF·CO-RE·libbpf ABI 자체를 1차 자료로 확인할 때
- Linux kernel docs: BPF Type Format: https://docs.kernel.org/bpf/btf.html
- Linux kernel docs: libbpf Overview: https://docs.kernel.org/bpf/libbpf/libbpf_overview.html
- Linux kernel docs: BPF LLVM Relocations: https://www.kernel.org/doc/html/latest/bpf/llvm_reloc.html
- libbpf Program Types and ELF Sections: https://libbpf.readthedocs.io/en/latest/program_types.html
커널 내부 동작·실전 가이드 — 이 글이 다룬 개념을 더 파고들 때
- Andrii Nakryiko, Enhancing the Linux kernel with BTF type information: https://facebookmicrosites.github.io/bpf/blog/2018/11/14/btf-enhancement.html — BTF를 만든 저자 본인이 쓴 원조 소개 글. C 구조체가 BTF type graph로 어떻게 인코딩되고 중복 제거(dedup)되는지 실제 다이어그램으로 보여준다 — 이 글이 다루는 CO-RE relocation과는 다른 각도(type graph 구조)지만, 공식 자료 중 BTF를 시각적으로 설명하는 몇 안 되는 자료다.
- Andrii Nakryiko, BPF CO-RE: https://nakryiko.com/posts/bpf-portability-and-co-re/ — BCC runtime compile의 한계와 CO-RE가 BTF/Clang/libbpf를 조합하는 이유
- Andrii Nakryiko, BPF CO-RE reference guide: https://nakryiko.com/posts/bpf-core-reference-guide/ —
BPF_CORE_READ, existence check, flavor 기법의 실전 API - BCC to libbpf conversion guide: https://nakryiko.com/posts/bcc-to-libbpf-howto-guide/ — BCC 코드가 libbpf/CO-RE 코드로 바뀔 때 무엇이 달라지는지
비교·설계 맥락 — 책 예제 이후 생태계가 어떻게 바뀌었는지 볼 때
- libbpf releases: https://github.com/libbpf/libbpf/releases —
SEC()strict mode, 최신 버전 확인 - BTFHub: https://github.com/aquasecurity/btfhub — target kernel에 native BTF가 없을 때의 우회 경로
배경 지식 — 이 장의 개념이 왜 이렇게 설계됐는지 더 넓게 볼 때
- eBPF.io: BPF CO-RE: https://docs.ebpf.io/concepts/core/
- libbpf-bootstrap: https://github.com/libbpf/libbpf-bootstrap — skeleton, CO-RE, ring buffer 예제를 실제 project 구조로 볼 때
안녕하세요. 이번에 실습이 참 많네요.
개인적으로 아래와 같은 시나리오에서는 이번 스터디를 학습하시고 어떻게 대응하실지 궁금해서 질문드립니다.
전제는 Kubernetes에서 eBPF 기반 도구(CNI, 관측, 런타임 보안)의 노드 에이전트는 대개 DaemonSet으로 각 노드에 배포됩니다.
그리고 상황은 클러스터의 노드 이미지가 균질하지 않습니다. 노드그룹마다 배포판이 다르고, AMI 롤링 업데이트 중에는 구·신 커널이 공존합니다. 물론 onprem인 상황이어도 괜찮습니다. 이 상황에서 단일 컨테이너 이미지로 모든 노드를 커버하려면 어떻게 테스트를 진행하실지, 배포를 진행하실지 궁금합니다.