커널에 eBPF 프로그램을 올리면 bpf() syscall이 곧바로 실행을 시작하지 않는다. 그 전에 verifier가 프로그램 전체를 검사해서 안전하지 않을 수 있는 모든 경우를 걸러낸다. 그런데 이상한 점이 있다. 커널은 이 프로그램을 아직 한 번도 돌려본 적이 없다. 실행도 안 해본 코드가 나중에 어떤 입력을 받아도 커널 메모리를 벗어나 읽거나 쓰지 않을 거라는 걸, verifier는 대체 어떻게 미리 아는가?
이 글의 답은 한 문장으로 요약된다. verifier는 프로그램을 실행하는 대신, 각 레지스터가 "가질 수 있는 값의 범위"를 명령어를 따라가며 추적하고, 그 범위만으로 "이 메모리 접근은 항상 버퍼 안에 있다"는 산수를 증명한다.
- 전제 지식: eBPF 프로그램이
bpf()syscall로 커널에 load된다는 것, 레지스터와 조건 분기 정도의 기본 어셈블리 개념만 알면 된다. CO-RE·BTF·libbpf 파이프라인은 몰라도 된다(5주차에서 다뤘다). - 깊이 상한: 이 글은
bpf_reg_state가 레지스터 값의 범위를 어떻게 표현하는지,data + X > data_end같은 비교문이 어떻게 "이후 접근이 안전하다"는 근거로 바뀌는지, 그 근거가 실제 메모리 접근 검사에서 어떻게 쓰이는지를 주 계층으로 다룬다. state pruning이 이 범위 정보를 어떻게 비교하는지는 한 층 아래(얕게)로만 다룬다. tnum 비트 연산의 구현 세부사항, verifier 전체 상태공간 탐색의 형식적 증명, JIT 단계에서 이 정보가 실제 CPU 명령으로 바뀌는 과정은 범위 밖이다. - 근거: 이 글은 Learning eBPF(Liz Rice, O'Reilly, 2023) 6장(원서 p.109-124)을 기반으로, 책이 다루지 않는 지점(레지스터 상태의 정확한 필드 구성, bounds check의 커널 소스 메커니즘, 실제로 이 메커니즘이 뚫렸던 사례)을 커널 v6.9 소스와 커밋·selftest로 보강했다. 근거 전체는
SOURCES.md에 있다.
2~4절은 이 증명에 쓰이는 재료(레지스터 상태, 값의 범위)를 준비하는 과정이다. 실제 증명 장면은 if (data + 8 > data_end) 한 줄을 다루는 5절에서 나온다.
1. verifier는 프로그램을 실행하는 대신, 가능한 값의 집합을 들고 명령어를 하나씩 따라간다
이 그림은 eBPF 프로그램 하나가 작성부터 실행까지 거치는 전체 흐름에서 verifier가 정확히 어느 단계에 있는지 보여준다.
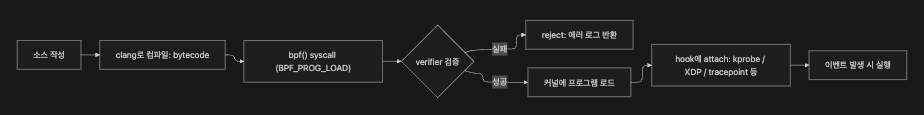
verifier는 컴파일이 끝난 뒤, 그리고 커널에 실제로 로드되기 전, 이 파이프라인의 딱 한 지점에서만 개입한다. 이 검사를 통과하지 못하면 그 뒤 단계(로드·attach·실행)는 아예 일어나지 않는다. 이 글은 이 그림의 verifier 검증 상자 안에서 실제로 무슨 일이 벌어지는지를 다룬다.
"실행 안 해본 코드가 안전한지 어떻게 아는가"라는 질문에 대한 커널 소스의 답은 소스 코드 최상단 주석에 그대로 적혀 있다.
/* kernel/bpf/verifier.c, v6.9, 48~50행 */
/* bpf_check() is a static code analyzer that walks eBPF program
 * instruction by instruction and updates register/stack state.
 * All paths of conditional branches are analyzed until 'bpf_exit' insn.
 */
verifier는 프로그램을 실행하지 않는다. 대신 "레지스터 6번은 [10, 20] 범위의 값을 가질 수 있다"처럼 각 레지스터에 대한 지식을 손에 들고, 명령어를 하나씩 따라가며 그 지식을 갱신한다. 분기(branch)를 만나면 지금까지의 레지스터 상태 전체를 스택에 복사해두고 한쪽 경로를 먼저 탐색한 뒤, 나중에 스택에서 다른 쪽 경로를 꺼내 이어서 탐색한다. 이 과정은 실행이 아니라 "가능한 값들의 집합"을 대상으로 한 정적 분석이다.
다음 그림은 앞의 그림 속 verifier 검증 상자 안에서, 분기가 있는 프로그램을 verifier가 실제로 어떤 순서로 걸어가는지 보여준다.
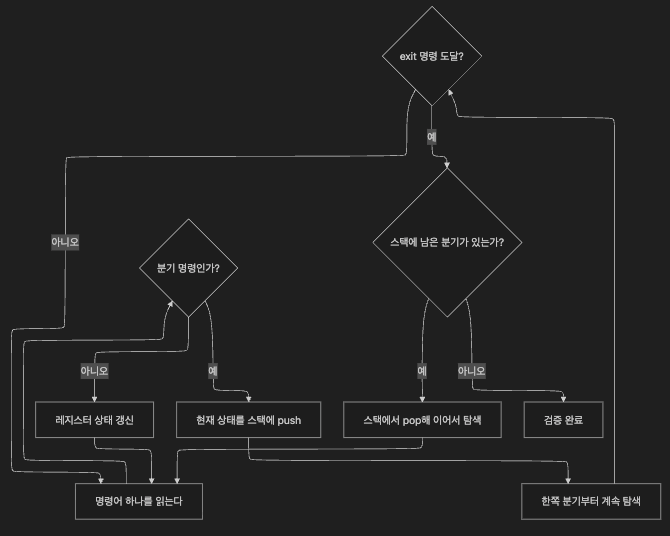
이 그림은 verifier가 분기마다 상태를 스택에 쌓아가며 "모든 경로를 끝까지 걸어본다"는 흐름을 보여준다. 화살표는 검사 순서이지, 프로그램이 실제로 실행되는 순서가 아니다. verifier는 각 분기의 결과를 값 하나로 확인하는 게 아니라 "이 경로로 갈 수 있는 모든 값의 범위"를 갖고 판단한다. 두 레지스터의 범위가 아예 겹치지 않으면(예: 한쪽은 항상 5보다 크고 다른 쪽은 항상 5보다 작음) verifier는 그 비교 결과를 실행 없이 확정하고, 도달 불가능한 쪽 분기는 아예 걷지 않는다(dead-branch elimination).
이 정적 분석은 명령어 최대 100만 개까지만 처리한다(책 원문 p.120). 예전에는 이 한도가 4096개였고, 지금도 비특권 사용자에게는 이 낮은 한도가 그대로 적용된다(책 원문 p.110 각주). 분기가 많은 프로그램은 같은 명령어를 여러 경로에서 반복해서 처리하므로, 이 한도는 "프로그램 길이"가 아니라 "verifier가 처리한 연인원"에 가깝다.
2. verifier 로그 읽는 법: 레지스터 상태 주석 해독하기
bpftool prog load나 libbpf_set_print()로 검증 실패(또는 성공) 로그를 켜면, verifier가 각 명령어를 처리한 뒤의 레지스터 상태를 이런 식으로 남긴다. 아래 로그는 책 예제(원서 p.111-113)에서 핵심 줄만 옮긴 것이다.
0: (bf) r6 = r1
1: (18) r1 = 0xffff800008178000
3: (61) r2 = *(u32 *)(r1 +0)
 R1_w=map_value(id=0,off=0,ks=4,vs=16,imm=0) R6_w=ctx(id=0,off=0,imm=0)
R10=fp0R1_w=map_value(id=0,off=0,ks=4,vs=16,imm=0)은 레지스터 1이 맵 값을 가리키는 포인터이고, key size 4바이트·value size 16바이트인 맵을 가리킨다는 표기다. R6_w=ctx(...)는 레지스터 6이 컨텍스트(BPF 프로그램 인자)를 가리킨다. R10=fp0은 레지스터 10이 스택 프레임 포인터로 고정돼 있음을 나타낸다(오프셋 0). 이 글의 해석에는 _w 표시 자체는 중요하지 않다. R1=map_value, R6=ctx, R10=fp0처럼 레지스터의 타입과 범위 정보만 읽으면 된다.
컨텍스트가 하필 R6에 복사되는 것도 우연이 아니다(책 원문 p.112-113). eBPF 프로그램이 helper 함수를 호출하면 그 인자는 R1~R5에 담긴다. 즉 helper를 부르는 순간 R1~R5의 값은 언제든 덮어써질 수 있다. 반면 R6~R9는 helper 호출로 값이 바뀌지 않는 "보존" 레지스터다. 맨 처음 R1에 들어온 컨텍스트를 R6으로 옮겨두면, 그 뒤 몇 번을 helper를 호출하든 컨텍스트를 잃지 않고 계속 참조할 수 있다.
스칼라 레지스터는 좀 더 복잡한 주석이 붙는다.
R2_w=inv(id=1,umax_value=4294967295,var_off=(0x0; 0xffffffff))
R3_w=inv(id=0,umin_value=1,umax_value=4294967296,var_off=(0x0; 0x1ffffffff))inv는 타입이 확정된 포인터가 아니라 스칼라(scalar) 값이라는 표시다. 레지스터 자체는 64비트(8바이트)이지만, umax_value=4294967295(0xFFFFFFFF, 32비트 전체 범위)로 잡힌 건 이 값이 바로 앞 명령어에서 r2 = *(u32 *)(...)처럼 32비트 단위로 읽혔기 때문이다. 상위 32비트가 0이라는 걸 verifier가 이미 알고 있어서, 레지스터 자체의 폭(64비트)과 무관하게 이 시점의 알려진 범위가 32비트 최댓값으로 좁혀진 것이다. var_off=(0x0; 0xffffffff)는 확정 비트는 0(value), 하위 32비트는 전부 불확실(mask)이라는 표기다. 이 umax_value/umin_value/var_off 세 필드가 이 글의 핵심 소재다. 다음 절에서 정확히 무엇을 추적하는 필드인지 뜯어본다.
3. umin_value/umax_value/var_off는 실제로 무엇을 추적하는가
레지스터 하나에 값이 정확히 하나 들어있다고 생각하면 이 필드들이 왜 이렇게 많은지 이해하기 어렵다. 실제로는 레지스터 하나에 서로 다른 방식으로 근사한 정보 여러 개가 동시에 붙어 있다.
/* include/linux/bpf_verifier.h, v6.9, 73~211행 (일부 발췌) */
struct bpf_reg_state {
	enum bpf_reg_type type;
	s32 off;
	union { int range; /* PTR_TO_PACKET일 때만 유효 */ ... };
	struct tnum var_off;
	s64 smin_value; s64 smax_value;   /* 부호 있는 64비트 범위 */
	u64 umin_value; u64 umax_value;   /* 부호 없는 64비트 범위 */
	s32 s32_min_value; s32 s32_max_value; /* 부호 있는 32비트 범위 */
	u32 u32_min_value; u32 u32_max_value; /* 부호 없는 32비트 범위 */
	u32 id; u32 ref_obj_id;
};
이 네 필드를 한 문장으로 묶으면, verifier는 한 레지스터의 값을 네 가지 다른 방식으로 동시에 근사한다.
| 렌즈 | 필드 | 예: 값 8을 담은 레지스터 |
|---|---|---|
| 부호 없는 64비트 구간 | umin_value~umax_value | [0, 8] |
| 부호 있는 64비트 구간 | smin_value~smax_value | [0, 8] |
| 32비트 서브레지스터 | u32_min_value~u32_max_value | [0, 8] |
| tnum(비트마스크) | var_off = {value, mask} | value=0b1000, mask=0b0000 |
왜 하나로 안 되고 넷이나 필요할까? 부호 없는 구간과 부호 있는 구간은 "0을 어디서 자르느냐"가 다르기 때문에 서로 자동으로 변환되지 않는다. 예를 들어 -1은 부호 있는 구간에서는 "0보다 1 작은 값"이지만, 부호 없는 64비트로 재해석하면 0xFFFFFFFFFFFFFFFF라는 거대한 양수다. 이런 값(부호 경계를 넘나드는 값)은 한쪽 구간만으로는 정확히 표현할 수 없다.
var_off는 또 다른 근사다. 이건 구간이 아니라 tnum(tracked number)이라는 비트마스크 구조다.
/* include/linux/tnum.h, v6.9 */
struct tnum { u64 value; u64 mask; };value와 mask로 "이 비트는 확정 0/1이고, 저 비트는 모른다"를 표현한다. 그런데 tnum은 구간을 정확히 표현하지 못한다. 예를 들어 [0, 2]라는 딱 떨어지는 구간을 비트마스크로 감싸면, 커널 주석이 직접 밝히듯 {0, 1, 2, 3}까지 포함하는 더 넓은 집합이 돼버린다(2진수로 0, 1, 10을 감싸는 최소 마스크가 3까지 포함하기 때문이다). tnum은 구간의 대체재가 아니라, min/max 구간과 별도로 "어떤 비트가 확정됐는가"를 추적하는 또 하나의 렌즈다.
이 네 개(부호없는/부호있는/32비트 두 쌍)와 tnum이 서로 완전히 독립적으로 노는 건 아니다. 값이 부호 경계를 넘나들지 않는 경우에는 서로의 정보를 이용해 더 좁혀질 수 있다.
/* kernel/bpf/verifier.c, __reg64_deduce_bounds() 주석, v6.9, 2052행 부근 */
/* Currently reg_state can't represent two segments per numeric domain,
 * so in such situations we can only derive maximal possible range
 * ([0, U64_MAX] for u64, and [S64_MIN, S64_MAX] for s64).
 */
커널 공식 문서도 이 관계를 같은 방식으로 설명한다. "값이 먼저 < 8로 테스트되고 그다음 s> 4로 테스트되면, verifier는 그 값이 > 4이고 s< 8이라는 것도 결론 내릴 수 있다. 부호 경계를 넘지 않기 때문이다." 반대로 이 조건이 깨지면(부호 경계를 넘나드는 값이면) 한쪽 구간을 다른 쪽으로 좁힐 수 없고, verifier는 안전한 쪽으로(더 넓은 범위로) 되돌아간다.
4. ALU 연산과 조건 분기가 이 범위들을 어떻게 좁히는가
레지스터에 값을 더하거나 조건 분기를 지나면 이 범위들이 갱신된다. 규칙은 직관적인 "구간 산술"과 거의 같다. [a,b] + [c,d]의 결과는 [a+c, b+d]다.
/* kernel/bpf/verifier.c, scalar_min_max_add(), v6.9, 13169행 부근 */
if (signed_add_overflows(dst_reg->smin_value, smin_val) ||
    signed_add_overflows(dst_reg->smax_value, smax_val)) {
	dst_reg->smin_value = S64_MIN;
	dst_reg->smax_value = S64_MAX;
} else {
	dst_reg->smin_value += smin_val;
	dst_reg->smax_value += smax_val;
}
이 덧셈이 오버플로우할 가능성이 있으면 얘기가 달라진다. verifier는 결과를 좁게 말하는 대신 전체 범위로 리셋해버린다. "연산을 하면 정보가 더 정확해질 것"이라는 직관과 반대다. 부정확한 좁은 범위를 유지하는 것보다, 안전한 쪽으로 크게 벌려서 "모른다"고 인정하는 쪽을 택한다.
조건 분기는 반대로 범위를 좁히는 쪽으로 작동한다. if (idx < len) 같은 스칼라 비교를 만나면, verifier는 참/거짓 두 개의 "평행 세계"를 만들어 각 세계에 다른 범위를 부여한다.
/* kernel/bpf/verifier.c, regs_refine_cond_op()의 BPF_JLT case, v6.9, 14561행 부근 */
case BPF_JLT:
	reg1->umax_value = min(reg1->umax_value, reg2->umax_value - 1);
	reg2->umin_value = max(reg1->umin_value + 1, reg2->umin_value);
	break;
idx < len이 참인 분기에서는 idx의 최댓값이 len - 1로, len의 최솟값이 idx + 1로 좁혀진다. 거짓 분기는 부등호가 뒤집힌 채로 같은 방식이 적용된다.
중요한 건 이 좁히기가 opcode별로 명시적으로 코딩된 case문이라는 점이다. "조건분기를 지나면 범위가 자동으로 정확해진다"는 건 틀린 그림이다. 이 좁히기는 양쪽 레지스터가 둘 다 SCALAR_VALUE(스칼라 값)일 때, 그리고 그 비교가 regs_refine_cond_op()가 인식하는 opcode(BPF_JLT 등 부등호 비교)일 때만 일어난다.
두 번 연속으로 좁히는 분기(s>= 1 다음 s<= 1)를 거치면 값이 정확히 하나의 상수로까지 확정될 수도 있다. 그 경우 verifier는 더 이상 "범위"가 아니라 "정확히 이 값"이라고 안다.
5. data + X > data_end 비교문이 "이후 접근은 안전하다"는 증명으로 바뀌는 과정
이제 이 글의 핵심 질문으로 들어간다. XDP나 소켓 필터 프로그램이 패킷을 읽기 전에는 반드시 이런 코드를 먼저 쓴다.
void *data = (void *)(long)ctx->data;
void *data_end = (void *)(long)ctx->data_end;
if (data + 8 > data_end)
    return XDP_DROP;
/* 여기서부터는 최소 8바이트를 안전하게 읽을 수 있다 */
이 비교에는 앞 절의 스칼라 비교 규칙(umin/umax를 좁히는 regs_refine_cond_op)이 적용되지 않는다. data와 data_end는 스칼라가 아니라 PTR_TO_PACKET 타입의 포인터이고, 포인터 비교는 스칼라 비교와 완전히 다른 함수가 처리한다.
/* kernel/bpf/verifier.c, check_cond_jmp_op() 발췌, v6.9, 15155행 부근 */
} else if (!try_match_pkt_pointers(insn, dst_reg, ®s[insn->src_reg],
this_branch, other_branch) &&
is_pointer_value(env, insn->dst_reg)) {
verbose(env, "R%d pointer comparison prohibited\n", ...);스칼라 대 스칼라 비교는 reg_set_min_max()가, 패킷 포인터 대 패킷 포인터 비교는 try_match_pkt_pointers()가 처리한다. 그리고 이 함수가 실제로 좁히는 건 umin_value/umax_value가 아니라, PTR_TO_PACKET 타입 레지스터에만 있는 별도 필드 range다.
패킷 포인터는 비교는 되지만 산술은 안 되는 경우가 있다. 예를 들어 data_end++;처럼 data_end 자체를 직접 증가시키면, verifier는 R3 pointer arithmetic on pkt_end prohibited로 거부한다(책 원문 p.117). data_end는 "패킷이 끝나는 지점"이라는 경계값 그 자체이기 때문에, 이 값을 임의로 옮기게 허용하면 지금까지 설명한 bounds check 전체가 의미를 잃는다.
/* kernel/bpf/verifier.c, find_good_pkt_pointers(), v6.9, 14215행 부근 */
if (dst_reg->umax_value > MAX_PACKET_OFF ||
    dst_reg->umax_value + dst_reg->off > MAX_PACKET_OFF)
	return; /* 오버플로우 위험이 있으면 range를 아예 안 준다 */

bpf_for_each_reg_in_vstate(vstate, state, reg, ({
	if (reg->type == type && reg->id == dst_reg->id)
		reg->range = max(reg->range, new_range);
}));
if (data + 8 > data_end) return;을 통과했을 때 정확히 어느 레지스터가 안전 범위를 얻는지는 다음 그림으로 정리된다. (※ 이 다이어그램은 아직 이미지로 변환되지 않았다. 발행 전 mmdc로 렌더링해 velog에 올리고 이 코드 블록을 이미지 링크로 바꿔야 한다.)
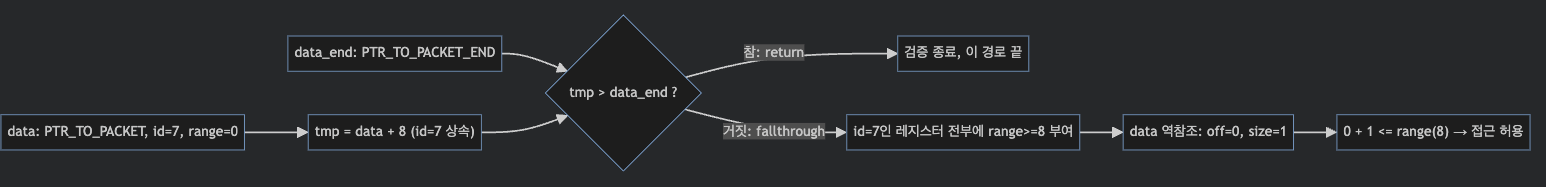
verifier는 data뿐 아니라 data와 같은 id를 가진 다른 레지스터(예: data를 복사한 원본 포인터)까지 한꺼번에 range=8을 부여한다. id는 "같은 베이스 포인터에서 파생됐다"는 표식이고, umax_value는 이 range를 계산하는 도중 오버플로우가 없었는지 확인하는 재료로만 쓰인다.
data ─────────────► [ 안전 접근 가능 range=8 ][ ??? ] data_end
      ▲ 이 경계(=range)가 여기서 확정된다 ▲
이렇게 확정된 range가 실제 메모리 접근 검사의 최종 게이트다.
/* kernel/bpf/verifier.c, check_packet_access() → __check_mem_access(), v6.9 */
if (reg->smin_value < 0) { verbose(env, "R%d min value is negative"); return -EACCES; }
err = reg->range < 0 ? -EINVAL
    : __check_mem_access(env, regno, off, size, reg->range, zero_size_allowed);
/* __check_mem_access() 내부 */
if (off >= 0 && size_ok && (u64)off + size <= mem_size)
	return 0;
여기까지 놓고 보면 "이 접근은 항상 버퍼 안"이라는 증명은 off + size <= mem_size라는 산수 하나로 끝난다. mem_size 자리에 들어가는 게 바로 range다. umin_value/umax_value/var_off는 이 최종 검사식에 직접 쓰이는 게 아니라, range를 안전하게 계산하는 데 필요한 재료(음수 인덱스 배제, 오버플로우 없음 증명)일 뿐이다. 이 글의 소재를 "umin/umax/var_off가 packet bounds check를 담당한다"로 이해했다면, 정확히는 "umin/umax/var_off가 range라는 별도 필드를 안전하게 계산하도록 돕고, 그 range가 최종 검사를 담당한다"가 더 정확하다.
이 range는 한 번 붙으면 그 프로그램이 끝날 때까지 유효한 게 아니다. 실무 규칙만 남기면 간단하다. bpf_skb_store_bytes()처럼 패킷 크기나 내용을 바꿀 수 있는 helper를 호출한 뒤에는 이전 packet pointer의 bounds check를 계속 믿지 말고, 포인터를 다시 읽어 range를 새로 받아야 한다. 그러지 않고 이전 포인터를 그대로 역참조하면 R9 invalid mem access 'inv'로 거부되는 사례가 Cilium 프로젝트 문서에 보고돼 있다.
이 메커니즘의 실행 가능한 최소 예제가 커널 selftest에 있다. 아래는 원문 그대로가 아니라, 매크로 치환과 인라인 어셈블리 문법을 걷어내고 핵심 로직만 남긴 축약본이다.
/* tools/testing/selftests/bpf/progs/verifier_direct_packet_access.c, v6.9, 축약(원문은 인라인 asm) */
/* __description("direct packet access: test1") __success __retval(0) */
r2 = data;      // data 포인터 로드
r3 = data_end;  // data_end 포인터 로드
r0 = r2; r0 += 8;
if r0 > r3 goto l0;   // data + 8 > data_end ?
r0 = *(u8*)(r2 + 0);  // 통과했으면 안전, __success
l0: r0 = 0; exit;
6. verifier가 reject하는 것은 "위험함"인가 "증명 실패"인가
다음 selftest는 앞 절과 정반대 상황을 보여준다. 이것도 원문 인라인 asm을 걷어낸 축약본이다.
/* verifier_direct_packet_access.c, "test6", v6.9, 축약(원문은 인라인 asm) */
/* __description("direct packet access: test6 (pkt_end >= reg, bad access)") */
/* __failure __msg("invalid access to packet") */
r2 = data; r3 = data_end; r0 = r2; r0 += 8;
if r3 >= r0 goto l0;   // data_end >= data+8 이면 스킵
r0 = *(u8*)(r2 + 0);   // 이 분기: data_end < data+8 이 증명된 상태, 거부됨
이 코드에서 실제로 거부되는 분기는 "data_end가 data+8보다 작다"는 게 증명된 쪽이다. 직관적으로는 위험해 보이지만, 실제 런타임에서 이 분기를 타는 패킷이 정말 8바이트 미만인지는 알 수 없다. verifier가 이 분기에서 아는 건 오직 "data_end < data+8"뿐이고, "data_end가 data보다는 크다"는 보장조차 없다. 그래서 verifier는 "이 코드가 위험하다"가 아니라 "이 코드가 안전하다는 걸 증명할 range 정보가 없다"는 이유로 거부한다.
reject 메시지를 볼 때마다 "이 프로그램이 실제로 크래시를 낸다"고 해석하면 안 된다. 정확한 해석은 "verifier가 현재 갖고 있는 범위 정보로는 안전성을 증명하지 못했다"는 것이다. verifier가 프로그램을 실제로 실행해보지 않는다는 사실(1절)과 이 사실은 같은 이야기의 다른 면이다. 증명하지 못하면 안전할 수도 있는 코드까지 보수적으로 잘라낸다. 설계 목표는 false positive(안전한데 거부)는 있어도 false negative(위험한데 통과)는 없는 것이다. 다만 이건 어디까지나 설계 목표다. 10절에서 보듯 verifier 구현 자체에 버그가 있으면 이 목표가 실제로 깨진 사례도 있었다.
7. 같은 원리가 패킷 밖에서도 쓰인다
패킷 접근만 특별한 게 아니다. verifier가 보는 대상이 맵 값이나 스택으로 바뀌어도 기본 질문은 같다. "이 레지스터는 지금 어떤 타입이고, 어디까지 안전하다고 증명됐는가?"
배열/스택 인덱스도 같은 산수로 검사된다.
12바이트 배열 char message[12]가 있을 때, 유효 인덱스는 0~11이다.
그런데 조건을 if (c <= sizeof(message))로 쓰면 c == 12인 경우를 걸러내지 못한다(책 원문 p.116-117).
verifier는 이 실수를 3~4절의 범위 추적으로 그대로 잡아낸다. c의 umax_value가 12까지 열려 있는 상태에서 message[c]를 읽으면, invalid access to map value, value_size=16 off=16 size=1처럼 정확한 초과 크기를 로그에 남기고 거부한다.
비교 연산자를 <로 고쳐야(c < sizeof(message)) c의 umax_value가 11까지로 좁혀져 통과한다. 전역 배열은 .data 맵으로 구현되기 때문에, verifier 관점에서는 일반 C 배열도 "map value pointer"로 나타난다. 이 검사는 5절에서 본 패킷 range 검사와 사실상 같은 산수(off + size <= mem_size)를 맵 경계에 대해 적용한 것이다.
NULL일 수 있는 포인터도 같은 방식으로 좁혀진다.
bpf_map_lookup_elem()의 반환값은 맵에 해당 키가 없으면 0(NULL)일 수 있다.
이 반환값을 저장한 레지스터를 곧바로 역참조하면 invalid mem access 'map_value_or_null'로 거부된다.
if (p != 0) { ... }처럼 명시적으로 NULL 체크를 거친 뒤에만 통과한다.
이 체크도 3~6절에서 본 "조건 분기가 레지스터 상태를 좁힌다"는 같은 메커니즘의 응용이다. 포인터 타입이 map_value_or_null에서 map_value로 좁혀진다.
물론 모든 포인터가 이 체크를 거쳐야 하는 건 아니다. PTR_TO_CTX나 PTR_TO_STACK처럼 verifier가 이미 NULL이 아니라고 알고 있는 타입도 있다. NULL 체크가 필요한 건 _OR_NULL이 붙은, 아직 어느 쪽인지 증명되지 않은 타입뿐이다.
일부 helper 함수는 이 NULL 체크 부담을 아예 다른 방식으로 없앤다. bpf_probe_read_kernel(void *dst, u32 size, const void *unsafe_ptr)의 세 번째 인자 이름이 unsafe_ptr인 게 그 표시다. 이 helper는 "NULL만 아니면 안전하다"를 확인하는 게 아니라, 커널 안에서 흔히 쓰는 fault-safe 읽기(주소가 유효하지 않아도 커널이 죽지 않고 에러만 반환하는 방식)로 직접 메모리를 읽는다. NULL 포인터도 이 fault-safe 경로 안에서는 그냥 "읽기 실패"로 처리되는 여러 경우 중 하나일 뿐이다.
이 밖에도 verifier는 이 글의 주제(범위 추적)와는 결이 다른 검사를 몇 가지 더 한다. load 시점에 함께 확인되는 항목이라 표로만 남긴다(책 원문 p.114-122).
| 검사 | 실패 예 |
|---|---|
| helper 함수가 이 프로그램 타입에 맞는가 | v6.9 기준 XDP에서 bpf_get_current_pid_tgid() 호출 → unknown func(등록 안 됨, 미존재 아님). 이런 허용 목록은 커널 버전이 오르면서 넓어지기도 한다 |
helper 인자 타입이 bpf_func_proto 선언과 맞는가 | 맵 포인터 자리에 로컬 변수 포인터 전달 → R1 type=fp expected=map_ptr |
| GPL 전용 helper를 GPL 비호환 라이선스에서 쓰지 않는가 | gpl_only helper 호출 + 비호환 라이선스 → cannot call GPL-restricted function |
| 컨텍스트에서 허용된 필드만 읽는가 | tracepoint에서 미허가 필드 접근 → invalid bpf_context access |
| 반환값(R0)이 초기화됐는가 | 값 설정 없이 exit → R0 !read_ok(helper를 한 번이라도 호출하면 그 반환값으로 초기화된 것으로 처리됨) |
8. 실행 완결성 보장: 명령어 상한과 루프
1절에서 본 "모든 분기를 스택에 쌓아가며 끝까지 걷는다"는 탐색에는 함정이 하나 있다. 분기가 무한히 갈라지면 이 탐색 자체가 끝나지 않을 수 있다. verifier는 안전성뿐 아니라 이 분석 자체가 반드시 끝난다는 것도 보장해야 한다. 100만 개 명령어 상한이 1차 방어선이다. 이 값은 커널에 하드코딩돼 있고 설정으로 바꿀 수 없다.
루프는 이 완결성 보장과 직접 부딪히는 지점이다. 커널 5.3 이전에는 뒤로 가는 분기(backward jump) 자체가 금지돼, 개발자들은 #pragma unroll로 컴파일러가 루프를 반복 명령어로 풀어쓰게 해서 우회했다.
다음 그림은 verifier가 backward jump(루프) 하나를 만났을 때 accept와 reject를 가르는 판단 순서를 보여준다.
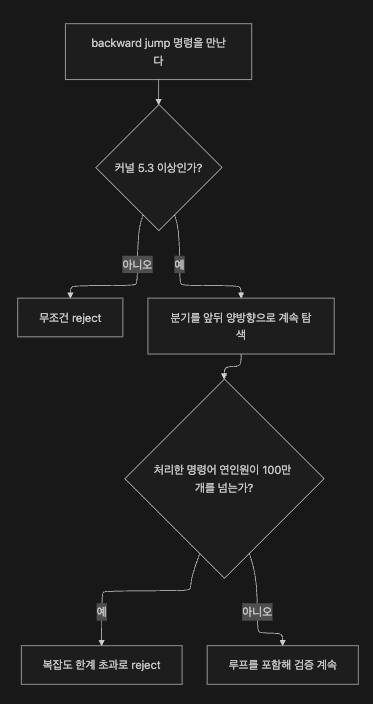
5.3부터는 verifier가 분기를 앞뒤 양방향으로 따라가며 실행 경로가 100만 개 상한 안에 머무는 한 일부 루프를 허용한다.
반복 횟수가 컴파일 시점에 고정된(예: for (int i=0; i<10; i++)) 루프는 이 조건을 만족하기 쉽다. 반대로 반복 횟수가 변수(예: 전역 변수 c)에 의존하는 루프는 verifier가 상한을 증명하지 못한다. 이런 루프는 위 그림의 복잡도 한계 초과 경로로 거부되는 경우가 흔하다.
5.17부터는 bpf_loop() 헬퍼가 추가돼 이 문제를 다른 방식으로 푼다(책 원문 p.121). 최대 반복 횟수를 인자로 받고, 매 반복마다 호출할 콜백 함수를 받는다. verifier는 이 콜백 함수의 bytecode를 "한 번만" 검증하면 되고, 그 콜백이 실제로 몇 번 불릴지는 런타임에 결정된다. 콜백이 0이 아닌 값을 반환하면 조기 종료도 가능하다. bpf_for_each_map_elem()도 같은 방식(콜백 1회 검증 + 런타임 반복)으로 동작한다.
9. state pruning은 언제 두 상태를 "같다"고 보는가
명령어 상한이 탐색에 "여기까지만"이라는 바깥 한계를 긋는다면, pruning은 그 한계 안에서 같은 일을 두 번 하지 않게 막는 두 번째 장치다. 같은 명령어를 여러 경로로 반복해서 방문하는 게 비효율적이므로, verifier는 이미 검증한 상태와 "같거나 더 안전한" 상태를 다시 만나면 그 경로를 더 이상 걷지 않는다(pruning). "같다"의 기준을 스칼라 레지스터 하나로 좁혀 보면 이렇다.
/* kernel/bpf/verifier.c, range_within(), v6.9, 16346행 부근, 32비트 쌍 검사는 생략한 축약본 */
static bool range_within(const struct bpf_reg_state *old,
			  const struct bpf_reg_state *cur)
{
	return old->umin_value <= cur->umin_value &&
	       old->umax_value >= cur->umax_value &&
	       old->smin_value <= cur->smin_value &&
	       old->smax_value >= cur->smax_value;
	       /* 실제 코드는 s32/u32 min/max 쌍도 같은 패턴으로 이어서 검사한다 */
}
/* regsafe()의 실제 판정, 발췌 */
return range_within(rold, rcur) &&
       tnum_in(rold->var_off, rcur->var_off) &&
       check_scalar_ids(rold->id, rcur->id, idmap);
"이전(old) 상태가 안전했다고 이미 검증했는데, 지금(cur) 상태의 범위가 old의 부분집합이면(더 좁으면) cur도 안전하다"가 핵심 논리다. 다만 조건이 하나 더 있다. range_within과 tnum_in을 모두 통과해도, 두 레지스터의 id로 추적되는 상관관계(예: "이 레지스터와 저 레지스터가 항상 같은 값을 가진다")까지 보존돼야 한다. range가 아무리 좁아 보여도 이 상관관계가 깨졌다면 실제로는 다른 상태이므로 pruning하면 안 된다.
Cilium을 개발하는 Isovalent의 엔지니어는 "Linux verifier에는 많은 휴리스틱이 있으며 특히 state pruning 쪽이 그렇다"고 언급하며, verifier 변경이 검증 가능 여부나 복잡도에 예측하기 어려운 영향을 줄 수 있어 대규모 실전 BPF 프로그램(Cilium 자체의 프로그램들)을 회귀 테스트의 실험대로 쓴다고 설명한다. pruning 로직은 "한 번 정해지면 고정되는 규칙"이 아니라, 커널 버전이 바뀔 때마다 조정되는 휴리스틱 집합에 가깝다.
10. 이 메커니즘이 실제로 뚫렸던 사례
범위 추적 로직도 결국 코드이고, 코드에는 버그가 생긴다. 2020년 CVE-2020-8835는 그 실제 사례다.
커밋 f2d67fec0b43, "bpf: Undo incorrect __reg_bound_offset32 handling" (2020-03-30)
"The verifier rewrote original instructions it recognized as dead code
with 'goto pc-1', but reality differs from verifier simulation in that
we're actually able to trigger a hang."
verifier가 32비트 range 계산 버그 때문에 특정 분기를 "절대 도달할 수 없는 죽은 코드"로 잘못 확정하고, 그 확정에 근거해 명령어를 goto pc-1(자기 자신으로 되돌아가는 무한루프 명령)로 재작성했다. 그런데 실제로는 그 분기가 도달 가능했고, 재작성된 코드가 실행되며 커널이 멈췄다. 1절에서 "verifier는 범위 비교만으로 분기를 죽은 코드로 확정하고 아예 걷지 않는다"고 설명했는데, 그 확정 로직 자체에 버그가 있으면 확정이 틀릴 수 있다는 걸 보여주는 사례다.
2021년 CVE-2021-3490은 다른 종류의 버그였다. AND/OR/XOR 같은 비트 연산에서, 양쪽 피연산자가 모두 상수로 알려진 특수한 경우에 32비트 범위를 제대로 갱신하지 않는 문제가 있었고, 이는 로컬 권한 상승으로 이어졌다. 4절에서 본 "구간 산술"이 비트 연산에서는 그만큼 더 다루기 까다롭다. 범위 추적은 한 번 완성되면 끝나는 문제가 아니라 계속 발견되는 종류의 버그 표면이다.
이런 사고를 구조적으로 줄이기 위한 연구도 있다. Rutgers 대학 연구팀은 2023년 Linux Plumbers Conference에서 Agni라는 도구를 소개했다. Agni는 verifier의 range analysis 로직을 SMT 논리로 자동 변환해 Z3로 검증하며, 레지스터의 실제 실행값이 verifier가 믿는 값과 달라질 수 있는(unsound) 경우를 자동으로 찾아내는 것을 목표로 한다. verifier의 증명 자체도 결국 사람이 짠 코드이므로, 그 코드가 정말로 옳은지를 별도로 검증하는 도구가 필요하다.
11. 정리: verifier 로그 한 줄을 처음부터 끝까지 읽어보기
이 글에서 다룬 걸 2절의 로그 한 줄에 그대로 대입해보면 이렇게 읽힌다.
R2_w=inv(id=1,umax_value=4294967295,var_off=(0x0; 0xffffffff))inv: 이 레지스터는 포인터가 아니라 스칼라 값이다(1절).umax_value=4294967295: 이 값이 가질 수 있는 부호 없는 상한이 32비트 전체 범위임을 나타낸다(3절). 아직 이 값을 특정 상수나 좁은 구간으로 좁힐 조건 분기를 지나지 않았기 때문이다(4절).var_off=(0x0; 0xffffffff): tnum 표현으로, 하위 32비트가 전부 "모른다"는 상태다(3절). umax_value와 별개의 근사이지만 서로 정보를 교환하며 정제된다.id=1: 이 레지스터가 다른 어떤 레지스터와 파생 관계에 있다는 표식이다. 이 로그의 R2는 스칼라(inv)이므로, 여기서 id는 9절에서 본 state pruning의 상관관계 추적(다른 스칼라 레지스터와 항상 같은 값을 가지는지)에 쓰인다. 만약 이 레지스터가 패킷 포인터(pkt)였다면 같은 id 필드가 5절에서 본 것처럼 range를 형제 레지스터에 전파하는 데 쓰였을 것이다. 스칼라의 id와 패킷 포인터의 id는 필드는 같지만 쓰이는 맥락이 다르다.
직접 확인: bpftool prog dump xlated name <prog_name> visual > out.dot && dot -Tpng out.dot > out.png로 검증 대상 프로그램의 제어 흐름 그래프를 뽑아보라. 분기가 있는 지점마다 1절의 스택-push가 실제로 새 노드로 갈라지는 걸 눈으로 확인할 수 있다.
veristat(libbpf 프로젝트에 포함된 도구)로 같은 프로그램을 여러 커널 버전에서 돌려보는 것도 해볼 만하다. verifier 구현이 바뀔 때마다 processed 61 insns 같은 로그의 처리 명령어 수가 달라지는 걸 볼 수 있다. 9절에서 언급한 "pruning은 고정된 규칙이 아니라 휴리스틱"이라는 말이 이렇게 로그 숫자로 드러난다.
다음 장으로 이어지는 질문: 이 글은 verifier가 프로그램 하나의 안전성을 어떻게 증명하는지에 집중했다. 하지만 eBPF 프로그램은 종류가 다양하다. kprobe, XDP, tracepoint, cgroup 프로그램마다 검증 규칙(허용된 helper, 접근 가능한 컨텍스트 필드)이 다르다는 걸 7절에서 잠깐 봤다. 이 프로그램 타입들은 정확히 어떻게 나뉘고, 각 타입은 어디에 attach되는가? 다음 장(7장, week07)에서 이어서 본다.
더 볼 자료:
- 공식 정의: 커널 verifier 문서: 레지스터 값 추적과 direct packet access를 이 글보다 더 formal한 언어로 다룬다.
- 형식검증: Agni 프로젝트, LPC 2023 발표: verifier range analysis의 soundness를 SMT로 검증하는 연구.
- 실무: Paul Chaignon(Isovalent), "Test Verifier Changes on Cilium's BPF Programs": verifier 변경이 실전 프로그램에 미치는 영향을 다룬다.
- 원본 텍스트: Learning eBPF 6장(원서 p.109-124,
11-ch6-the-ebpf-verifier-pp129-144.pdf): 이 글이 근거로 쓴 1차 자료.