같은 verifier인데 왜 프로그램 타입마다 다르게 검증할까: 커널 내부의 타입별 디스패치 구조
XDP 프로그램 안에서 bpf_get_current_pid_tgid()를 부르면 verifier는 로드 자체를 거부한다.
그런데 같은 helper를 kprobe 프로그램에 넣으면 아무 문제 없이 통과한다.
verifier는 똑같은 코드, 똑같은 레지스터 상태 추적 엔진(week06)을 쓰는데, 왜 프로그램 타입에 따라 이렇게 다르게 반응하는가?
이 글을 읽고 나면 다음을 설명할 수 있어야 한다.
- program type이 커널 내부에서 어떤 구조체로 표현되고, verifier가 이를 어디서 조회하는가
is_valid_access가 컨텍스트 접근을 검사할 때 실제로 무엇을 하는가- helper 허용 목록이 program type과 어떻게 연결되는가
- kfunc가 helper와 등록·조회 메커니즘에서 정확히 무엇이 다른가
- attach type이 언제·몇 단계로 검증되는가, 왜 항상 1:1이 아닌가
- 반환값(return code)의 의미를 누가 해석하는가. verifier인가, 다른 주체인가
2~5섹션은 verifier가 검증 루프 중 이 타입별 테이블과 그 바깥의 별도 경로들을 조회하는 지점(컨텍스트 접근, helper, kfunc)을 다룬다.
6섹션은 attach type 검증이 로드 시점과 attach 시점 두 곳으로 나뉘어 있다는 것을, 7섹션은 반환값의 의미를 정작 verifier가 아니라 다른 주체가 해석하는 경우가 있다는 것을 다룬다.
8섹션은 선택 축인 fentry/fexit(BPF trampoline)이 kprobe와 어떻게 다른 메커니즘인지 짚고, 9섹션에서 XDP 프로그램 하나를 로드부터 실행까지 따라가며 전체를 다시 정리한다.
1. program type은 커널 내부에서 무엇으로 표현되는가
이 그림은 프로그램 하나가 로드되는 순간부터 실행되는 순간까지, 이 글이 다루는 지점들이 전체 흐름의 어디에 있는지 보여준다.
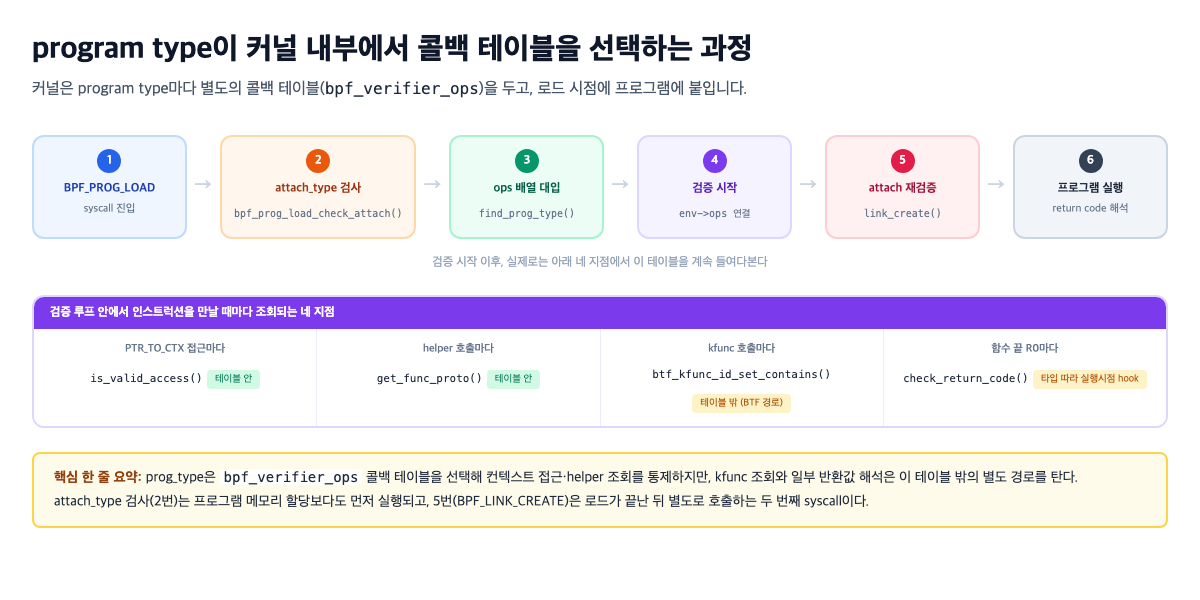
이 그림은 link 기반 attach 경로를 기준으로 그렸으며, 일부 cgroup류 프로그램이 쓰는 레거시 BPF_PROG_ATTACH 경로는 생략했다. 그림의 번호와 이 글의 섹션은 아래처럼 대응한다.
| 그림 요소 | 무엇을 하는가 | 대응 섹션(H2 제목) |
|---|---|---|
| 1번 | BPF_PROG_LOAD 진입(syscall 진입점, 특정 섹션 소유 아님. 이름은 "6. attach type은 언제·어떻게 검증되는가"에서 처음 등장) | 해당 없음 |
| 3번 | find_prog_type()로 ops 배열 대입 | 1. program type은 커널 내부에서 무엇으로 표현되는가 |
| 4번 | 검증 시작, env->ops 연결 | 2. verifier는 이 타입별 규칙을 어디서 조회하는가 |
검증 루프 네 지점 중 is_valid_access() | PTR_TO_CTX 접근마다 조회(테이블 안) | 3. is_valid_access는 무엇을 검사하는가 |
검증 루프 네 지점 중 get_func_proto() | helper 호출마다 조회(테이블 안) | 4. helper 허용 목록은 어디서 program type과 연결되는가 |
검증 루프 네 지점 중 btf_kfunc_id_set_contains() | kfunc 호출마다 조회(테이블 밖) | 5. kfunc는 helper와 무엇이 다른가 |
| 2번·5번 | attach_type 검사(로드 시점)·재검증(link_create()) | 6. attach type은 언제·어떻게 검증되는가 |
검증 루프 네 지점 중 check_return_code() | 함수 끝 R0마다 해석(테이블 밖) | 7. return code는 누가 해석하는가 |
| 6번 | 프로그램 실행 | 9. 정리: XDP 프로그램 하나를 로드부터 실행까지 따라가기 |
program type은 그냥 붙이는 라벨이 아니다. 아래 그림은 bpf_types.h의 매크로 나열 하나가 실제 콜백 테이블(bpf_verifier_ops)에 연결되기까지의 과정을 보여준다.
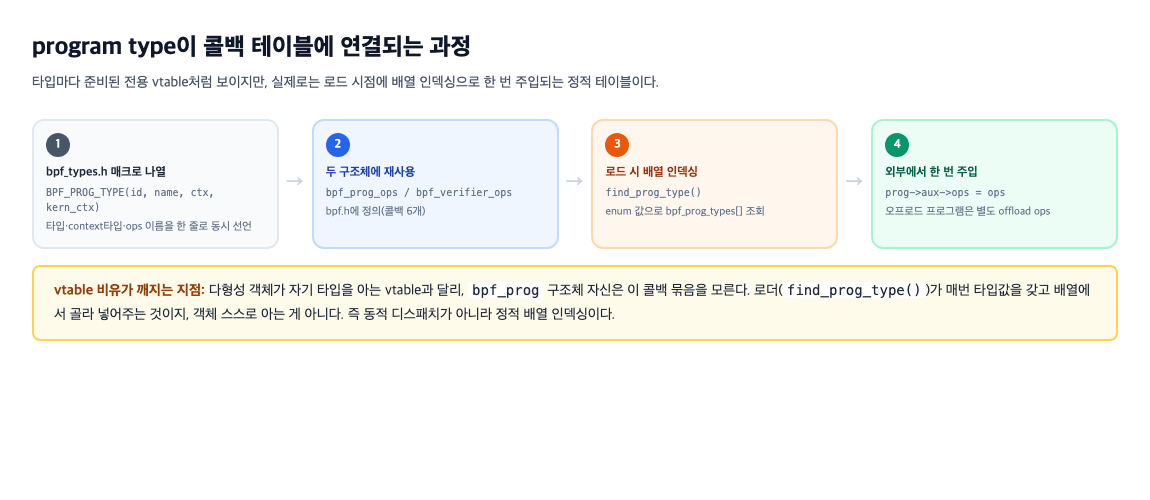
라벨이라면 이후 로딩 경로가 프로그램마다 똑같아야 하는데, 실제로는 타입값을 키로 완전히 다른 콜백 테이블이 선택된다. 다음 섹션부터는 이 테이블이 검증 루프의 어느 지점에서 조회되는지, 그리고 이 테이블 밖(kfunc, 일부 반환값 해석)에서는 어떻게 다르게 처리되는지를 차례로 본다.
2. verifier는 이 타입별 규칙을 어디서 조회하는가
kernel/bpf/verifier.c의 bpf_check()는 커널 전체 검증의 진입점이다. 이 함수가 시작되자마자 6주차의 범용 검증 엔진과 1섹션의 타입별 정책 테이블을 잇는 한 줄이 실행된다.
/* kernel/bpf/verifier.c, v6.9, 21221-21222행 */
env->prog = *prog;
env->ops = bpf_verifier_ops[env->prog->type];
소스 - kernel/bpf/verifier.c#L21221-L21222

env는 6주차에서 본 range tracking 같은 범용 검증 로직이 공유하는 하나의 전역 상태이고, ops는 그 안의 필드일 뿐이다.
다만 "가장 먼저 채워진다"가 "이 시점에 모든 정책이 확정된다"는 뜻은 아니다.
다음 섹션에서 보듯 attach_type에 따라 같은 prog_type 안에서도 동작이 갈리므로, env->ops는 필요조건일 뿐 충분조건이 아니다.
3. is_valid_access는 무엇을 검사하는가
범용 검증 엔진과 타입별 정책이 처음 실제로 만나는 지점은 check_mem_access()다. 이 함수는 메모리 접근 인스트럭션마다 레지스터가 가리키는 대상의 타입을 보고 분기하는데, 컨텍스트 포인터일 때만 check_ctx_access()를 거쳐 env->ops->is_valid_access()를 호출한다.
/* kernel/bpf/verifier.c, v6.9, check_ctx_access() 5567-5591행 */
if (env->ops->is_valid_access &&
    env->ops->is_valid_access(off, size, t, env->prog, &info)) {
    ...
}
verbose(env, "invalid bpf_context access off=%d size=%d\n", off, size);
return -EACCES;
소스 - kernel/bpf/verifier.c#L5567-L5591
6주차의 포인터 추적이 "이 레지스터가 지금 뭘 가리키고 있나"를 알아냈다면, 이 단계는 그 대상이 컨텍스트 포인터일 때만 "이 필드를 이렇게 읽어도 되나"를 타입별 콜백에게 물어보는 다음 단계다.
XDP 타입의 is_valid_access 구현(net/core/filter.c의 xdp_is_valid_access())을 보면 이 콜백이 단순한 허용/거부 게이트가 아니라는 게 드러난다. 아래 그림은 이 함수가 한 번에 처리하는 세 가지 검사를 보여준다.
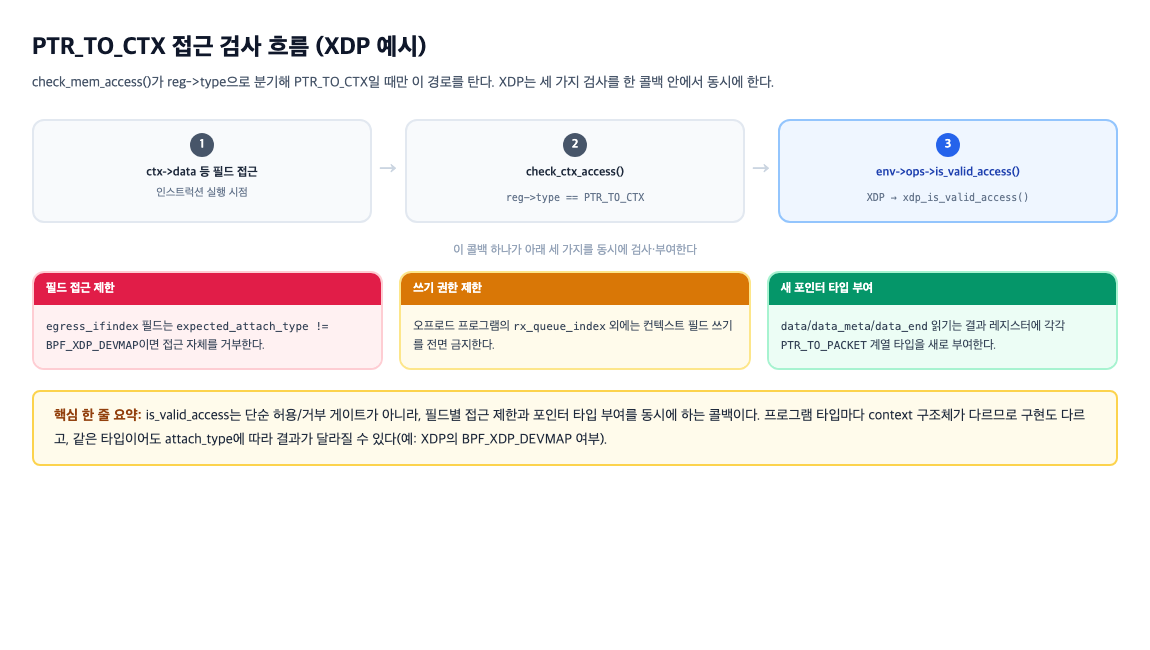
세 번째 카드가 packet 접근 검사의 시작점이다. data를 읽으면 그 결과가 그냥 정수가 아니라 "패킷 시작 주소"라는 특수 타입으로 verifier에 등록되고, 이후 6주차에서 다룬 packet range 검사(data_end와 비교해서 경계를 확인하는 그 패턴)가 여기서 시작된다.
/* net/core/filter.c, v6.9, xdp_is_valid_access() 8981-9016행 중 8986-9013행 발췌 */
if (prog->expected_attach_type != BPF_XDP_DEVMAP) {
    switch (off) {
    case offsetof(struct xdp_md, egress_ifindex):
        return false;
    }
}
...
switch (off) {
case offsetof(struct xdp_md, data):
    info->reg_type = PTR_TO_PACKET;
    break;
소스 - net/core/filter.c#L8981-L9016
is_valid_access가 프로그램 타입마다 다르게 구현된 이유는, 타입마다 컨텍스트 구조체 자체가 다르고 그 필드들이 가리키는 커널 내부 의미도 다르기 때문이다. 같은 XDP 타입인데도 expected_attach_type에 따라 결과가 달라지는 것도(그림 첫 번째 카드) 같은 이유다.
이 검사가 크기·정렬·범위까지 본다는 걸 실제 CI 테스트로 확인할 수 있다.
tools/testing/selftests/bpf/progs/verifier_ctx_sk_msg.c는 sk_msg_md.size 필드를 정상 크기(u32)로 읽으면 성공하고, size 필드를 잘못된 크기(u64)로 읽거나 구조체 끝을 넘겨 읽으면, 또는 family 필드를 정렬 안 된 오프셋(offsetof(...)+1)으로 읽으면 각각 정확히 "invalid bpf_context access" 에러가 뜬다는 걸 검증한다.
이 문자열은 위에서 본 check_ctx_access()의 에러 메시지와 그대로 일치한다.
직접 확인: tools/testing/selftests/bpf/progs/verifier_ctx_sk_msg.c의 성공 케이스와 세 가지 실패 케이스를 나란히 읽어보면, "무엇이 되고 무엇이 안 되는지"가 코드 대조만으로 명확해진다.
4. helper 허용 목록은 어디서 program type과 연결되는가
helper 함수 조회는 check_helper_call()에서 일어난다.
이 함수는 고정된 enum bpf_func_id를 env->ops->get_func_proto()에 넘겨 그 helper의 프로토타입을 얻는다(정확한 인자는 아래 코드 참고).
프로토타입이 없으면 즉시 로드 실패다.
/* kernel/bpf/verifier.c, v6.9, check_helper_call() 10201-10218행 */
if (env->ops->get_func_proto)
    fn = env->ops->get_func_proto(func_id, env->prog);
if (!fn) { ... return -EINVAL; }

if (!env->prog->gpl_compatible && fn->gpl_only) { ... }
if (fn->allowed && !fn->allowed(env->prog)) { ... }
소스 - kernel/bpf/verifier.c#L10201-L10218
helper 목록이 타입별로 완전히 독립돼 있다고 생각하기 쉽지만, 실제로는 전용 helper 몇 개만 처리하고 나머지는 공통 fallback(bpf_sk_base_func_proto 등)으로 위임하는 계층 구조다. 다음 섹션 그림의 "helper 조회" 열(STEP 3·4)이 이 구조를 그대로 보여준다.
커널 공식 문서(Documentation/bpf/verifier.rst)와 Cilium 공식 레퍼런스 문서 둘 다 같은 내용을 확인해준다. bpf_verifier_ops->get_func_proto()가 enum bpf_func_id를 그 프로그램 타입에서 쓸 수 있는 helper로 매핑한다는 것이다.
5. kfunc는 helper와 무엇이 다른가
kfunc를 "helper의 새 이름"으로 이해하면 이후 verifier 로그에서 낯선 등록·거부 패턴을 만났을 때 헷갈리게 된다. 실제로는 등록 자료구조, 조회 단위, 등록 시점이 모두 다른 별도 메커니즘이다.
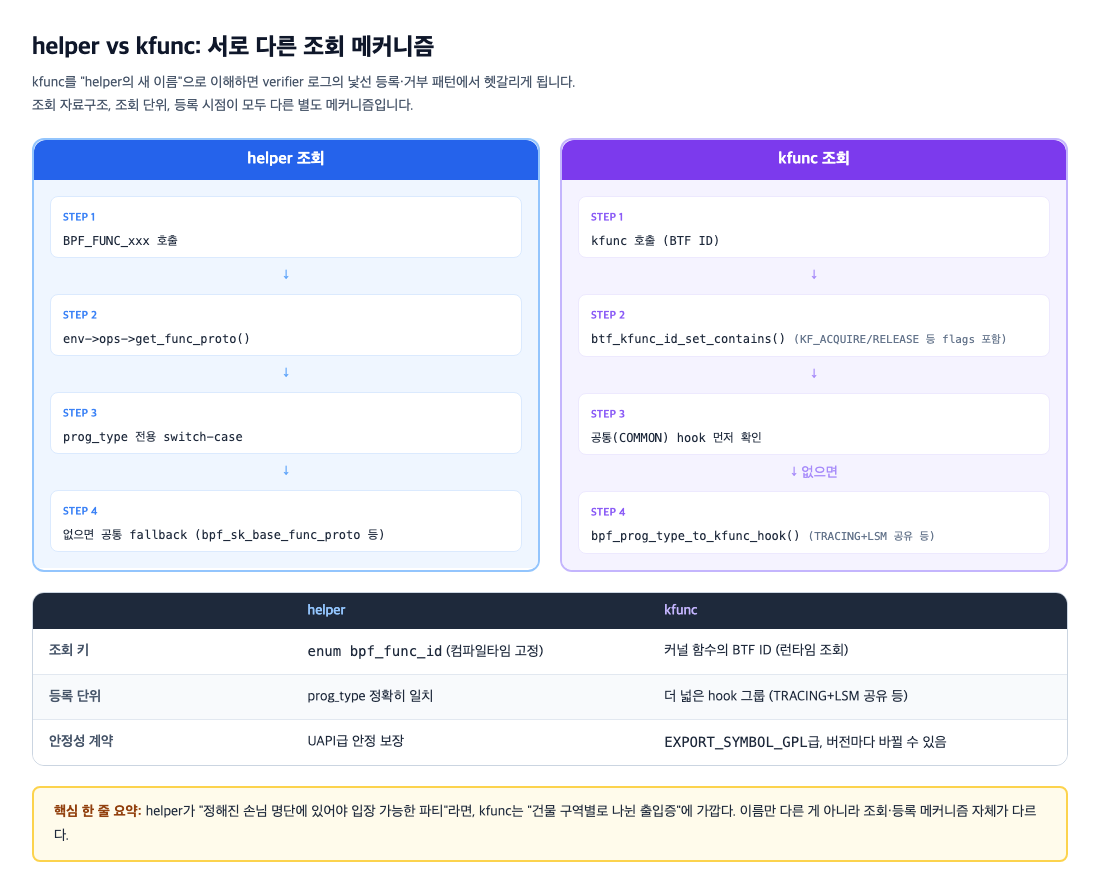
kfunc 쪽 STEP 2(btf_kfunc_id_set_contains())가 바깥쪽 함수이고, STEP 3·4(공통 hook 확인 → 없으면 bpf_prog_type_to_kfunc_hook())는 그 안에서 실행되는 하위 단계다. 등록 시점(register_btf_kfunc_id_set())에는 이 순서가 반대다.
helper는 컴파일타임에 고정된 enum bpf_func_id와 get_func_proto()(prog_type 정확히 일치)로 조회되는 반면, kfunc는 커널 함수의 BTF ID를 키로 btf_kfunc_id_set_contains()가 런타임에 조회한다.
등록 방식도 다르다. kfunc 등록은 prog_type을 그대로 쓰지 않고 bpf_prog_type_to_kfunc_hook()이 더 넓은 "hook" 그룹으로 묶는다. 예컨대 BPF_PROG_TYPE_TRACING과 BPF_PROG_TYPE_LSM은 둘 다 BTF_KFUNC_HOOK_TRACING이라는 같은 그룹을 공유한다.
/* kernel/bpf/btf.c, v6.9, bpf_prog_type_to_kfunc_hook() 8119-8121행 */
case BPF_PROG_TYPE_TRACING:
case BPF_PROG_TYPE_LSM:
    return BTF_KFUNC_HOOK_TRACING;
소스 - kernel/bpf/btf.c#L8119-L8121
helper가 "정해진 손님 명단(enum)에, 그것도 자기 방(prog_type) 명단에 있어야만" 입장 가능한 파티라면, kfunc는 "건물 구역(hook 그룹)별로 나뉜 출입증"에 가깝다. TRACING 프로그램과 LSM 프로그램은 서로 다른 prog_type이지만 같은 출입증을 쓰기 때문에, 한쪽에 등록된 kfunc 세트를 다른 쪽도 그대로 쓸 수 있는 경우가 생긴다.
kfunc는 단순히 "호출 가능/불가능"만 검사하지 않는다.
tools/testing/selftests/bpf/prog_tests/kfunc_call.c에는 "acquire kernel function does not return PTR_TO_BTF_ID"라는 에러를 검증하는 테스트가 있는데, 이는 kfunc가 acquire/release 같은 참조 카운팅 시맨틱을 KF_ACQUIRE 같은 BTF 플래그로 검증받는다는 걸 보여준다.
helper의 bpf_func_proto에는 이런 이름 기반 시맨틱이 없다.
커널 공식 문서(Documentation/bpf/kfuncs.rst)는 이 차이를 안정성 계약의 유무로 설명한다. kfunc는 일반 helper와 달리 안정된 인터페이스를 갖지 않으며, EXPORT_SYMBOL_GPL과 비슷하게 서브시스템 메인테이너가 필요하면 바꾸거나 제거할 수 있다.
kfunc 호출 메커니즘은 2021년 커밋(e6ac2450d6dee)에서 처음 도입됐는데, 이 커밋 메시지부터 "화이트리스트에 오른 함수들은 고정된 ABI 계약에 묶이지 않는다"고 명시했다.
이후 KF_ACQUIRE·KF_RELEASE·KF_RET_NULL 같은 플래그 기반 인프라로 계속 정리돼 왔다.
즉 처음 설계할 때부터 helper와는 다른 안정성 등급으로 의도된 기능이며, 지금도 계속 다듬어지고 있다.
Brendan Gregg는 2024년 SIGCOMM 발표에서 User/Kernel/BPF 세 실행 모델을 비교하며 BPF의 자원 접근 채널을 "restricted helpers, kfuncs"로 병기했다. 다만 이 슬라이드는 둘을 나란히 놓을 뿐 등록·조회 메커니즘 차이까지 다루지는 않는다.
6. attach type은 언제·어떻게 검증되는가
BPF_PROG_LOAD 처리 중 프로그램 메모리 할당보다도 먼저, kernel/bpf/syscall.c의 bpf_prog_load_check_attach()가 prog_type과 사용자가 넘긴 expected_attach_type의 조합을 검사한다.
/* kernel/bpf/syscall.c, v6.9, bpf_prog_load_check_attach() 2556-2565, 2605-2608행(파일 등장 순서) */
case BPF_PROG_TYPE_CGROUP_SOCK:
    switch (expected_attach_type) {
    case BPF_CGROUP_INET_SOCK_CREATE:
    case BPF_CGROUP_INET_SOCK_RELEASE:
    case BPF_CGROUP_INET4_POST_BIND:
    case BPF_CGROUP_INET6_POST_BIND:
        return 0;
    default:
        return -EINVAL;
    }
...
case BPF_PROG_TYPE_SK_LOOKUP:
    if (expected_attach_type == BPF_SK_LOOKUP)
        return 0;
    return -EINVAL;
소스 - kernel/bpf/syscall.c#L2556-L2565 · SK_LOOKUP 분기 L2605-L2608
이 함수 하나가 "이 prog_type엔 이 attach_type만"이라는 표를 코드로 구현한다.
다만 표의 형태가 균일하지 않다. 아래 그림은 prog_type마다 로드 시점 검사가 몇 갈래로 갈리는지 보여준다.
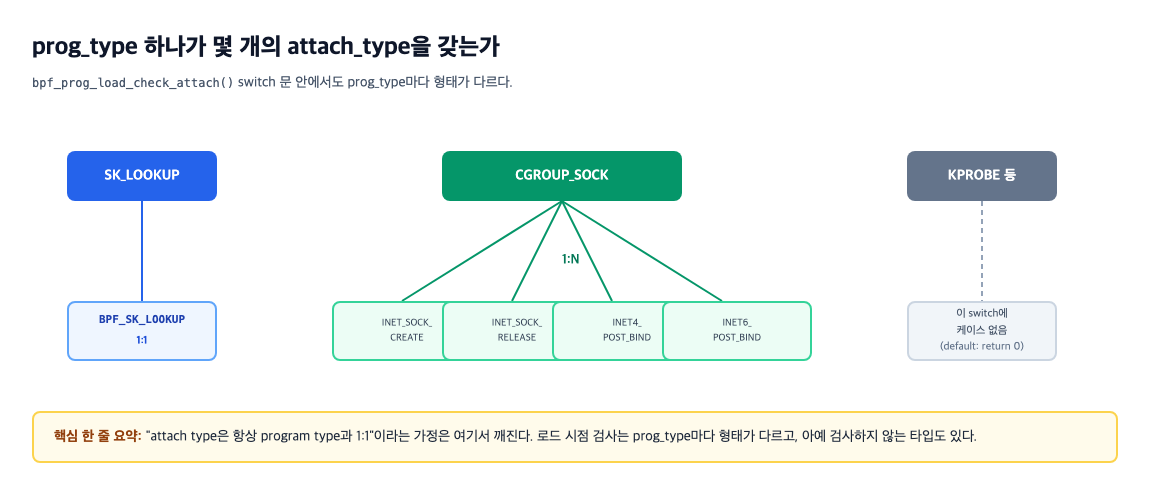
"attach type은 항상 program type과 1:1이다"라는 가정은 이 코드 앞에서 바로 무너진다.
bpf_prog_load_check_attach()도 로드 시점 검사일 뿐이라, 실제 attach 시점에 다시, 종종 더 세밀하게 검사된다.
로드 시점엔 케이스가 아예 없던 KPROBE도 attach 시점엔 attach_type에 따라 세 갈래로 나뉘고, CGROUP_SKB류는 검문소를 하나 더 거친다.
몇 단계를 거치는지는 prog_type마다 다르며, 정확한 함수와 조건은 아래 표에 정리했다.
| 검문소 | 시점 | 담당 함수 | 검사 대상 |
|---|---|---|---|
| 1 | BPF_PROG_LOAD | bpf_prog_load_check_attach() | prog_type-expected_attach_type 조합(일부 타입만) |
| 2 | BPF_LINK_CREATE | link_create() → prog_type별 attach 함수 | attach_type별 라우팅(예: KPROBE는 BPF_PERF_EVENT/BPF_TRACE_KPROBE_MULTI/BPF_TRACE_UPROBE_MULTI 3분기) |
| 3(일부만) | attach 시점 | bpf_prog_attach_check_attach_type() | CGROUP_SKB류의 enforce_expected_attach_type 강도 |
이 1:N 구조는 커널 버전이 올라가며 계속 넓어지는 살아있는 표다.
책 출간(2023년 2월) 이후 새로 생긴 것만 셋이다. 정확한 내용과 근거는 아래 표에 정리했다.
| 상태 | 책 원문 서술 | 실제 (커널 v6.9 기준) | 근거 |
|---|---|---|---|
| 신규 | BPF_PROG_TYPE_NETFILTER 미언급(책 출간 2023년 2월 시점 존재하지 않았을 가능성) | netfilter 훅(PREROUTING/FORWARD 등)에 붙는 별도 program type으로 존재 | S028 |
| 신규 | CGROUP_SOCK/CGROUP_SKB와 "연결 대상 주소를 속일 수 있다"는 서술만 있고, CGROUP_SOCK_ADDR라는 이름은 등장하지 않음(p.139) | 그 이름으로 확정된 타입이 존재하며, AFUNIX 소켓용 `BPF_CGROUP_UNIX*` attach type 다섯 종이 책 출간 이후 추가로 늘어남(LWN 기준) | S029 |
| 신규 | global subprog에 넘기는 context 인자의 타입 검증은 책에서 다루지 않음 | __arg_ctx 태그가 붙은 인자는 program type별 canonical context 타입을 강제받음(v6.9 신규) | S018 |
(신규 = 책 출간 이후 새로 생긴 내용. 유지/보정/오류 등급은 이번 주차에서는 해당 사례가 없었다.)
7. return code는 누가 해석하는가
반환값(R0)의 의미는 kernel/bpf/verifier.c의 check_return_code()가 prog_type별 정적 range로 강제한다. 예를 들어 BPF_PROG_TYPE_NETFILTER는 아래 코드처럼 반환값 범위가 로드 시점에 고정된다.
/* kernel/bpf/verifier.c, v6.9, check_return_code() 15502-15511행 */
case BPF_PROG_TYPE_NETFILTER:
    range = retval_range(NF_DROP, NF_ACCEPT);
    break;
case BPF_PROG_TYPE_EXT:
    /* freplace program can return anything ... */
default:
    return 0;
소스 - kernel/bpf/verifier.c#L15502-L15511
그런데 이 switch 문에는 BPF_PROG_TYPE_XDP 케이스가 없다. 아래 그림은 정적 range 강제 여부에 따라 반환값 해석이 세 갈래로 갈리는 걸 보여준다.
XDP는 이 switch에 case 자체가 없어서, 일반 LSM은 case가 있지만 그 안에서 조건부로 빠져서, 결과적으로 둘 다 정적 강제 없이 통과된다는 점은 같아도 코드 경로는 다르다.
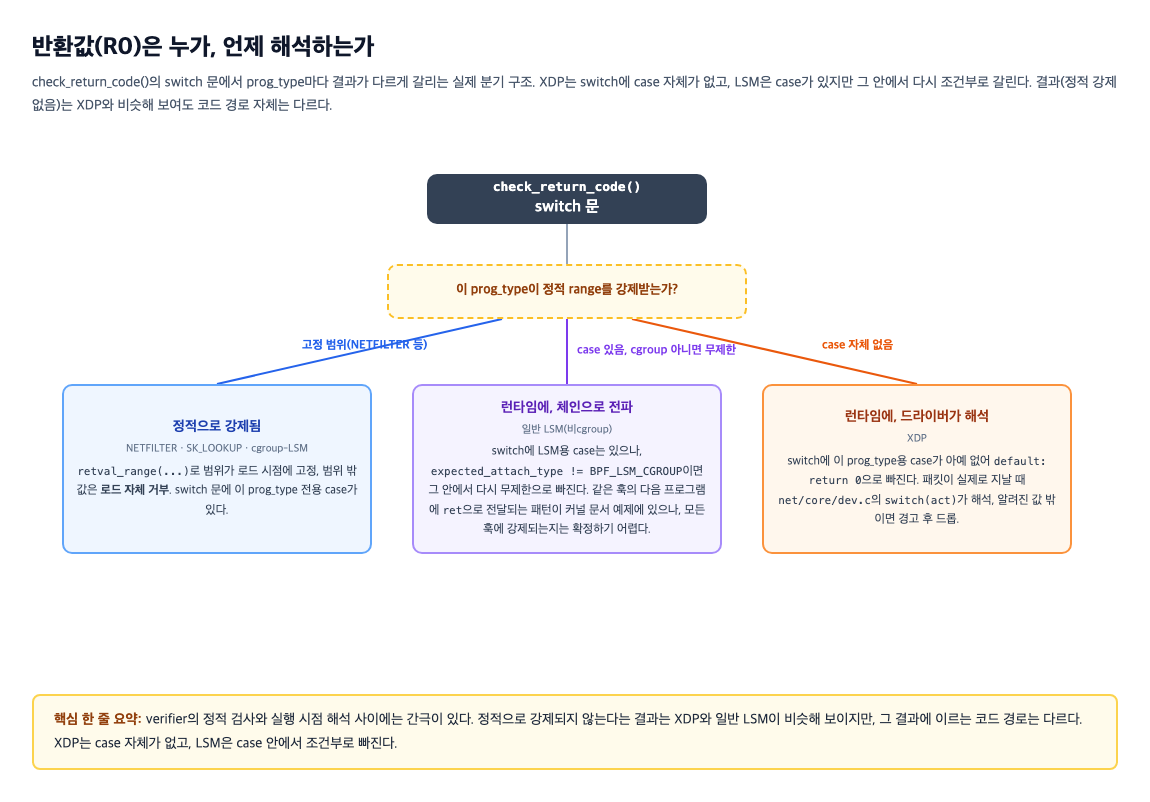
이 강제는 cgroup 계열 LSM(expected_attach_type == BPF_LSM_CGROUP)에만 적용되고, 일반 LSM과 XDP는 로드 시점엔 거의 어떤 정수를 리턴해도 통과된다. XDP는 4(XDP_REDIRECT)를 넘는 예기치 않은 값을 리턴해도 로드는 성공하고, 런타임에만(그것도 pr_warn_once라 딱 한 번만) 경고가 뜬다.
LSM 훅 체인(그림 가운데 카드)의 근거는 커널 문서(Documentation/bpf/prog_lsm.rst) 예제 코드다. 다만 정확히 어떤 조건에서 체인이 끊기는지, 모든 훅이 이 패턴을 강제하는지까지는 이 발췌만으로 확정하기 어렵다.
8. fentry/fexit는 kprobe와 무엇이 다른가
이 섹션은 선택 축이다. 시간 여유가 있을 때 참고할 배경으로 다룬다.
kprobe와 fentry/fexit(BPF trampoline)는 같은 지점(대상 함수)에서 BPF 프로그램을 실행하지만 그 지점에 도달하는 경로가 다르다.
kernel/bpf/trampoline.c의 bpf_trampoline_update()가 트램폴린 쪽 메커니즘을 담당한다. 아래 그림은 두 경로와 비용 구조를 비교한다.
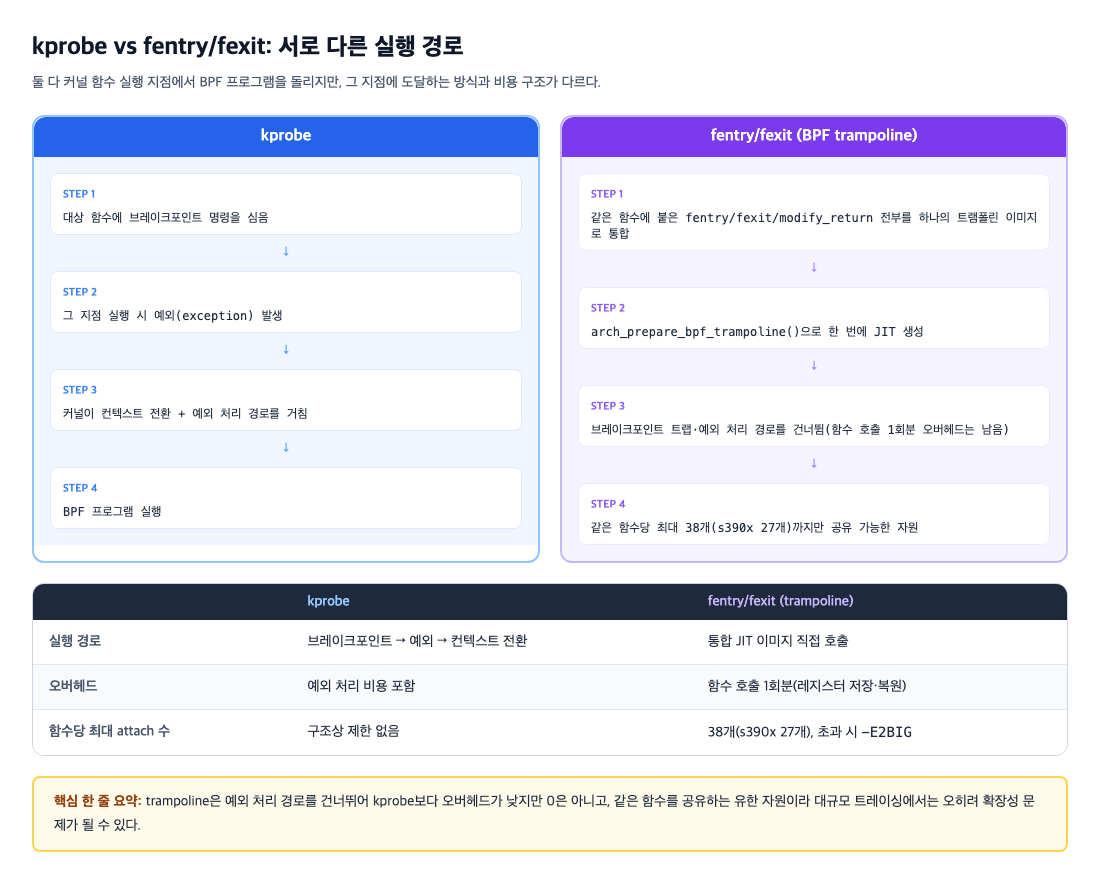
이 메커니즘은 2019년 커밋(fec56f5890d9, "bpf: Introduce BPF trampoline")에서 처음 도입됐다. 커밋 메시지는 목적을 "커널 코드가 BPF 프로그램을 사실상 오버헤드 없이 호출할 수 있게 하는 것"이라고 명시한다.
tools/testing/selftests/bpf/prog_tests/trampoline_count.c의 serial_test_trampoline_count()는 그림 표의 마지막 행(함수당 최대 attach 수)까지 반복 attach가 성공하고, 그다음 하나를 더 attach하면 정확히 -E2BIG 에러로 실패한다는 걸 실제로 실행해서 검증한다.
2025년 Linux Plumbers Conference eBPF Track 발표는 이 함수당(per-function) 설계가 대규모 트레이싱 시나리오(수백~수천 개 함수를 한꺼번에 추적)에서는 오히려 확장성 문제가 된다는 문제의식을 다뤘다. 함수 하나에 대한 오버헤드는 트램폴린이 유리하지만, 추적 대상 함수 개수가 늘어나면 함수당 독립 인스턴스라는 구조 자체가 비용이 된다.
9. 정리: XDP 프로그램 하나를 로드부터 실행까지 따라가기
이 글에서 다룬 걸 XDP 프로그램 하나의 생애주기에 그대로 대입해보면 이렇게 읽힌다.
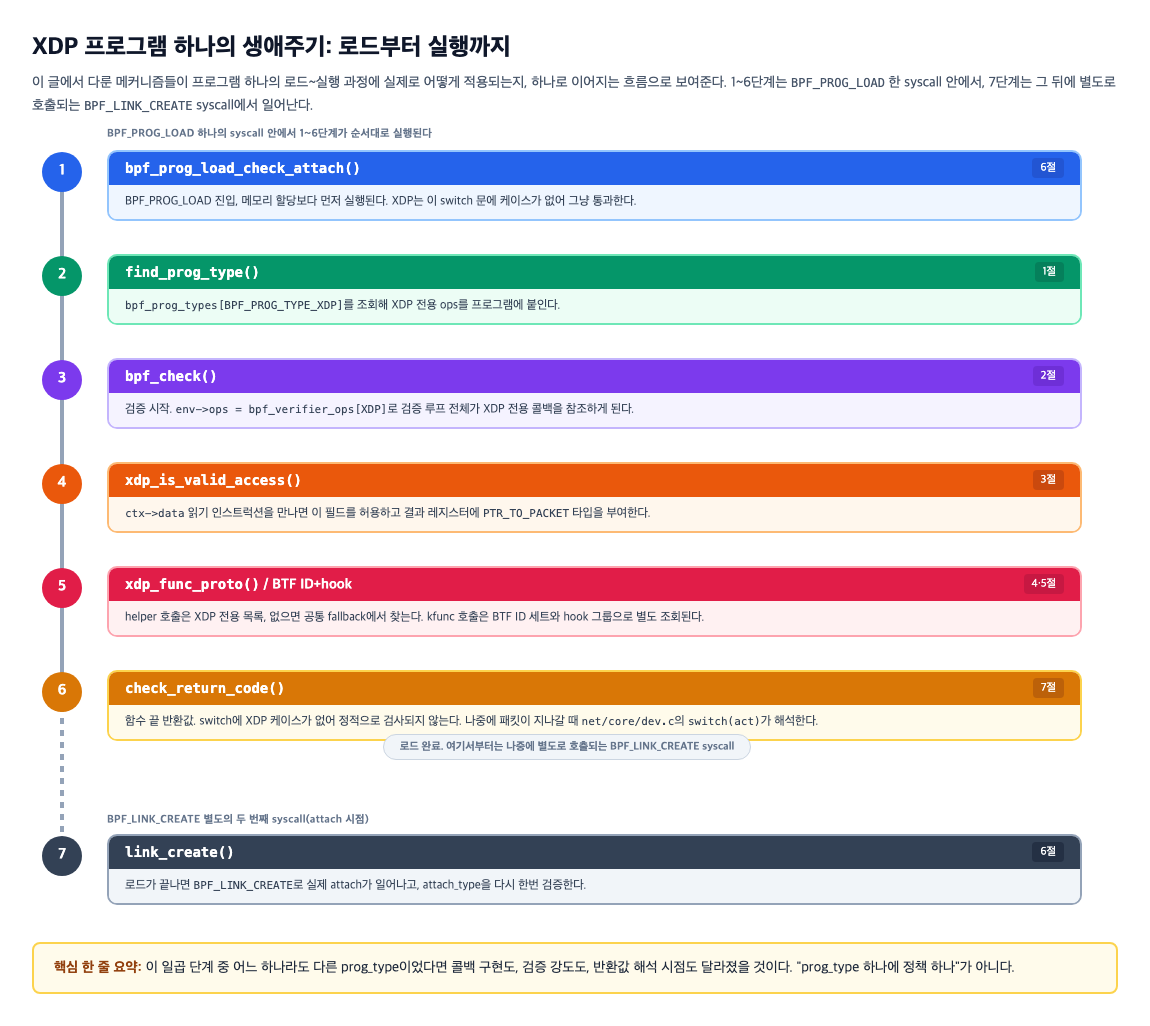
이 일곱 단계 중 어느 하나라도 다른 prog_type이었다면 콜백 구현도, 검증 강도도, 반환값 해석 시점도 달라졌을 것이다.
"prog_type 하나에 정책 하나"가 아니다.
prog_type은 bpf_verifier_ops를 통해 컨텍스트 접근과 helper 조회를 결정하고, attach_type은 그 정책들의 세부 입력값으로 작용하며, kfunc와 return code는 이 테이블 바깥의 별도 경로로 조회되거나 해석된다는 게 이 챕터 전체의 요지다.
더 볼 자료
- 공식 정의: 커널 verifier 문서:
is_valid_access·get_func_proto콜백 구조를 이 글보다 더 formal한 언어로 다룬다. - 공식 정의: kfunc 문서: kfunc의 안정성 계약과 등록 절차를 상세히 다룬다.
- 실무: Cilium BPF Architecture: 이 글이 다룬 디스패치 구조를 네트워킹 프로젝트 관점에서 재확인한다.
- 원본 텍스트: Learning eBPF 7장(원서 p.125-141,
12-ch7-ebpf-program-and-attachment-types-pp145-162.pdf): 이 글이 근거로 쓴 1차 자료.
안녕하세요~ 블로그 글 잘 읽었습니다.
전 좀 on-prem & cloud 두 환경 운영관점으로도 답변을 듣고 싶습니다.