Langfuse 공부 4 — Datasets와 Experiments UI로 비교하기
이번 글에서 할 일은 같은 질문을 두 프롬프트에 넣고, Langfuse에서 결과를 나란히 읽는 것이다. 평균 점수를 확인한 다음 개별 답변까지 내려가면서 “점수가 높으면 답이 정확한가?”도 직접 확인한다.
주요 단어 · Dataset · Expected output · Experiment · Evaluator · Score
3편의 버전 1은 한 문장으로, 버전 2는 답·근거·한계로 응답한다. 형식이 충실해 보인다고 정확성도 좋아질까? 세 질문을 고정하고 실제 로컬 모델 응답 여섯 개를 비교한다.
실습 환경은 Langfuse OSS 4.50.0, Python SDK 4.16.0, Ollama의 qwen3:8b다. 추론은 2026년 10월 4일 23:59 KST에 실행했고 저장 결과는 10월 5일 재조회했다. 데이터 등록과 모델 호출은 Python SDK로 수행했으며, 아래 화면은 같은 결과를 로컬 Langfuse UI에서 직접 연 것이다.
1. 비교의 단위
Dataset은 비교에 반복해서 사용할 입력과 선택적인 참고 답안을 모은 것이다. Experiment는 그 항목들을 특정 프롬프트·모델·설정으로 실행하고 평가한 한 번의 실험이다.
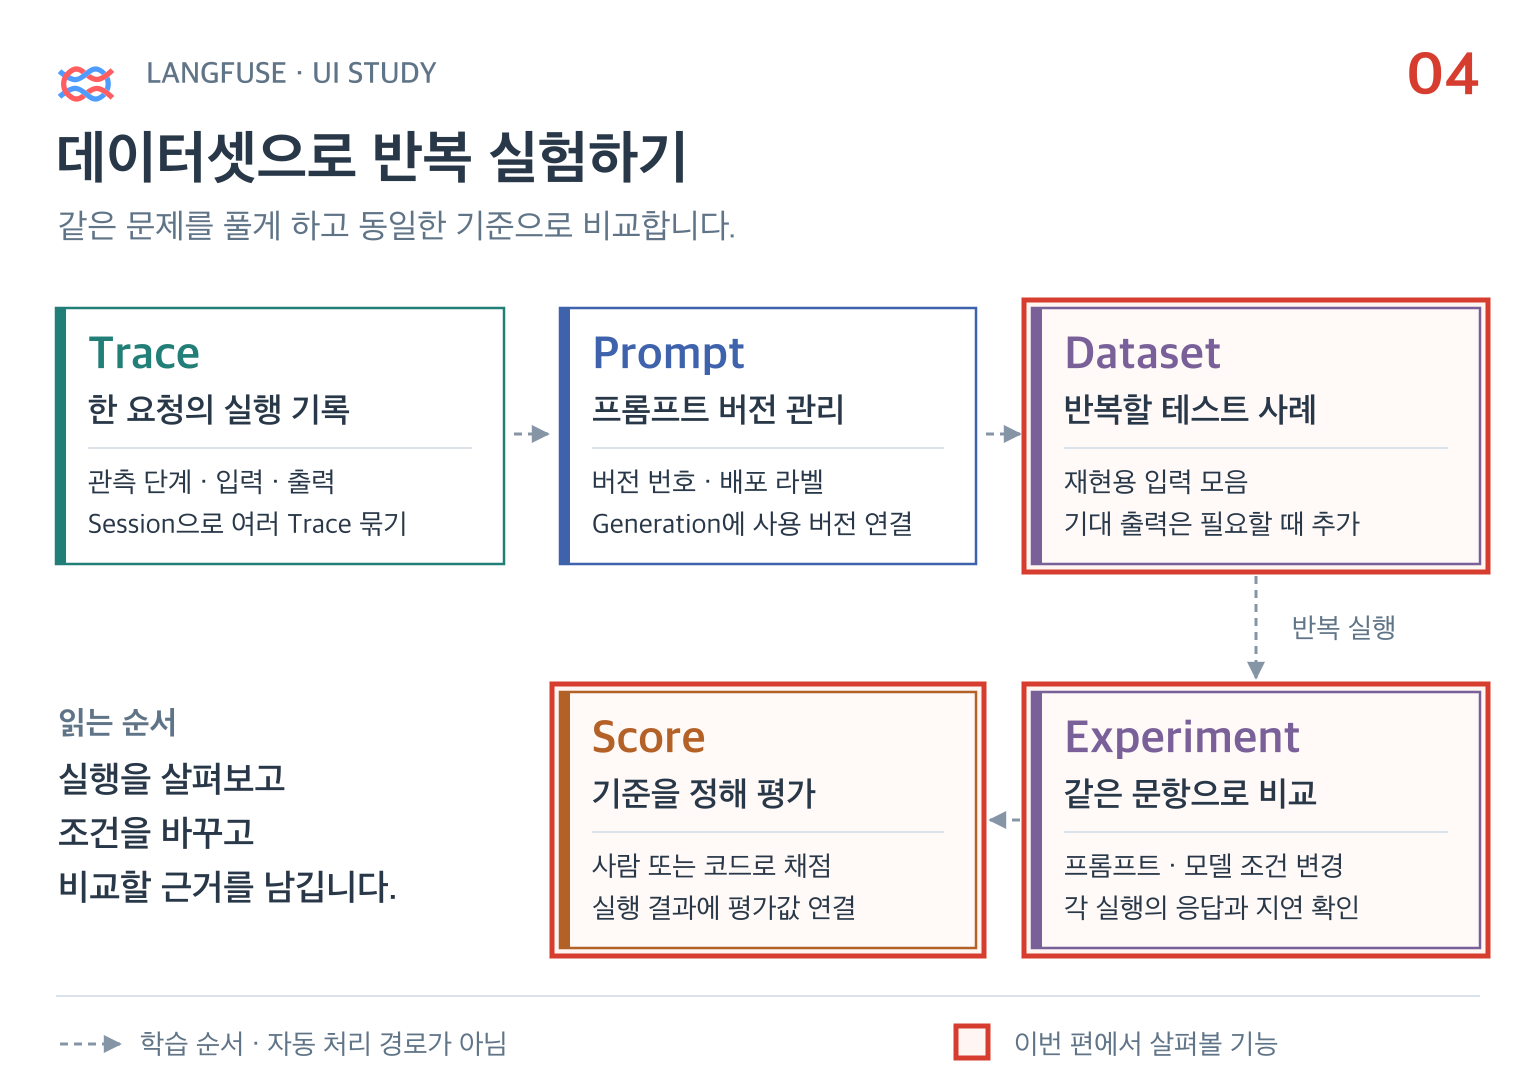
빨간 테두리는 이번 글에서 다룰 Dataset·Experiment·Score다. 점선은 학습 순서이며 자동 처리 경로가 아니다. 실제 실습에서는 ui-study-questions의 같은 세 항목을 두 프롬프트로 각각 실행한다. 평가 함수는 각 응답을 받아 점수를 계산한다. 질문을 고정해야 프롬프트 변경 전후를 비교할 수 있다.
이번 실험에서 바꾼 것은 프롬프트 버전이다. 모델은 qwen3:8b, temperature는 0, max_tokens는 256, reasoning_effort는 none으로 같게 두었다. 동시 실행 수는 1이며 버전마다 같은 세 문항을 한 번씩 실행했다. temperature를 0으로 두었더라도 다른 장비·모델 파일·실행 환경에서 항상 같은 문장이 나온다는 보장은 없다.
| 실행 이름 | Prompt 버전 | 가져올 label | 응답 지시 |
|---|---|---|---|
baseline-v1 | 1 | study-baseline | 한국어 한 문장 |
structured-v2 | 2 | study-structured | 답·근거·한계, 전체 세 문장 이내 |
Prompt는 지시문을, Dataset은 질문을 고정하고 Experiment는 그 조합을 실행한다. SDK 실행 방식은 공식 Experiments 문서를 기준으로 확인했다.
2. Dataset 읽기
ui-study-questions에는 Langfuse와 Ollama의 역할, trace/span 관계의 세 문항을 넣었다. 실험 비교 기능을 익히기 위한 작은 예제다.
왼쪽 메뉴에서 Datasets → ui-study-questions를 열고 Items 탭을 선택한다. 이 탭에서 비교에 사용할 세 질문과 참고 답안을 먼저 읽는다.
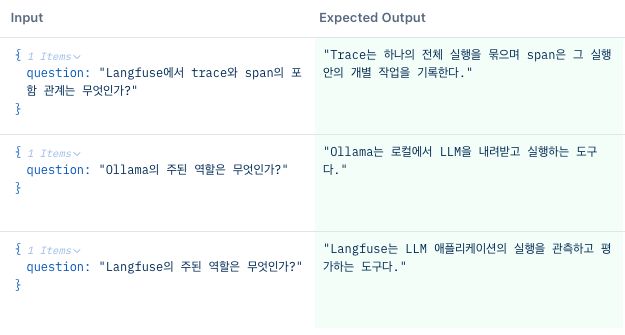
로컬 Langfuse에서 SDK로 등록한 학습용 Dataset을 직접 조회한 화면.
| Input의 질문 | Expected output의 참고 답안 |
|---|---|
| Langfuse의 주된 역할은 무엇인가? | LLM 애플리케이션의 실행을 관측하고 평가하는 도구다. |
| Ollama의 주된 역할은 무엇인가? | 로컬에서 LLM을 내려받고 실행하는 도구다. |
| Langfuse에서 trace와 span의 포함 관계는 무엇인가? | Trace는 전체 실행을 묶으며 span은 그 실행 안의 개별 작업을 기록한다. |
Input은 애플리케이션에 전달할 입력이다. 이 예제는 {"question": "질문 내용"}을 저장하고 item.input["question"]을 프롬프트의 {{question}}에 넣는다.
Expected output은 참고 답안이다. 이 칸을 채워도 자동으로 정답을 판정하지는 않는다. 평가 함수가 문자열 일치나 의미 비교에 쓸 수 있다. 이번 keyword-match는 Metadata의 keyword_groups를 검사하며, Expected output은 사람이 읽을 기준이다.
Metadata는 입력과 구분하는 부가 정보다. 여기에는 문항 식별용 case와 키워드 그룹을 넣었다. 이 예제의 모델 메시지는 question만 사용하므로 metadata는 모델에 보내지 않는다.
3. 평가 규칙 정의
Evaluator는 출력에 대해 정해진 기준을 계산하는 함수다. Score는 그 함수의 결과다. 점수의 이름·범위·분모를 알아야 값의 의미를 해석할 수 있다.
이번 규칙은 단순하다. 각 동의어 그룹에서 하나 이상의 단어를 찾으면 그 그룹을 통과한다. 모든 그룹을 통과하면 1, 하나라도 빠지면 0이다. 예를 들어 Langfuse 질문에는 다음 세 그룹을 둔다.
keyword_groups = [
    ["LLM", "언어 모델", "언어모델"],
    ["관측", "추적", "모니터링"],
    ["평가", "분석"],
]
실제 실행 코드에서 사용한 평가 함수의 핵심 부분은 다음과 같다. 독립 실행용 전체 프로그램은 아니며, Experiment runner에 넘기는 함수 부분을 발췌했다.
from langfuse import Evaluation

def keyword_match(*, output, metadata, **kwargs):
    text = str(output).casefold()
    groups = metadata["keyword_groups"]
    missing = [
        group for group in groups
        if not any(word.casefold() in text for word in group)
    ]
    return Evaluation(
        name="keyword-match",
        value=0.0 if missing else 1.0,
        comment=f"단순 키워드 검사. 누락 그룹: {missing}",
    )
대소문자를 맞춘 뒤 부분 문자열을 찾는다. “trace가 span을 포함한다”와 반대 문장에도 같은 단어가 들어간다. 관계 판정은 하지 않으므로 accuracy 대신 keyword-match로 저장했다.
Run evaluator는 세 문항의 점수를 평균 내 avg-keyword-match로 기록한다. 공식 데이터 모델에서도 개별 항목 평가와 run 전체 평가를 구분한다. 다른 evaluator의 숫자를 기준 없이 같은 품질 척도로 읽으면 안 된다.
4. 실험 실행과 목록
Dataset을 가져온 뒤 task와 evaluator를 연결한다. task는 프롬프트를 컴파일하고 Ollama에 실제로 요청하며, 답변 문자열을 반환하는 함수다. 다음은 전체 실행 코드 중 두 run에 공통으로 적용한 부분이다.
dataset = langfuse.get_dataset("ui-study-questions")

result = dataset.run_experiment(
    name="ui-study-prompt-comparison",
    run_name="baseline-v1",  # 다른 실행은 structured-v2
    task=task,
    evaluators=[keyword_match],
    run_evaluators=[average_keyword_match],
    max_concurrency=1,
    metadata={
        "prompt_name": "ui-study/tutor-answer",
        "prompt_version": 1,
        "model": "qwen3:8b",
    },
)
langfuse.flush()average_keyword_match는 세 항목 점수의 산술평균을 반환한다. 두 번째 실행은 task가 가져올 Prompt와 metadata의 버전도 2로 바꿨다. 실행 이름만 바꾸면 프롬프트가 바뀌지는 않는다.
종료 전 flush()로 대기 중인 관측 데이터를 내보낸다. 이어 API로 두 실험·여섯 결과·점수·Prompt 연결·토큰 값을 다시 읽어 28개 검증 항목을 통과한 뒤 UI를 확인했다.
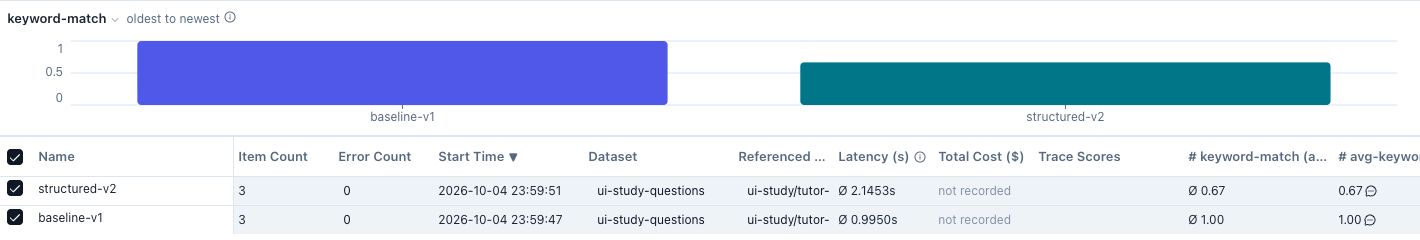
같은 Dataset을 사용한 두 run. Item Count는 각각 3이다. Error Count가 0이라는 것은 실행 오류가 없었다는 뜻이며, 답변 내용이 모두 정확하다는 뜻은 아니다.
목록에서 Dataset과 항목 수를 확인한다. 한쪽이 세 문항이고 다른 쪽이 두 문항이면 평균을 그대로 비교할 수 없다. 이번 데이터는 전날 23:59 KST에 실행되어 자정 이후의 “오늘” 범위에서 빠질 수 있다. 화면이 비면 프로젝트와 시간 범위부터 점검한다.
5. 두 실행 비교
같은 Dataset의 Experiments 탭에서 baseline-v1과 structured-v2 두 행을 체크한 뒤, 화면 아래의 Compare 버튼을 누른다. 비교 화면에서는 다음 순서로 기준과 표시 내용을 맞춘다.
- Baseline에서
baseline-v1을 선택한다. 처음 기준이structured-v2였다면 이를 바꾼다. 이번 UI에서는 반대쪽 실행도 자동으로 교환됐다. - Compare가
structured-v2인지 확인한다. - Columns에서 Output, Expected Output을 체크한다. Display는 기본값인 Side by side를 유지해 나란히 읽는다.
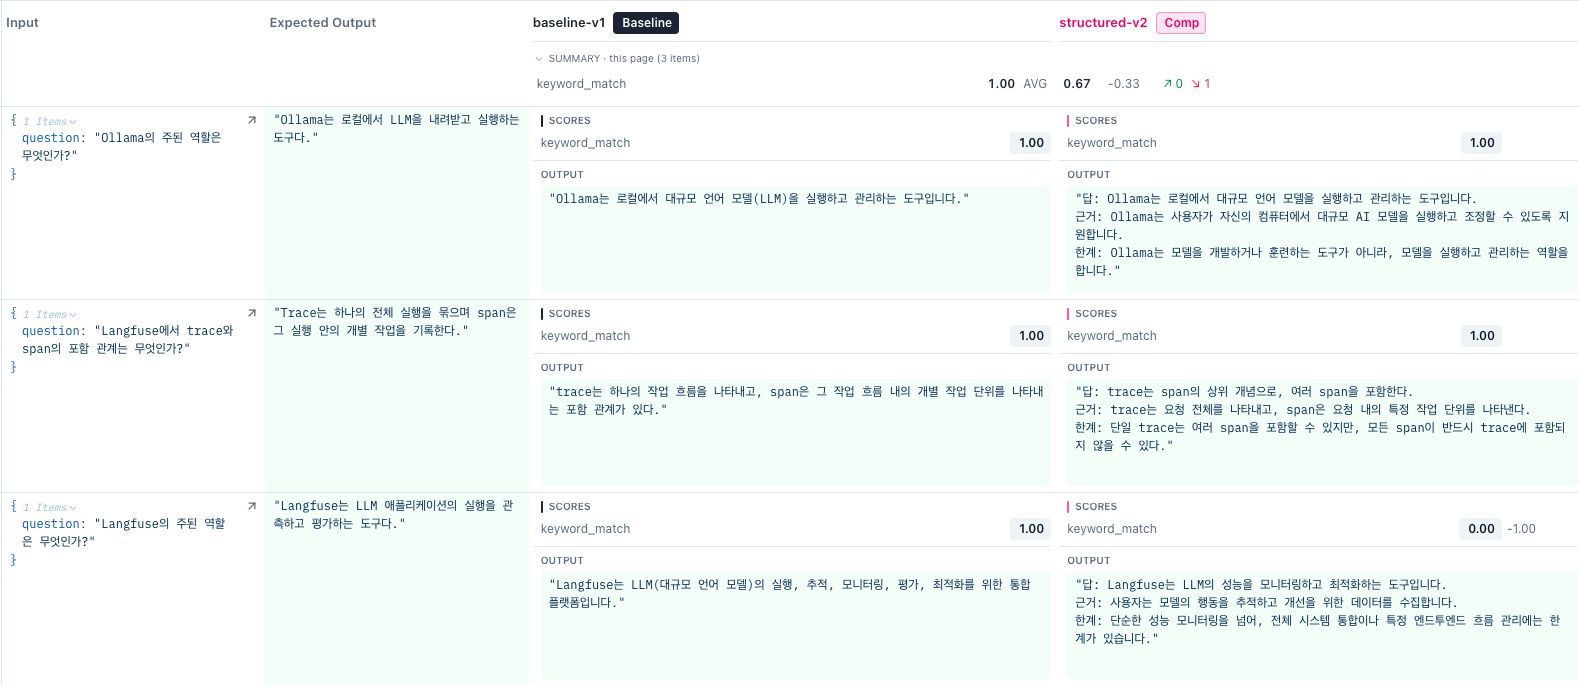
비교 화면은 평균 차이가 발생한 문항을 찾는 출발점이다. 넓은 표의 문장이 작게 보이면 원본 크기로 보기를 연다. 아래에서도 개별 응답을 따로 확대해 읽는다.
SDK에 기록한 keyword-match는 이 비교 표에서 keyword_match로 표시됐다. 평균은 기준 1, 비교 0.67, 차이 -0.33으로 보인다. Langfuse 질문 행은 비교 점수 0, 차이 -1이다. 반올림 전 평균 계산은 (1+1+0)/3이다.
| 질문 | baseline-v1 | structured-v2 |
|---|---|---|
| Langfuse 역할 | 1 | 0 |
| Ollama 역할 | 1 | 1 |
| trace와 span | 1 | 1 |
| 평균 | 1.0 | 0.6667 |
확인한 사실은 “버전 2의 답변 하나가 키워드 그룹을 충족하지 않았다”는 것이다. 한 번씩 실행한 세 문항의 단어 포함 검사이므로 “버전 1의 정확도는 100%”나 “버전 2가 항상 나쁘다”는 결론을 낼 수 없다.
실제 usage 합계를 함께 읽으면 출력 형식 변경의 비용도 확인할 수 있다.
| 세 문항 합계 | baseline-v1 | structured-v2 |
|---|---|---|
| 입력 토큰 | 175 | 394 |
| 출력 토큰 | 111 | 257 |
| 전체 토큰 | 286 | 651 |
구조화 프롬프트는 지시문과 답변이 길어 입출력 토큰 모두 늘었다. 그러나 설명이 늘었다는 사실이 정확성까지 보장하지는 않는다. 이 로컬 실습에서는 별도 모델 가격을 설정하지 않았으므로 토큰을 API 청구액으로 읽을 수도 없다.
6. 개별 응답에서 배우기
6.1 점수 0의 이유
버전 2에서 Langfuse 역할 질문의 실제 출력은 다음과 같다.
답: Langfuse는 LLM의 성능을 모니터링하고 최적화하는 도구입니다.
근거: 사용자는 모델의 행동을 추적하고 개선을 위한 데이터를 수집합니다.
한계: 단순한 성능 모니터링을 넘어, 전체 시스템 통합이나 특정 엔드투엔드 흐름 관리에는 한계가 있습니다.
LLM, 모니터링, 추적이 있지만 평가와 분석은 없어 0점이다. 이것은 규칙의 결과다. 마지막 문장의 제품 한계까지 검증해 주지는 않는다. 근거 없이 넓은 주장을 만들었을 수 있으므로 제품 설명으로 인용하려면 공식 기능 문서와 따로 대조해야 한다.
비교 표의 Langfuse 질문 행에서 structured-v2 쪽 점수 또는 출력 셀을 누른다. 잠시 뒤 오른쪽에 Experiment Item 패널이 열린다. experiment-item-task의 keyword-match 점수 0과 user 질문, assistant의 세 줄 응답을 함께 확인한다.
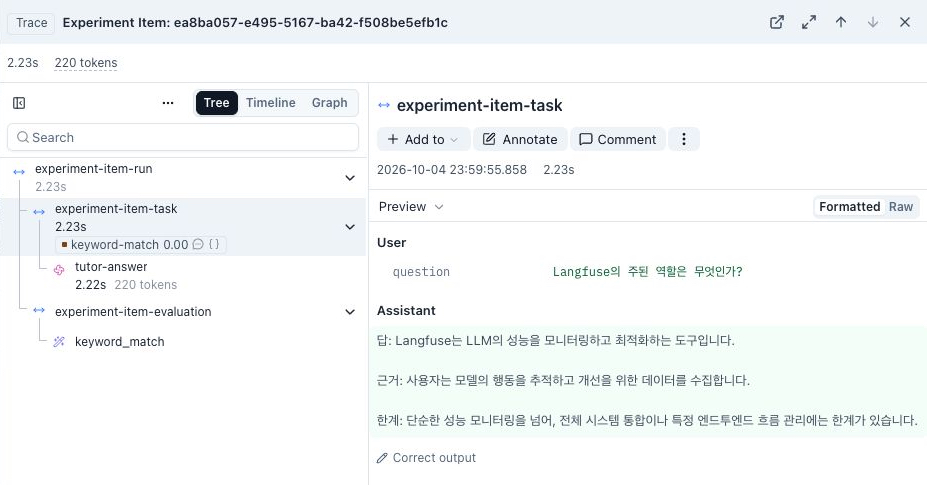
structured-v2의 오른쪽 Experiment Item 패널 부분 캡처. Expected output은 앞의 비교 표에서 읽고, 이 패널에서는 실제 응답과 점수를 확인한다.
원본 Dataset 항목의 참고 답안과 metadata를 다시 보려면 Input 오른쪽 위의 Open dataset item 화살표를 누른다. 별도의 Dataset 항목 페이지가 열리므로 실험에서 생성한 Output과 등록해 둔 Expected output을 혼동하지 않는다.
낮은 점수에서는 입력·출력·버전을 확인한 뒤 실제 문장에서 누락 그룹을 찾는다. “모델이 못했다”와 “규칙이 표현을 너무 좁게 정의했다”를 구분해야 한다. 동의어가 부족하면 타당한 설명도 0이 될 수 있다.
6.2 점수 1의 함정
더 중요한 사례는 버전 2의 trace/span 답변이다. 이 답변은 1점을 받았지만 다음 문장을 포함했다.
한계: 단일 trace는 여러 span을 포함할 수 있지만, 모든 span이 반드시 trace에 포함되지 않을 수 있다.
이 설명은 잘못됐다. Trace는 동일한 trace_id를 공유하는 observation의 묶음이고, span은 observation의 한 유형이다. 루트 span은 부모 span이 없어도 trace와 무관하지는 않다. 공식 Observability 개념을 기준으로 바로잡아야 한다.
규칙은 trace, span, 포함을 발견해 1점을 줬다. 개념의 관계나 한계 문장의 타당성을 판단하지는 않는다. 높은 점수의 항목도 직접 읽어야 하는 이유다. 검사가 놓친 오류는 숫자 뒤에 남는다.
6.3 Prompt와 Trace 연결
결과가 이상하면 패널의 트리에서 experiment-item-task 아래 tutor-answer generation까지 확인한다. 이 Langfuse 질문의 버전 2 호출은 입출력 합계 220토큰을 사용했다. 이번 여섯 generation에는 prompt=prompt를 전달해 실제 사용한 버전을 연결했다.
전체 프로그램은 버전 번호로 조회한 Prompt 객체를 컴파일해 입력으로 쓰고 응답·usage를 기록한다. label 조회도 별도로 수행해 study-structured가 버전 2를 가리키는지 검증했다. 공식 문서도 generation에 Prompt 객체를 전달하도록 안내한다. 연결된 버전까지 확인하면 이름만 보고 지나친 버전 선택 실수를 찾을 수 있다.
7. 다시 실행하고 확장하기
전체 프로그램은 기존 설치 편의 가상환경과 .env를 사용한다. 현재 로컬 작업 폴더에서 다음처럼 실행한다.
cd /Users/daeyong/ws/study
docs/langfuse-study-2026-10-04/lab/.venv/bin/python \
  docs/langfuse-ui-guide-2026-10-04/lab/prompt_experiment.py
완료한 run은 체크포인트를 읽어 건너뛰므로 추론을 반복하지 않는다. 저장값만 확인하려면 --verify-only를 붙인다. 중간에 실행이 끊겼다면 체크포인트의 inflight_run과 UI에 저장된 결과부터 확인한다. 이 파일을 지워 다시 시작하면 중복 실행이 생길 수 있으므로 무작정 삭제하지 않는다. 서버와 Dataset은 후속 학습을 위해 유지했다.
다음에는 새 이름으로 한 가지 변경만 추가해 보자. “불확실한 한계를 임의로 만들지 말 것”을 지시하거나, 별도 evaluator로 세 줄 형식을 검사할 수 있다. keyword-match와 format-check를 나눠 기록하되 형식 점수를 사실 정확성으로 해석하지 않는다.
질문을 늘릴 때는 역할을 혼동하기 쉬운 질문도 포함한다. 사람이 확인한 오류를 새 평가 기준으로 바꾸고 같은 Dataset으로 재실행하면, 결과에서 발견한 문제를 다음 실험으로 이어 갈 수 있다.
1편: 로컬 환경 설치 · 3편: Prompt 버전 관리
자료 기준: Langfuse 4.50.0 로컬 실습, Python SDK 4.16.0. 모델 응답과 토큰·점수는 실제 실행값이며, 공식 API·개념 문서는 2026년 10월 5일 KST 확인했다. 세 문항의 결과를 일반적인 모델 성능 순위로 해석하지 않는다.
