Langfuse 실습 — 로컬 LLM부터 AIOps 운영까지
1.[Langfuse 1] Docker와 Ollama로 로컬 LLM 관측 환경 만들기
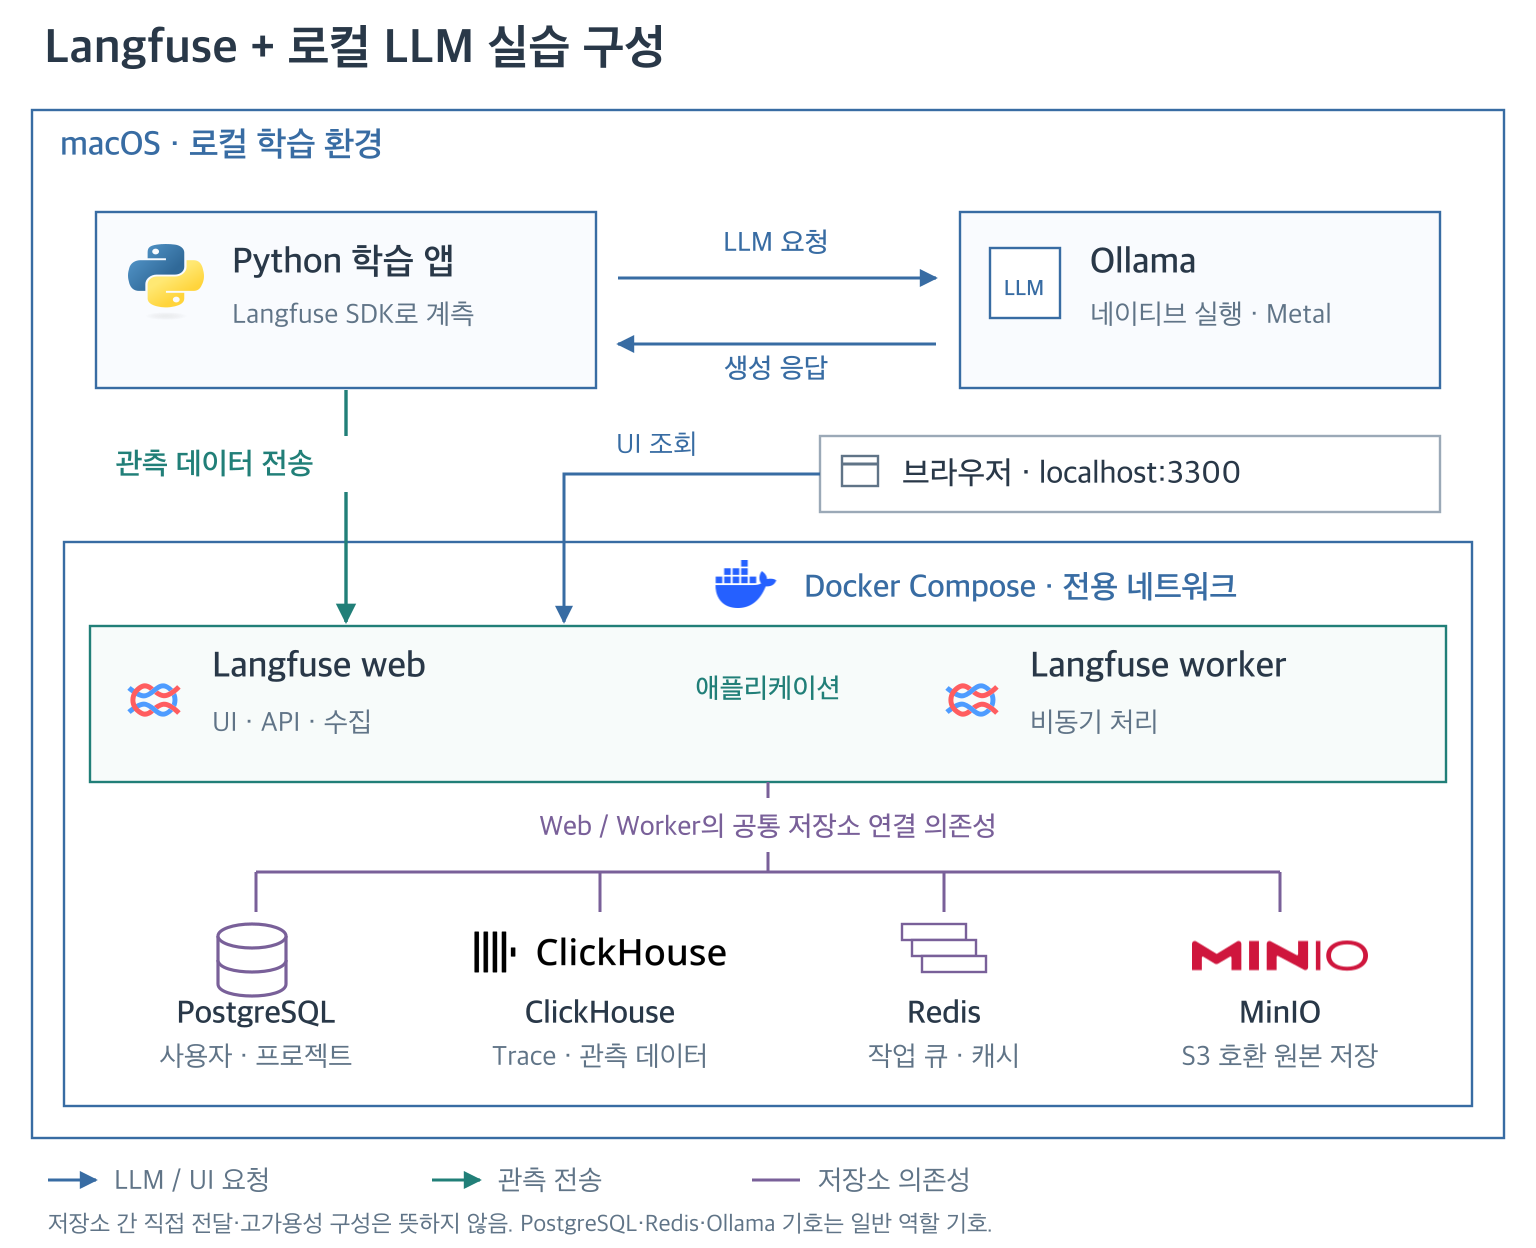
Mac에 Ollama와 qwen3:8b를 설치하고 Docker로 Langfuse v4를 구성했습니다. 실제 로컬 추론, trace 저장·재조회, 입력·출력·토큰 확인까지 기록합니다.
2.[Langfuse 2] UI에서 Trace·오류·Session·Score 읽기
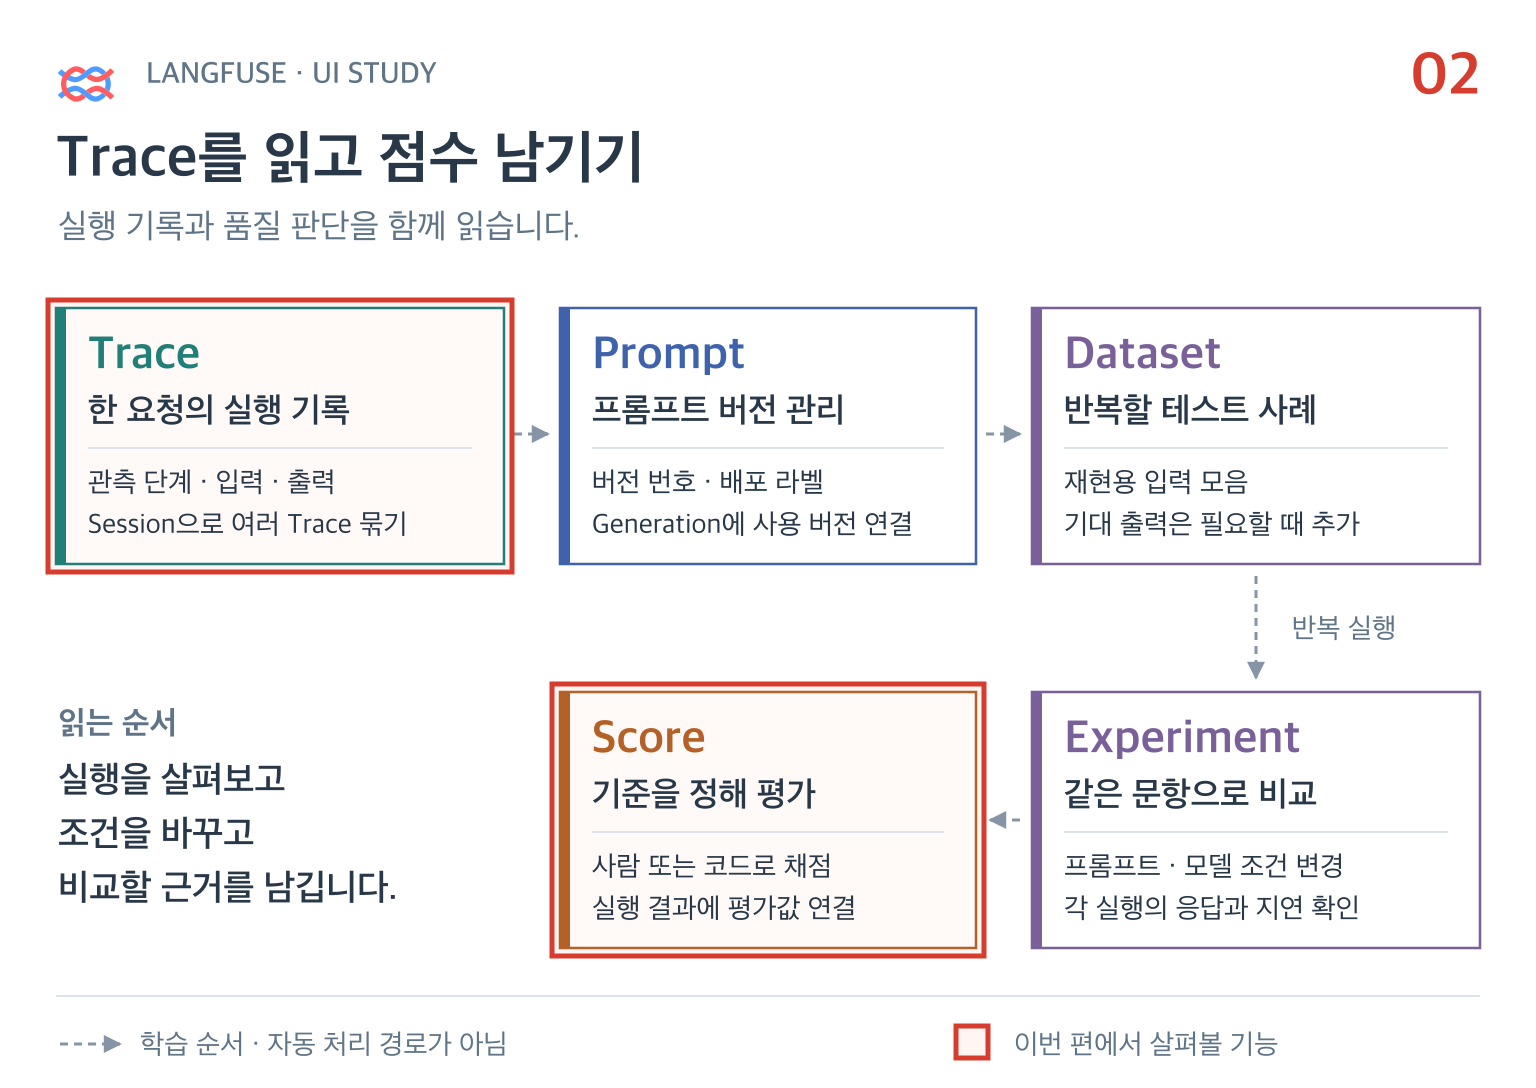
실제 로컬 LLM 요청 세 개로 Tracing 필터, 관측 트리와 Timeline, 입력·출력·토큰, 의도한 ERROR, Session과 수동 Score를 읽고 기록합니다.
3.[Langfuse 3] Prompts UI에서 버전과 라벨 관리하기
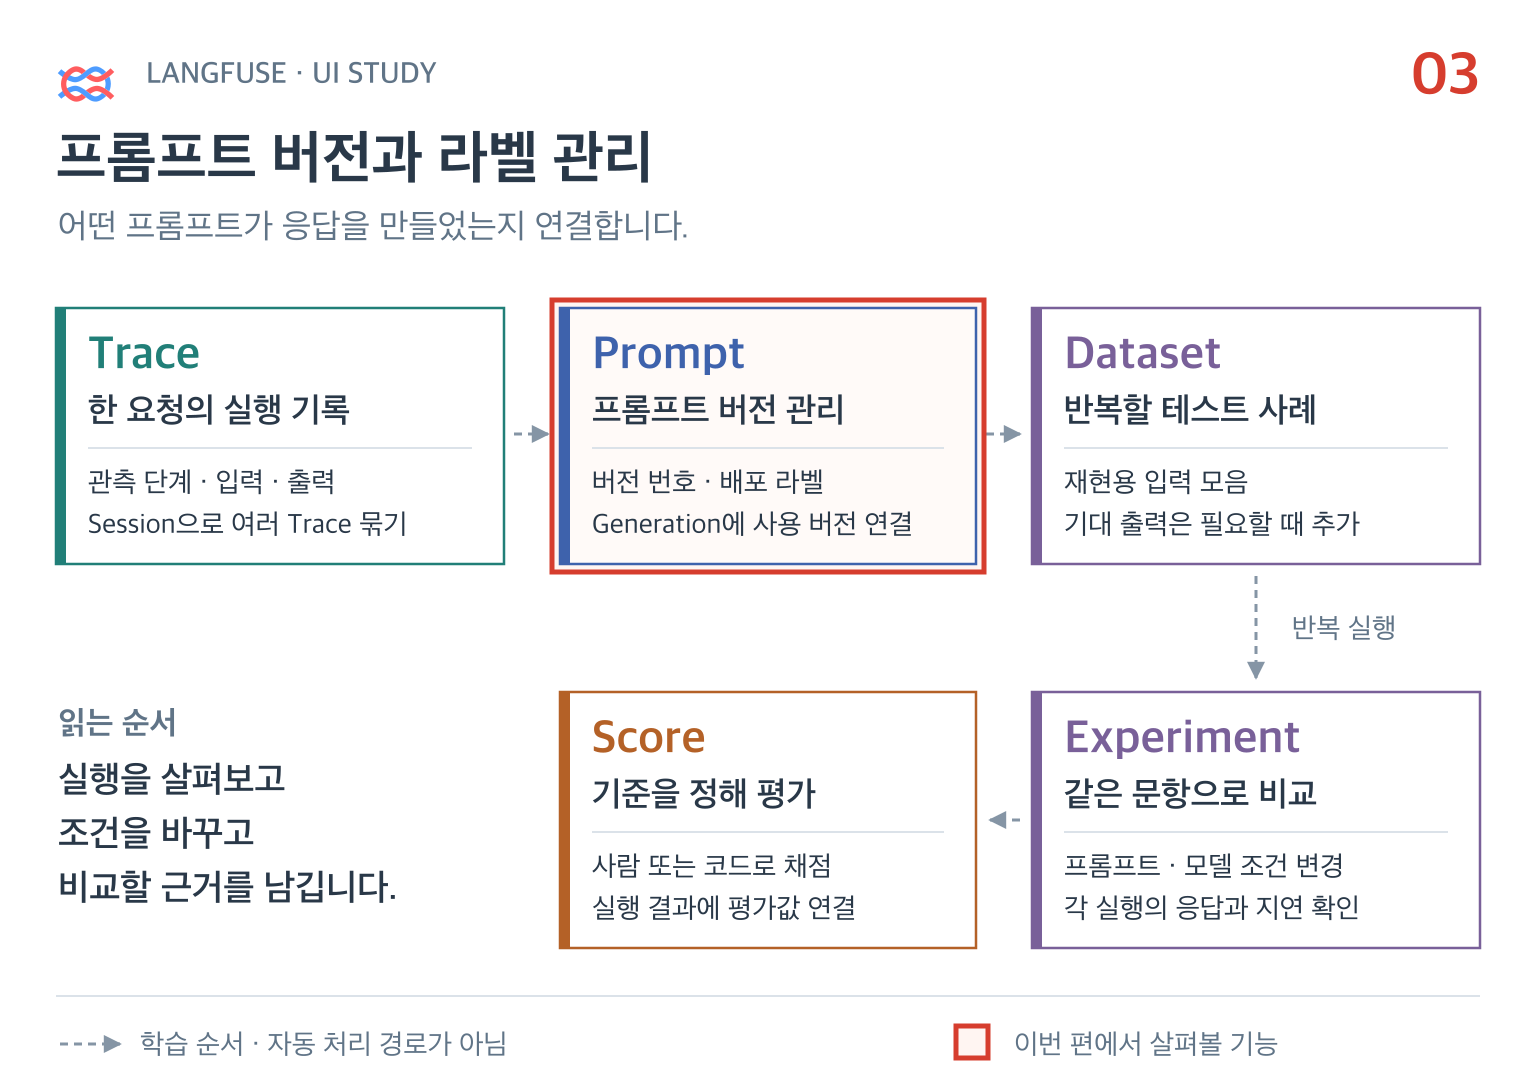
Prompts UI에서 본문·Config·변수, 버전 차이와 라벨을 읽고 관리합니다. 로컬 Ollama의 실제 호출을 Linked Generations에서 찾아 사용 버전을 확인합니다.
4.[Langfuse 4] Datasets와 Experiments UI로 프롬프트 비교하기
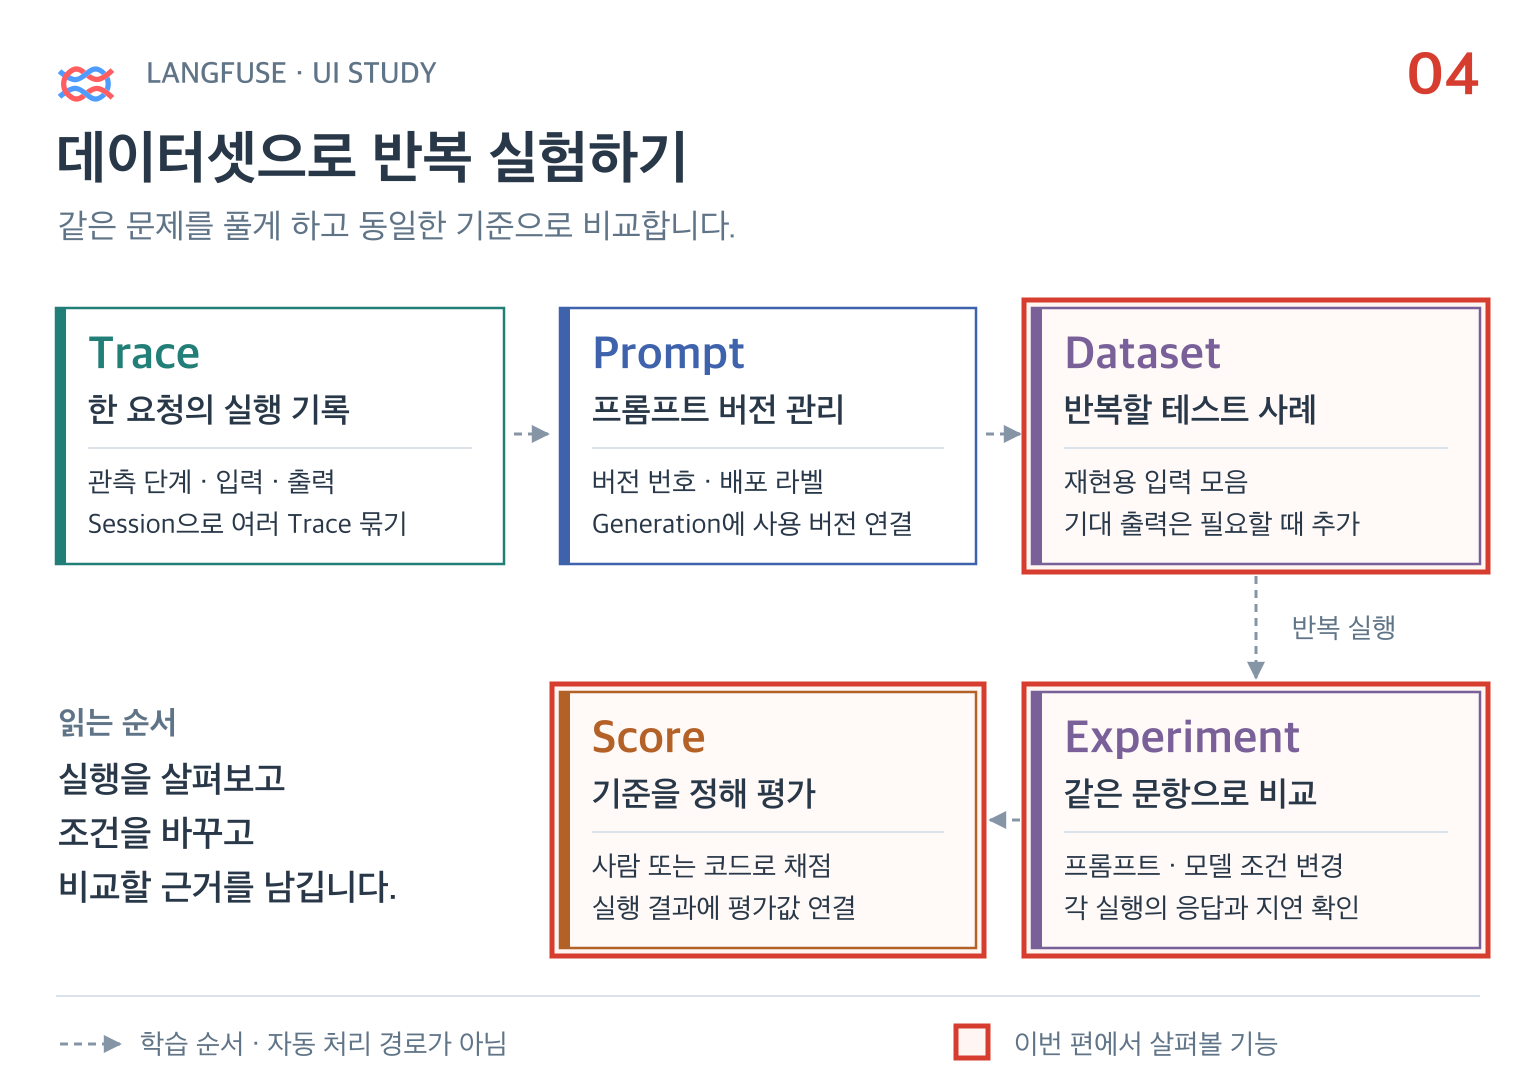
같은 세 질문을 두 프롬프트로 실행해 Datasets와 Experiments UI에서 비교합니다. 평균 점수부터 개별 응답까지 읽으며 키워드 평가가 놓치는 오류를 확인합니다.
5.[Langfuse 5] 장애 진단 에이전트와 Agent Graph 읽기
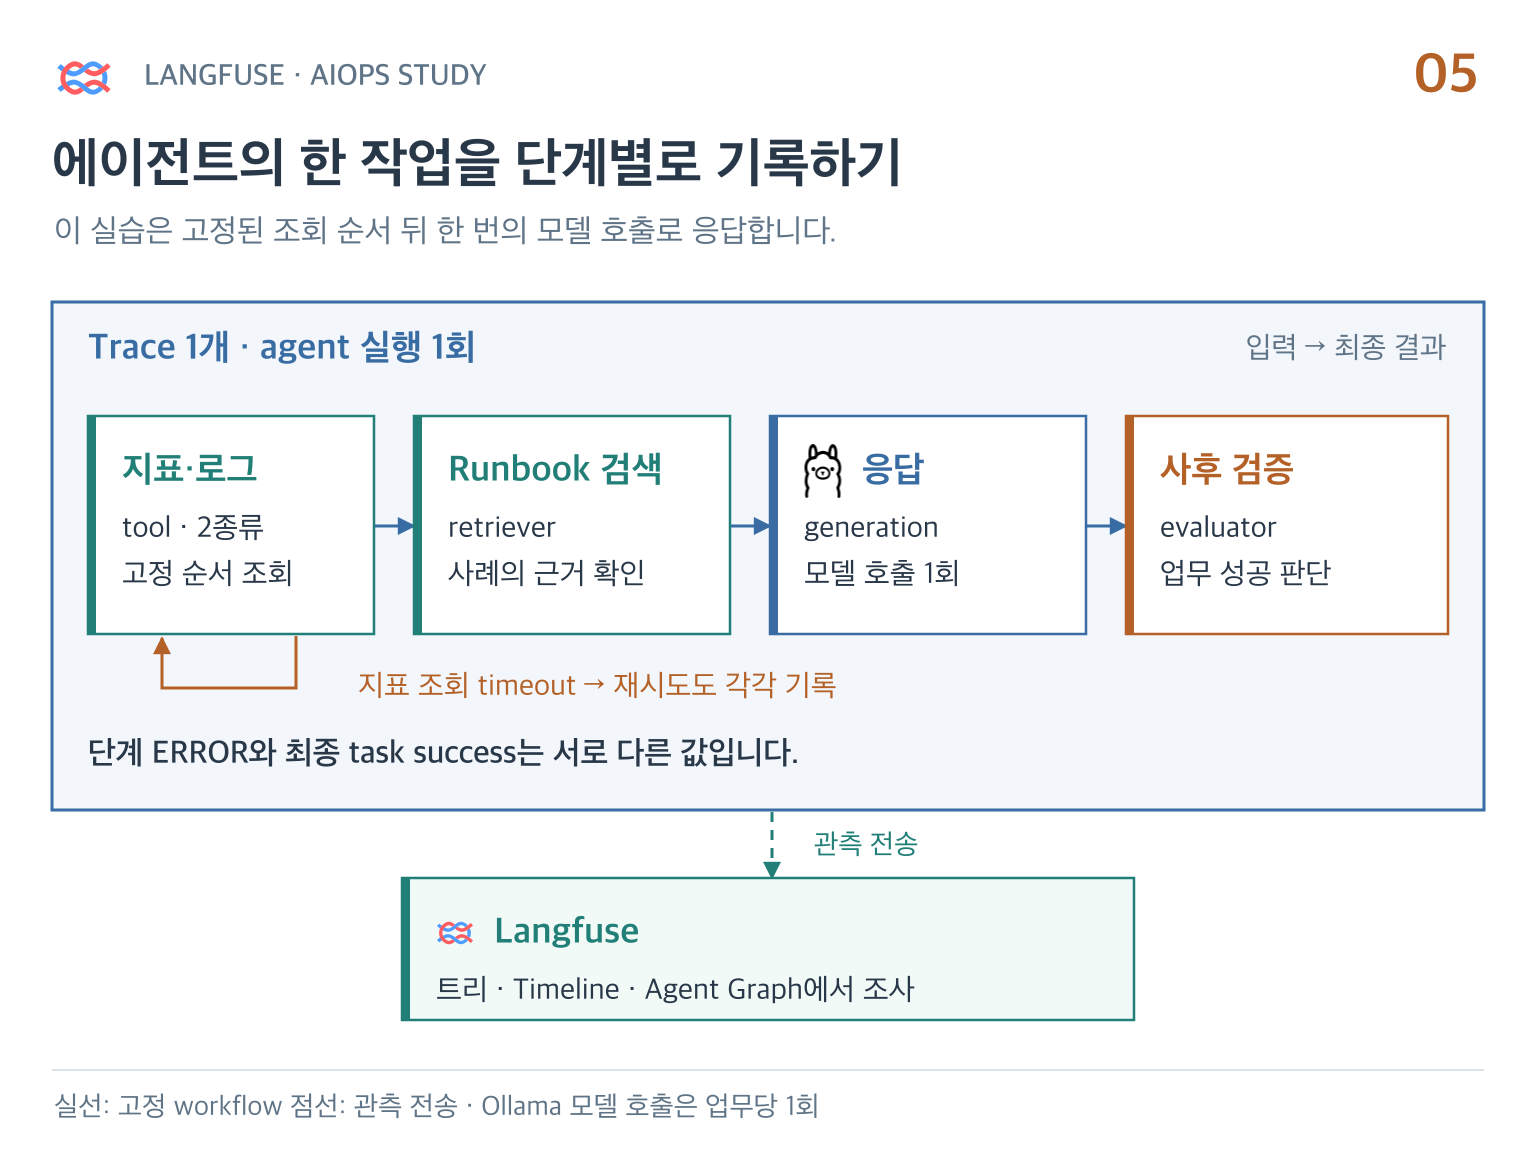
합성 장애 6건을 로컬 LLM으로 진단하고, Agent·Tool·Graph에서 재시도와 판단 실패를 구분합니다.
6.[Langfuse 6] 비용·성공률·p95 대시보드 만들기
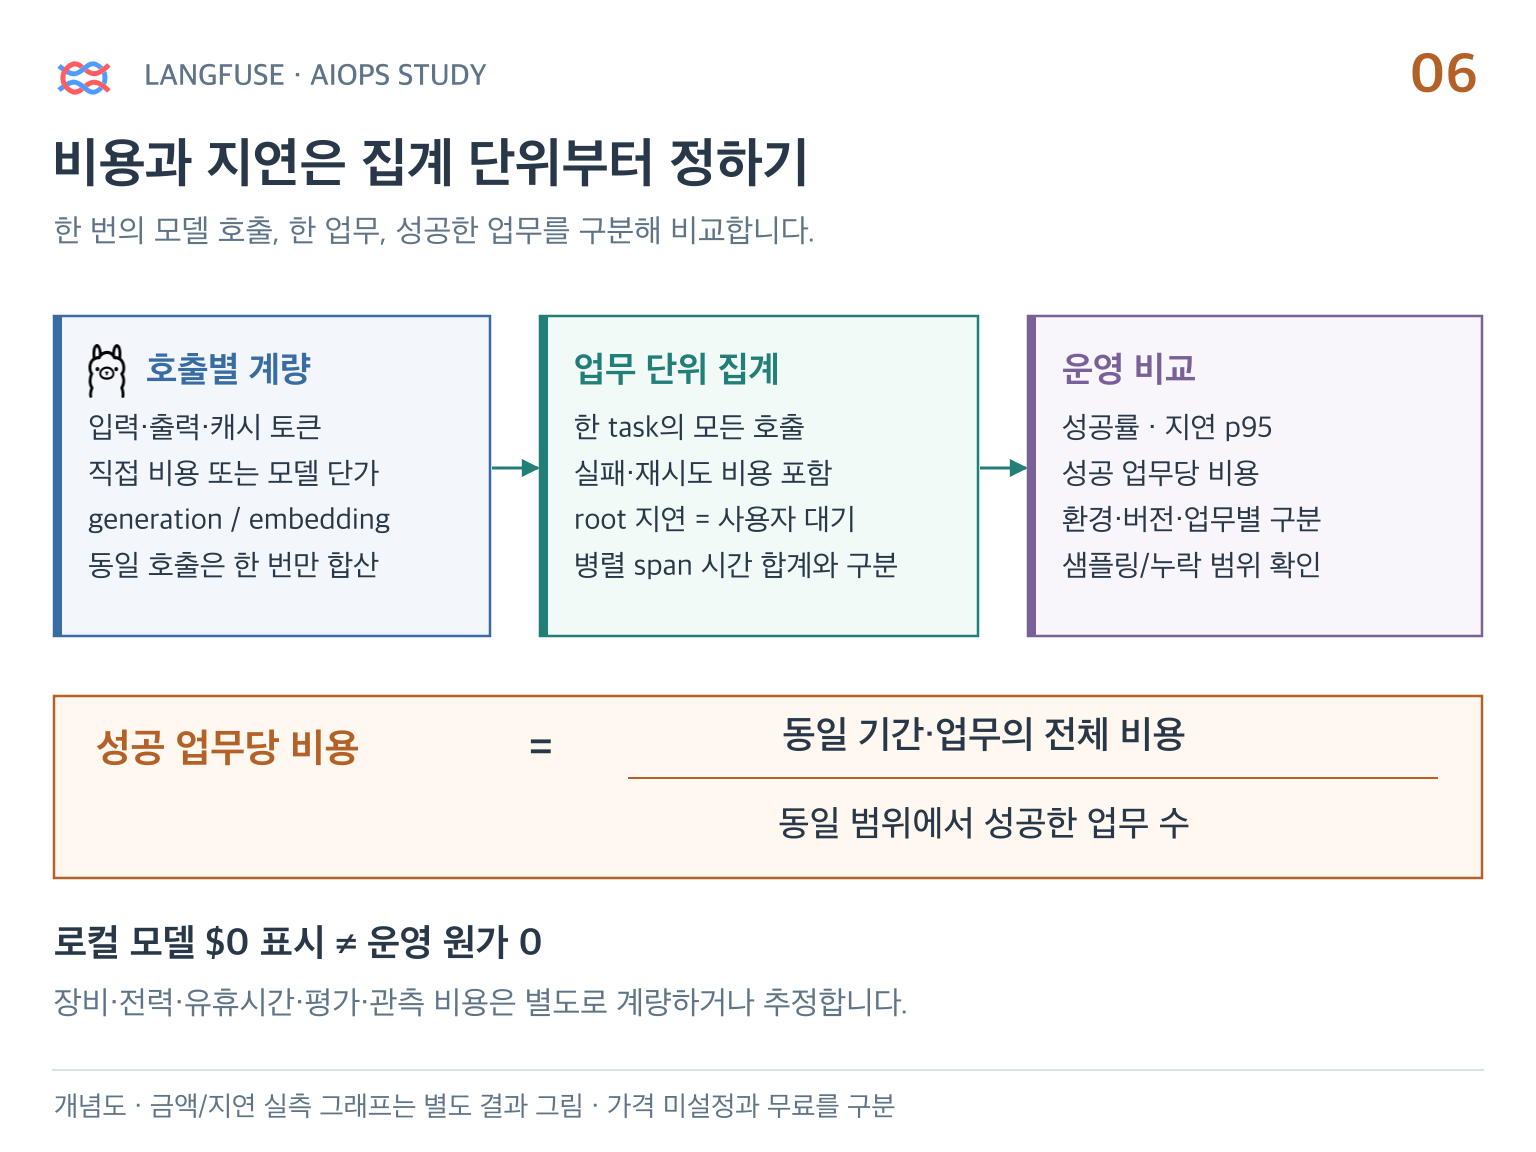
실제 6건의 토큰·TTFT·p95를 집계하고, 요청당 비용과 성공당 비용의 분모 차이를 확인합니다.
7.[Langfuse 7] 로컬 Judge와 Annotation Queue로 평가 검증하기
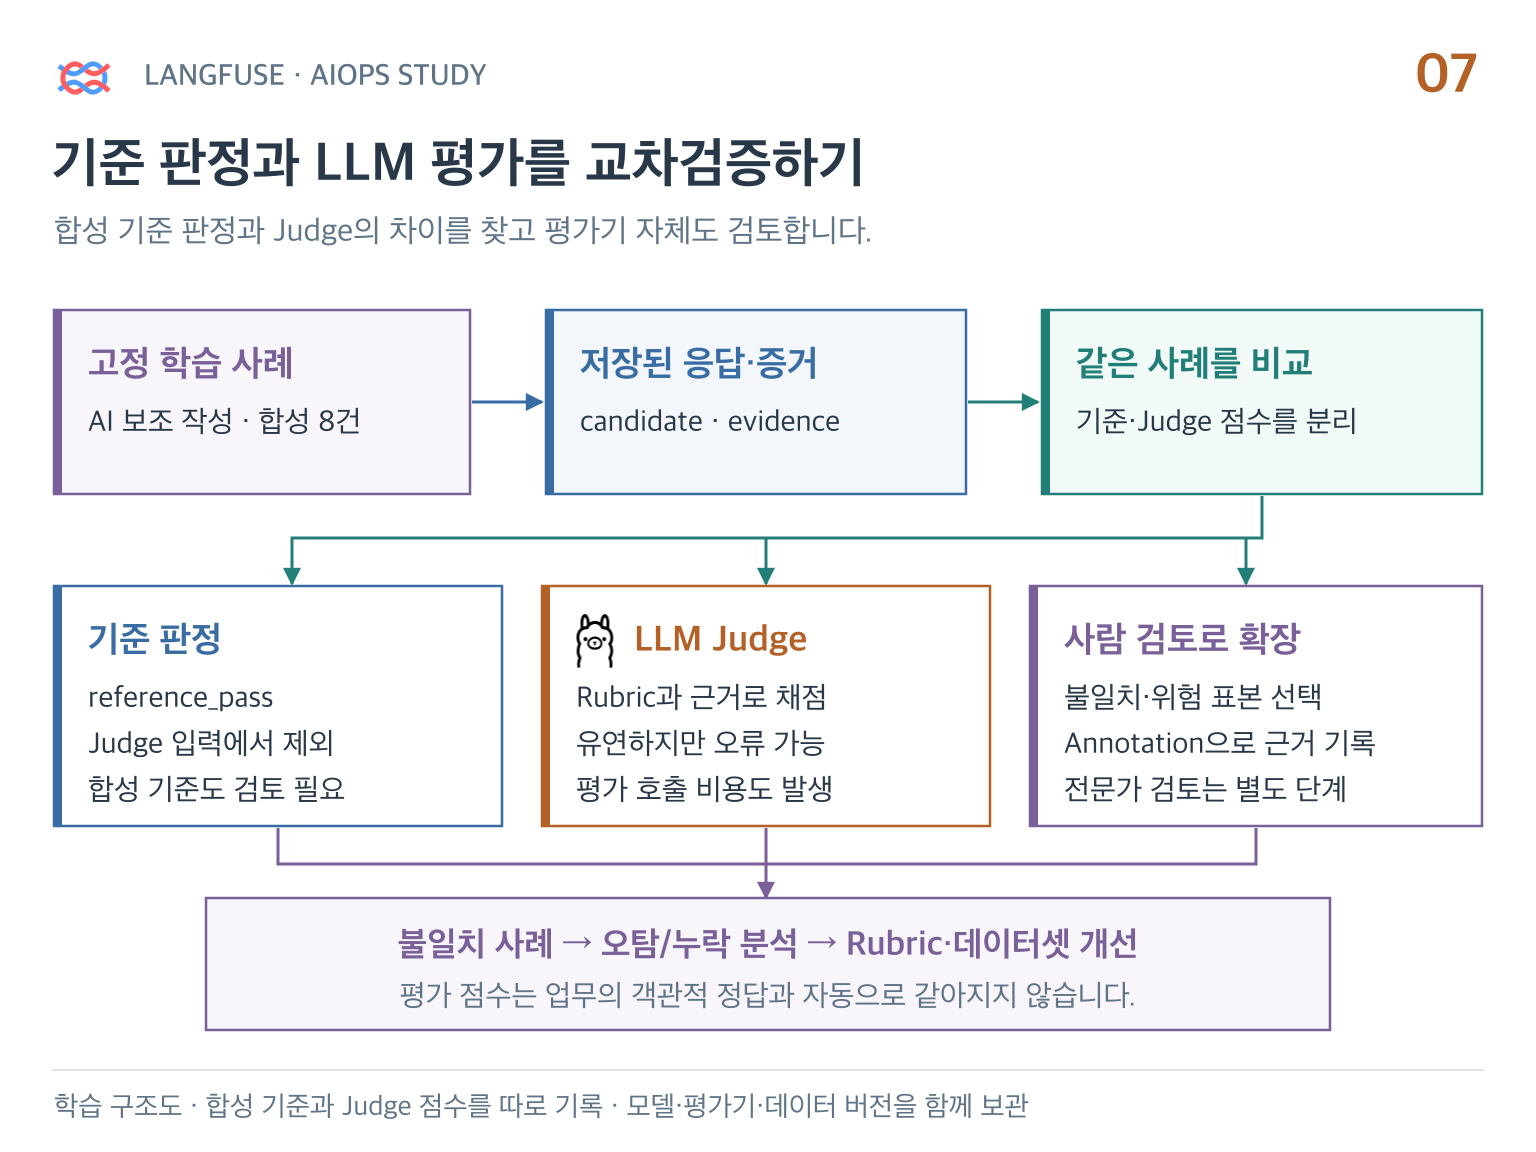
합성 기준과 로컬 Judge를 Score Analytics로 비교하고 Annotation Queue에서 검토 점수·근거를 저장합니다.
8.[Langfuse 8] 평가로 프롬프트 배포를 막고 롤백하기
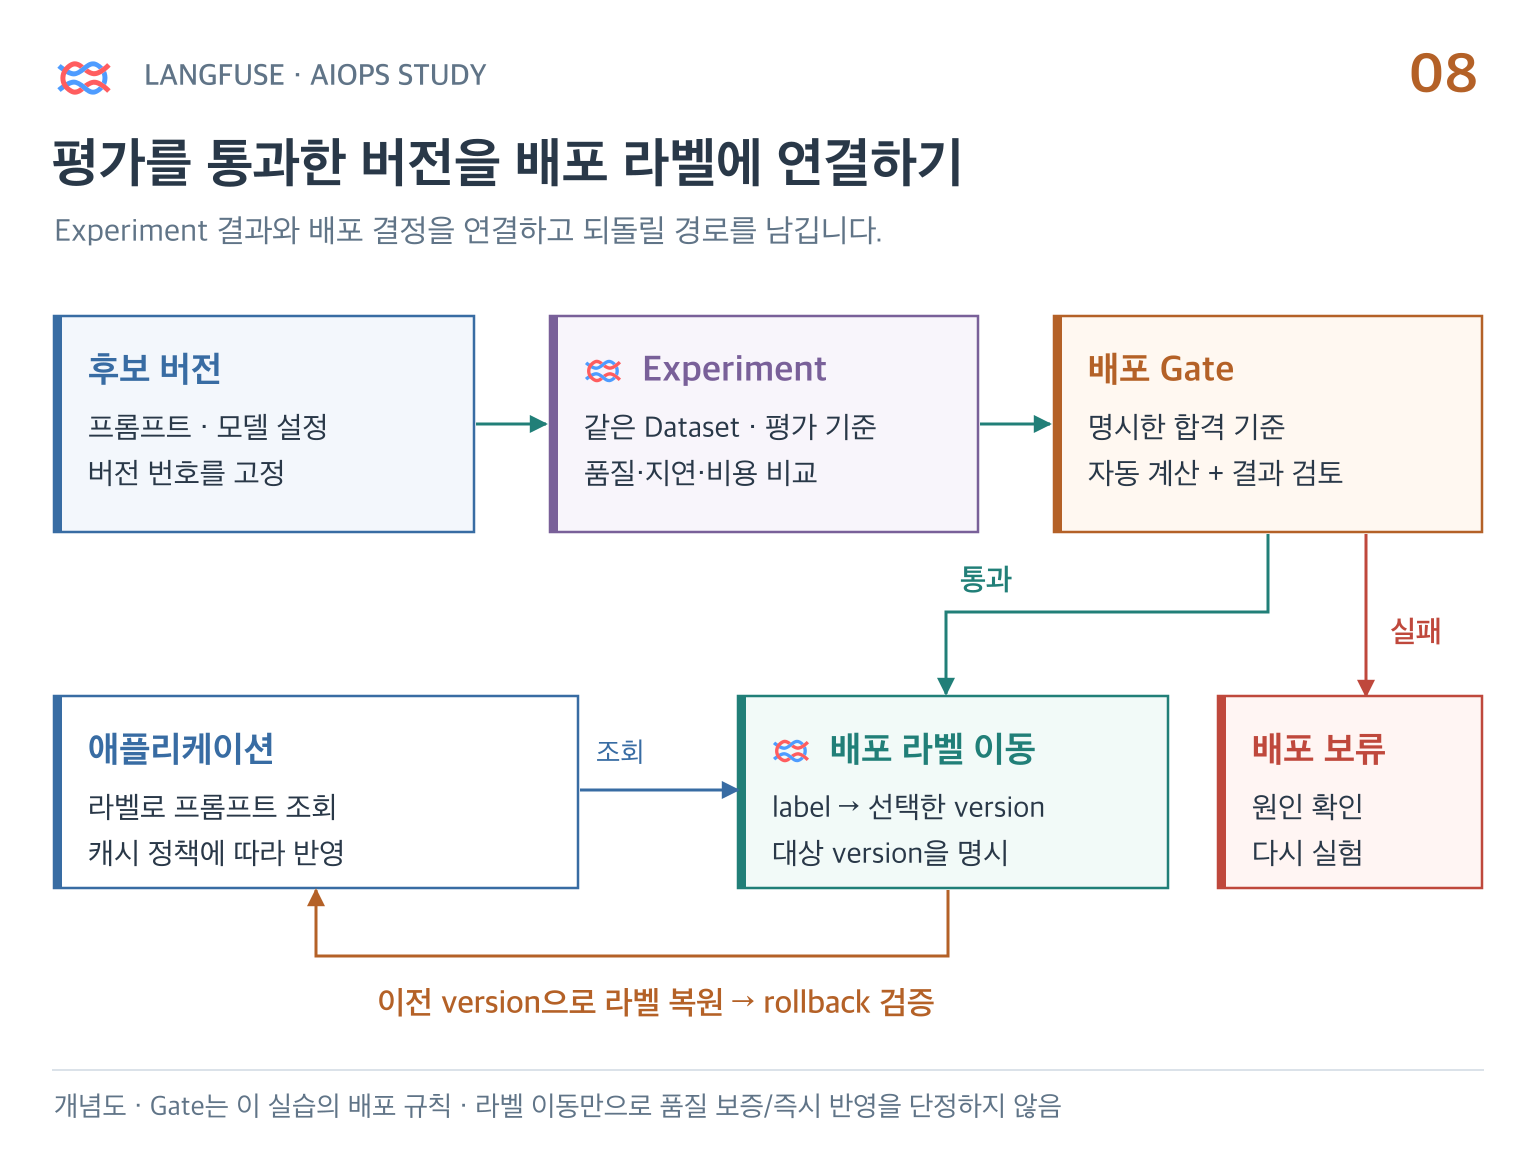
빠르고 저렴해도 품질이 나쁜 후보를 gate로 차단하고, 실습 라벨의 승격·롤백을 검증합니다.
9.[Langfuse 9] 온라인 평가·Alerts·실패 Dataset 연결하기
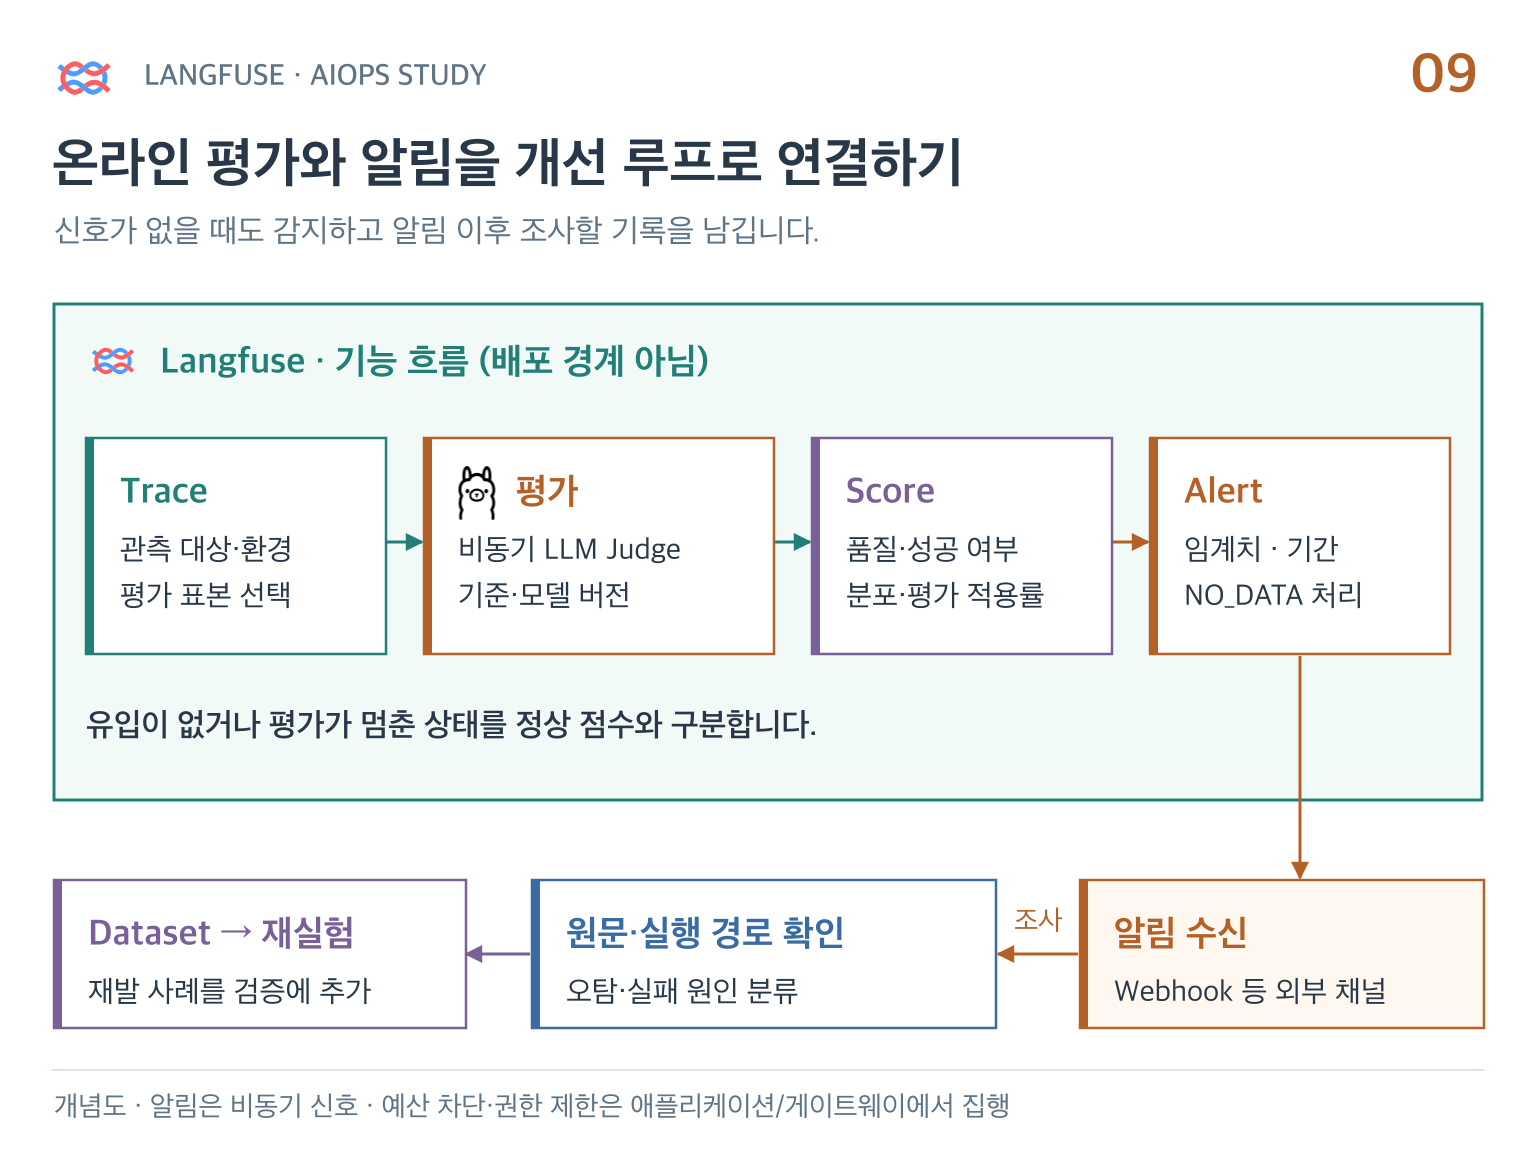
저장 결과의 사후 평가, native Alert와 서명된 HTTPS webhook, 실패 사례의 Dataset 연결을 실습합니다.
10.[Langfuse 10] 마스킹·수집 장애·백업으로 셀프호스팅 운영하기
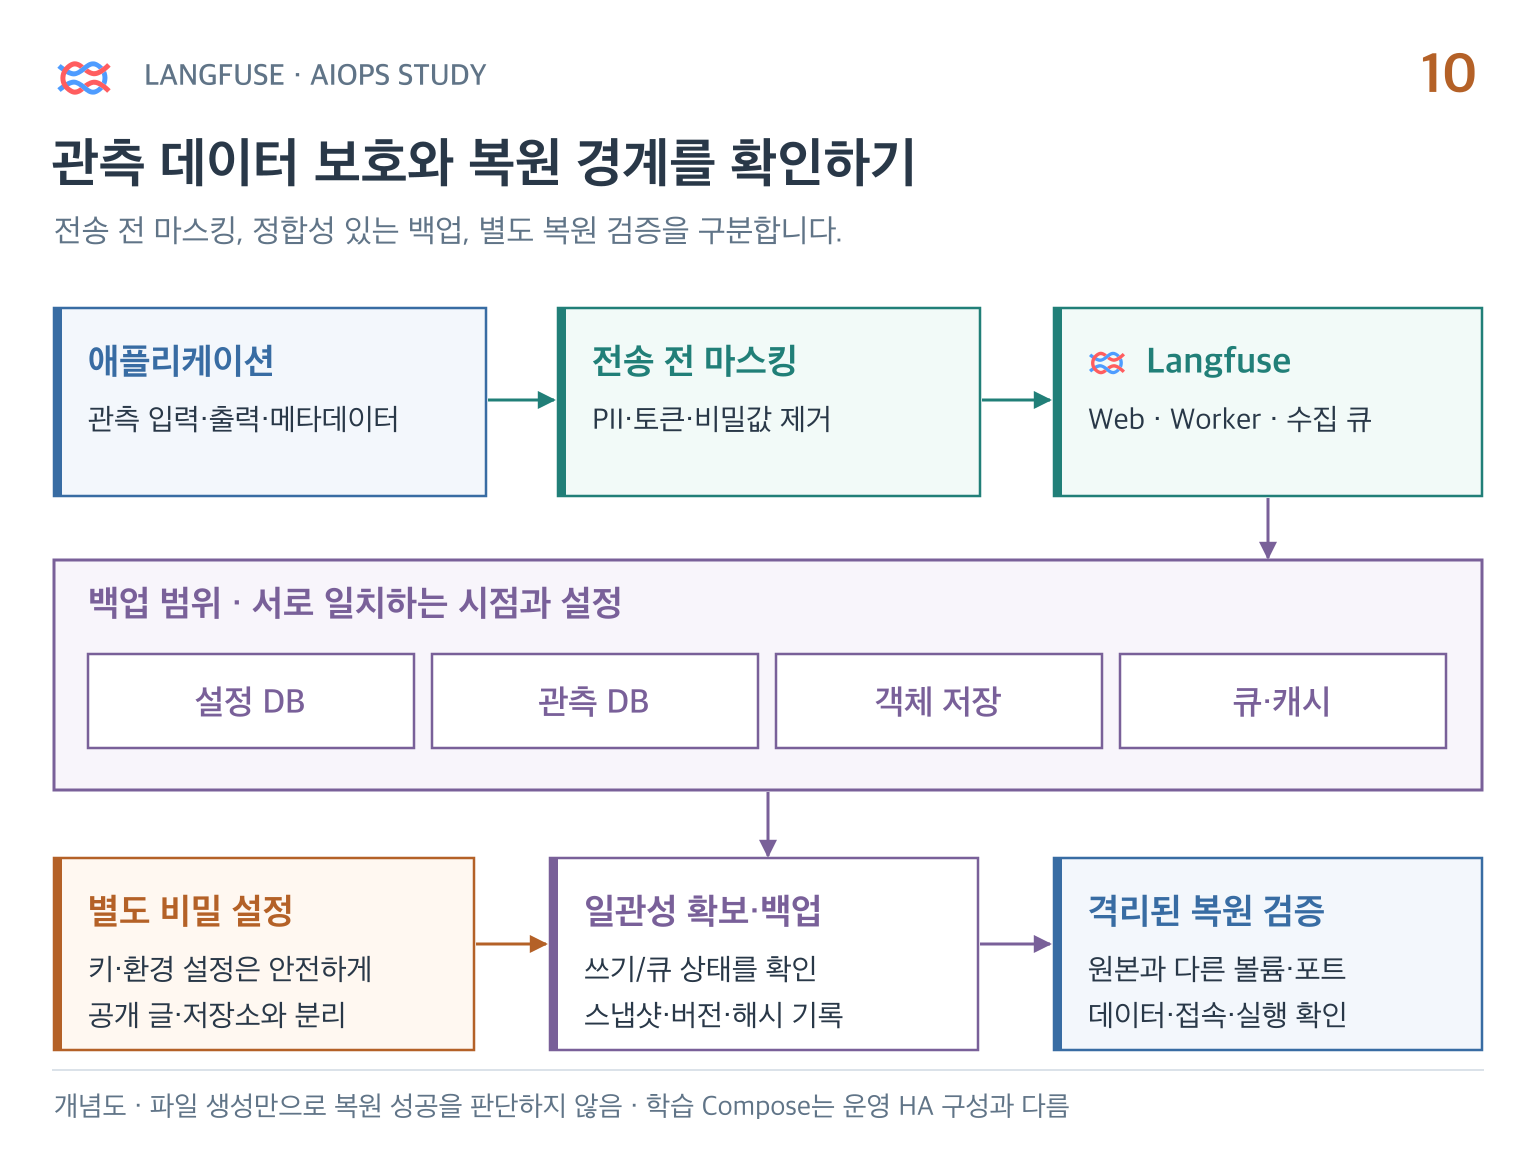
SDK 마스킹과 수집 실패를 확인하고, 비공개 백업에서 분리된 복원본의 Prompt·Trace·Score를 검증합니다.
11.[Langfuse 11] Qwen-Image-2.1의 생성 과정을 추적하기
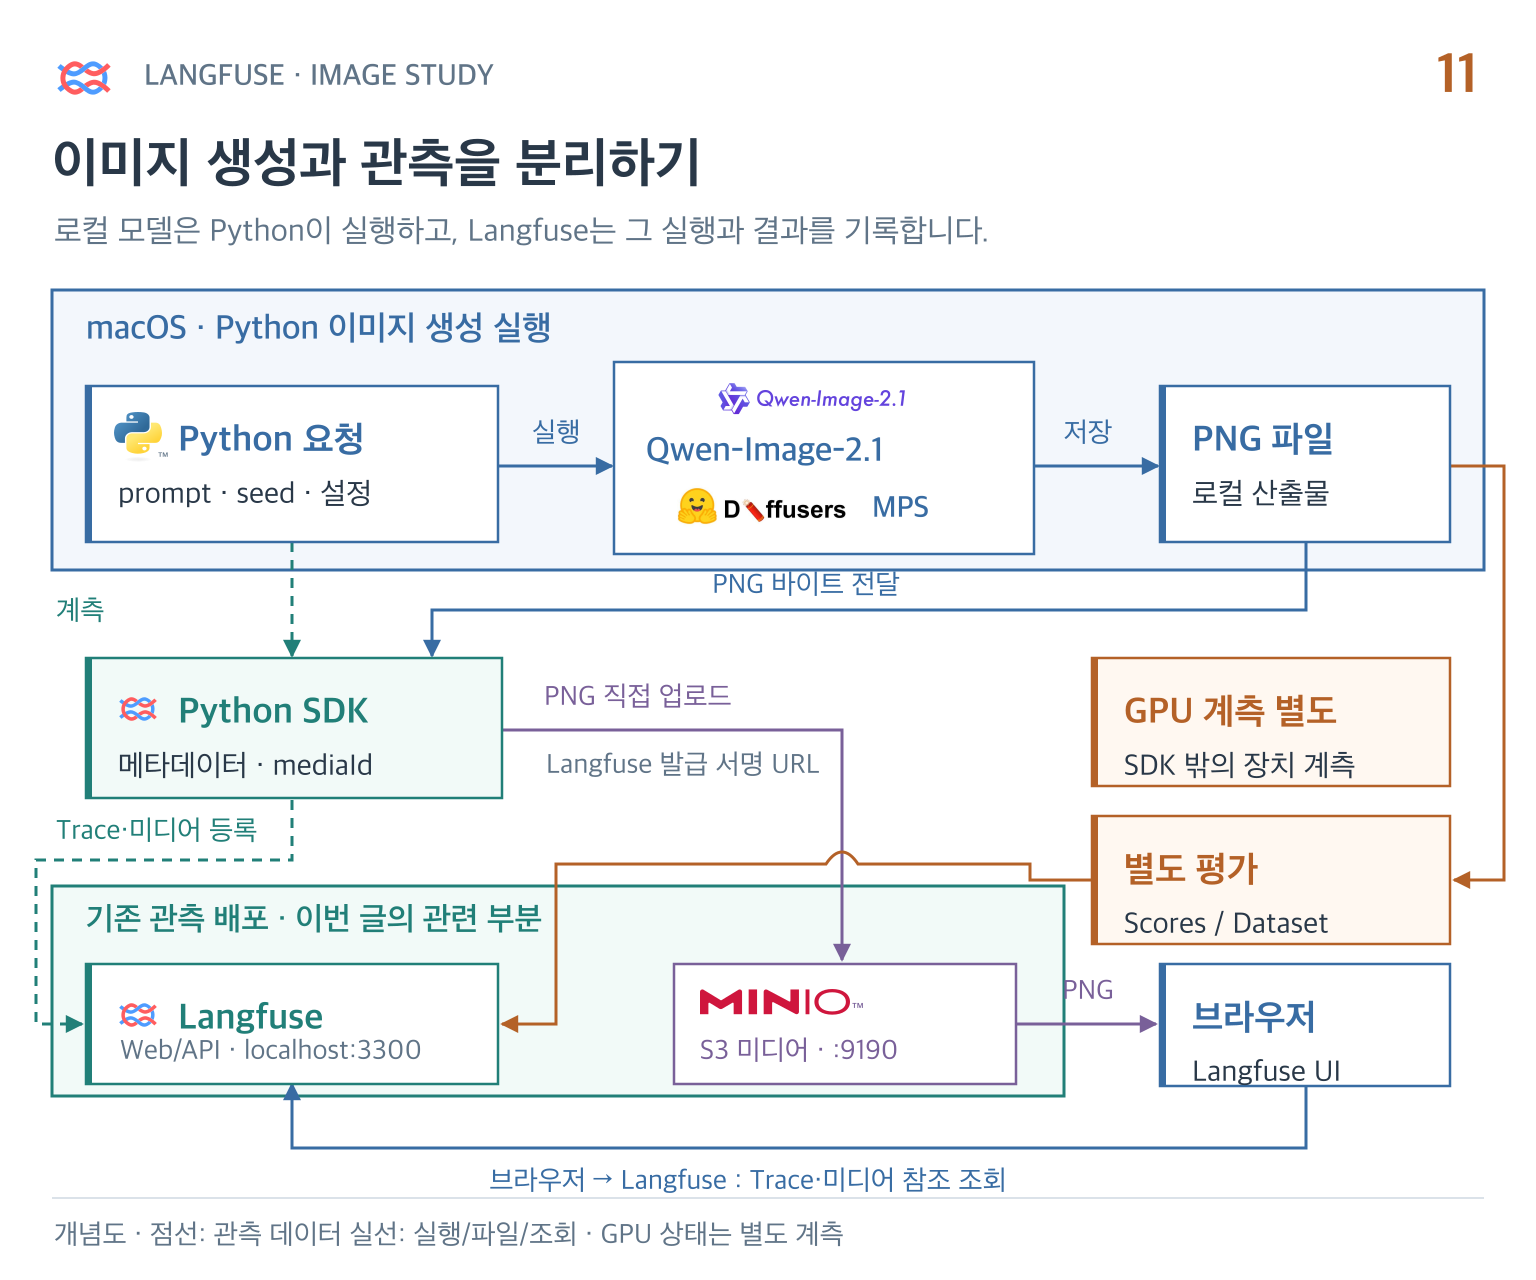
로컬 Qwen으로 영어·한글 포스터, 제품 사진풍, 서버실 일러스트를 생성하고 Prompt·설정·실제 PNG를 Langfuse에 기록합니다. 성공과 실패 사례를 함께 살펴봅니다.
12.[Langfuse 12] OCR과 Dataset으로 생성 이미지 품질 평가하기
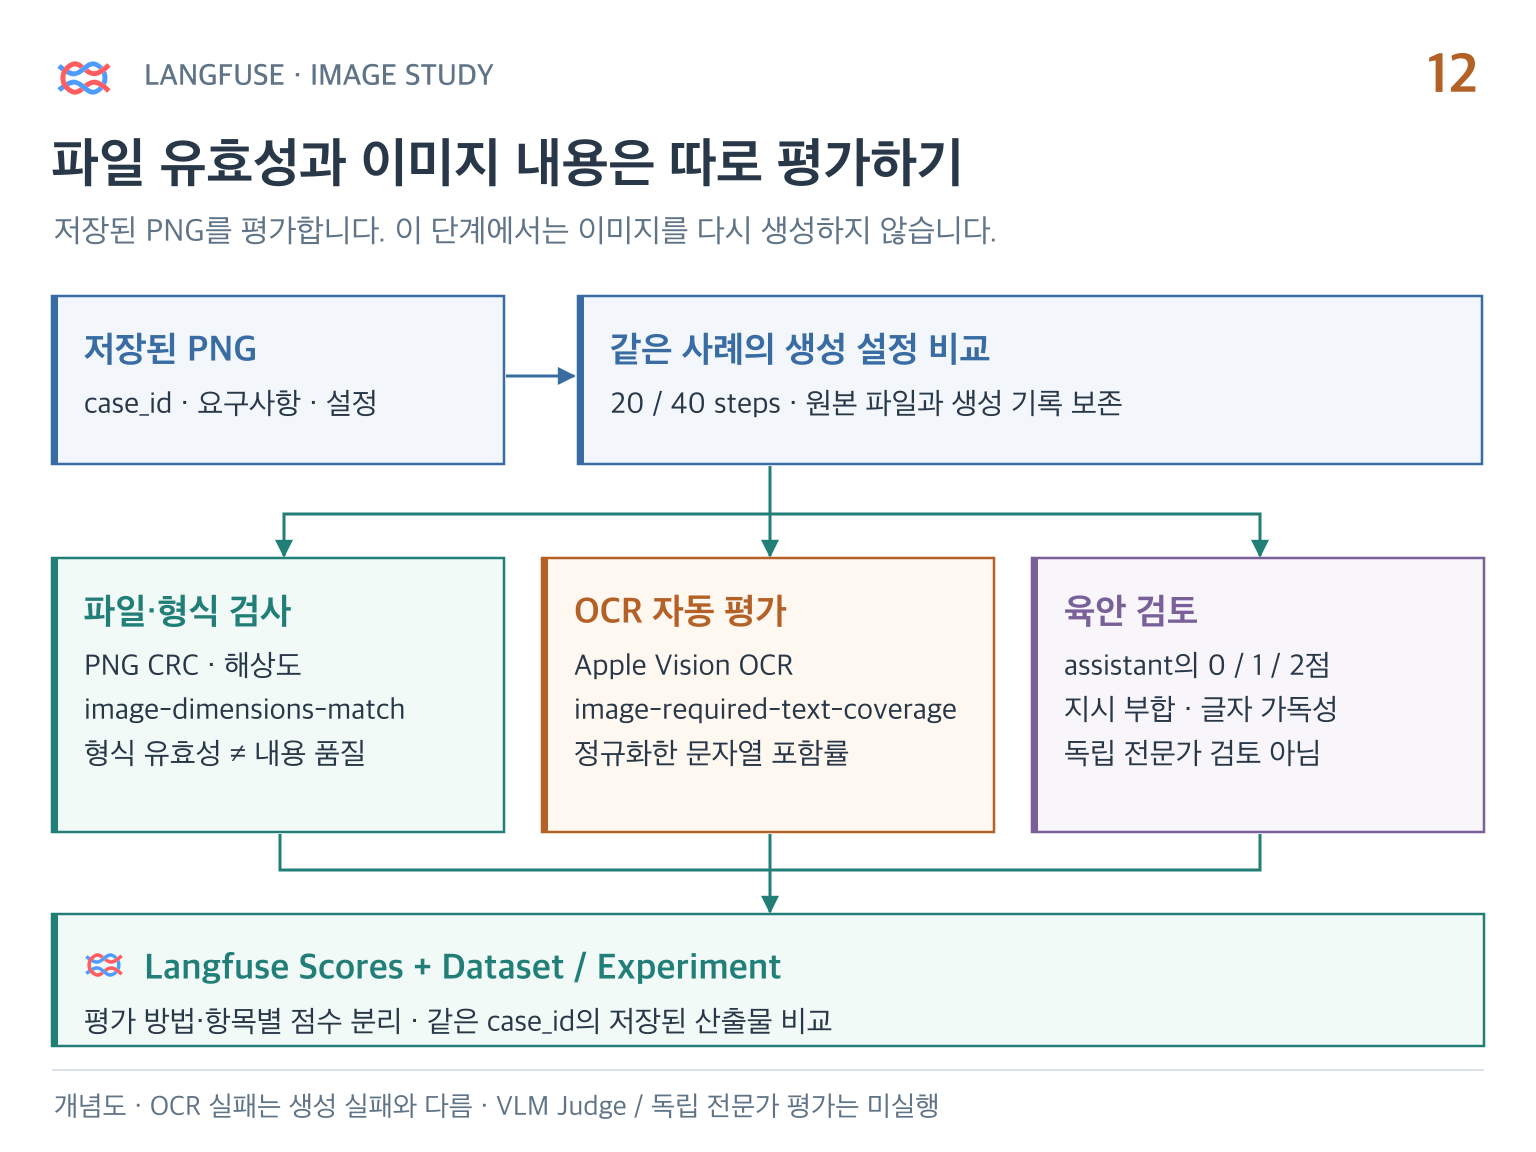
저장된 이미지를 파일 검사·OCR·명시적 시각 기준으로 평가하고, Dataset과 Experiment에서 생성 설정별 결과를 비교합니다.
13.[Langfuse 13] 이미지 생성 비용과 성능을 같은 기준으로 비교하기
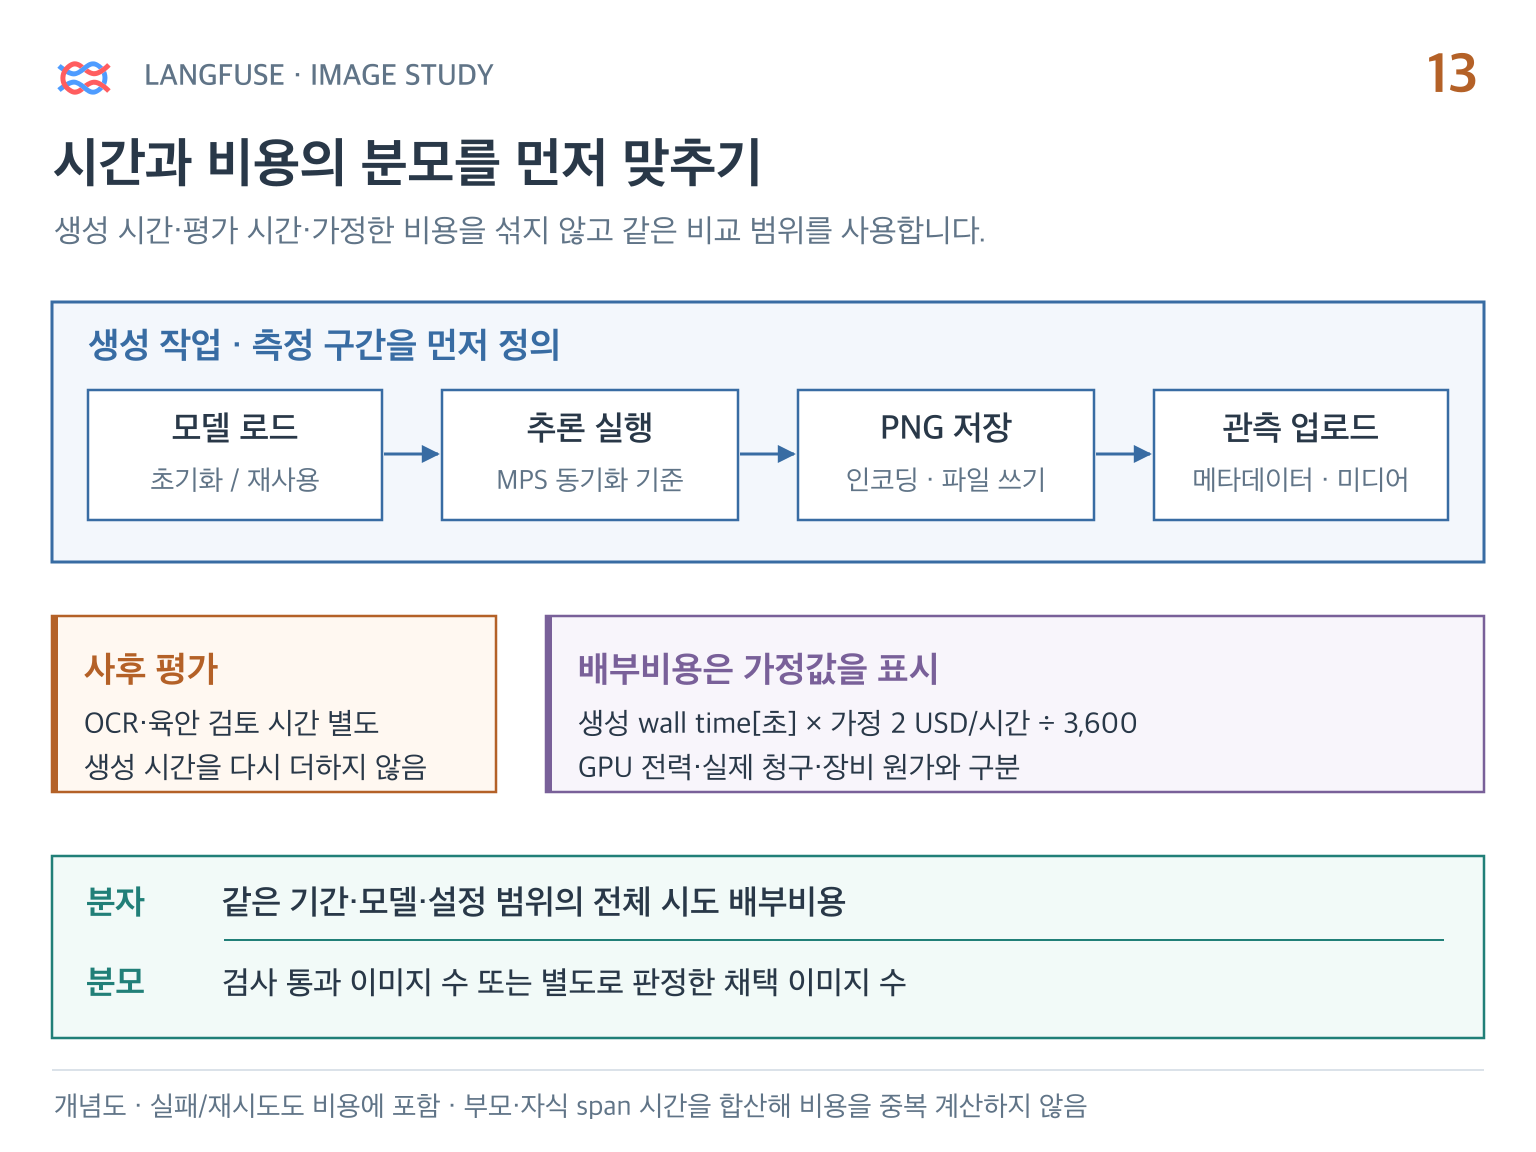
실제 생성 시간과 가정 배부비용을 구분하고, 호출·생성·채택 이미지의 분모를 맞춰 비용과 성능을 해석합니다.