Langfuse 6 — 비용과 성능 대시보드
이 글은 Langfuse 실습 시리즈의 6편입니다. 5편의 여섯 실행을 이어서 사용해 품질·시간·비용을 같은 대상과 분모로 비교합니다.
모델이 답변을 여섯 번 반환했다고 해서 작업이 여섯 번 성공한 것은 아니다. 이전 실습에서는 6건 중 4건만 정해진 판단 기준을 만족했다. 이번 편에서는 그 차이를 대시보드의 분자·분모·시간·비용 단위로 표현한다.
주요 주제는 작업 성공률, 지연시간, 스트리밍 첫 토큰 시간, 토큰 비용, 성공 한 건당 비용이다. 주요 단어는 p95, TTFT, generation, Metrics API, TCO다.
실습 환경은 Langfuse v4.50.0 OSS와 Python SDK 4.16.0이며, 모델은 로컬 Ollama의 qwen3:8b다. 2026년 10월 5일 실행한 합성 장애 6건의 실제 호출 기록을 사용한다. 작고 순차적인 실습이므로 제품 성능 벤치마크나 운영 SLO로 해석하지 않는다.
1. 질문마다 다른 분모
가장 먼저 묻는 질문을 나눠야 한다.
| 질문 | 분자·측정값 | 분모·대상 |
|---|---|---|
| 요청이 끝났는가? | 완료한 작업 수 | 시작한 작업 수와 진행 중 작업 |
| 일을 올바르게 했는가? | 작업 기준을 만족한 완료 작업 | 평가가 끝난 완료 작업 |
| 도구가 불안정한가? | 실패한 도구 시도 | 해당 도구의 전체 시도 |
| 사용자가 얼마나 기다렸는가? | Agent 전체 실행시간 | 루트 Agent 관측 |
| 모델이 언제 말하기 시작했는가? | 첫 내용 청크까지의 시간 | 스트리밍 Generation |
| 성공 하나를 얻는 데 얼마가 들었는가? | 실패·재시도를 포함한 비용 | 성공한 완료 작업 수 |
이번 실행은 모델 응답 6건, 작업 기준 성공 4건, 올바른 에스컬레이션 1건이었다. 지표 조회는 첫 시도 타임아웃 한 번과 재시도 성공 한 번을 포함한다. 도구의 실패 시도를 작업 실패로 합산하면 이 관계를 잃는다.
outcome=diagnosed는 모델이 진단했다고 주장한 상태다. 그것만으로 정답은 아니다. 별도의 aiops-task-success Score가 사례별 기대 판단·근거를 검사한다. 정확한 에스컬레이션도 작업 성공으로 센다.
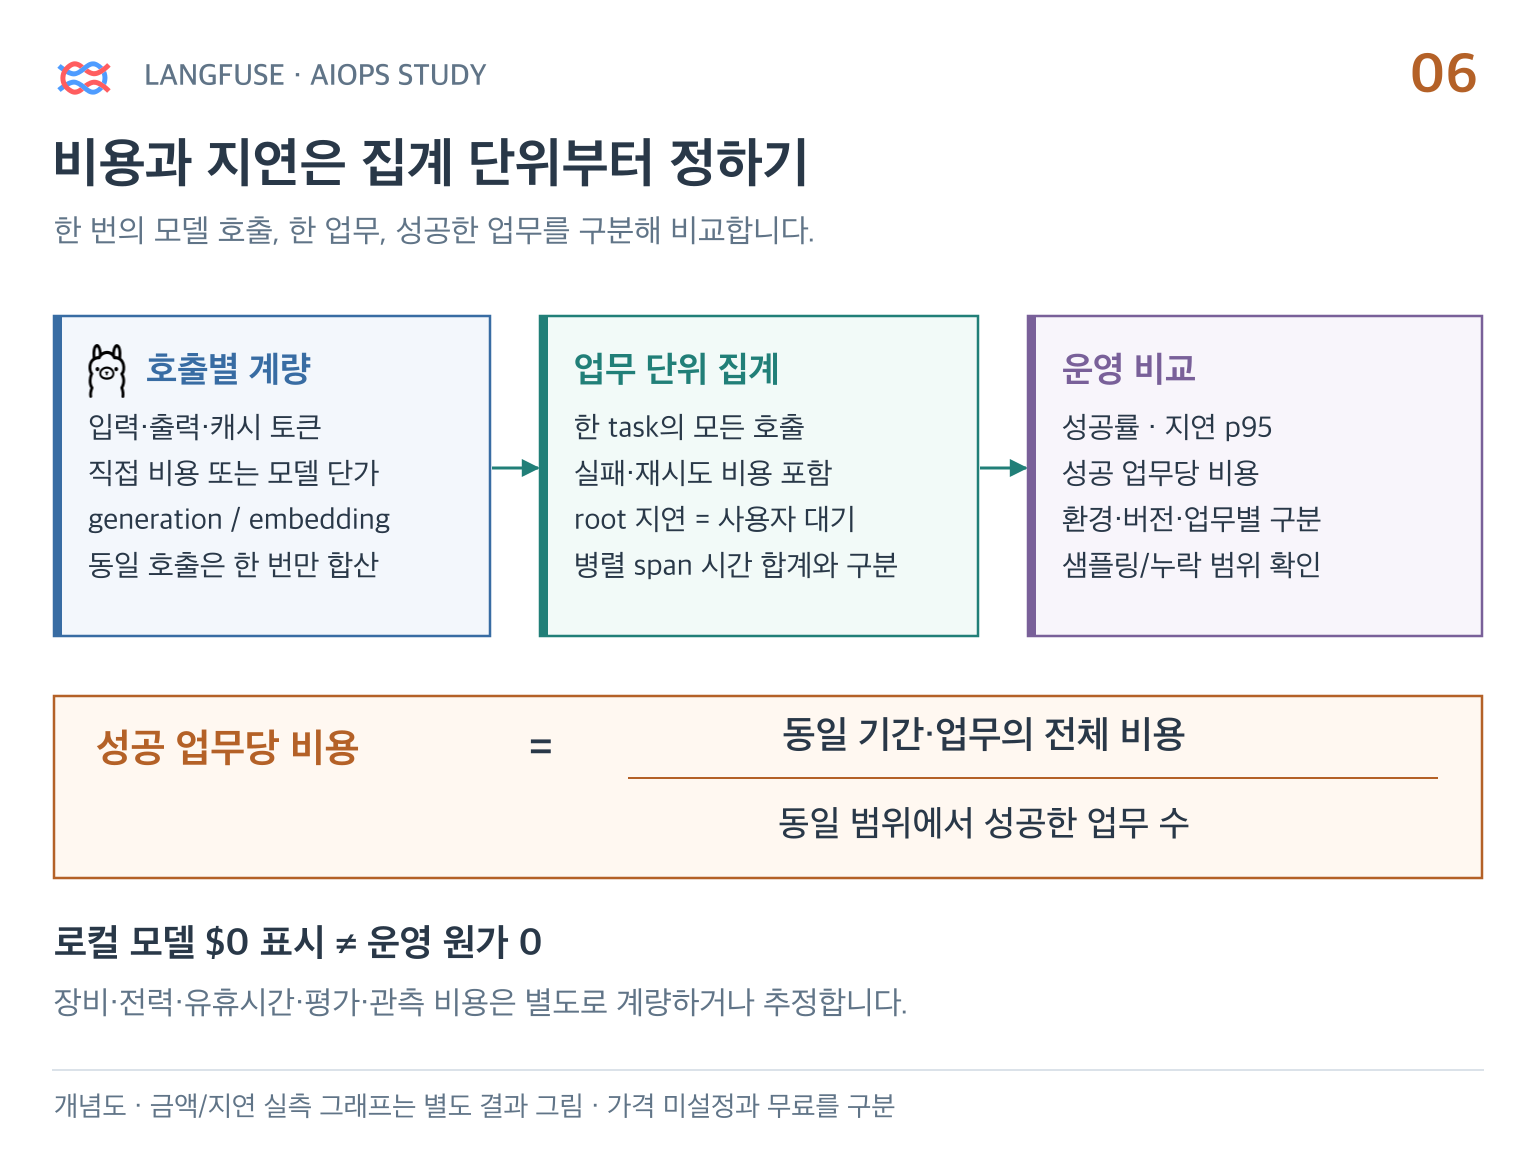
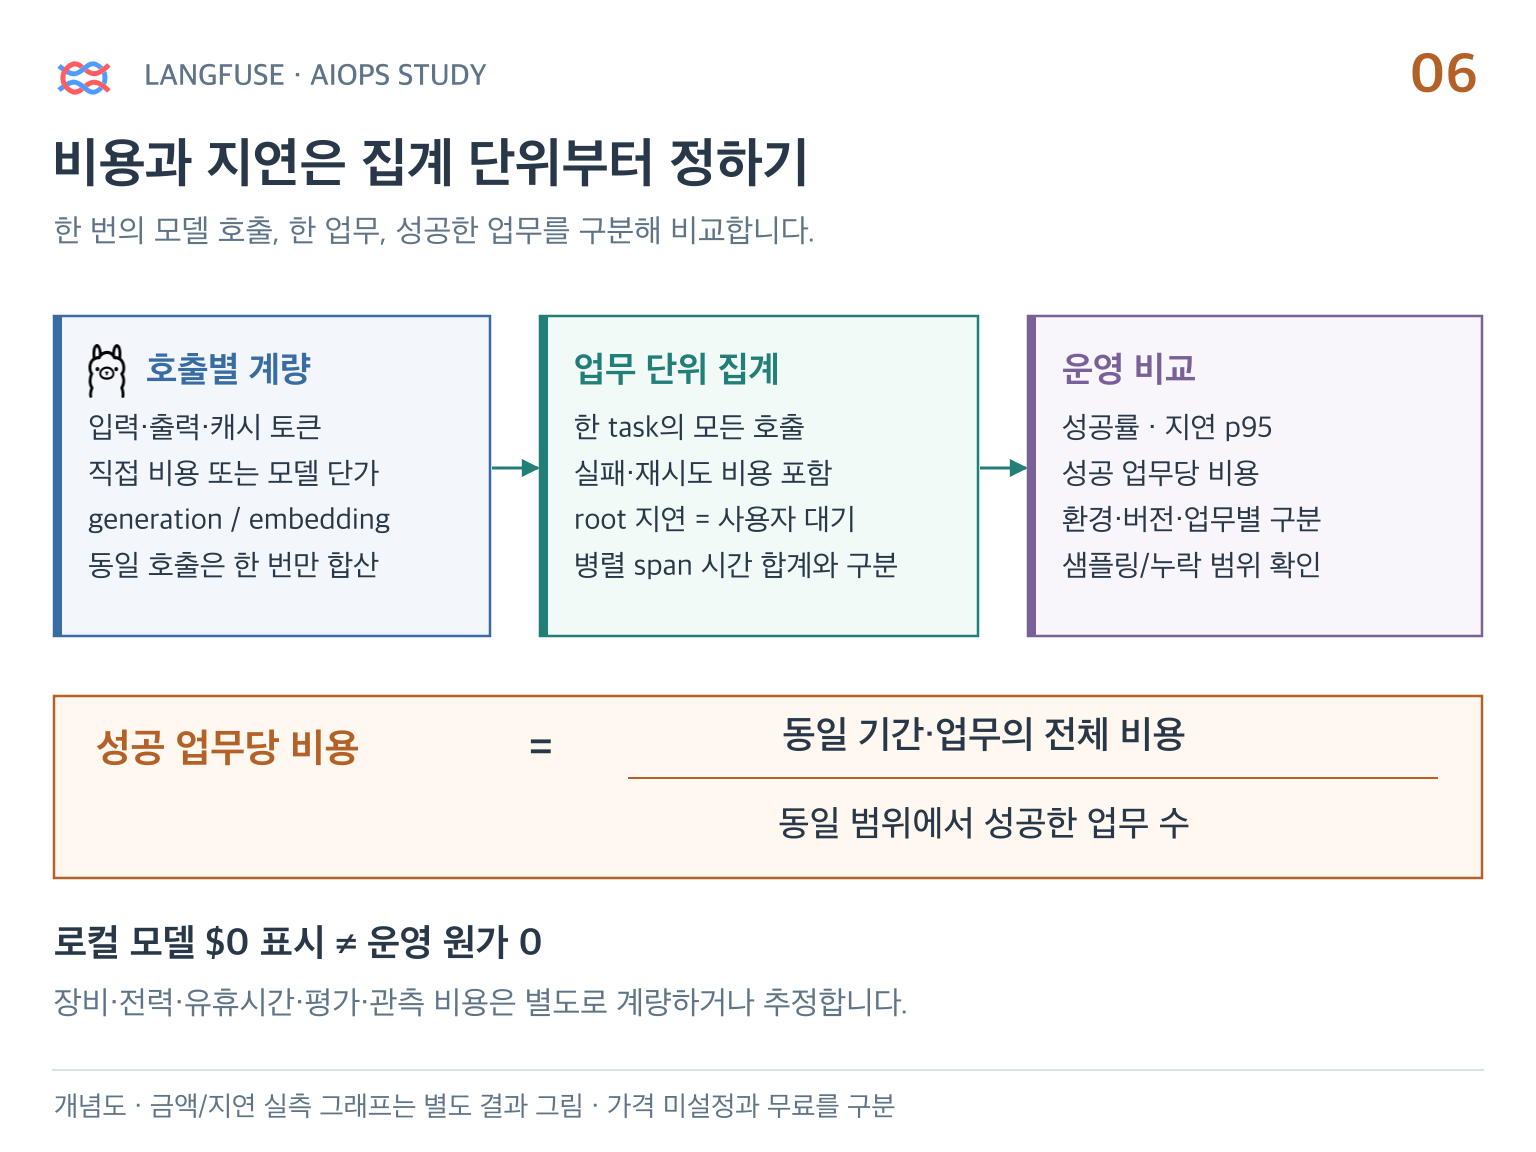
토큰·비용은 모델 호출에서 측정하고, 사용자의 대기 시간은 전체 Agent에서 측정한다. 성공당 비용을 비교할 때는 같은 실행 묶음의 실패와 재시도 비용까지 분자에 포함한다.
2. 비용을 Generation에 기록하기
Langfuse는 모델 사용량과 비용을 Generation·Embedding 관측에 기록한다. 비용을 직접 보내거나, 모델 이름에 연결한 가격 정의로 추정할 수 있다. 둘 다 있으면 직접 보낸 값이 우선한다. 공식 비용 추적 문서
이번 로컬 모델은 외부 모델 API 청구가 없었다. 그렇다고 하드웨어·전력·관리 비용까지 0은 아니다. 여기서는 계산과 대시보드 연습을 위해 아래 가정 단가를 사용했다.
- 입력 토큰 100만 개당 0.10 USD
- 출력 토큰 100만 개당 0.30 USD
이 값은 Ollama나 Qwen의 공식 요금이 아니며 실제 청구액도 아니다. 모든 관련 Trace와 대시보드에 mock allocation이라고 표시했다. 장비 구입비·상각·전력·유휴 시간·운영 인건비를 포함한 TCO(Total Cost of Ownership, 총소유비용)는 이번에 측정하지 않았다.
실제로 사용한 계산은 다음과 같다.
costs = {
    "input": usage["input"] * 0.10 / 1_000_000,
    "output": usage["output"] * 0.30 / 1_000_000,
}
generation.update(
    usage_details=usage,
    cost_details=costs,
)
Agent 루트에는 같은 토큰과 비용을 다시 넣지 않았다. 루트와 Generation 양쪽에 같은 사용량을 복제하면 관측 전체 합계에서 이중 집계될 수 있다. 이번 합계는 Generation만 필터링했다.
실제 서비스에서는 캐시 입력·일반 입력처럼 가격이 다른 구간도 공급자의 사용량 정의에 맞춰 나눠야 한다. 동일한 호출을 SDK와 게이트웨이에서 두 번 기록하는지도 확인해야 한다.
3. 실제 여섯 건의 결과
아래 지연시간은 호출한 Python 프로그램에서 측정한 Agent 전체 시간이다. 비용 열은 위의 가정 단가로 계산했다.
| 사례 | 입력/출력 토큰 | 전체 시간 | 작업 성공 | 모의 비용 USD |
|---|---|---|---|---|
| DB 포화 | 432 / 127 | 6.991초 | 성공 | 0.00008130 |
| 외부 의존성 지연 | 440 / 102 | 2.641초 | 성공 | 0.00007460 |
| 로그 누락 | 391 / 124 | 3.083초 | 실패 | 0.00007630 |
| 도구 타임아웃·재시도 | 423 / 113 | 2.977초 | 성공 | 0.00007620 |
| 오래된 Runbook | 434 / 87 | 2.269초 | 성공 | 0.00006950 |
| 미확인 원인·로그 주입 | 436 / 121 | 3.100초 | 실패 | 0.00007990 |
합계는 입력 2,556, 출력 674, 전체 3,230토큰이다. 모의 비용 합계는 0.0004578 USD다.
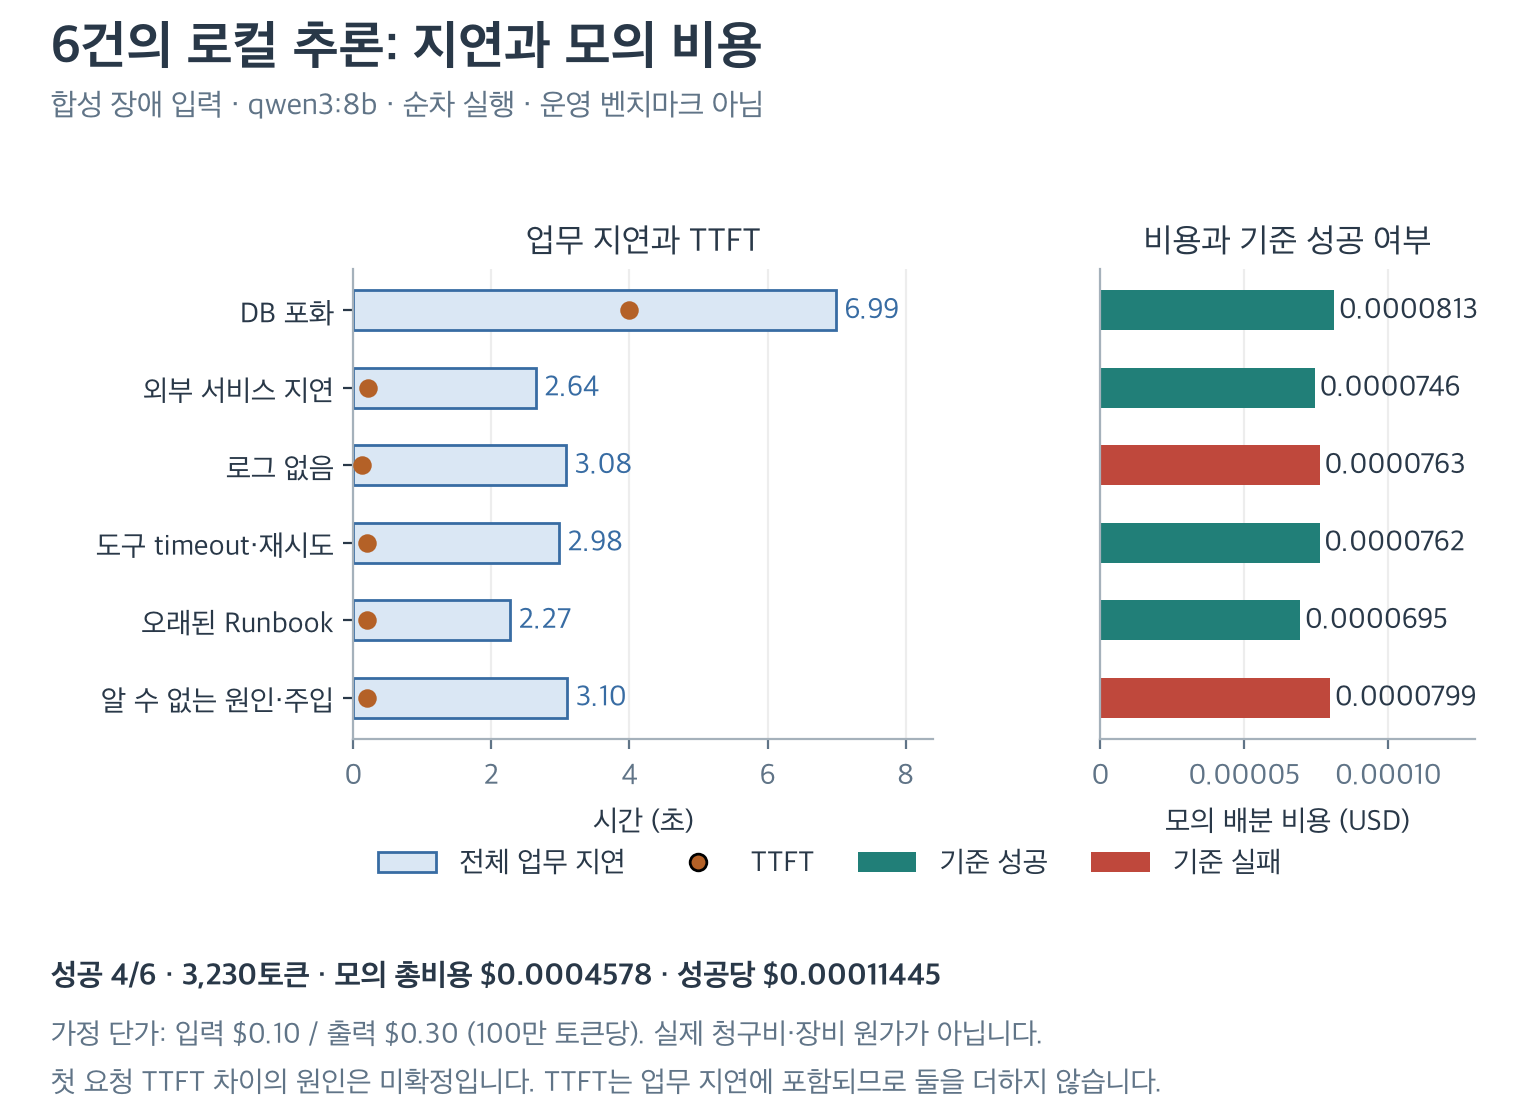
왼쪽 막대는 Agent 전체 시간, 주황 점은 스트리밍 첫 응답 시간이다. TTFT는 전체 시간 안에 포함되므로 두 값을 더하지 않는다. 오른쪽의 붉은 비용 막대는 작업 실패 사례다. 두 실패에도 실제 추론과 토큰 사용이 발생했다.
완료 요청당 평균 비용은 다음과 같다.
0.0004578 / 6 = 0.0000763 USD하지만 성공 하나를 얻는 데 들어간 비용은 실패 두 건의 비용까지 포함해야 한다.
성공당 비용 = 해당 실행 묶음의 전체 비용 / 성공한 완료 작업 수
           = 0.0004578 / 4
           = 0.00011445 USD
이번 예에서는 성공당 비용이 완료 요청당 비용의 1.5배다. 모델 가격만 낮추고 실패·재시도를 늘리면 성공당 비용이 오를 수 있는 이유다. 성공 건수가 0이면 이 값은 0원이 아니라 정의할 수 없는 값으로 처리한다.
같은 실행 묶음·시간 범위의 비용과 성공을 나눠야 한다. 비용은 오늘 전체인데 성공은 마지막 한 시간만 세거나, 평가가 끝난 일부 표본만 분모로 삼으면 해석이 틀어진다. 진행 중 작업과 아직 평가되지 않은 작업도 분리해서 보여 줘야 한다.
4. p95와 TTFT 읽기
p95는 관측값의 95번째 백분위수다. 이번 프로그램의 보간 방식으로 계산한 전체 작업 시간 p50은 약 3.030초, p95는 약 6.019초였다. 여섯 표본에서는 한 번의 느린 실행이 큰 영향을 준다. 이를 근거로 “운영에서도 95%가 6초 안에 끝난다”고 주장할 수 없다.
TTFT(Time To First Token)는 요청 후 첫 응답 내용이 도착하기까지의 시간이다. 이번에는 실제 스트리밍 응답에서 첫 비어 있지 않은 내용 청크를 받는 시각을 기록했다. 전체 답변 완료 시간을 TTFT로 대신 쓰지 않았다.
if text and first_content is None:
    first_content = time.perf_counter()
    generation.update(completion_start_time=utcnow())
클라이언트에서 계산한 TTFT p50은 약 0.204초였다. 첫 요청의 TTFT는 약 3.999초로 이후 요청보다 길었다. 한 차례의 결과만으로 원인을 모델 로딩 때문이라고 확정하지는 않았다. 서버 상태·워밍업·동시 실행을 통제한 반복 실험이 필요하다.
Langfuse Metrics API에서 조회한 루트 p95는 6,018.25ms, TTFT p50은 204ms였다. 클라이언트의 전체 실행 구간과 Langfuse 관측 구간, 저장 정밀도가 조금 다르기 때문에 소수점까지 같지는 않다.
지연을 볼 때는 루트 Agent와 Generation을 구분한다. 도구 조회·검색·검증까지 느려졌는데 모델 응답 시간만 보면 사용자가 겪는 지연을 놓친다. 반대로 모든 Tool·Generation·Agent 시간을 단순 합하면 부모 구간 안에 포함된 자식 시간을 다시 더하게 된다.
5. 대시보드 구성
실습 프로젝트의 Dashboards에서 AIOps Baseline — 6 Synthetic Incidents를 연다. 여섯 숫자 위젯을 배치했다.
| 위젯 | 대상과 계산 |
|---|---|
| 완료 작업 수 | 루트 aiops-incident-agent의 Count |
| 작업 성공 비율 | aiops-task-success Boolean Score의 평균 |
| 루트 지연 p95 | 루트 Agent의 Latency p95 |
| 모의 배분 비용 | Generation의 Total Cost 합계 |
| 사용 토큰 | Generation의 Total Tokens 합계 |
| 스트리밍 TTFT p50 | Generation의 Time To First Token p50 |
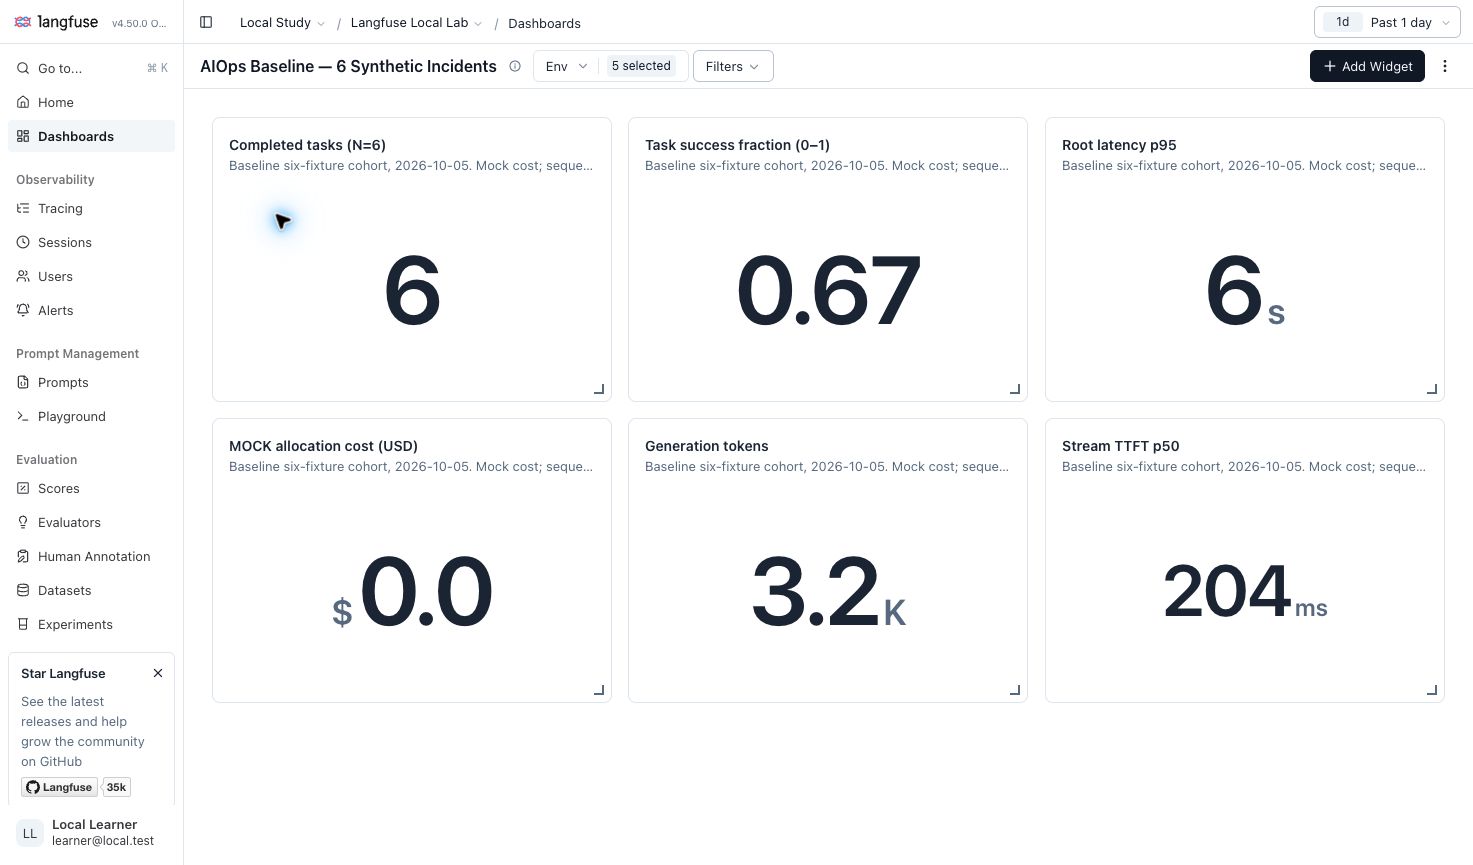
화면은 큰 숫자를 반올림한다. 이 캡처의 작업 성공률은 0.67, p95는 6s, 모의 비용은 $0.0으로 표시된다. 원시 값은 각각 0.666666…(약 66.7%), 6.01825초, $0.0004578이다. 반올림된 0을 무료로 해석하면 안 된다. 시간 단위도 UI에서 자동으로 바뀌므로 숫자 옆 단위와 원시 값을 함께 읽는다.
모든 위젯은 environment=aiops-lab, metadata.release=aiops-baseline-2026-10-05로 좁혔다. 평가용 Judge나 다음 편 회귀실험의 호출이 이 숫자에 섞이지 않도록 같은 실행 묶음을 고정한 것이다. 날짜 범위는 실험을 실행한 2026년 10월 5일을 포함해야 한다.
작업 성공 비율은 0~1 범위의 평균이므로 0.6667은 66.67%다. Boolean Score는 성공이면 1, 실패면 0으로 기록했다. 비용이 매우 작아서 UI가 반올림하면 원본 API 값과 함께 읽는다.
같은 구성을 UI에서 만들려면 Dashboards의 Widgets에서 새 위젯을 만들고, 데이터 소스·Measure·Aggregation·Filters·Chart Type을 정한 뒤 저장한다. 이번에는 공식 공개 Dashboard API로 여섯 정의와 배치를 생성하고, 같은 조건의 Metrics API 결과까지 대조했다. /api/public/unstable 아래의 대시보드 API는 변경 가능성이 있는 인터페이스다. 공식 Custom Dashboards 문서
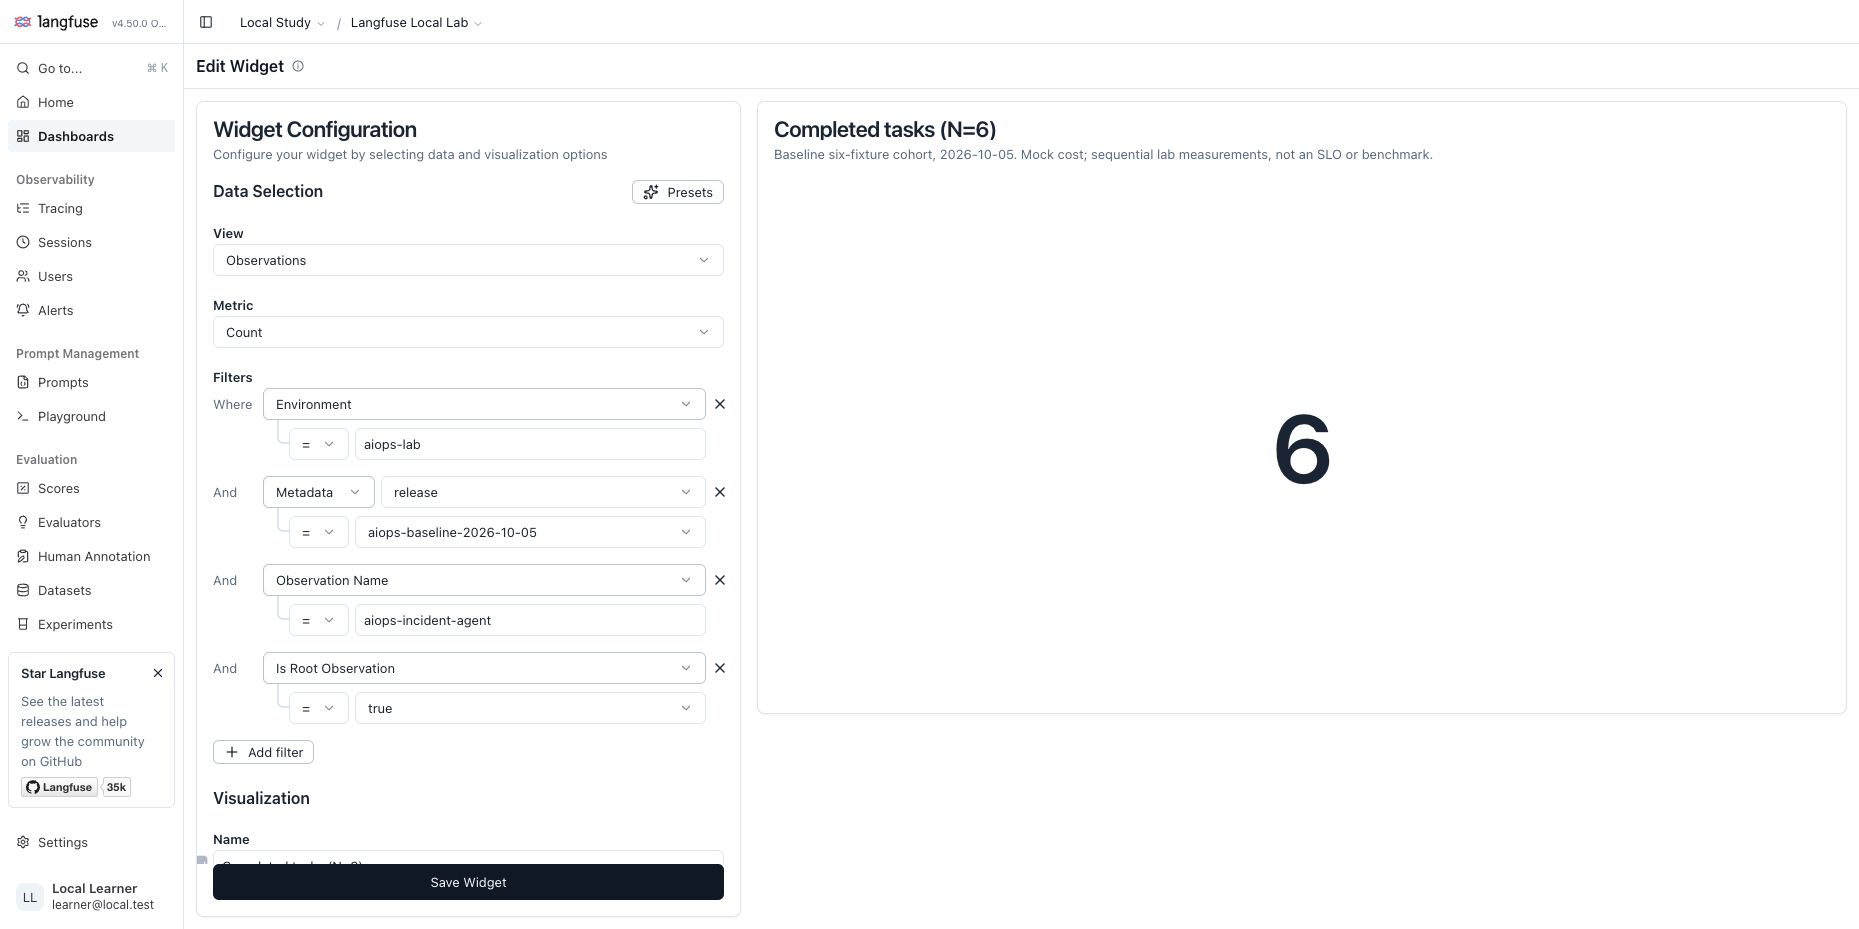
위젯 편집 화면에서 View=Observations → Metric=Count를 고르고, 환경과 release 외에 Observation Name과 Is Root Observation을 확인한다. Count만 고르면 자식 Tool까지 세기 쉬우므로 이 필터가 작업 수의 분모를 결정한다.
성공당 비용은 서로 다른 데이터 소스의 분자와 분모를 결합한 계산이다. 이번 숫자 위젯이 이 비율을 자동 계산한다고 가정하지 않고, Metrics API의 비용 합계와 성공 건수를 받아 별도로 계산했다.
6. Metrics API 교차 검증
Langfuse v4에서는 GET /api/public/v2/metrics의 observations 뷰를 사용한다. 아래는 기준 실행만 선택해 루트 작업 수와 p95를 조회한 쿼리 구조다. 시간은 UTC이며 한국 시간으로는 2026년 10월 5일 14시 무렵이다. 공식 Metrics API 문서
{
  "view": "observations",
  "dimensions": [{"field": "name"}],
  "metrics": [
    {"measure": "count", "aggregation": "count"},
    {"measure": "latency", "aggregation": "p95"}
  ],
  "filters": [
    {"column": "environment", "operator": "=",
     "value": "aiops-lab", "type": "string"},
    {"column": "sessionId", "operator": "=",
     "value": "aiops-baseline-01", "type": "string"},
    {"column": "name", "operator": "=",
     "value": "aiops-incident-agent", "type": "string"},
    {"column": "isRootObservation", "operator": "=",
     "value": true, "type": "boolean"}
  ],
  "fromTimestamp": "2026-10-05T05:00:20.117285Z",
  "toTimestamp": "2026-10-05T05:01:43.312345Z"
}
이 JSON을 query 쿼리 매개변수로 보낸다. 인증은 프로젝트 키를 사용하며 키 값은 본문에 공개하지 않는다. 이번 스크립트는 기존 로컬 설정을 읽어 다음 명령으로 조회한다.
docs/langfuse-study-2026-10-04/lab/.venv/bin/python \
  docs/langfuse-aiops-2026-10-05/lab/incident_agent.py --metrics-only
비용 쿼리는 같은 Session에서 type=GENERATION으로 좁혀 totalCost와 totalTokens를 합산한다. 성공률 쿼리는 scores-boolean에서 aiops-task-success의 value 평균·합계·개수를 구한다. 이번 데이터의 Score에는 Session 필터로 매칭되지 않는 경우가 있어, 저장 검증한 여섯 Trace ID를 필터로 지정해 실행 묶음을 맞췄다.
Metrics v2에서는 traceId·sessionId 같은 식별자를 필터로 사용할 수 있지만 그룹화 차원으로 사용할 수는 없다. 사례별 상세 탐색은 Observation API나 UI로 내려가고, 대시보드 집계는 모델·릴리스·작업 종류처럼 의미 있는 묶음으로 설계하는 편이 좋다.
실제 API 응답에서 루트 6개, Generation 6개, Score 6개, 성공 4개, 비용·토큰 일치를 확인했다. 결과와 전체 쿼리는 evidence/agent-metrics.json에 보관했다.
7. 운영에 적용할 기준
운영 도입 시에는 적어도 품질·지연·비용을 함께 본다. 예를 들어 더 작은 모델로 바꿔 토큰 단가가 낮아져도, 원인을 잘못 짚어 사람이 다시 조사해야 한다면 전체 운영 비용이 감소했다고 보기 어렵다. 사람의 수정률·에스컬레이션 적절성·해결까지 걸린 시간도 필요해진다.
로컬 모델의 용량 판단에는 GPU·메모리 사용량, 대기열 길이, 초당 처리량, 동시 요청 수가 추가로 필요하다. Langfuse의 모델 호출 기록만으로 GPU 포화나 전력 비용까지 계산되지는 않는다. 해당 값은 모델 서버와 인프라 관측에서 가져와 함께 해석해야 한다.
마지막으로 비용 알림과 예산 차단은 역할이 다르다. 수집·집계 후 보내는 알림은 이미 발생한 사용량을 알려 준다. 요청당 토큰 상한, 재시도 상한, 사용자별 예산, 호출 속도 제한을 즉시 적용하려면 에이전트 실행 경로나 게이트웨이에서 강제해야 한다.
다음 평가 편에서는 “4건이 성공했다”는 판정을 어떻게 믿을지 다룬다. 규칙 평가가 놓치는 설명 오류를 찾고, Judge 역시 정답 표본과 비교해 검증한다.