Langfuse 11 — Qwen-Image-2.1의 생성 과정을 추적하기
이 글에서 다룰 주제
- 이미지 생성 모델을 Langfuse에 연결할 때 실행과 관측이 어떻게 나뉘는지 이해한다.
- 프롬프트·seed·steps·체크포인트를 같은 Generation에 기록한다.
- 생성한 PNG를 실제 Trace 화면에서 열고, 이미지 저장 경로를 확인한다.
- 영어·한글 포스터, 제품 사진풍, 서버실 일러스트의 프롬프트와 결과를 비교한다.
주요 단어 · 멀티모달 · Generation · Diffusers · MPS · seed · 미디어 참조
텍스트 에이전트를 관측할 때는 질문과 답변을 읽으면 된다. 이미지 생성에서는 프롬프트가 같아도 seed, 해상도, 추론 단계 수가 달라지면 결과가 달라진다. “파란 배경의 포스터를 만들었다”는 로그만으로는 실패한 글자가 어떤 설정에서 나왔는지 찾기 어렵다.
이번 글은 Qwen-Image-2.1의 실행 조건과 생성 이미지를 Langfuse에 함께 남기는 실습이다. 다음 편에서는 이 이미지를 다시 사용해 평가하고, 13편에서는 생성 시간과 채택당 비용을 같은 분모로 계산한다.
1. 실행과 관측의 경계
멀티모달 관측은 텍스트뿐 아니라 이미지·오디오 등 서로 다른 형태의 입출력을 실행 기록에 연결하는 것이다. 이미지를 생성하는 기능과, 생성 결과를 저장하고 분석하는 기능은 구분한다.
Qwen-Image-2.1은 텍스트 기반 이미지 생성과 이미지 편집을 지원하는 공개 가중치 모델이다. 공식 자료에는 생성부 7B, 텍스트·참조 이미지 인코더 Qwen3-VL 8B, RGBA VAE가 설명돼 있다. “7B 모델”이라는 이름만으로 전체 적재 메모리를 계산하면 인코더와 실행 중 텐서가 빠진다. 공식 저장소, 모델 카드
이 실습의 역할은 다음과 같다.
| 구성 요소 | 맡는 일 |
|---|---|
| Python·Diffusers | 프롬프트를 받고 Qwen 파이프라인을 호출한다. |
| PyTorch MPS | Apple GPU에서 지원되는 연산을 실행한다. |
| Langfuse SDK | 시작·종료, 모델·설정, 프롬프트 연결, 이미지 참조를 전송한다. |
| Langfuse | Trace를 저장하고 UI에서 입출력·속성·점수를 조회한다. |
| S3 호환 미디어 저장소 | PNG 본문을 저장한다. 이번 로컬 구성은 MinIO다. |
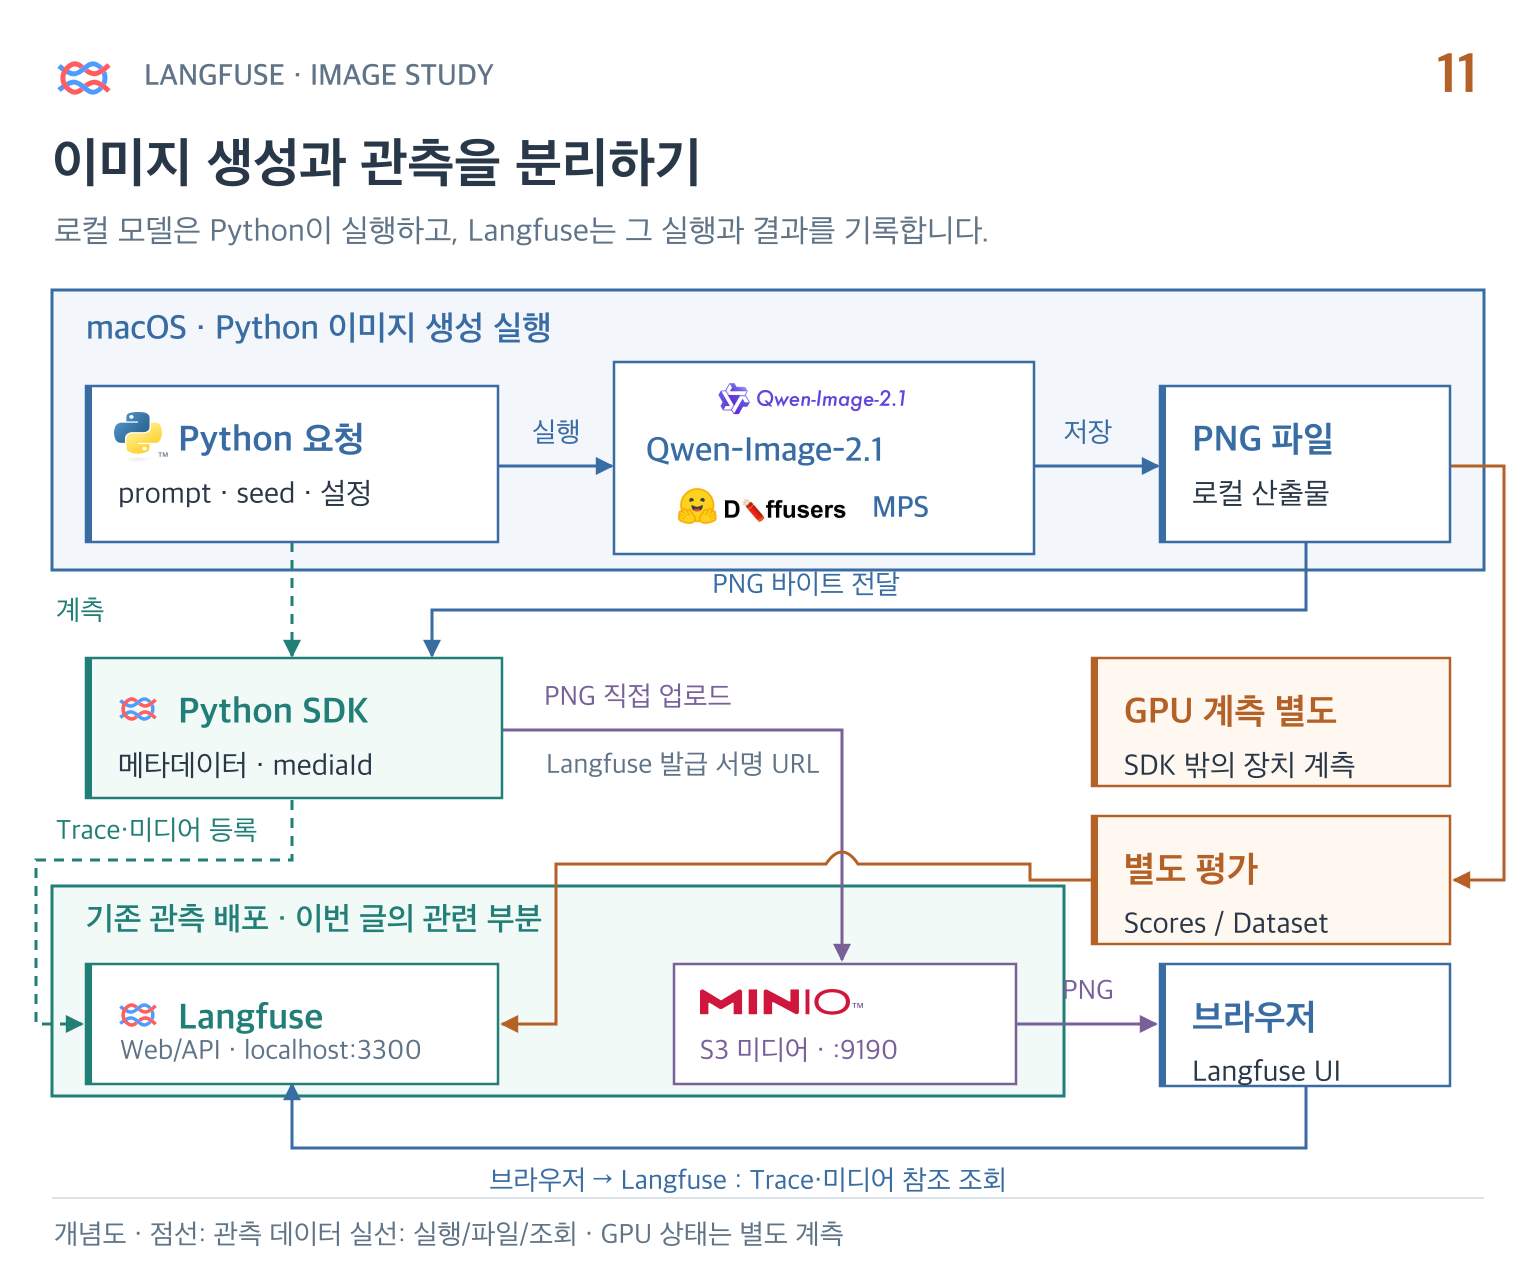
이미지 생성 요청을 실행하는 주체는 Python 프로그램이다. Langfuse에 모델 이름을 등록하는 것만으로 가중치를 내려받거나 GPU 작업이 시작되지는 않는다. GPU 스케줄링·서버 재시작·오토스케일링은 추론 서버와 인프라 운영 도구의 역할이다.
Qwen 2.1의 가중치는 공개돼 있지만 라이선스는 Qwen Research License다. 확인한 라이선스는 비상업적 연구·평가로 이용 범위를 제한하고, 상업적 이용에는 별도 라이선스를 요구한다. 회사 서비스에 도입할 때는 공개 가중치와 상업적 이용 허가를 따로 확인해야 한다. 공식 라이선스
2. 실행 환경 준비
이번에는 Langfuse를 Docker로, 이미지 모델을 macOS의 Python 가상환경에서 실행한다. 기존 Docker 관측 환경을 유지하면서 호스트의 MPS 실행 경로를 확인하기 위한 구성이다.
| 항목 | 이번 실습 조건 |
|---|---|
| 호스트 | Apple M5 Pro, 통합 메모리 64GiB, macOS 26.6.2 |
| 이미지 실행 | Python 3.14.8, PyTorch 2.14.1, BF16, MPS 경로 |
| 파이프라인 | Diffusers 0.41.0.dev0, 아래에 명시한 커밋 고정 |
| 관측 서버·SDK | Langfuse OSS 4.50.0 · Python SDK 4.16.0 |
| 비교 입력 | 영어 제목 2종, 1,024×1,024, seed 42, 20·40 steps |
메모리 용량은 이번 실행 환경의 사양이며 공식 최소 요구량이나 다른 모델에도 적용되는 기준이 아니다.
공식 빠른 시작은 CUDA를 사용한다. 다음 MPS 경로는 해당 예제를 이 실습 환경에 맞춰 적용한 것으로, 모든 Mac·해상도·모델 편집 기능의 호환성을 보장하는 공식 최소 사양 안내가 아니다.
2.1 패키지 고정
Python 3.14를 별도로 설치한 환경에서 python3.14를 사용했다. 시스템 Python과 버전이 같은지 먼저 확인한다.
초기 확인에서 PyPI의 diffusers==0.40.0으로는 QwenImage21Pipeline을 가져올 수 없었다. 공식 모델 카드가 안내하는 개발판을 사용하되, 재현할 수 있도록 설치 당시 커밋을 고정했다.
python3.14 -m venv .venv
source .venv/bin/activate
python -m pip install \
  torch==2.14.1 torchvision==0.29.1 transformers==5.18.0 accelerate==1.15.0 \
  pillow==12.3.0 safetensors==0.8.0 \
  langfuse==4.16.0 python-dotenv==1.2.4
python -m pip install \
  'diffusers @ git+https://github.com/huggingface/diffusers.git@cff9dafbbf493e2a08c6f1951fb2d8845da71841'
또한 프로세서 적재 시 Qwen3VLVideoProcessor requires the Torchvision library 오류가 발생해 torchvision==0.29.1을 추가했다. 텍스트만으로 이미지를 생성하는 호출에서도 통합 프로세서를 적재하는 과정에 이 의존성이 필요했다.
모델 체크포인트도 revision을 고정한다. 이번에 사용한 값은 d26bb61231c349cf6b7896fa83353113880e1ba3이다. 패키지 버전과 모델 revision은 서로 다른 정보다. 같은 모델 이름이어도 가중치나 파이프라인 구현이 바뀌면 결과가 달라질 수 있다.
모델 저장소의 파일 크기 합계는 확인 시점 약 30.86GiB였다. 이 값은 다운로드 대상 파일 크기이며 추론 중 최대 메모리 요구량이 아니다. 다운로드 시간은 생성 지연과 분리한다.
2.2 로컬 연결
프로젝트 폴더의 .env에 로컬 Langfuse 프로젝트의 키를 넣는다. 키를 코드·노트북 출력·공개 원고에 포함하지 않는다.
LANGFUSE_BASE_URL=http://localhost:3300
LANGFUSE_PUBLIC_KEY=pk-lf-your-local-project-key
LANGFUSE_SECRET_KEY=sk-lf-your-local-project-key
LANGFUSE_TRACING_ENVIRONMENT=image-lab
서버가 응답하는지 확인한 뒤 이미지 저장소 주소를 점검한다. 이 실습의 SDK와 브라우저는 호스트에서 실행하므로 미디어 URL은 호스트에서 접근 가능한 http://localhost:9190이어야 한다. Docker 내부의 http://minio:9000을 호스트 브라우저에 그대로 반환하면 이미지가 열리지 않는다.
이 주소는 로컬 실습 기준이다. 여러 PC가 접근하는 배포에서는 업로더·브라우저·필요한 서버가 접근할 수 있는 주소와 인증·서명 URL 구성을 사용한다. 미디어 표시를 위해 버킷 전체를 익명 공개할 필요는 없다. 셀프호스팅 멀티모달 설정
3. 한 번의 생성 기록
Generation은 모델 호출을 나타내는 관측 유형이다. 이미지 생성에서도 모델명·입력·출력·사용량·비용을 한 호출에 연결하는 단위로 사용할 수 있다.
Trace는 요청 전체를, Generation은 이미지 모델 호출을 나타내도록 구성한다. 추후 프롬프트 보강이나 OCR을 추가하면 같은 Trace의 별도 단계로 연결할 수 있다.
프롬프트는 다음처럼 고정했다.
A clean square educational poster. A solid deep blue background.
Exactly the words "LANGFUSE LAB" in large white uppercase sans-serif letters,
centered and very easy to read. A small simple white outline of a light bulb
below the title. Flat graphic design, generous negative space, no extra text,
no watermark, no photographic elements.
형식과 문구를 명시하면 다음 편에서 해상도·필수 문구·배경·아이콘 여부를 서로 다른 기준으로 평가할 수 있다. 원하는 결과를 “예쁜 포스터”라고만 정하면 평가 실패의 이유도 모호해진다.
3.1 계측 핵심 코드
다음 코드는 실행 코드에서 미디어 기록에 필요한 부분을 추린 예제다. 설치와 .env 준비가 끝나 있어야 하며, 최초 실행에는 모델 다운로드·적재 시간이 추가된다.
import io
import os
import time

os.environ.setdefault("PYTORCH_ENABLE_MPS_FALLBACK", "1")

import torch
from dotenv import load_dotenv
from diffusers import QwenImage21Pipeline
from langfuse import get_client
from langfuse.media import LangfuseMedia

load_dotenv()
lf = get_client()
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",
    revision="d26bb61231c349cf6b7896fa83353113880e1ba3",
    torch_dtype=torch.bfloat16,
).to("mps")

prompt = (
    'A clean square educational poster. A solid deep blue background. '
    'Exactly the words "LANGFUSE LAB" in large white uppercase sans-serif letters, '
    'centered and very easy to read. A small simple white outline of a light bulb '
    'below the title. Flat graphic design, generous negative space, no extra text, '
    'no watermark, no photographic elements.'
)
parameters = {"width": 1024, "height": 1024, "num_inference_steps": 20,
              "true_cfg_scale": 1.0, "use_kv_cache": True}

with lf.start_as_current_observation(
    name="image-request", input={"prompt": prompt}
) as request:
    with lf.start_as_current_observation(
        name="qwen-image-2.1",
        as_type="generation",
        model="Qwen/Qwen-Image-2.1",
        input={"prompt": prompt},
        model_parameters={**parameters, "seed": 42},
        metadata={"device": "mps", "dtype": "bfloat16"},
    ) as generation:
        started = time.perf_counter()
        image = pipe(
            prompt=prompt,
            **parameters,
            generator=torch.Generator("cpu").manual_seed(42),
        ).images[0]
        torch.mps.synchronize()
        elapsed = time.perf_counter() - started

        image.save(f"image-steps{parameters['num_inference_steps']}.png")
        buffer = io.BytesIO()
        image.save(buffer, format="PNG")
        media = LangfuseMedia(
            content_bytes=buffer.getvalue(), content_type="image/png"
        )
        generation.update(
            output={"image": media},
            usage_details={"output_images": 1},
            metadata={"generation_latency_seconds": elapsed},
        )
        request.update(
            input={"prompt": prompt}, output={"image": media}
        )

lf.flush()
위 축약 예제는 미디어 전송에 집중해 Prompt 연결을 생략했다. 실제 실습은 lf.get_prompt("image-study/poster", version=1)로 받은 PromptClient를 compile()하고, Generation 생성 시 prompt=prompt_client를 전달했다. 이렇게 연결해야 UI에서 사용한 템플릿 버전으로 이동할 수 있다. Prompt 연결 방법
실제 UI의 Prompts → image-study → poster에서 버전 1을 열었다. 템플릿의 {{color}}와 {{title}}를 각각 배경색과 제목으로 바꾸며, 요청 문장과 구성 조건은 공유한다.
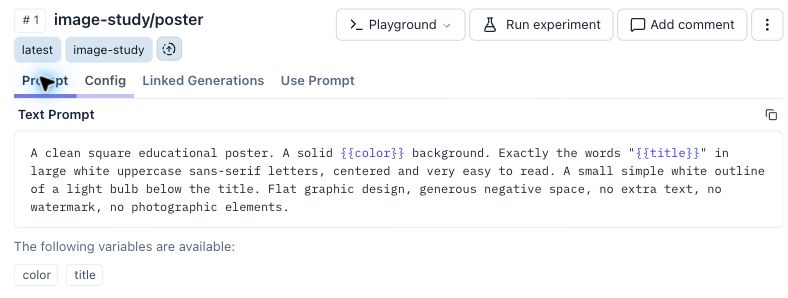
로컬 Langfuse의 Prompt 상세를 부분 캡처했다. color와 title은 템플릿 변수이며 생성 모델이 알아서 해석하는 특수 문법이 아니다. SDK의 compile()이 실제 문자열로 바꾼다.
Config에는 모델 revision·기본 해상도·seed·cache 설정을 보관했다. 이 JSON을 저장하는 것만으로 파이프라인 설정이 바뀌지는 않는다. 실행 프로그램이 전달한 값이 실제 조건이므로, Generation의 model_parameters에도 호출별 해상도와 steps를 남겼다.
LangfuseMedia는 이미지 바이트를 관측 데이터에 연결하는 SDK 객체다. 파일 경로 문자열만 출력에 넣는 것과 다르다. 다른 PC의 브라우저는 로컬 디스크 경로를 읽을 수 없지만, 미디어 참조는 저장된 이미지와 연결된다.
output_images는 이 예제에서 정한 사용자 정의 사용량 이름이다. PNG 바이트 수나 이미지 수를 텍스트 출력 토큰으로 바꾸지 않는다. 모델 이름만 설정했다고 로컬 추론 비용이 자동으로 계산되는 것도 아니다. 비용 배부는 13편에서 따로 다룬다.
flush()는 전송을 기다리는 단계다. 성공 여부는 이후 Trace와 미디어를 재조회해 확인해야 한다. 이 코드의 elapsed는 파이프라인 호출부터 MPS 동기화까지이며, 초기 모델 적재와 PNG 저장·미디어 업로드는 포함하지 않는다. Generation의 UI 지연은 코드 블록 범위에 따라 파일 처리 시간까지 포함할 수 있으므로 두 시간을 같은 값으로 취급하지 않는다.
3.2 재현 조건
seed는 난수 생성의 시작 상태를 정한다. 같은 seed만으로 다른 하드웨어·라이브러리·정밀도에서 픽셀 단위 동일성을 보장하지는 않는다. 이 실습은 seed 외에 체크포인트 revision, Diffusers 커밋, dtype, 해상도, steps, KV cache 사용 여부를 함께 기록했다.
MPS fallback을 켠 것은 지원되지 않는 일부 연산이 CPU 경로로 실행될 수 있음을 허용한 것이다. 모든 연산이 GPU에서 수행됐다고 해석하지 않는다. 실제 실행에서 확인하지 않은 GPU 사용률·피크 메모리를 추정값으로 채우지 않는다.
4. UI에서 결과 읽기
실제 비교에서는 영어 제목 두 종류를 각각 20·40 steps로 생성해 1,024×1,024 PNG 네 장을 얻었다. 그 전에 512×512·4 steps로 연결을 확인했지만 글자가 흐릿해 품질 비교에서는 제외했다. 아래 화면은 LANGFUSE LAB을 20 steps로 생성한 기록이다.
Langfuse UI에서는 다음 순서로 읽는다.
- Tracing에서 이번
image-lab환경 또는 실습 Session을 찾는다. - Session
qwen-image-study-20261005에서 요청을 열고,image-request아래의qwen-image-2.1Generation을 선택한다. - Preview에서 입력 프롬프트와 출력 미디어를 확인한다. PNG 첨부를 펼치면 실제 이미지를 볼 수 있다.
- Attributes에서 모델과 해상도·steps·seed를 확인한다.
- 전체 실습에서 연결한 Prompt로 이동해 어떤 템플릿 버전에서 생성됐는지 확인한다.
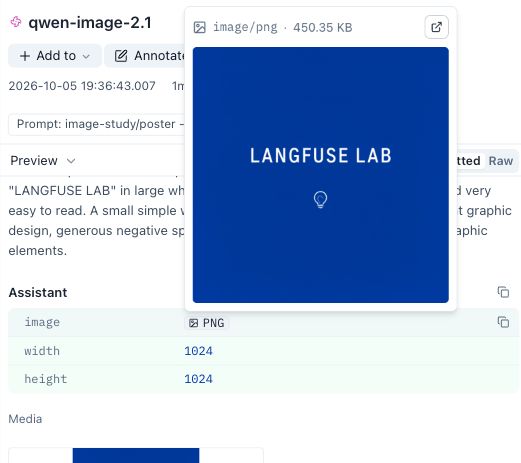
Preview의 PNG 첨부를 펼친 화면이다. 입력 문장과 실제 출력 이미지를 같은 호출에서 확인한다.
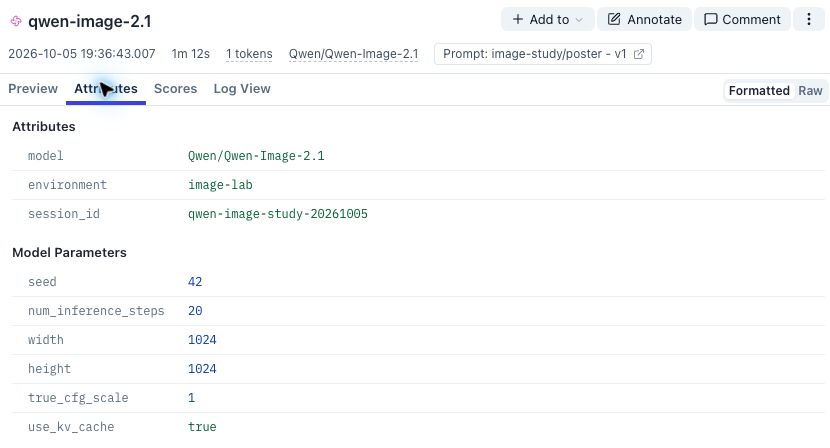
Attributes의 Model Parameters에서 seed 42, 20 steps, 1,024×1,024 조건을 확인한다. 화면의 1 tokens는 이 버전 UI의 일반 사용량 표기다. 실제 기록한 사용량은 output_images=1이며 텍스트 토큰을 측정한 값이 아니다.
Trace 전체와 Generation의 Preview가 다를 수 있다. 이 실습의 SDK 4.16에서는 update_trace()가 없으며, 요청의 입출력은 루트 Span의 update()로 기록한다. 기존의 Trace 수준 입출력 API는 호환용으로 남아 있지만 deprecated 상태이므로 새 예제는 루트 Span과 Generation을 사용했다. Trace의 최상위 출력이 비어 보이면 트리에서 image-request 또는 qwen-image-2.1을 선택해 실제 Observation의 출력을 확인한다. Python SDK v4 변경 사항
5. 서로 다른 이미지 예제
영어 포스터만으로는 이미지 모델을 어떻게 관측하고 평가할지 충분히 드러나지 않는다. 같은 체크포인트로 제품 사진풍·서버실 일러스트·한글 포스터도 생성했다. 세 장 모두 1,024×1,024, 40 steps, seed 42, BF16, MPS, KV cache 사용 조건이다. 아래 프롬프트를 3절 코드의 prompt에 넣고 num_inference_steps=40으로 바꾸면 같은 종류의 실습을 할 수 있다.
각 프롬프트를 image-study/product-photo, image-study/server-illustration, image-study/korean-poster의 버전 1로 따로 등록했다. 같은 Generation 계측으로 텍스트 조건과 결과 PNG를 연결하며, Session은 qwen-image-diversity-20261005로 구분했다. 이 세 장은 스타일과 실패 양상을 살펴보는 추가 사례로, 12·13편의 영어 포스터 20·40 steps 비교 네 장에는 합산하지 않는다.
5.1 제품 사진풍
유리 주전자, 자연광, 나무 테이블처럼 재질과 조명을 구체적으로 지정했다. 실제 제품을 촬영한 사진이 아니라 모델이 생성한 이미지다.
A realistic premium product photograph of a clear glass electric kettle with a simple
matte white handle and base, half filled with water, placed on a warm natural wooden
table beside a large window. Soft natural morning light, realistic glass reflections and
refraction, gentle shadows, calm minimal home interior softly blurred in the background.
The entire kettle is visible, centered composition, square image, professional product
photography. No brand, no logo, no text, no letters, no watermark.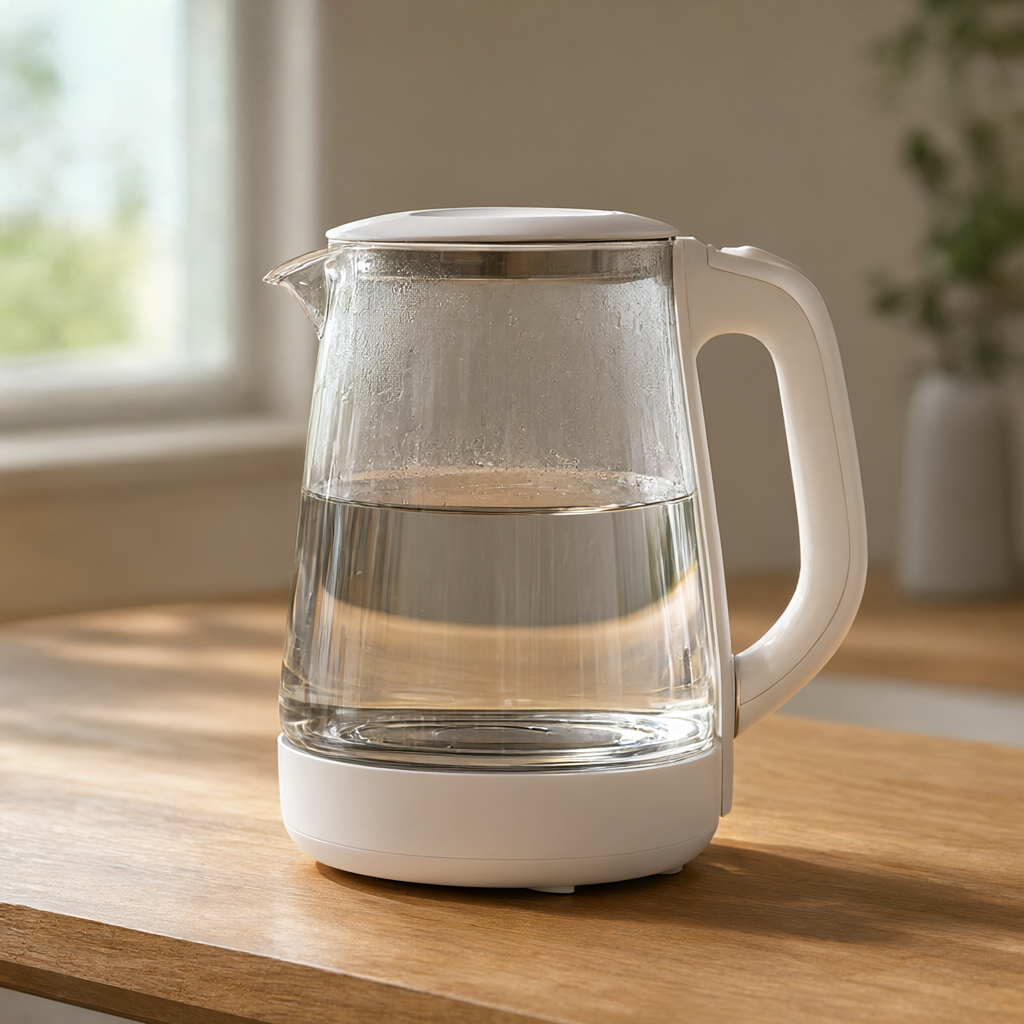
직접 생성한 원본 PNG. 생성 구간 실측 175.6초. 모델 적재·파일 저장·업로드 시간은 제외했다.
유리 표면의 반사, 물의 경계, 흰 손잡이와 받침, 나무 테이블 및 창가 조명이 보인다. 제품의 전체 형태와 문구·브랜드가 없는 조건을 시각적으로 확인했다. 다만 이 관찰은 반사·굴절의 물리적 정확성이나 실제 판매 제품의 형태를 검증한 결과는 아니다.
5.2 서버실 일러스트
아이소메트릭 구도와 파랑·청록 팔레트를 지정하고 서버 랙 4개를 요청했다. 설명용 일러스트이며 실제 시스템 아키텍처나 배선 도면으로 사용하지 않는다.
A polished isometric illustration of a small modern server room, viewed from an elevated
three-quarter angle. Four dark blue server racks with tiny cyan indicator lights stand
neatly on a light gray raised floor. Clean geometric shapes, carefully aligned
perspective, blue and teal palette, soft ambient shadows, white background, generous
negative space, square composition. An editorial illustration of a server room, not an
engineering diagram. No labels, no readable text, no numbers, no arrows, no logo, no
watermark.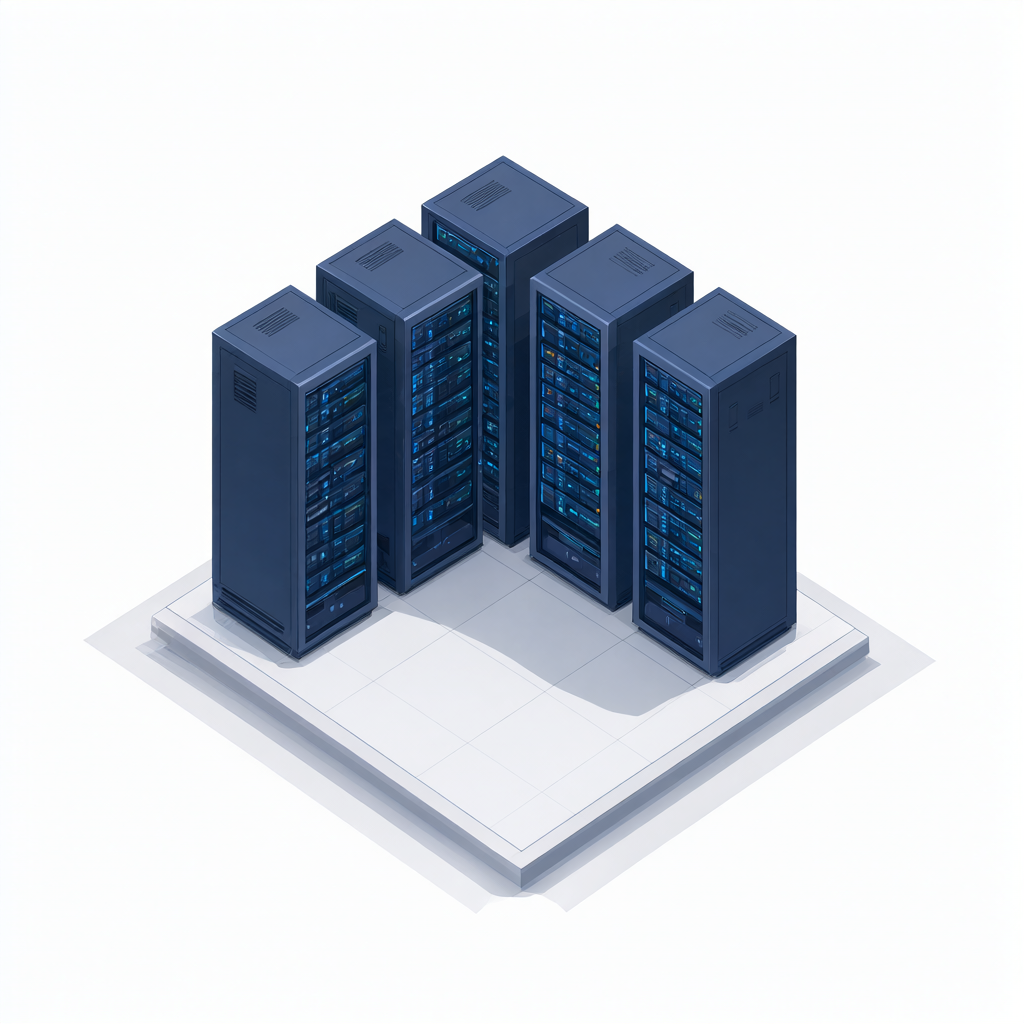
직접 생성한 원본 PNG. 생성 구간 실측 244.7초. 모델 적재·파일 저장·업로드 시간은 제외했다.
결과의 색상과 구도는 요청한 스타일에 가깝지만 랙을 세면 5개다. 뒤쪽 중앙의 랙까지 포함하면 수량 조건을 충족하지 않는다. 보기 좋은 결과라도 요구사항 검사는 실패할 수 있다. 재생성으로 이 결과를 숨기지 않고 원래 프롬프트와 함께 보존했다. 이런 유형에는 OCR 대신 사물 수와 배치 검사가 필요하다.
5.3 한글 포스터
제목은 로컬 AI, 부제는 이미지 생성 실습으로 정확한 문구 두 개를 지정했다. 영문 포스터와 달리 한글 자형을 얼마나 정확히 만드는지도 확인한다.
Create a clean square Korean educational poster on a pure white background. The large
centered main headline must read exactly "로컬 AI". Below it, a smaller centered subtitle
must read exactly "이미지 생성 실습". Use dark navy blue Korean sans-serif typography with
crisp, correctly formed Hangul characters and generous spacing. Place one simple dark
navy blue outline light bulb icon below the subtitle. Flat graphic design, balanced
vertical layout, abundant white space. Only these two text lines, no other letters, no
logo, no watermark, no photographic elements.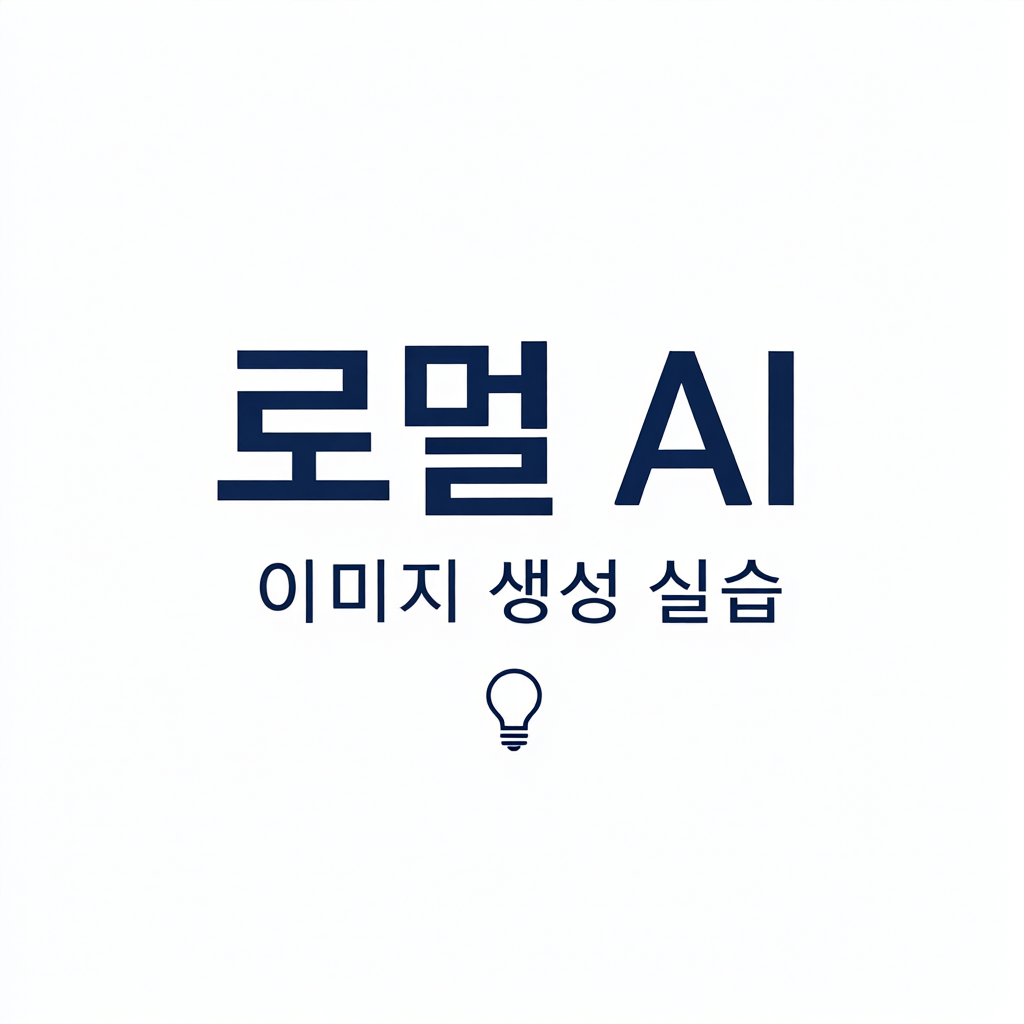
직접 생성한 원본 PNG. 생성 구간 실측 246.5초. 모델 적재·파일 저장·업로드 시간은 제외했다.
부제인 “이미지 생성 실습”은 시각적으로 읽히지만, 제목의 “컬” 자형이 잘못 그려져 요청한 “로컬 AI”를 정확히 재현하지 못했다. 흰 배경·남색 글자·전구·두 줄 배치가 맞더라도 제목 오류 때문에 그대로 채택하기 어렵다.
별도로 실행한 Apple Vision OCR은 EEAI 한 줄만 반환했고 두 필수 문구를 모두 놓쳤다. 따라서 여기에는 생성 모델의 제목 자형 오류와 OCR이 읽을 수 있는 부제까지 놓친 평가 오류가 함께 있다. OCR 불일치를 곧바로 모든 글자가 틀렸다는 판단으로 바꾸면 안 된다. 이 한 장만으로 모델의 한글 생성 능력 전체나 OCR의 한국어 성능을 일반화하지 않는다.
세 예제의 Prompt 버전·이미지 사용량·비용 기록과 저장소에서 다시 내려받은 PNG의 SHA-256도 확인했다. 이 저장 검증의 성공과 이미지 요구사항 충족은 서로 다른 결과다. 원본 이미지는 수정하지 않았으며, 실패한 조건도 생성 기록에 남겨 후속 평가 기준으로 사용할 수 있다.
6. 이미지가 저장되는 경로
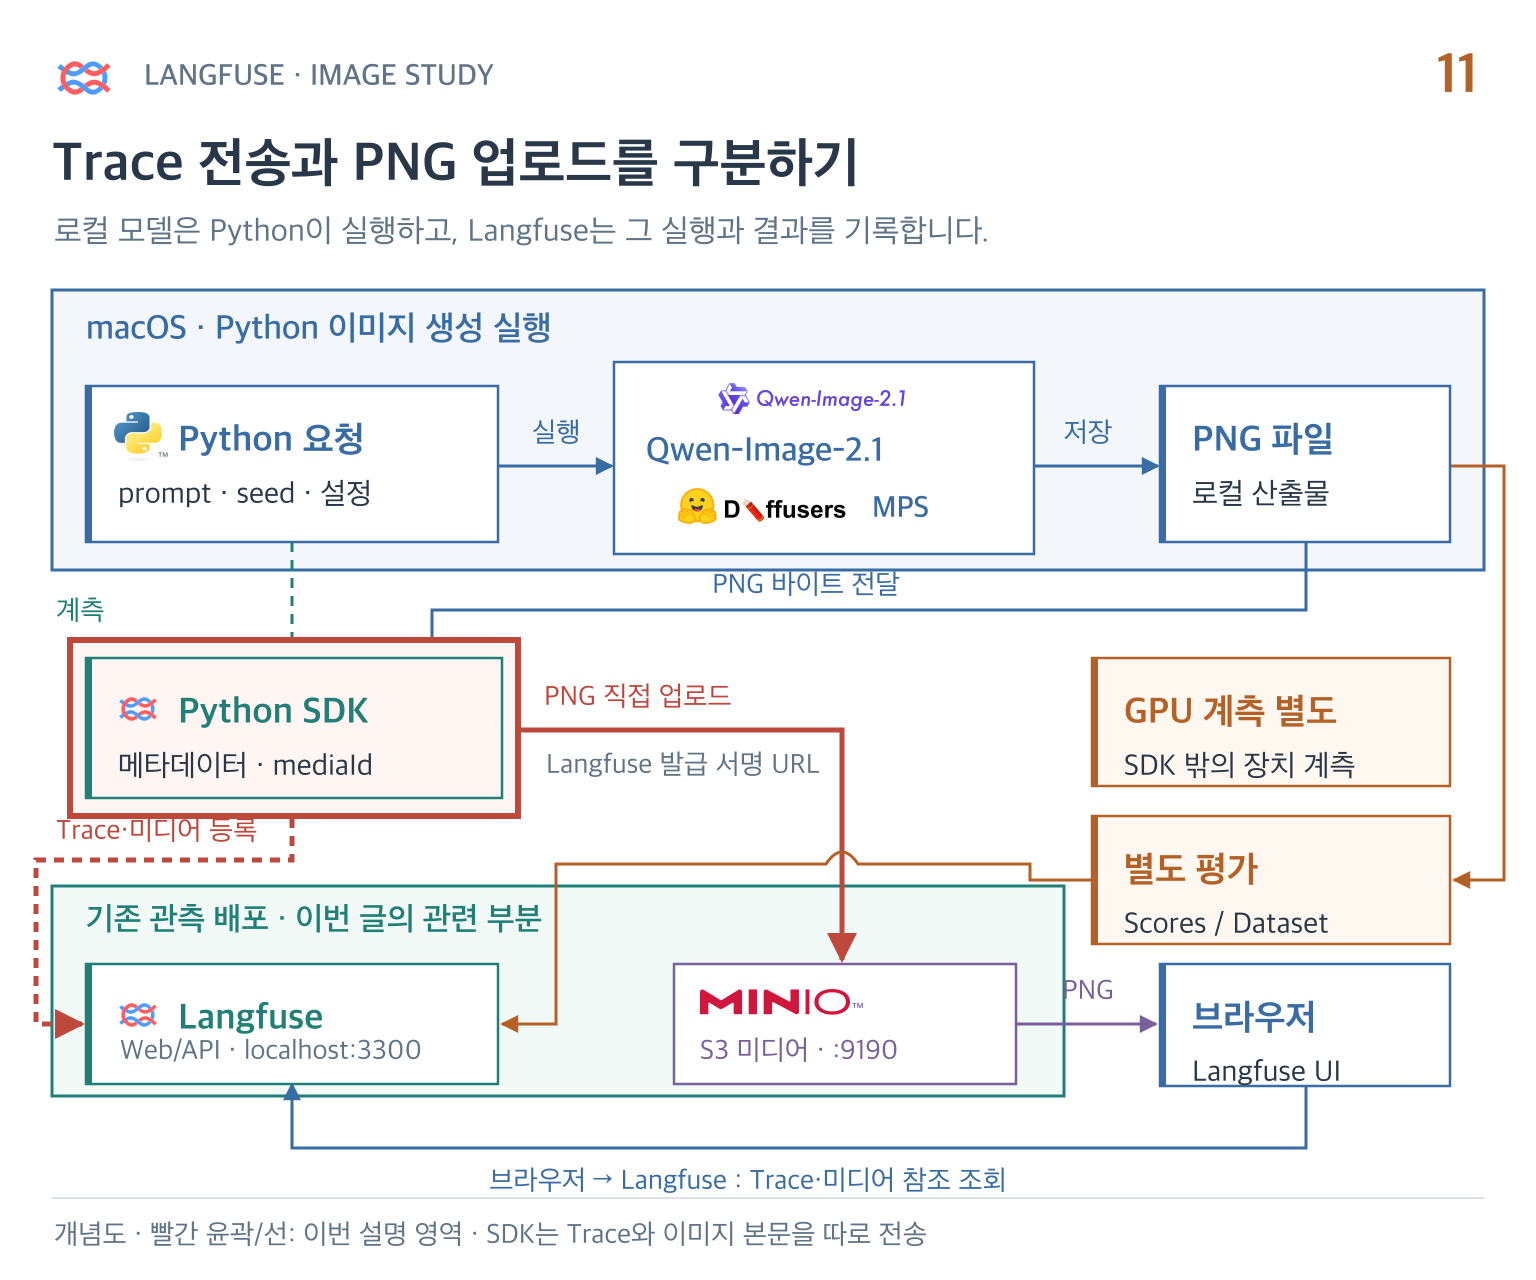
SDK는 미디어 파일을 분리해 저장하고 관측에는 참조를 남긴다. 일반적인 경로는 다음과 같다.
- SDK가 Langfuse에 미디어 등록을 요청해 업로드 정보를 받는다.
- 서명된 URL로 S3 호환 저장소에 이미지 바이트를 업로드한다.
- Generation의 출력에는 해당 미디어를 가리키는 참조가 들어간다.
- UI가 참조를 해석해 이미지를 표시한다.
이미지 파일이 모두 Langfuse Web 서버를 통과해 저장되는 단일 경로로 이해하면 업로드 실패를 진단하기 어렵다. Trace는 보이는데 이미지만 안 보일 때는 업로드 상태, 브라우저에서 접근 가능한 저장소 주소, 서명 URL의 유효성, 콘텐츠 유형을 확인한다. 공식 미디어 처리 과정
외부 이미지 URL을 기록하는 방법도 있다. 이 경우 Langfuse 저장소로 자동 복사되는 것이 아니므로 원본 삭제·주소 만료가 재현성에 영향을 준다. 장기 평가 자료에는 파일 보존 정책과 접근 경로도 함께 정해야 한다.
7. 다음 실습의 질문
이번 기록으로 “어떤 설정에서 어떤 이미지가 생성됐는가”를 확인할 수 있다. 하지만 PNG가 존재한다는 사실만으로 포스터가 요구사항을 만족한다고 판단할 수는 없다.
다음 편에서는 같은 이미지를 다시 생성하지 않고 평가한다. 파일이 정상인지, 요구한 문구가 읽히는지, 색상과 배치가 적절한지를 분리하고, 결과를 Dataset·Experiment·Score로 연결한다.
확인 기준: 2026-10-05, 공식 모델·SDK 문서와 본문에 명시한 로컬 실행 범위. 실습 결과는 소수 사례이며 모델 전반의 품질·운영 성능 벤치마크가 아니다.
