이 글에서 다룰 주제
- 역할: 임베딩 모델과 검색 인덱스는 무엇을 각각 맡는가?
- 알고리즘: HNSW와 IVFFlat은 어디에서 후보를 줄이는가?
- 평가: 빠른 검색이 충분한 정답을 회수하는지 어떻게 확인하는가?
주요 단어 · Embedding · Exact Search · ANN · HNSW · IVFFlat · Recall@K
벡터 검색에서 ‘가깝다’는 것은 임베딩 공간과 거리 기준에 따른 말이다. HNSW나 IVFFlat이 문장의 의미를 새로 이해하는 것은 아니다. 이들은 이미 만들어진 벡터를 더 적은 탐색으로 찾도록 돕는다. 따라서 의미 표현의 품질과 근사 검색의 재현율을 따로 평가해야 한다.
ANN(Approximate Nearest Neighbor)은 일부 정확도를 양보할 수 있는 근사 최근접 검색이다. Recall@K는 정확 검색 상위 K개 중 얼마나 회수했는지를 나타낸다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. pgvector의 위치
pgvector는 PostgreSQL 확장으로 벡터 타입·거리 연산·검색 인덱스를 추가한다. 별도 DB 서버나 임베딩 생성 모델은 아니다. 일반 업무 데이터와 함께 저장하고 SQL·JOIN·트랜잭션을 사용할 수 있다.
임베딩 모델이 문서와 질문을 숫자 벡터로 바꾸고 pgvector가 가까운 벡터를 찾는다. 같은 차원이어도 서로 다른 모델의 벡터는 비교 가능한 공간이 아닐 수 있다.
2. 최소 SQL 예제
pgvector가 서버에 설치되어 있고 확장을 활성화할 권한이 있다는 전제이다. 3차원은 학습용이다.
CREATE EXTENSION IF NOT EXISTS vector;
CREATE SCHEMA IF NOT EXISTS study;
CREATE TABLE study.vector_docs (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    project_id bigint NOT NULL,
    content text NOT NULL,
    embedding vector(3) NOT NULL
);
INSERT INTO study.vector_docs (project_id, content, embedding) VALUES
(10, '연결 풀 고갈 사례', '[0.1,0.2,0.3]'),
(10, '파일 업로드 오류', '[0.8,0.1,0.1]');
SELECT id, content, embedding <=> '[0.1,0.2,0.3]'::vector AS distance
FROM study.vector_docs
WHERE project_id = 10
ORDER BY embedding <=> '[0.1,0.2,0.3]'::vector
LIMIT 5;| 연산자 | 의미 | 정렬 |
|---|---|---|
<-> | L2 거리 | 작을수록 가까움 |
<=> | 코사인 거리 | 작을수록 가까움 |
<#> | 음의 내적 | 오름차순으로 큰 내적 우선 |
거리 함수는 인덱스 알고리즘과 별개다. HNSW는 탐색 구조이며 cosine은 거리 기준이다. 인덱스 operator class와 질의 연산자를 맞춘다.
3. 정확 검색과 ANN
정확 검색은 조건을 만족하는 후보들의 거리를 평가해 정확한 최근접 결과를 얻는다. ANN은 전체 탐색량을 줄여 빠르게 찾지만 정답 일부를 놓칠 수 있다. 임베딩 자체의 의미 품질과 ANN의 재현율은 다른 문제다.
4. HNSW: 다층 이웃 그래프
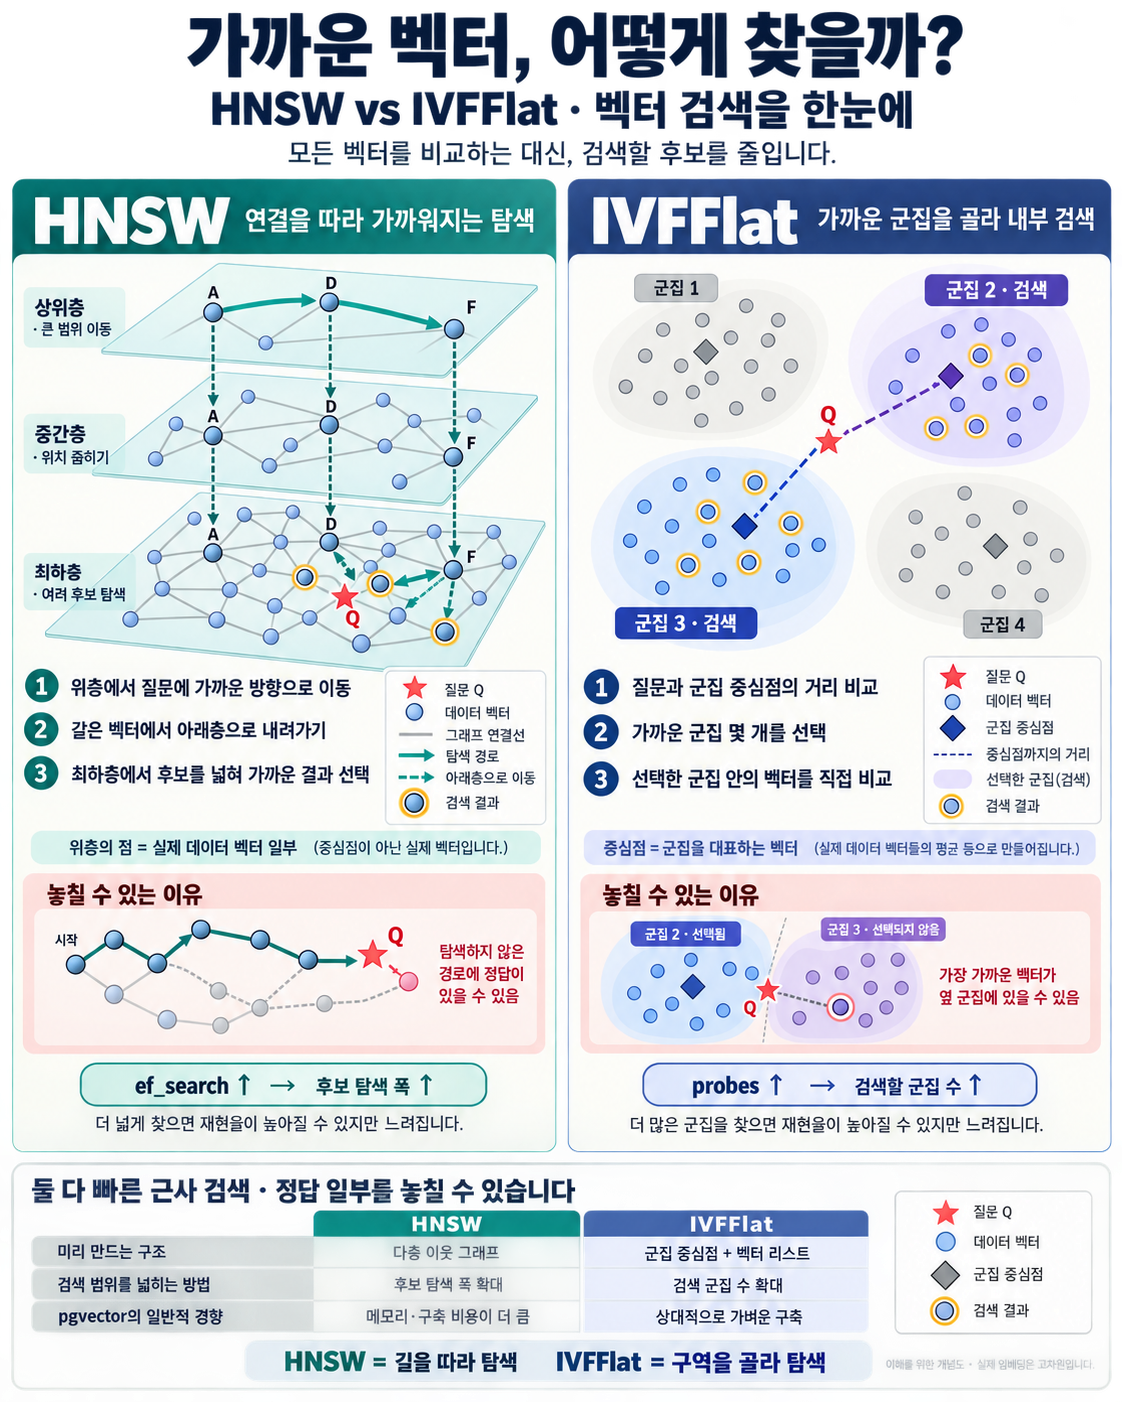
학습 자료의 개념도 — HNSW와 IVFFlat 비교. 세부 조건은 본문 설명을 함께 읽는다.
상위층에는 실제 벡터 일부가 참여하며, 아래층으로 갈수록 더 많은 벡터가 있다. 최하층에는 전체 벡터가 참여한다. 상위 노드는 군집 중심점이 아니다.
거리 값은 탐색을 설명하기 위한 예시다. 상위층에서 더 가까운 이웃으로 이동하다 아래층으로 내려간다. 최하층에서는 여러 후보를 유지하며 이웃을 탐색한다. 한 줄 경로만 따라가는 단순 greedy 탐색으로 이해하면 부정확하다. 탐색하지 않은 경로에 정답이 있을 수 있다.
| 설정 | 역할 |
|---|---|
| m | 연결 수 상한 조절, 메모리·연결 구조에 영향 |
| ef_construction | 구축 시 후보 탐색 폭 |
| hnsw.ef_search | 질의 시 후보 탐색 폭 |
CREATE INDEX study_vector_docs_hnsw
ON study.vector_docs USING hnsw (embedding vector_cosine_ops);
BEGIN;
SET LOCAL hnsw.ef_search = 100;
SELECT id FROM study.vector_docs
ORDER BY embedding <=> '[0.1,0.2,0.3]'::vector LIMIT 5;
COMMIT;
ef_search=100은 총 거리 계산을 정확히 100번으로 제한한다는 뜻이 아니다. LIMIT는 반환 개수이고 ef_search는 탐색 폭이다.
5. IVFFlat: 군집 선택 후 내부 비교
대표 데이터로 군집 중심을 학습하고 각 벡터를 리스트에 배치한다. 검색할 때 가까운 중심점 몇 개를 선택하고 그 리스트 안의 벡터를 직접 비교한다.
예를 들어 군집 2의 중심이 가장 가까워도 실제 최근접 벡터 D는 군집 3에 있을 수 있다. 예를 들어 A의 거리가 0.04, D의 거리가 0.03이라면 군집 2만 검색할 때 A를 반환하고 더 가까운 D를 놓칠 수 있다. Flat은 선택된 리스트에서 벡터를 직접 비교한다는 뜻이지, 전역 결과가 항상 정확하다는 뜻은 아니다.
- lists: 인덱스 구축 시 전체 군집 수.
- ivfflat.probes: 질의 시 검색할 군집 수.
- probes를 늘리면 보통 재현율이 좋아지지만 계산량도 증가한다.
- 데이터 분포가 크게 달라지면 군집 품질과 재구축 필요성을 평가한다.
6. 비교와 평가
| 기준 | HNSW | IVFFlat |
|---|---|---|
| 구조 | 다층 그래프 | 중심점과 리스트 |
| 구축 | 별도 군집 학습 불필요 | 대표 데이터 학습 필요 |
| 일반적 경향 | 높은 메모리·구축 비용, 좋은 속도/재현율 | 상대적으로 가벼운 구축 |
| 누락 원인 | 탐색 경로·후보 제한 | 검색하지 않은 군집 |
| 질의 조절 | ef_search | probes |
평가는 데이터 분포와 필터 조건을 포함한다. 정확 검색 Top 10 중 ANN이 9개를 찾았다면 그 질의의 Recall@10=0.9이다. 여러 질의의 평균과 낮은 성능 구간을 함께 보고 p95 지연·메모리·인덱스 크기도 측정한다.
프로젝트·권한 필터가 강하면 ANN 후보 중 다수가 탈락할 수 있다. iterative scan, 탐색량, 파티셔닝, 선택적 필터 후 정확 검색 등을 실제 계획과 비교한다. 필터를 제거해 결과 개수를 맞추지 않는다.
7. Recall을 비교하는 실험을 설계하기
예를 들어 동일한 평가 질의와 권한 필터에서 정확 검색의 상위 10개를 기준 집합으로 저장한다. ANN 검색이 그중 9개를 회수했다면 그 질의의 Recall@10은 0.9다. 이는 예시 계산이며 이 글에서 수행한 벤치마크 결과가 아니다.
| 고정할 것 | 바꾸어 볼 것 | 기록할 것 |
|---|---|---|
| 문서·청킹·임베딩 모델·거리 함수 | HNSW ef_search | Recall@K·p50/p95 지연 |
| 같은 질의와 권한·프로젝트 필터 | IVFFlat probes | 결과 개수·Recall@K·지연 |
| 같은 데이터 스냅샷 | 인덱스 방식·구축 설정 | 구축 시간·인덱스 크기·메모리 |
여러 후보 인덱스를 동시에 만들고 이름만 바꿔 질의했다고 각각 사용되었다고 가정하면 안 된다. 실행 계획에서 실제 접근 경로를 확인한다. 정확 검색 기준을 만드는 동안에도 ANN 경로가 사용되지 않았는지 확인해야 한다.
적은 결과만 반환되는 문제는 권한 필터를 없애서 해결하지 않는다. 탐색량 확대, 지원 버전의 iterative scan, 선택도가 높은 필터의 정확 검색, 부분 인덱스나 파티셔닝을 같은 조건에서 비교한다. LIMIT 10은 10개의 적격 결과를 찾기 위한 충분한 탐색량을 자동으로 보장하지 않는다.
검색 품질과 답변 품질도 구분한다. 가까운 벡터를 잘 회수했어도 청크가 너무 짧거나 문서가 오래되었다면 좋은 답변의 근거가 되지 못할 수 있다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.