이 글에서 다룰 주제
- 객체 구조: DB·스키마·권한과 저장 위치는 어떻게 다른가?
- 실행 구조: 연결을 받은 뒤 누가 SQL을 처리하는가?
- 메모리: 캐시와 정렬·해시 작업 공간은 무엇이 다른가?
주요 단어 · Cluster · Database · Schema · Role · Backend · Shared Buffers · work_mem
pgAdmin을 열면 Tables, Schemas, Functions, Extensions처럼 익숙하면서도 역할이 다른 이름들이 한꺼번에 보인다. 여기에 Backend, Shared Buffers, WAL 같은 내부 구조 용어까지 더해지면 어디부터 연결해야 할지 헷갈리기 쉽다. 먼저 무엇을 저장하는가, 누가 실행하는가, 어디에서 처리하는가를 나누어 PostgreSQL의 전체 지도를 그려 보자.
Cluster는 하나의 PostgreSQL 서버 인스턴스가 관리하는 데이터베이스 집합, Schema는 DB 안의 이름 공간이다. Backend는 클라이언트 연결의 SQL을 처리하는 서버 프로세스다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. pgAdmin에서 읽는 객체의 범위
화면에 보이는 것은 컬럼이 아니라 객체 종류다
pgAdmin에서 보이는 Tables·Schemas·Functions 등은 테이블 필드가 아니다. PostgreSQL의 여러 객체를 종류별로 묶어 보여주는 pgAdmin Object Explorer의 노드다. 실제 컬럼은 student 테이블을 펼친 뒤 Columns에서 확인한다.
PostgreSQL의 database cluster는 한 서버 인스턴스가 관리하는 데이터베이스 집합을 뜻한다. 반드시 다중 서버나 분산 구성을 의미하지 않는다.
mydb에 연결한 상태에서 student를 조회한다.
SELECT * FROM public.student;public은 스키마, student는 테이블이다. 다른 데이터베이스의 테이블을 일반적인 database.schema.table 참조만으로 자유롭게 조회할 수 있는 구조가 아니다. 별도 연결이나 FDW 등이 필요하다.
서버와 DB 목록
| 항목 | 역할 | 해석 |
|---|---|---|
| Servers (1) | pgAdmin 서버 연결 목록 | 등록된 연결 1개 |
| PostgreSQL 18 | 연결 표시 이름 | 이름은 변경 가능하므로 실제 버전은 별도 확인 |
| Databases (2) | DB 목록 | 예시: mydb, postgres |
| mydb | 업무·실습 DB | 사용자가 만든 DB 이름의 예 |
| postgres | 보통 초기화 시 생성되는 기본 DB | 관리 도구의 기본 접속 DB 등으로 사용 |
괄호 안 숫자는 표시된 객체 수이며 필터·시스템 객체 표시 설정의 영향을 받을 수 있다.
SELECT version();
SELECT current_database(), current_user;
SHOW search_path;
서버 범위의 Role과 Tablespace
| 항목 | 의미 |
|---|---|
| Login/Group Roles | 사용자 계정과 권한 그룹. LOGIN 속성이 있으면 접속 계정으로 사용 가능 |
| Tablespaces | 데이터 객체 파일을 저장할 물리 위치 |
| pg_default | 기본 저장 공간. 별도 지정이 없는 일반 객체의 기본 위치로 사용 |
| pg_global | Role 등 클러스터 공용 시스템 카탈로그 저장 공간 |
Role이 서버 범위 객체라고 해서 모든 DB·테이블에 자동 접근할 수 있는 것은 아니다. CONNECT·USAGE·SELECT 등 필요한 권한을 따로 가진다.
CREATE ROLE app_reader NOLOGIN;
CREATE ROLE report_user LOGIN;
GRANT app_reader TO report_user;

GRANT CONNECT ON DATABASE mydb TO app_reader;
-- 이하 mydb에 연결한 상태
GRANT USAGE ON SCHEMA public TO app_reader;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO app_reader;
이 예제는 비밀번호·인증 설정을 포함하지 않는다. 마지막 GRANT는 기존 테이블 대상이며 새 테이블은 생성 역할 기준의 ALTER DEFAULT PRIVILEGES 설정이 필요하다.
| 비교 | Schema | Tablespace |
|---|---|---|
| 질문 | 어떤 이름 공간에 속하는가? | 어느 물리 위치에 저장되는가? |
| 예 | school.student | 특정 마운트 경로 |
| 목적 | 이름·권한·논리 구조 | 저장 장치 배치 |
| 관계 | 한 스키마 객체를 여러 Tablespace에 둘 수 있음 | 여러 스키마 객체를 같은 공간에 둘 수 있음 |
Tablespace는 샤딩 기능이 아니다. 디스크를 분리해도 서버의 CPU·메모리·장애 경계가 자동으로 분산되지 않는다.
Schema와 public
public은 보통 DB에 기본 생성되는 스키마다. 이름이 public이라고 누구나 모든 테이블에 접근할 수 있는 것은 아니다. 실제 권한을 확인해야 한다.
CREATE SCHEMA school;
CREATE TABLE school.student (id bigint PRIMARY KEY, name text);
public.student와 school.student는 서로 다른 객체다. 스키마를 생략하면 search_path의 순서로 이름을 찾는다. 신뢰하지 않는 사용자가 객체를 만들 수 있는 스키마를 search_path에 넣으면 이름 가로채기 위험이 있으므로 서비스 SQL·권한 설계에서 주의한다.
2. 데이터와 로직을 구성하는 객체
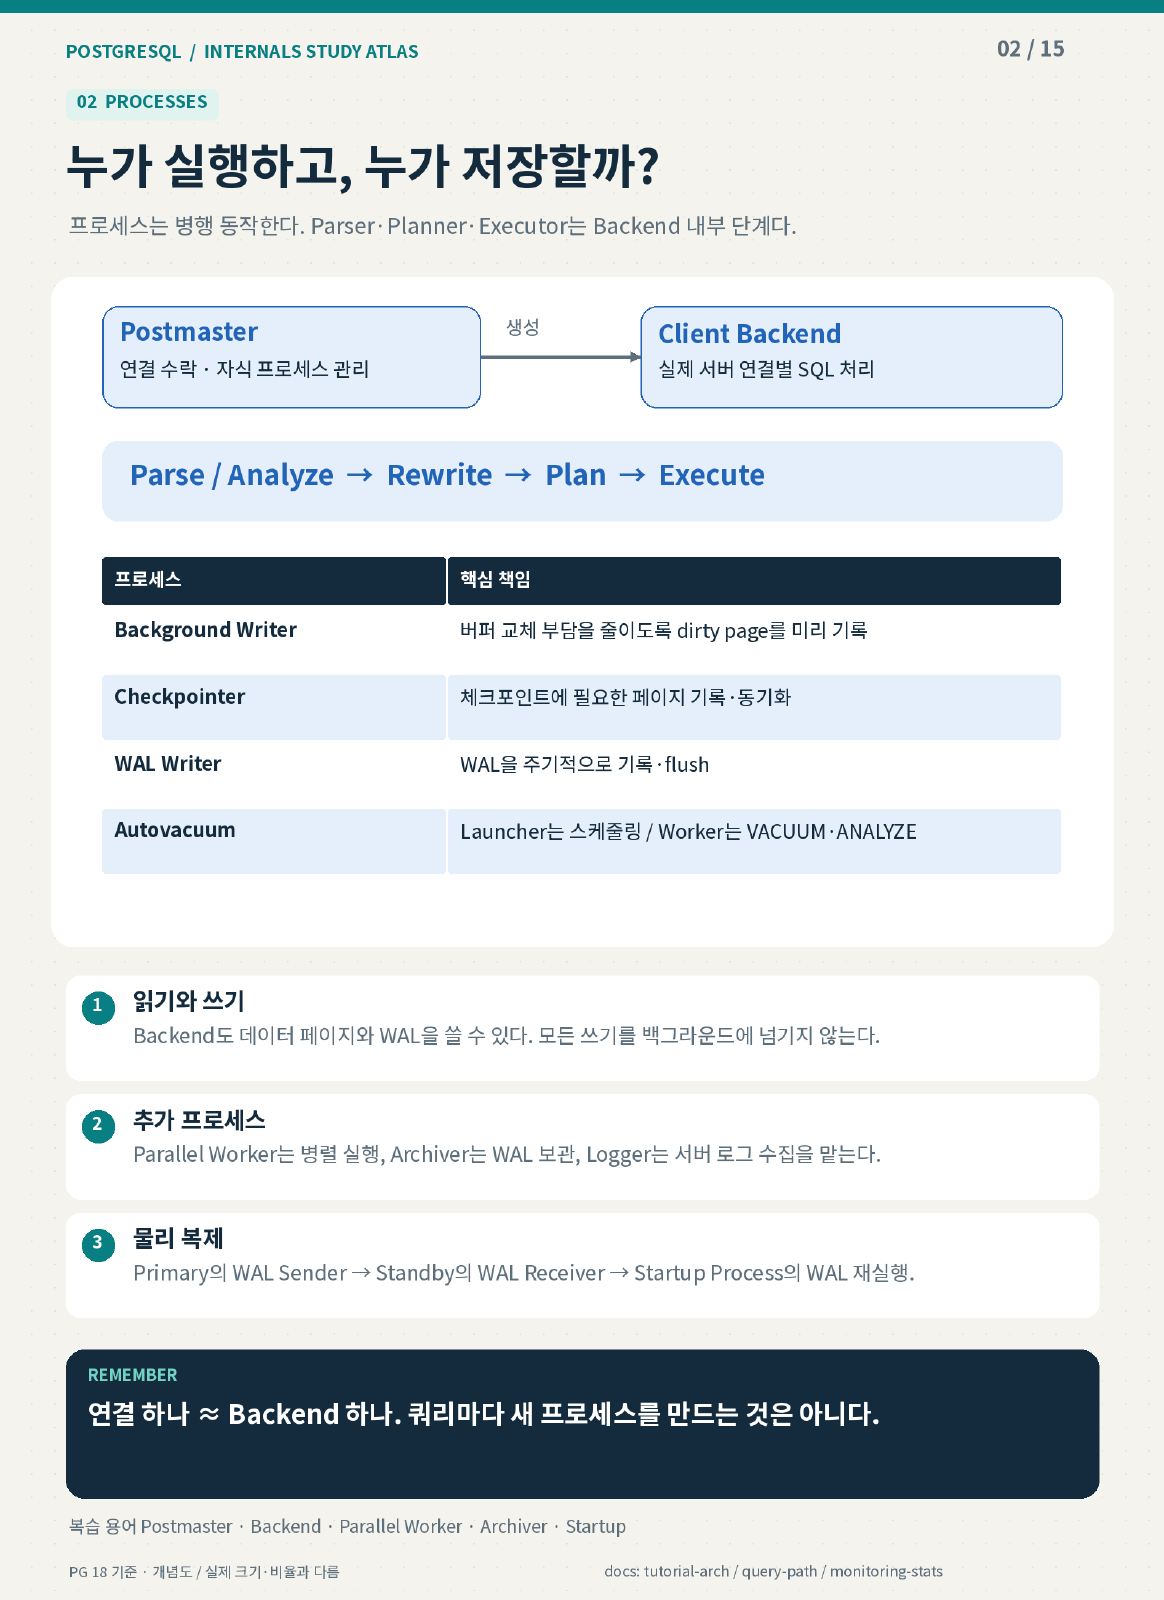
학습 자료의 개념도 — Backend와 백그라운드 프로세스의 역할. 세부 조건은 본문 설명을 함께 읽는다.
데이터베이스 아래의 객체
| 항목 | 역할 | 동작 예와 주의점 |
|---|---|---|
| Casts | 타입 변환 규칙 | '123'::integer처럼 변환. 사용자 정의 Cast는 암묵적 변환에도 영향을 줄 수 있음 |
| Catalogs | DB 자체의 메타데이터 | 테이블·컬럼·권한·타입 등을 조회. 일반적으로 pg_catalog와 information_schema 표시 |
| Event Triggers | DDL 이벤트에 반응 | CREATE·ALTER·DROP 등 지원되는 구조 변경 이벤트의 감사·통제 |
| Extensions | 확장 객체 패키지 | 타입·함수·연산자 등 관련 객체를 묶어 설치·버전 관리 |
| Foreign Data Wrappers | 외부 데이터 접근 구현 | 원격 DB·파일 등에 접근하는 어댑터 |
| Languages | 함수·프로시저 구현 언어 | plpgsql 등. 자연어 설정과 다름 |
| Publications | 논리 복제 발행 범위 | 어떤 테이블의 어떤 변경을 발행할지 정의 |
| Schemas | 논리적 이름 공간 | 이름 충돌 방지와 권한 관리 |
| Subscriptions | 논리 복제 구독 | 원격 Publication의 데이터를 받아 적용 |
Catalogs: 데이터에 대한 데이터
student에 학생 정보가 저장된다면, 카탈로그에는 student의 컬럼·타입·제약 같은 구조 정보가 기록된다.
SELECT column_name, data_type, is_nullable
FROM information_schema.columns
WHERE table_schema = 'public'
  AND table_name = 'student'
ORDER BY ordinal_position;- pg_catalog: PostgreSQL 고유의 상세 시스템 정보.
- information_schema: 표준화된 메타데이터 인터페이스.
- 스키마 변경은 CREATE·ALTER·DROP으로 수행한다. 시스템 카탈로그 직접 수정으로 관리하지 않는다.
Extension은 다른 객체 메뉴와 연결된다
확장이 등록한 함수는 Functions, 타입은 Types, 연산자는 Operators에 나타날 수 있다. 메뉴가 서로 다른 기능 제품을 뜻하는 것은 아니다. 하나의 기능이 여러 객체로 구성될 수 있다.
논리 복제
운영 DB의 Publication이 변경 범위를 정의하고, 수신 DB의 Subscription이 데이터를 가져와 적용한다. 최초 데이터 동기화 이후 변경 전달에 활용할 수 있다. DDL·시퀀스 상태까지 전부 자동 복제되는 것은 아니므로 스키마 배포와 시퀀스 관리 정책을 별도로 검토한다.
데이터 저장·조회 객체
| 항목 | 저장·동작 방식 | 용도 |
|---|---|---|
| Tables | 실제 행 저장 | 업무 데이터 |
| Views | SELECT 정의 저장 | 조회 재사용·노출 범위 관리 |
| Materialized Views | SELECT 정의와 결과 저장 | 무거운 집계 결과 재사용 |
| Sequences | 다음 번호 발급 | IDENTITY·serial 등의 번호 생성 |
| Foreign Tables | 외부 데이터의 테이블 정의 | FDW를 통한 원격 조회 |
View와 Materialized View
View는 조회할 때 원본에 대한 쿼리가 실행되며, 해당 트랜잭션의 가시성 규칙에 따른 데이터를 읽는다. Materialized View는 이전에 저장한 결과를 읽는다. PostgreSQL 기본 Materialized View는 원본 변경마다 자동으로 갱신되지 않는다.
REFRESH MATERIALIZED VIEW public.student_summary;Materialized View 자체에 인덱스를 만들 수 있다. 갱신 비용·잠금·허용 가능한 데이터 지연을 함께 설계해야 한다.
Sequence
시퀀스는 동시 요청에서 번호를 안전하게 발급하지만 롤백해도 발급 번호를 되돌리지 않을 수 있다. 캐시와 실패 때문에 빈 번호가 생길 수 있으므로 회계 문서 등 무결번 업무 번호와 구분한다. 발급 순서가 커밋 순서와 같다는 보장도 없다.
FDW의 구성
| 객체 | 역할 |
|---|---|
| Foreign Data Wrapper | 외부 접근 구현 |
| Foreign Server | 원격 접속 대상과 옵션 |
| User Mapping | 로컬 사용자와 원격 인증 연결 |
| Foreign Table | 외부 데이터 컬럼 구조·매핑 |
Foreign Table은 자동 복제본이 아니다. 외부 접근 시 네트워크·원격 실행·조건 pushdown 여부가 성능에 영향을 준다.
로직과 연산 객체
| 항목 | 역할 |
|---|---|
| Functions | SQL 식에서 호출할 수 있는 함수. 값·행 집합 반환과 데이터 처리 |
| Procedures | CALL로 실행하는 작업 단위 |
| Trigger Functions | 트리거가 호출하는 실행 코드 |
| Aggregates | 여러 행을 상태에 누적하여 집계 결과 계산 |
| Operators | 타입별 기호 연산과 처리 함수 연결 |
| 비교 | Function | Procedure |
|---|---|---|
| 호출 | SELECT f(...) 등 | CALL p(...) |
| 반환 | 값·여러 행·void 등 | 출력 매개변수 사용 가능 |
| 데이터 변경 | 가능 | 가능 |
| 내부 COMMIT/ROLLBACK | 불가 | 호출 문맥·정의 옵션 등 허용 조건에서 가능 |
조회와 수정으로 둘을 구분하면 부정확하다. Function도 데이터를 수정할 수 있다.
Trigger와 Trigger Function
- Trigger: 어느 객체의 어떤 이벤트에서, 언제·어떤 단위로 실행할지 정의.
- Trigger Function: 실행할 코드 정의. 행 트리거에서 OLD·NEW 등을 사용.
- 일반적인 DML 트리거는 해당 DML과 같은 트랜잭션에서 실행된다. 비동기 큐가 아니다.
CREATE TABLE public.student_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    name text NOT NULL,
    updated_at timestamptz NOT NULL DEFAULT CURRENT_TIMESTAMP
);

CREATE FUNCTION public.set_student_updated_at()
RETURNS trigger
LANGUAGE plpgsql
AS $$
BEGIN
    NEW.updated_at := CURRENT_TIMESTAMP;
    RETURN NEW;
END;
$$;

CREATE TRIGGER student_set_updated_at
BEFORE UPDATE ON public.student_demo
FOR EACH ROW
EXECUTE FUNCTION public.set_student_updated_at();
함수는 Trigger Functions, 연결 정의는 테이블 아래 Triggers에 해당한다. CURRENT_TIMESTAMP는 트랜잭션 시작 시각이므로 같은 트랜잭션 내 여러 갱신에 같은 값이 들어갈 수 있다. DDL에 반응하는 Event Trigger와 구분한다.
타입과 비교 규칙
| 항목 | 역할 | 예 |
|---|---|---|
| Types | 사용자 정의 타입 | ENUM·복합 타입 |
| Domains | 기존 타입에 재사용 가능한 제약 추가 | 0~100 점수 |
| Collations | 문자열 정렬·비교 규칙 | 한국어 순서·대소문자 무시 |
CREATE TYPE public.student_status
AS ENUM ('active', 'graduated', 'suspended');

CREATE DOMAIN public.score_100
AS integer CHECK (VALUE BETWEEN 0 AND 100);
위 Domain의 CHECK만으로 NULL이 금지되지는 않는다. 필수 컬럼에는 NOT NULL을 지정한다. ENUM 순서는 단순한 문자열 사전순이 아니라 정의된 ENUM 순서다.
FTS: 전문 검색 객체
| 항목 | 역할 |
|---|---|
| FTS Parsers | 텍스트를 토큰으로 분리하고 종류 식별 |
| FTS Dictionaries | 토큰을 검색어로 정규화하거나 제거 |
| FTS Templates | Dictionary 처리 알고리즘의 구현 기반 |
| FTS Configurations | Parser와 토큰 종류별 Dictionary 연결 |
SELECT to_tsvector('english', 'The students are studying');영어 설정에서는 불용어 제거·어간 처리 등이 적용된다. tsvector는 전문 검색의 어휘·위치 표현이며 임베딩 벡터가 아니다. GIN으로 tsvector 검색을 가속할 수 있으나, Collation을 한국어로 설정한다고 한국어 형태소 분석기가 자동으로 생기는 것은 아니다.
3. SQL을 실행하는 프로세스
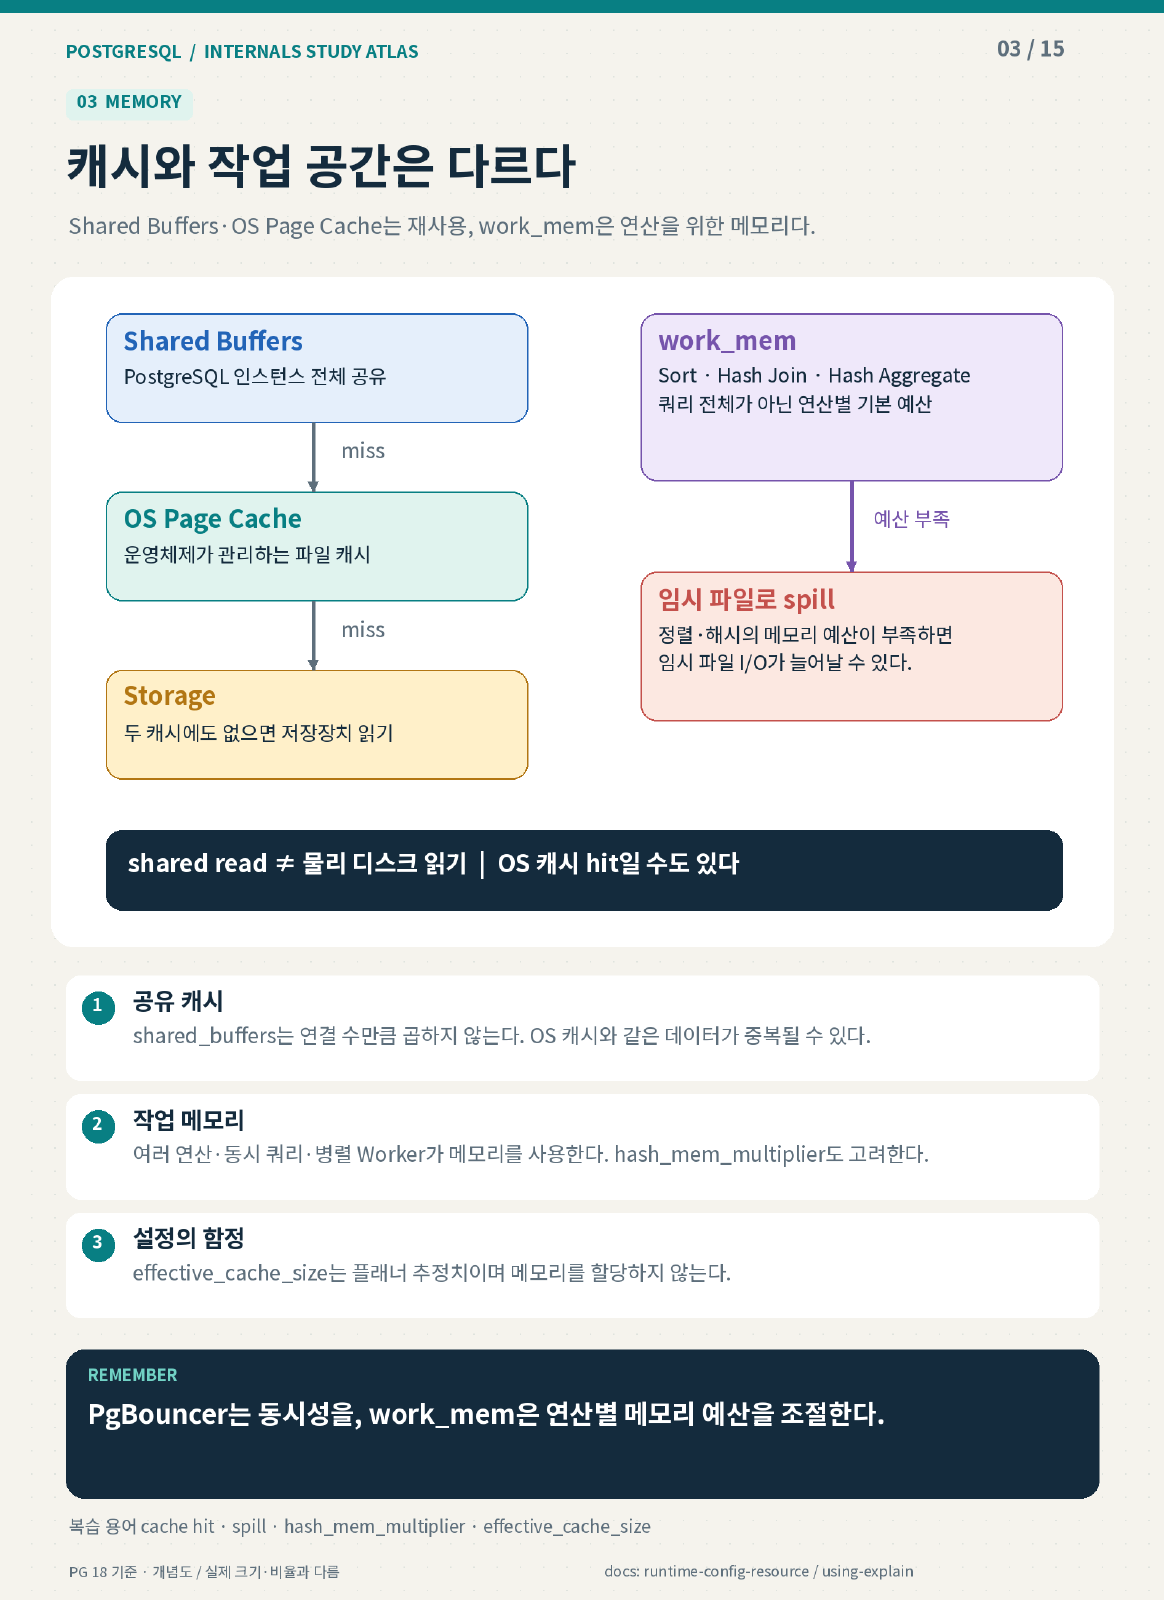
학습 자료의 개념도 — 캐시와 작업 공간의 차이. 세부 조건은 본문 설명을 함께 읽는다.
누가 실행하고, 누가 저장할까?
프로세스는 병행 동작한다. Parser·Planner·Executor는 Backend 내부 단계다.
| 프로세스 | 담당 역할 |
|---|---|
| Postmaster | 연결 수락, Backend 생성, 프로세스 감시 |
| Client Backend | 연결별 SQL 실행·트랜잭션·잠금 처리 |
| Background Writer | 버퍼 교체 부담을 줄이도록 dirty page를 미리 기록 |
| Checkpointer | 체크포인트에 필요한 페이지 기록과 동기화 |
| WAL Writer | WAL을 주기적으로 기록·flush |
| Autovacuum Launcher / Worker | 작업 스케줄링 / 실제 VACUUM·ANALYZE |
| Parallel Worker | 병렬 실행 계획의 일부 수행 |
| Archiver | 완료된 WAL 세그먼트 아카이빙 |
| WAL Sender / Receiver | 물리 복제 WAL 전송 / 수신 |
| Startup Process | 시작 시 복구 및 Standby의 WAL 재실행 |
| Logger | logging collector 활성화 시 로그 수집 |
연결 수락 → Backend 생성·인증 → SQL 수신 → Parse/Analyze → Rewrite → Plan → Execute → 결과 반환.
Parser·Planner·Executor는 일반적으로 Backend 내부 단계이며 각각 별도 OS 프로세스가 아니다. 실제 서버 연결 하나에 Backend 하나가 대응하고, 유지되는 연결에서 여러 SQL을 처리한다.
읽기와 쓰기 — Backend도 데이터 페이지와 WAL을 쓸 수 있다. 모든 쓰기를 백그라운드에 넘기지 않는다.
추가 프로세스 — Parallel Worker는 병렬 실행, Archiver는 WAL 보관, Logger는 서버 로그 수집을 맡는다.
물리 복제 — Primary의 WAL Sender → Standby의 WAL Receiver → Startup Process의 WAL 재실행.
기억할 문장: 연결 하나 ≈ Backend 하나. 쿼리마다 새 프로세스를 만드는 것은 아니다.
4. 캐시와 작업 공간의 차이
캐시와 작업 공간은 다르다
Shared Buffers·OS Page Cache는 재사용, work_mem은 연산을 위한 메모리다.
| 구분 | Shared Buffers | OS Page Cache | work_mem |
|---|---|---|---|
| 주체 | PostgreSQL | OS | PostgreSQL 실행기 |
| 대상 | 테이블·인덱스 페이지 | 파일 데이터 | 정렬·해시 중간 데이터 |
| 범위 | 인스턴스 공유 | OS 파일 캐시 | 일반적으로 연산·프로세스별 |
| 크기 | 시작 시 설정 | 동적 변화 | 필요할 때 사용 |
| 부족할 때 | 페이지 교체 | 저장장치 읽기 증가 | spill 가능 |
work_mem은 연결당 예약값도 쿼리 전체 메모리의 절대 상한도 아니다. 일반적인 해시 예산은 work_mem × hash_mem_multiplier이다. Shared Buffers와 OS 캐시에는 같은 데이터가 중복될 수 있다.
공유 캐시 — shared_buffers는 연결 수만큼 곱하지 않는다. OS 캐시와 같은 데이터가 중복될 수 있다.
작업 메모리 — 여러 연산·동시 쿼리·병렬 Worker가 메모리를 사용한다. hash_mem_multiplier도 고려한다.
설정의 함정 — effective_cache_size는 플래너 추정치이며 메모리를 할당하지 않는다.
기억할 문장: PgBouncer는 동시성을, work_mem은 연산별 메모리 예산을 조절한다.
5. 실습에서 먼저 확인할 것
SELECT version(), current_database(), current_user;
SHOW search_path;
SHOW shared_buffers;
SHOW work_mem;
SHOW hash_mem_multiplier;
SHOW effective_cache_size;
연결 이름과 실제 버전을 혼동하지 않고, 공유 캐시의 크기와 연산별 메모리 예산을 구분해서 읽는다. 이 명령은 설정을 변경하지 않는다. 캐시 hit가 높다는 사실만으로 느린 SQL의 모든 원인이 해결되었다고 판단할 수는 없다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.
시리즈 목차
- PostgreSQL의 전체 지도: pgAdmin·프로세스·메모리
- UPDATE와 COMMIT의 저장 흐름: WAL·Checkpoint
- MVCC와 HOT: 한 행의 여러 버전은 어떻게 연결될까?
- VACUUM과 TXID 프리징: 공간과 오래된 트랜잭션 관리
- 대용량 테이블 읽기 줄이기: B-tree·BRIN·파티셔닝
- GIN·GiST와 JSONB: 포함 조건과 인덱스의 쓰기 비용
- 같은 한글인데 왜 다를까? Collation·NFC·NFD
- PostgreSQL 텍스트 검색: FTS·pg_trgm·BM25 구분하기
- ORM과 연결 관리: Flush·Commit·PgBouncer
- 느린 SQL 조사하기: EXPLAIN·pg_stat_statements·auto_explain
- pgvector의 HNSW·IVFFlat: 정확도와 탐색 비용
- 업무 DB에서 RAG까지: PGMQ·문서 버전·하이브리드 검색