동시성(Race Condition)을 다루는 방법
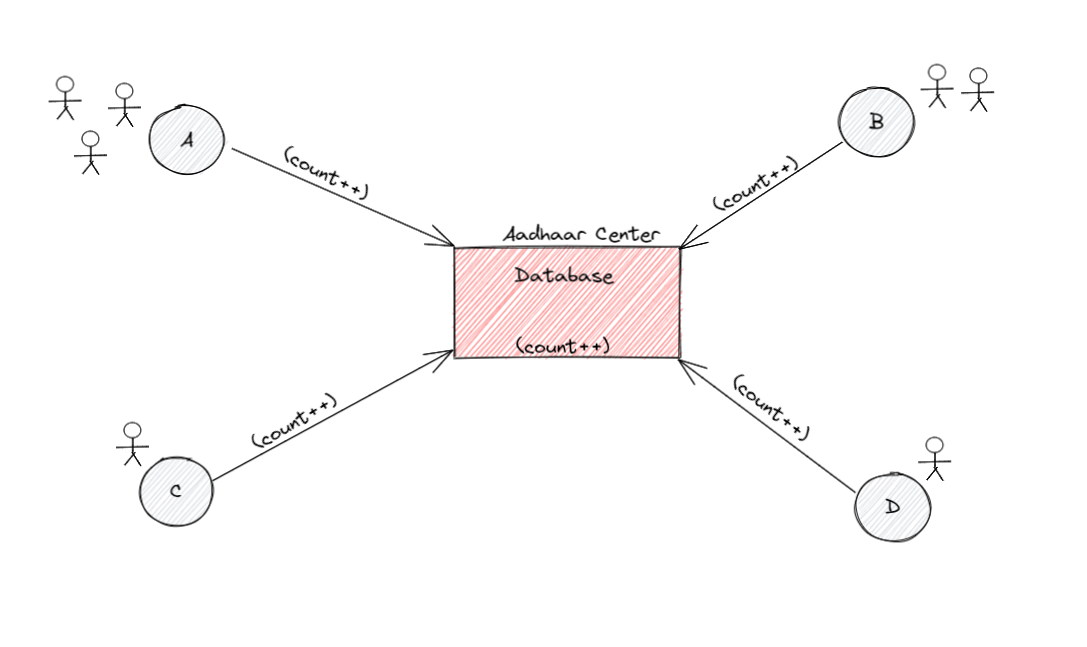
재고 로직을 통해 동시성을 다루는 방법을 기술해보려한다.
1. 비즈니스 로직
Entity
@Getter
@AllArgsConstructor
@NoArgsConstructor(access = AccessLevel.PROTECTED)
@Entity(name = "stock")
public class Stock {

    @Id @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;
    private Long productId;
    private Long quantity;


    public Stock(Long productId, Long quantity) {
        this.productId = productId;
        this.quantity = quantity;
    }

    public void decrease(Long quantity) {
        if (this.quantity - quantity < 0) throw new RuntimeException("재고는 0개 미만이 될 수 없습니다.");
        this.quantity -= quantity;
    }
}
Service
@Service
@RequiredArgsConstructor
public class StockService {

    private final StockRepository stockRepository;

    @Transactional
    public void decrease(Long id, Long quantity) {
        Stock stock = stockRepository.findById(id).orElseThrow();
        stock.decrease(quantity);
        stockRepository.saveAndFlush(stock);
    }

}
2. 테스트를 통한 검증
1) 수량 1개를 감소시키는 케이스
@SpringBootTest
class StockServiceTest {

    @Autowired
    private StockService stockService;

    @Autowired
    private StockRepository stockRepository;


    @BeforeEach
    public void before() {
        //상품: 1
        //재고: 100
        stockRepository.saveAndFlush(new Stock(1L, 100L));
    }

    @AfterEach
    public void after() {
        stockRepository.deleteAll();
    }

    @Test
    public void 재고감소() {
        stockService.decrease(1L,1L);
        //100 - 1 = 99
        Stock stock = stockRepository.findById(1L).orElseThrow();
        assertEquals(99, stock.getQuantity());
    }
}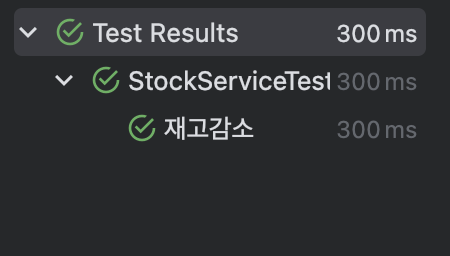
정상적으로 성공
2) 동시에 100개의 요청을 받는 케이스
    @Test
    public void 동시에_100개의_요청() throws InterruptedException {
        int threadCnt = 100;
        ExecutorService executorService = Executors.newFixedThreadPool(32);

        //100 개의 요청이 끝날 때까지 기다려야하므로 다른 스레드에서 수행중인 작업이 끝날 떄까지 대기시켜줌
        CountDownLatch latch = new CountDownLatch(threadCnt);

        for (int i = 0; i < threadCnt; i++) {
            executorService.submit(() -> {
                try{
                    stockService.decrease(1L,1L);
                } finally {
                    latch.countDown();
                }
            });
        }

        latch.await();

        Stock stock = stockRepository.findById(1L).orElseThrow();
        // 100 - (1 * 100) = 0;
        assertEquals(0, stock.getQuantity());
    }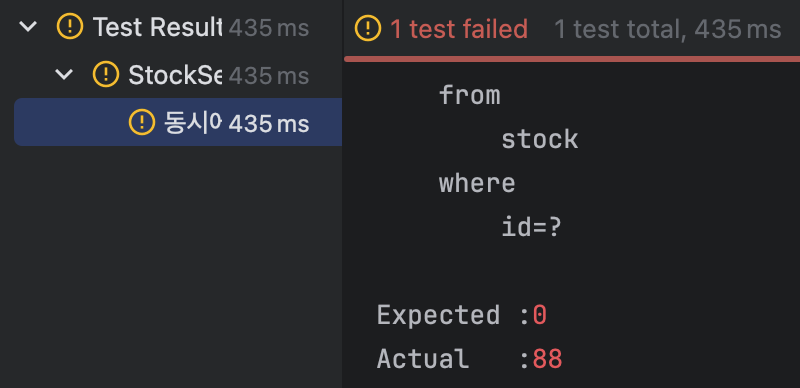
1개씩 100번 감소시켜야하므로 예상으론 0 을 반환해야하지만
위와 같은 결과가 나왔다.
이유는 Race Condition
위 테스트의 동작이 동기방식이었다면
스레드 1의 가져간 데이터를 스레드2 는 건드리지못하고 처리가 완료될 때까지 기다려야한다.
하지만 비동기 멀티 스레드로 구성된 위 테스트의 경우
같은 데이터를 다중 스레드가 동시에 접근하기때문에 갱신 처리가 누락될 수 있다.
결론적으로 여러 스레드가 공유 데이터에 동시에 접근하여 변경하려하기때문에 발생하는 문제이다.
3. 해결
1) Java synchronized 로 해결해보기
//    @Transactional
    public synchronized void decrease(Long id, Long quantity) {
        Stock stock = stockRepository.findById(id).orElseThrow();
        stock.decrease(quantity);
        stockRepository.saveAndFlush(stock);
    }
synchronized 사용 시 트랜잭션을 쓰지 않는 이유
스프링에서는 트랜잭션 애너테이션을 쓰면 해당 클래스를 매핑한 클래스를 새로 만들어서 실행하게 되는데 트랜잭션 시작 시 메서드 호출 트랜잭션 종료하게되는데 트랜잭션 종료 시점에 데이터베이스에 업데이트하는데 decrease 메서드가 완료되고 데이터베이스에 업데이트하기전에 다른 스레드가 decrease 메서드를 호출할 수 있기때문에 이전과 동일한 문제가 발생할 수 있으므로 트랜잭션을 제거해준다
정상적으로 처리되었다.
synchronized 의 한계
synchronized 는 1개의 프로세스안에서만 보장된다.
서버 1대 일 때는 데이터베이스의 접근을 1대만 해서 괜찮지만,
서버 2대 이상일 때는 특정 데이터를 여러군데에서 접근이 가능해진다.
결국 A서버가 처리중인 데이터를 B서버가 접근할 수 있다는 가정이 된다.
보통 운영 환경에서는 2대 이상이 대부분이므로 이 방법은 지양한다.
2) MySQL 로 해결하기
Lock
여러 사용자가 동시에 같은 데이터에 접근할 때 데이터의 무결성과 일관성을 유지하기 위해 데이터 접근을 제어하는 기능입니다.한 세션(작업)이 데이터를 수정하거나 읽는 동안 다른 세션이 해당 데이터를 마음대로 변경하지 못하도록 잠그는 역할을 합니다.
1. Pessimistic Lock
- 실제로 데이터에 Loc k 을 걸어서 정합성을 맞추는 방법입니다. exclusive lock 을 걸게되면 다른 트랜잭션에서는 lock 이 해제되기전에 데이터를 가져갈 수 없게 됩니다. 데드락이 걸릴 수 있기 때문에 주의하여 사용하여 합니다.
예시
StockRepository.interface
public interface StockRepository extends JpaRepository<Stock, Long> {


    @Lock(LockModeType.PESSIMISTIC_WRITE)
    @Query("select s from stock s where s.id = :id")
    Stock findByIdWithPessimisticLock(Long id);
}
PessimisticLockService.class
public class PessimisticLockService {

    private final StockRepository stockRepository;

    public void decrease(Long id, Long quantity) {
        Stock stock = stockRepository.findByIdWithPessimisticLock(id);
        stock.decrease(quantity);
        stockRepository.saveAndFlush(stock);
    }
}
검증 결과:

    select
        s1_0.id,
        s1_0.product_id,
        s1_0.quantity
    from
        stock s1_0
    where
        s1_0.id=?
    for
        updateof s1_0      <- for updateof 쿼리를 실행하여 Lock을 획득 요청
발생된 쿼리 로그를 보면 FOR UPDATE OF 를 쿼리를 통해 스레드가 Lock 획득을 시도하는 것을 알 수 있습니다. Lock 을 획득한 스레드외에 다른 스레드는 Blocking 상태로 대기하고 있다가 끝나는 즉시 다른 스레드가 Lock 을 획득하고 decrease 로직을 처리한다고 보면 됩니다.
장점
- 충돌이 빈번하게 일어난다면, Optimistic 보다는 Lock 성능이 좋을 수 있습니다.
- Lock 을 통해 데이터를 제어하기 때문에 데이터의 정합성이 보장됩니다.
단점
- 별도의 락을 잡기 때문에 성능이 감소할 수 있습니다.
2. Optimistic Lock
- 실제로 Lock 을 이용하지 않고 버전을 이용함으로써 정합성을 맞추는 방법입니다. 먼저 데이터를 읽은 후에 update 를 수행할 때 현재 내가 읽은 버전이 맞는지 확인하며 업데이트합니다. 내가 읽은 버전에서 수정사항이 생겼을 경우에는 application 에서 다시 읽은 후에 작업을 수행해야 합니다.
Stock.class
public class Stock {

    @Id @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;
    private Long productId;
    private Long quantity;

    //스레드 접근 조건으로 쓸 버전 컬럼 추가
    @Version
    private Long version;
stockRepository.interface
public interface StockRepository extends JpaRepository<Stock, Long> {

    @Lock(LockModeType.OPTIMISTIC)
    @Query("select s from stock s where s.id = :id")
    Stock findByIdWithOptimisticLock(Long id);
}
OptimisticLockService.class
@Service
@RequiredArgsConstructor
public class OptimisticLockService {

    private final StockRepository stockRepository;


    @Transactional
    public void decrease(Long id, Long quantity) {
        Stock stock = stockRepository.findByIdWithOptimisticLock(id);
        stock.decrease(quantity);
        stockRepository.saveAndFlush(stock);
    }
}
OptimisticLockFacade.class
@Component
@RequiredArgsConstructor
public class OptimisticLockStockFacade {

    private final OptimisticLockService optimisticLockService;


    public void decrease(Long id, Long quantity) throws InterruptedException {
        while (true) {
            try {
                optimisticLockService.decrease(id, quantity);
                break;
            } catch (Exception e) {
                Thread.sleep(50);
            }
        }

    }
}
검증 결과:

    update
        stock
    set
        product_id=?,
        quantity=?,
        version=?
    where
        id=?
        and version=?
100개의 스레드가 동시에 version = 0 인 데이터를 조회한 뒤 업데이트를 던지기 때문에, 가장 먼저 도달한 스레드 딱 1개만 수정에 성공하고 나머지 스레드는 수정 실패하게 됩니다.
이 때 실패한 스레드들은 다시 최신 version을 조회한 뒤 OptimisticLockFacade 에 정의된 while 문으로 재시도하는 로직을 실행합니다. 또한 스레드가 업데이트가 성공할 때마다 version += 1 을 수행하게 됩니다.
장점
- 별도의 락을 잡지 않으므로 Pessimistic Lock 보다 성능상의 이점이 있습니다.
단점
- 업데이트가 실패했을 때 재시도 로직을 개발자가 직접 작성해야하는 번거로움이 있습니다.
3. Named Lock
이름을 가진 metadata locking 입니다. 이름을 가진 lock 을 획득한 후 해제할때까지 다른 세션은 이 lock 을 획득할 수 없도록 합니다. 주의할 점으로는 transaction 이 종료될 때 lock 이 자동으로 해제되지 않습니다. 별도의 명령어로 해제를 수행해주거나 설정 시간이 끝나야 해제됩니다.
예시 주의: 실무에서는 데이터소스는 분리해야함
NamedLockRepository.interface
public interface LockRepository extends JpaRepository<Stock, Long> {

   @Query(value = "select get_lock(:key, 3000)", nativeQuery = true)
   void getLock(String key);

   @Query(value = "select release_lock(:key)", nativeQuery = true)
   void releaseLock(String key);
}
NamedLockStockFacade.class
public class NamedLockStockFacade {

   private final LockRepository lockRepository;
   private final StockService stockService;

   @Transactional
   public void decrease(Long id, Long quantity) {
       try{
           lockRepository.getLock(id.toString());
           stockService.decrease(id,quantity);
       } finally {
           lockRepository.releaseLock(id.toString());
       }
   }
}
StockService.class
public class StockService {

    private final StockRepository stockRepository;

    @Transactional(propagation = Propagation.REQUIRES_NEW)
    public void decrease(Long id, Long quantity) {
        Stock stock = stockRepository.findById(id).orElseThrow();
        stock.decrease(quantity);
        stockRepository.saveAndFlush(stock);
    }
}
검증 결과:

propagation = Propagation.REQUIRES_NEW
락의 획득 및 해제 주기와 비즈니스 로직의 트랜잭션 주기를 분리하여 데드락을 방지하고 동시성을 올바르게 제어를 가능하게 함
propagation = Propagation.REQUIRES_NEW 동작 흐름
1.부모 로직에서 네임드 락을 획득
2.REQUIRES_NEW 가 적용된 자식 메서드가 실행되면서 새로운 트랜잭션이 시작
3.비즈니스 로직 수행
4.자식 메서드가 끝나면서 즉시 DB에 커밋되어 실제 데이터가 반영
5.부모 로직으로 돌아와 네임드 락을 해제
변경된 데이터가 DB에 완벽하게 커밋된 것을 보장한 후에 락을 해제하므로
다음 스레드가 안전하게 최신 데이터를 읽어서 작업할 수 있습니다.
로그로 보는 스레드의 흐름
[ool-2-thread-12] : select get_lock(?, 3000)
[ool-2-thread-29] : select get_lock(?, 3000)
[ool-2-thread-28] : select get_lock(?, 3000)
...
... TRACE ... binding parameter (1:VARCHAR) <- [1] // '1'이라는 이름의 락 요청- 이후 대기하던 스레드 중 락을 가진 스레드들이 하나씩 재고 감소 로직을 수행한다.
// 락을 얻고 재고를 조회
[ool-2-thread-22] : select s1_0.id ... from stock s1_0 where s1_0.id=?

// 재고를 99로 감소
[ool-2-thread-22] : update stock set quantity=? ... where id=?
... TRACE ... binding parameter (2:BIGINT) <- [99]

// 로직이 끝나고 락 반납
[ool-2-thread-22] : select release_lock(?)
장점:
- 분산락을 구현할 때 용이합니다.
- 타임아웃을 손쉽게 구현할 수 있습니다.
단점:
- 트랜잭션 종료 시에 락 해제, 세션 관리에 주의가 필요하고, 실무에서 사용 시 구현 방법이 복잡할 수 있습니다.
3) 레디스 사용하기
Lettuce
- setnx 명령어를 활용하여 분산락 구현
- spin lock 방식
RedisLockRepository.interface
public class RedisLockRepository {

    private final RedisTemplate<String,String> redisTemplate;

    public Boolean lock(Long key) {
        return redisTemplate
                .opsForValue()
                .setIfAbsent(generateKey(key),"lock", Duration.ofMillis(3_000));
    }

    public Boolean unlock(Long key) {
        return redisTemplate.delete(generateKey(key));
    }

    private @NonNull String generateKey(Long key) {
        return key.toString();
    }
}
LettuceLockFacade.class
public class LettuceLockFacade {

    private final StockService stockService;
    private final RedisLockRepository redisLockRepository;

    public void decrease(Long id, Long quantity) throws InterruptedException {
        while (!redisLockRepository.lock(id)) {
            Thread.sleep(100);
        }

        try {
            stockService.decrease(id,quantity);
        }  finally {
            redisLockRepository.unlock(id);
        }
    }
}
검증 결과:
(스레드 20) -> quantity=[99], version=[1] (초반엔 순차 처리)
(스레드 20) -> quantity=[98], version=[2]
...
(스레드 19) -> quantity=[30], version=[70]
(스레드 9)  -> quantity=[29], version=[71]
(스레드 6)  -> quantity=[28], version=[72]
Lettuce 는 Redis 의 SETNX 라는 명령어를 이용하여 락을 잡는데, 해당 Key 가 없을 때만 데이터를 저장합니다. 100개의 스레드가 동시에 이 명령을 Redis 에 던지면, Redis 는 싱글 스레드로 동작하기 때문에 처음 도달한 스레드 1개만 성공하고 나머지는 실패를 반환하는데, Lettuce 자체는 락이 풀렸을 때 대기 스레드들을 깨워주는 기능이 없어서 별도의 직접 루프를 돌려줘야합니다.
결국 작업을 마친 스레드는 key 를 삭제하여 락을 해제하고 Thread.sleep 가 풀린 스레드가 다음 차례로 락을 획득합니다.
장점:
- 구현이 간단함
단점:
- spin lock 방식으로 레디스에 부하를 줄 수 있으므로 스레드 슬립으로 lock 획득 재시도 간의 텀을 줘야함
Redisson
- pub/sub 기반으로 Lock 구현 제공
RedissonLockStockFacade.class
public class RedissonLockStockFacade {

    private final RedissonClient redissonClient;
    private final StockService stockService;

    public void decrease(Long key, Long quantity) {
        RLock lock = redissonClient.getLock(key.toString());

        try {
            boolean available = lock.tryLock(10, 1, TimeUnit.SECONDS);

            if (!available) {
                System.out.println("lock 획득 실패");
                return;
            }

            stockService.decrease(key, quantity);
        } catch (InterruptedException e) {
            throw new RuntimeException(e);
        } finally {
            lock.unlock();
        }
    }
}
검증 결과:
update stock set product_id=?, quantity=?, version=? where id=? and version=?
binding parameter (2:BIGINT) <- [90]  | binding parameter (5:BIGINT) <- [9]
...
binding parameter (2:BIGINT) <- [79]  | binding parameter (5:BIGINT) <- [20]
...
binding parameter (2:BIGINT) <- [0]   | binding parameter (5:BIGINT) <- [99]
Redisson 은 Redis 의 Pub/Sub 기능을 활용하여 락이 해제되면 대기 중인 스레드들에게 신호를 보내는 방식으로 획득 실패 시 무한 루프를 돌지 않고 신호를 받았을 때만 락 획득을 시도하므로 Redis 에 주는 부담이 크게 줄어듭니다. (낙관적 락과 유사함)
장점
- 레디스 부하 최소화
- 타임 아웃 설정 지원
단점
- 별도의 라이브러리 의존성 추가
- 구현 복잡도 증가