ai 가 온라인 강의를 대체할 수 있을까? 해서 해보는 ai 선생님으로 학습해보기
1.메모리 계층 구조와 레디스의 탄생 배경
왜 RDB가 있는데 레디스가 필요할까?
그 근본은 컴퓨터 아키텍처의 메모리 계층 구조에 있습니다.
-
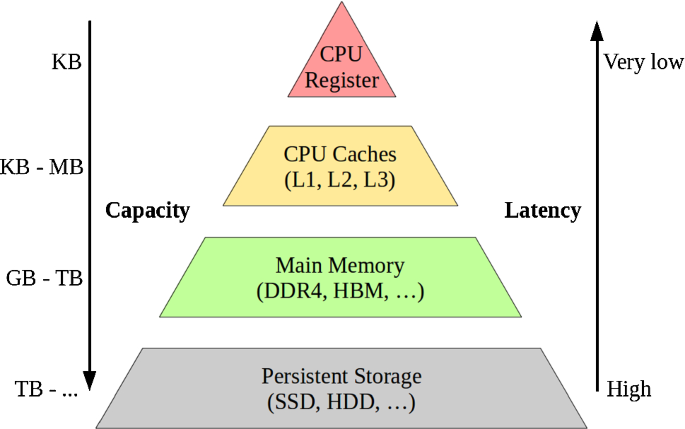
속도와 용량의 트레이드오프: CPU 레지스터, 캐시 메모리(L1, L2, L3), 메인 메모리(RAM),보조기억장치(SSD/HDD) 순으로 갈수록 용량은 커지지만 속도는 기하급수적으로 느려집니다.
-
디스크 I/O의 한계: MySQL,PostgreSQL 같은 RDB 는 데이터의 영속성을 보장하기 위해 최종적으로 디스크에 데이터를 씁니다. 디스크는 물리적인 탐색 시간이나 페이지 단위 I/O 연산이 필요하므로, 메모리 접근에 비해 수백~수천 배 느립니다.
-
인메모리의 강점: 레디스는 모든 데이터를 메인 메모리에 상주시켜 CPU 가 디스크 I/O 없이 데이터에 즉시 접근하게 합니다. 이 덕분에 초당 수십만 건의 연산을 처리할 수있는 구조적 우위를 가집니다.
2.레디스의 싱글 스레드 아키텍처 원리
1) 왜 싱글 스레드인가?
-
Context Switch 비용 제거: 멀티 스레드 환경에서는 CPU가 여러 스레드를 오가며 말할 때 '컨텍스트 스위칭'이라는 오버헤드가 발생하지만 레디스는 발생하지 않습니다.
-
Race Condition 배제: 여러 스레드가 동시에 같은 데이터에 접근할 때 발생하는 동기화 문제(Locking, 데드락)가 발생하지 않습니다. 즉, 원자성을 보장하기 위해 무거운 락을 걸 필요가 없으므로 연산이 매우 단순하고 빨라집니다.
-
CPU 가 아닌 메모리/네트워크가 병목: 레디스 개발자에 따르면, 일반적인 CPU 환경에서 레디스의 병목은 CPU 연산 속도가 아니라 메모리 대역폭이나 네트워크 I/O 에서 먼저 발생합니다.
2) 싱글 스레드임에도 어떻게 수많은 요청을 처리할 수 있을까?
I/O Multiplexing
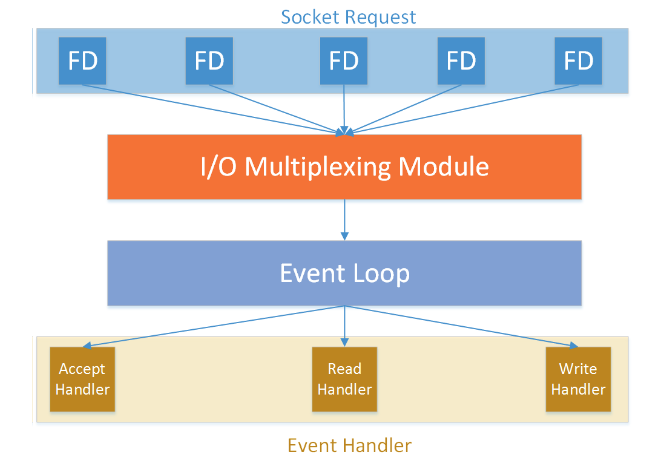
레디스는 비동기 논블로킹 I/O 멀티플렉싱 모델을 사용합니다. select, poll, epoll 같은 시스템 콜을 이용해, 하나의 스레드가 수많은 네트워크 소켓 연결을 감시하고 있다가, 데이터가 들어온 소켓만 골라내어 순차적으로 처리합니다.
⚠️ 주의점
싱글 스레드라는 것은 "앞의 명령어가 끝나야 뒤의 명령어가 실행된다" 뜻이므로 시간 복잡도가 인 무거운 명령어(KEYS *, FLUSHALL, SMEMBERS 등)을 운영 환경에서 실행하면, 레디스가 그 명령어를 처리하느라 뒤에 들어오는 모든 가벼운 요청들을 블로킹해버려 대형 장애로 이어질 수 있습니다.
3. 캐시의 필요성과 차이
파레토의 법칙: '전체 결과의 80%가 전체 원인의 20%에서 일어난다' 는 현상
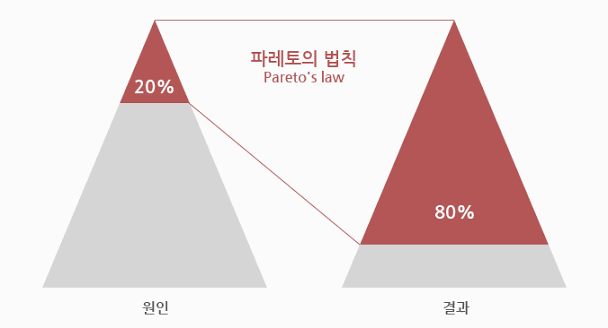
캐싱이 왜 효율적인지 알려주는 근본적인 인간 행동 패턴의 법칙입니다.
모든 데이터를 캐싱할 필요 없이, 자주 찾는 20% 만 잘 관리해도 시스템 성능이 비약적 상승할 수 있습니다.
데이터 저장 구조의 차이
-
RDB: 데이터의 영속성을 위해 하드 디스크에 데이터를 저장하므로 디스크 I/O 가 발생해 상대적으로 느립니다.
-
Redis: 모든 데이터를 메모리에 올려두고 처리하는 인메모리 데이터 구조 저장소입니다. 메모리 접근 속도는 디스크보다 수백~수천 배 빼르기 때문에 Read 성능이 압도적입니다.
4. 캐싱 전략
레디스를 어떤 구조로 배치하고 데이터를 읽고 쓸 것인지를 결정하는 핵심 아키텍처 이론
읽기 전략과 쓰기 전략으로 나뉩니다.
1) 읽기 전략
Look Aside
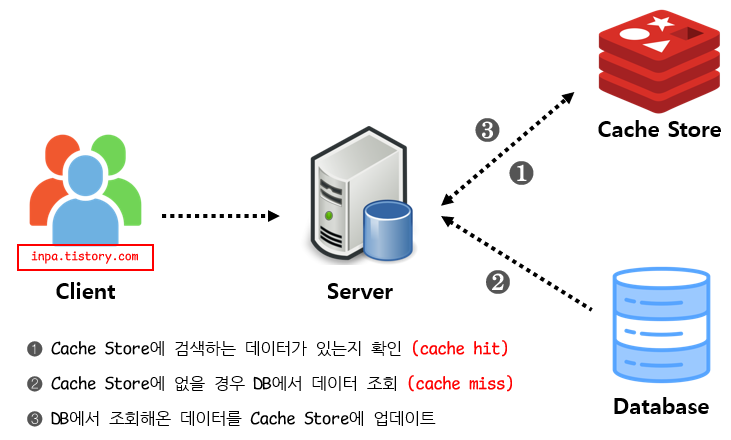
장점
레디스에 문제가 생겨도 RDB에서 데이터를 가져올 수 있어 장애 대처가 가능합니다.
단점
초기에 캐시 미스가 발생할 때 딜레이가 있고, RDB와 레디스 간 데이터 불일치가 발생할 수 있습니다.
2) 쓰기 전략
Write Around
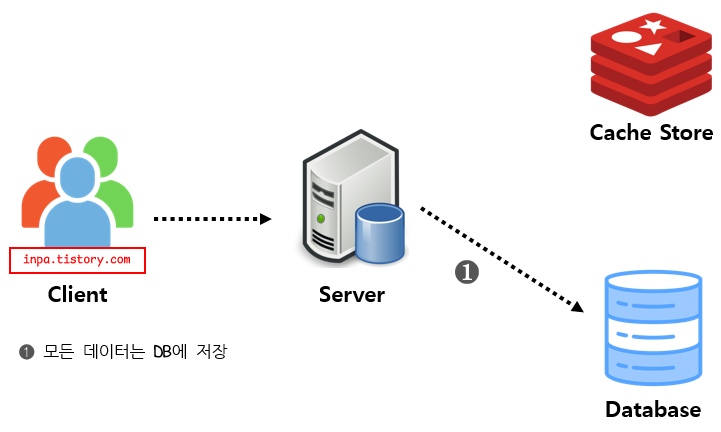
데이터를 저장할 때 RDB에만 저장하고, 캐시는 건드리지 않습니다. 캐시 미스가 발생했을 때만 캐시에 데이터가 올라갑니다.
장점
캐시 공간을 절약할 수 있습니다.
단점
데이터가 수정되어도 캐시에는 과거 데이터가 남아있을 수 있어 데이터 정합성 문제가 자주 발생합니다.
Write-Through
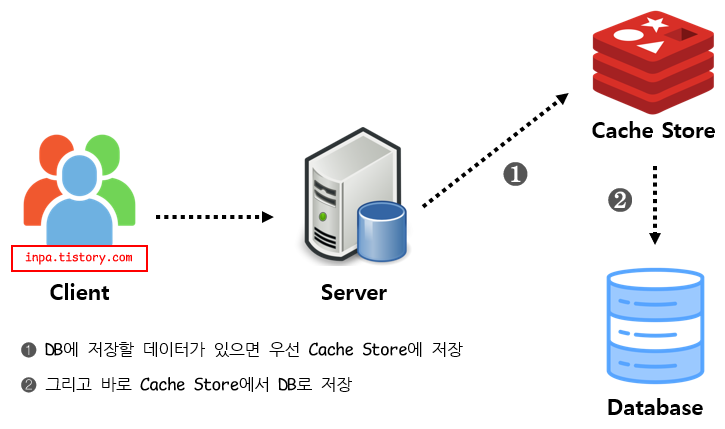
데이터를 저장할 때 RDB와 레디스에 동시에 저장합니다.
장점
캐시가 항상 최신 데이터를 유지합니다.
단점
쓸 때마다 두 곳에 저장하므로 쓰기 느려지고, 자주 안 쓰는 데이터도 캐시에 쌓여 메모리가 낭비됩니다.
5.만료 시간과 메모리 고갈 대책
메모리는 무한하지 않고 비용이 비쌉니다. 따라서 캐시 데이터의 생명 주기를 관리는 필수입니다.
TTL(Time To Live)
- 캐시 데이터가 유효한 시간을 설정하는 것입니다. TTL 이 지나면 데이터는 자동으로 삭제됩니다. 데이터 정합성 문제를 완화하는 가장 기본적인 장치입니다.
만약 레디스 메모리가 가득 차면?
- 제한된 메모리를 초과하여 데이터가 들어올 때, 레디스가 기존 데이터를 어떤 기준으로 지울지 결정하는 정책입니다.
- LRU(Least Recently Used): 가장 오랫동안 참조되지 않은 데이터를 삭제(가장 추천)
- LFU(Least Frequently Used): 가장 참조 횟수가 적은 데이터를 삭제
- Volatile-Iru: TTL이 설정된 키들 중에서만 LRU 알고리즘으로 삭제
6.레디스 타입과 명령어
1) String
- 레디스의 가장 기본적인 타입
- 숫자, 이미지와 같은 바이너리 데이터(최대 512MB)도 저장 가능
- SET
keyvalue: 특정 키에 값 저장 - GET
key: 특정 키 값 조회 - INCR / DECR
key: 값이 정수형태일 때 1씩 증감 - MSET / MGET: 여러 키-값을 한번에 저장하거나 조회
- SET
**사용 예시**: 사용자 토큰 세션 저장, HTML 페이지 캐싱, 단순 카운터(조회수 등)
2) Lists
- 문자열 요소들의 연결 리스트
- 데이터가 추가된 순서대로 저장
- 양방향 데이터를 넣거나 뺄 수 있어서 스택, 큐 구현할 때 유용
- LPUSH / RPUSH
keyvalue: 리스트 앞,뒤 값 추가 - LPOP / RPOP
key: 리스트 앞,뒤 값을 꺼내고 삭제 - LRANGE
keystartstop: 지정 범위 인덱스 요소 조회 - LLEN
key: 리스트 전체 길이 반환
- LPUSH / RPUSH
사용 예시: 타임라인의 최근 게시물 목록, 메시지 큐
3) Sets
- 중복을 허용하지 않는 문자열의 무작위 집합
- 순서 보장되지 않음
- 집합 연산을 빠르게 수행 가능
- SADD
keymember: 집합에 요소 추가 - SREM
keymember: 집합에서 특정 요소 제거 - SISMEMBER
keymember: 특정 요소가 집합에 포함되어 있는지 확인(참이면 1, 거짓이면 0) - SMEMBERS
key: 집합에 속한 모든 요소를 반환 - SINTER / SUNION / SDIFF: 여러 집합의 교집합,합집합,차집합을 구함
- SADD
사용 예시: 유니크 방문자 수 카운팅, 친구 추천 기능(공통 친구 찾기), 태그 시스템
4) Hashes
- 필드-값 쌍으로 이루어진 Map 구조
- 객체 형태의 데이터를 표현하기 적합
- HSET
keyfieldvalue: 특정 해시 키 내의 필드에 값 저장 - HGET
keyfield: 특정 필드의 값 조회 - HGETALL
key: 해당 해시 키에 저장된 모든 필드와 값 반환 - HDEL
keyfield: 특정 필드 삭제
- HSET
사용 예시: 사용자 프로필 정보(이름,이메일,나이 등) 저장
Sorted Sets (정렬된 셋)
- Set 과 마찬가지로 중복을 허용하지 않지만 요소마다 가중치를 같이 저장
- 가중치를 기준으로 요소를 자동으로 정렬 상태 유지
- ZADD
keyscoremember: 가중치와 함께 요소 추가 - ZRANGE
keystartstop[WITHSCORES]: 가중치 오름차순으로 정렬된 범위를 조회 - ZREVRANGE
keystartstop: 가중치 내림차순으로 정렬된 범위를 조회 - ZREM
keymember: 특정 요소를 제거 - ZRANK / ZREVRANK
keymember: 오름/내림차순 기준 특정 요소의 순위(인덱스)
를 조회
- ZADD
사용 예시: 게임 점수 랭킹 시스템, 실시간 인기 검색어 리스트
이미지 & 자료 출처
https://inpa.tistory.com/