[개발지식] Web Application의 상호보완적 Eventually Consistency #5 - Job Parameter의 한계와 Spring Batch Listener(Interface).
개발지식
1. 개요
Spring Batch를 진행하면서 Batch처리의 세부적인 순간들, 즉 Job과 Step의 처리전/후 및 Chunk 처리전/후, ItemRead/Process/Write 처리전/후 등 요구사항에 따라 원하는 시점의 이벤트를 감지하고 특정 로직을 수행할 수 있다.
사실 Listener보다는 AOP에 가까운 관심사적 처리인데, Spring Batch는 이를 interface로써 구현하여 개발자들의 편의성을 증대하고 구현을 더 효율적으로 할 수 있도록 도움을 주었다.
지금까지는 Spring Batch의 본질에 대해 알아보았다면, 이번에는 Spring Batch Listener를 활용하여 실무적으로 어떻게 적용할 수 있을지 분석해보았다.
2. Listener 종류
Spring Batch에서 각각의 처리 시점을 세분화하여 제공해주는 기능 및 이에 대한 범위는 다양하고, 개발자는 이를 활용하여 알맞은 처리시점에 관심사 로직을 구현할 수 있다.
그 종류로,
- JobExecutionListener
- beforeJob/afterJob - StepExecutionListener
- beforeStep/afterStep - ChunkListener
- beforeChunk/afterChunk/afterChunkError - Item(Read/Process/Writer)Listener
- beforeRead/afterRead/onReadError
와 같이 존재하며 각 DSL API에서 볼 수 있듯이, 실행 전후 혹은 실행 중 오류발생 시점 등 다양한 타이밍에 대해 원하는 로직을 구현할 수 있도록 지원한다.
참고로
- JobExecutionListener의 afterJob은 jobLauncer에 의해 job 실행 후, 메타데이터(JobExecution 등)에 해당 내역을 저장하기 전의 시점이다.
- afterChunk는 트랜잭션 커밋 후 호출되며, 청크처리 도중 예외 발생 시 롤백 후 afterChunkError()를 호출한다.
- ItemReadListener의 afterRead는 읽을 아이템이 없다면 호출되지 않는다.
- ItemProcessListener의 afterProcess는 메서드가 null 을 반환하더라도 호출된다(가공하는 작업은 null과 상관없이 진행).
- ItemWriterListener의 afterWrite는 트랜잭션이 커밋되기 전, ChunkListenerAfterChunk는 커밋 후에 발생하는 타이밍에 유의한다.
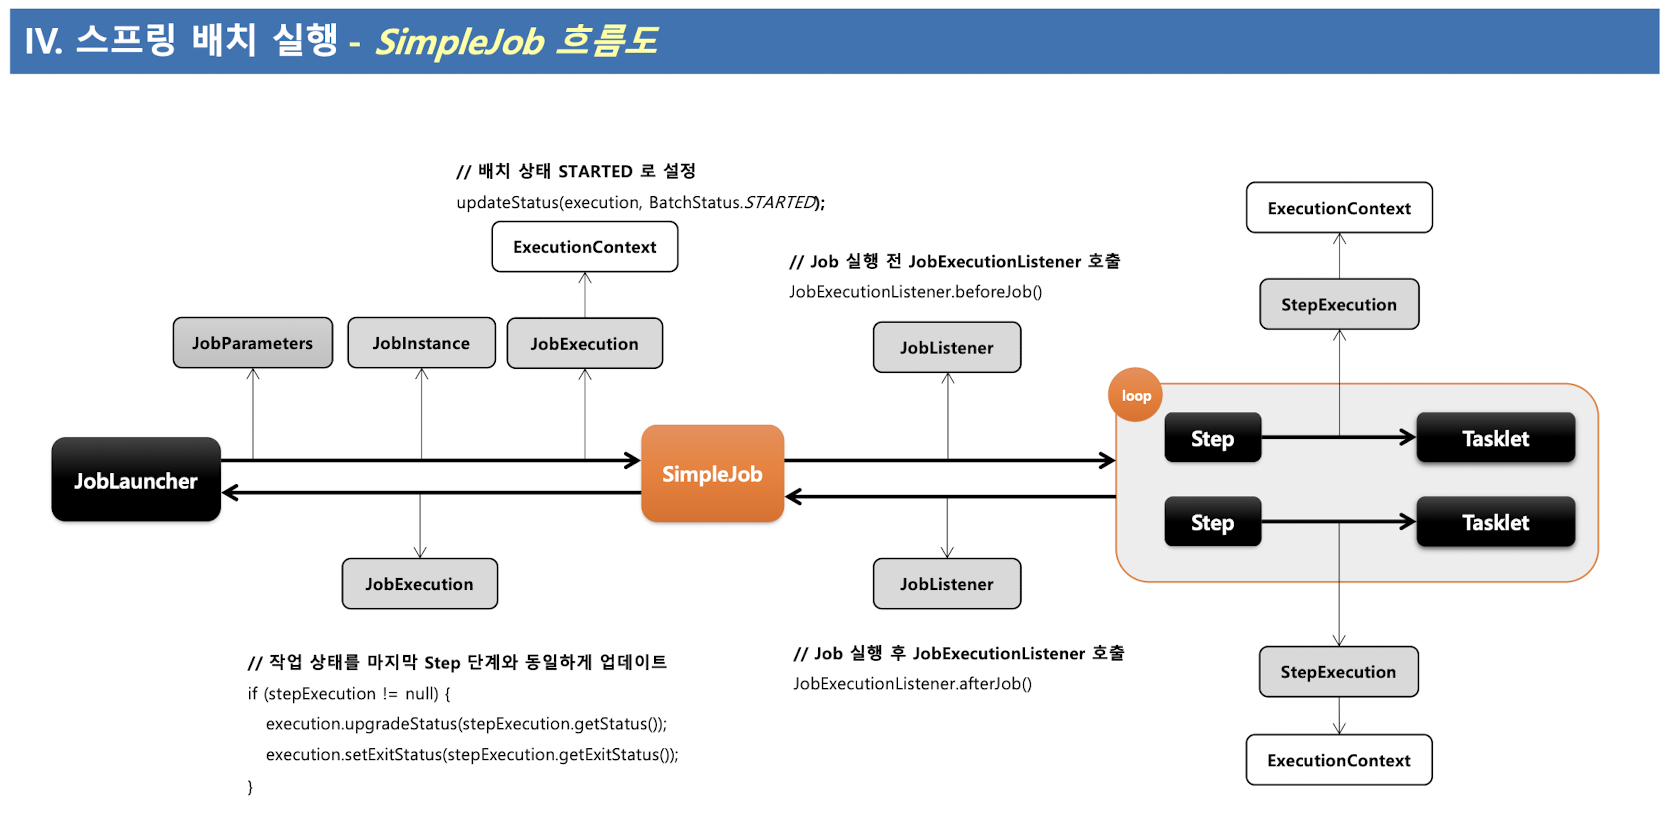
JobLauncer를 시작하여 batch job이 시작하고 끝날때까지의 과정을 하나의 모식도로 나타내면 위와 같다.
참고로 위의 경우는 tasklet의 경우이고, chunk 지향처리라면 앞서 언급했던대로 beforeChunk/afterChunk부터 시작하여(*각각 chunk item read전/커밋 후 발동), 내부적으로 item beforeRead/afterRead/...afterWrite(커밋 전)의 동작을 수행하는 과정이 추가된다.
3. Listener 활용방안
WAS Servlet나 Spring Batch의 Servlet/FilterChaining처럼 Listener를 활용하여 단순 로깅작업 이외 여러 부가 관심사/공통로직을 구현하여 편리하게 Spring Batch 작업을 관리할 수 있다.
- job/Step/Chunk 등 단계별 처리 모니터링(시작시점/종료시점/데이터 처리 개수) 등을 통해 데이터 리포팅이 가능하다.
- job/step에서 각각의 afterJob/afterStep 등을 통해 종료상태를 확인한 후 이에 대한 상응조치를 별도로 구현해줄 수 있다.
- Job/Step 실행후 각각의 처리내역은 JobExecution, StepExecution라는 메타데이터에 저장되어 RDBMS로 전달될 준비를 마치는데, 이때 Listener를 활용하여 해당 ExecutionContext에 필요 데이터를 추가정제하거나 수정할 수 있고 Step간의 데이터 전달 및 공유가 가능해진다.
- 공통 관심사 로직을 분리하여, 단순 로직을 원하는 시점에 언제든지 추가, 제거할 수 있다.
4. Listener 구현방안
구현방안은 크게 두가지가 있다.
- Listener 인터페이스를 직접 오버라이드하여 구현한다.
- Listener 어노테이션을 활용하여 런타임에 리플렉션한다.
4-1. Listener interface Override
리스너 인터페이스를 구현한 클래스를 빈객체로 생성하여 Spring Batch 실행 시 AOP로 해당 로직을 실행하도록 의도할 수 있다.
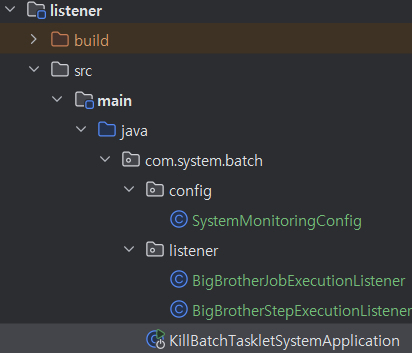
먼저, Batch 구성을 "비즈니스 업무단위"로 위와 같이 구성해주고, util성 클래스인 listener만 따로 빼주도록 한다.
Job/Step과 같이 기능별로 나누게 되면 각각 어떠한 job/step에 대한 내용인지 분간이 안가기도 하고, 가독성이 떨어지므로 비즈니스 단위의 구성이 필요하다.
이후 JobListener와 StepListener를 구성해주도록 한다(이때 각 구현체들은 인터페이스들을 구현한 클래스들이다).
@Slf4j
@Component
public class BigBrotherJobExecutionListener implements JobExecutionListener {
    @Override
    public void beforeJob(JobExecution jobExecution){
      log.info("This is BigBrotherJobExecutionListener.beforeJob");
    }

    @Override
    public void afterJob(JobExecution jobExecution){
        log.info("This is BigBrotherJobExecutionListener.afterJob");
        log.info("Check the jobExecution status : {}", jobExecution.getStatus());
    }
}
@Slf4j
@Component
public class BigBrotherStepExecutionListener implements StepExecutionListener {
@Override
public void beforeStep(StepExecution stepExecution) {
log.info("This is BigBrotherStepExecutionListener.beforeStep");
}
@Override
public ExitStatus afterStep(StepExecution stepExecution) {
log.info("This is BigBrotherStepExecutionListener.afterStep");
log.info("Check the stepExecution status : {}", stepExecution.getStatus());
return ExitStatus.COMPLETED;
}
}그리고 배치 메인로직을 구현해준다. 위에서 언급하였듯, job/step을 굳이 나눌필요는 없고 하나의 배치 컴포넌트로 작성하도록 한다.
@Slf4j
@Configuration
public class SystemMonitoringConfig {

    private final JobRepository jobRepository;
    private final PlatformTransactionManager transactionManager;

    public SystemMonitoringConfig(JobRepository jobRepository, PlatformTransactionManager transactionManager) {
        this.jobRepository = jobRepository;
        this.transactionManager = transactionManager;
    }

    @Bean
    public Job systemMonitoringJob(JobRepository jobRepository) {
        return new JobBuilder("systemMonitoringJob", jobRepository)
                .listener(new BigBrotherJobExecutionListener())
                .start(systemMonitoringStep())
                .build();
    }

    @Bean
    public Step systemMonitoringStep(){
        return new StepBuilder("completeQuestStep", jobRepository)
        		.listener(new BigBrotherStepExecutionListener())
                .tasklet((contribution, chunkContext) -> {
                    System.out.println("complete quest.");
                    System.out.println("Congratulations! Your Batch Step has just reached the basic one!");
                    return  RepeatStatus.FINISHED;
                }, transactionManager)
                .build();
    }
}
여기서 유의할 점은 우리가 구성한 리스너를 각각의 job, step빌더에서 제공해주는 dsl API를 활용하여(listener) 구성해주었다는 점이다.
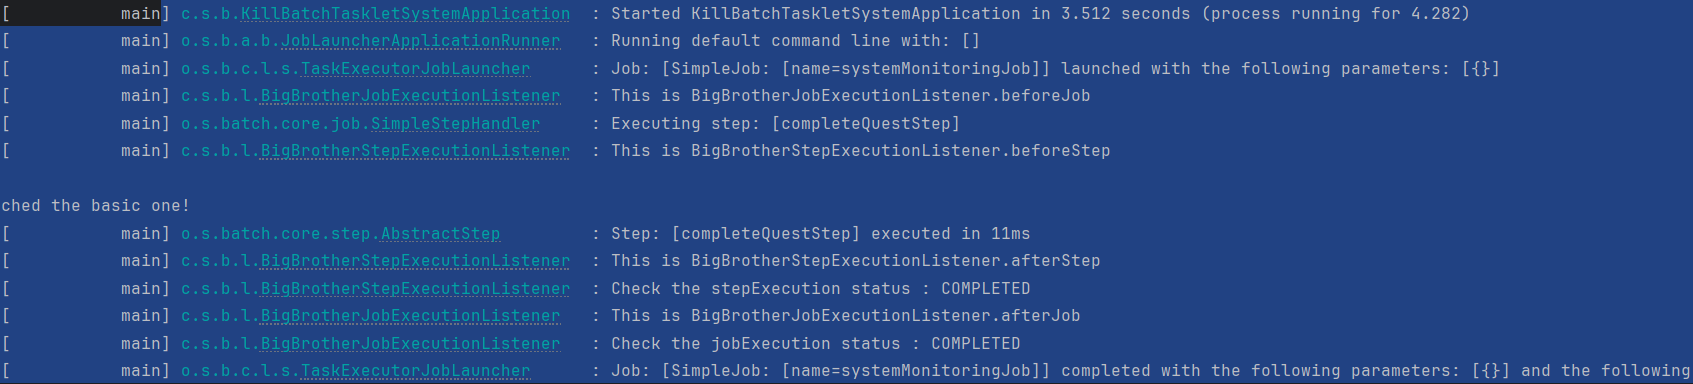
이에 대해 배치를 실행해준다면, 예상했던대로
- beforeJob
- Executing Job
- Executing Step
- before Step
- after Step
- after Job
순으로 진행됨을 로그로 살펴볼 수 있다.
참고로, JobExectution을 제외한 나머지 Step/ItemReading/ItemProcessing/ItemWriting/Chunk 등의 listener들은 Step에서 제공해주는 listener에 추가해주면 된다.
또한 StepListener의 afterStep의 경우 커밋 이후에 작동하는 리스너로써, 다음 단계인 job에게 해당 상태를 전달해주기 위해 반드시 ExitStatus의 반환타입을 명기해주어야 한다.
4-2. 어노테이션 활용
어노테이션을 활용하여 리스너를 구현할 수도 있다.
로직은 모두 동일하나, 단지 어노테이션을 활용했느냐 안했느냐의 차이일 뿐이다.
@Slf4j
@Component
public class BigBrotherJobExecutionListener implements JobExecutionListener {
//    @Override
//    public void beforeJob(JobExecution jobExecution){
//      log.info("This is BigBrotherJobExecutionListener.beforeJob");
//    }

      @BeforeJob
      public void beforeJob(){
        log.info("This is BigBrotherJobExecutionListener.beforeJob");
      }

//    @Override
//    public void afterJob(JobExecution jobExecution){
//        log.info("This is BigBrotherJobExecutionListener.afterJob");
//        log.info("Check the jobExecution status : {}", jobExecution.getStatus());
//    }

      @AfterJob
      public void afterJob(){
          log.info("This is BigBrotherJobExecutionListener.afterJob");
      }
}
@Slf4j
@Component
public class BigBrotherStepExecutionListener implements StepExecutionListener {
// @Override
// public void beforeStep(StepExecution stepExecution) {
// log.info("This is BigBrotherStepExecutionListener.beforeStep");
// }
@BeforeStep
public void beforeStep(StepExecution stepExecution){
log.info("This is BigBrotherStepExecutionListener.beforeStep");
}
// @Override
// public ExitStatus afterStep(StepExecution stepExecution) {
// log.info("This is BigBrotherStepExecutionListener.afterStep");
// log.info("Check the stepExecution status : {}", stepExecution.getStatus());
// return ExitStatus.COMPLETED;
// }
@AfterStep
public ExitStatus afterStep(StepExecution stepExecution){
log.info("This is BigBrotherStepExecutionListener.afterStep");
return ExitStatus.COMPLETED;
}
}참고로 이 역시 마찬가지로 StepExecution의 AfterStep의 반환타입은 반드시 ExitStatus로 명기해주도록 하며, 이를 지키지 않을 경우 애초부터 컴파일 오류가 발생한다.
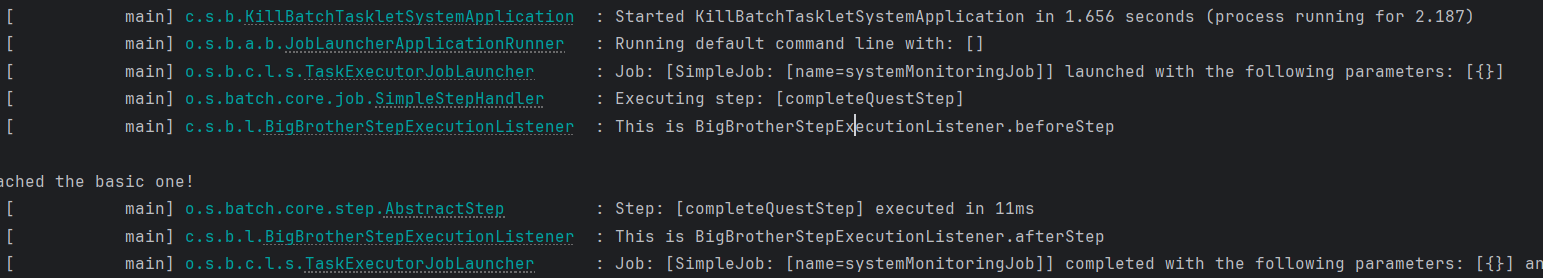
어노테이션을 활용하였을 경우에도 동일한 배치 실행 결과를 얻을 수 있다.
어노테이션은 각 인터페이스가 제공해주는 시점 모두 그대로, 동일하게 적용이 가능하며, 참고로 OnSkipInProcess/OnSkipInRead/OnSkipInWrite과 같이 배치의 skip 시점까지 리스너를 적용할 수 있다는 점을 기억한다.
5. 동적인 파라미터 조정/정제/추가 작업을 위한 리스너 활용방안
앞서 Step에 파라미터를 정제하거나 추가한 내용을 리스너를 통해 공유받을 수 있다고 하였는데, 이를 JobExecutionListener와 ExecutionContext를 통해 구현할 수 있다.
큰 흐름을 먼저 말하자면,
- Listener를 통한 정제
- job/step/tasklet을 통한 정제
로 상기와 같이 크게 두가지 방법으로 파라미터 조정을 할 수 있다.
/*
* listener를 통한 동적 구성
* */
@Slf4j
@Component
public class InfiltrationPlanListener implements JobExecutionListener {

    //before job : jobExecution에 동적인 파라미터 구성
    @Override
    public void beforeJob(JobExecution jobExecution) {
        Map<String, Object> infiltrationPlan = generateInfiltrationPlan();
        jobExecution.getExecutionContext().put("infiltrationPlan", infiltrationPlan);
        log.info("새로운 침투 계획이 준비됐다: {}",  infiltrationPlan.get("targetSystem"));
    }

    private Map<String, Object> generateInfiltrationPlan() {
        List<String> targets = List.of(
                "판교 서버실", "안산 데이터센터"
        );
        List<String> objectives = List.of(
                "kill -9 실행", "rm -rf 전개", "chmod 000 적용", "/dev/null로 리다이렉션"
        );
        List<String> targetData = List.of(
                "코어 덤프 파일", "시스템 로그", "설정 파일", "백업 데이터"
        );
        List<String> requiredTools = List.of(
                "USB 킬러", "널 바이트 인젝터", "커널 패닉 유발기", "메모리 시퍼너"
        );

        Random rand = new Random();

        Map<String, Object> infiltrationPlan = new HashMap<>();

        //targets/objectives/targetData/requiredTools 리스트의 숫자 내 난수를 1개 지정한다(=rand.nextInt)
        //이 중 1개 = 1 of List<String> = String.
        infiltrationPlan.put("targetSystem", targets.get(rand.nextInt(targets.size())));
        infiltrationPlan.put("objective", objectives.get(rand.nextInt(objectives.size())));
        infiltrationPlan.put("targetData", targetData.get(rand.nextInt(targetData.size())));
        infiltrationPlan.put("requiredTools", requiredTools.get(rand.nextInt(requiredTools.size())));

        return infiltrationPlan;
    }

    //after job :
    @Override
    public void afterJob(JobExecution jobExecution) {
        String infiltrationResult = (String) jobExecution.getExecutionContext().get("infiltrationResult");
        Map<String, Object> infiltrationPlan = (Map<String, Object>)
                jobExecution.getExecutionContext().get("infiltrationPlan");

        log.info("타겟 '{}' 침투 결과: {}", infiltrationPlan.get("targetSystem"), infiltrationResult);

        if ("TERMINATED".equals(infiltrationResult)) {
            log.info("시스템 제거 완료. 다음 타겟 검색 중...");
        } else {
            log.info("철수한다. 다음 기회를 노리자.");
        }
    }
}
위와 같이 리스너를 통해 동적 파라미터 주입 및 정제가 가능한데,
jobExecution.getExecutionContext().put("infiltrationPlan", infiltrationPlan);를 통해 파라미터를 구성한다는 점
String infiltrationResult = (String) jobExecution.getExecutionContext().get("infiltrationResult");
Map<String, Object> infiltrationPlan = (Map<String, Object>)
jobExecution.getExecutionContext().get("infiltration 를 통해 이미 구성한 잡파라미터들을 적절하게 추출해온다는 점
이 두가지 요소를 집중적으로 살펴보면 좋겠다.
/*
* job/step/tasklet을 통한 동적 구성
* */
@Slf4j
@Configuration
@RequiredArgsConstructor
public class AdvancedSystemInfiltrationConfig {
    //생성자 주입 by RequiredArgsConstructor
    private final InfiltrationPlanListener infiltrationPlanListener;

//    public AdvancedSystemInfiltrationConfig(InfiltrationPlanListener infiltrationPlanListener) {
//        this.infiltrationPlanListener = infiltrationPlanListener;
//    }

    @Bean
    public Job systemInfiltrationJob(JobRepository jobRepository, Step reconStep, Step attackStep) {
        return new JobBuilder("systemInfiltrationJob", jobRepository)
                .listener(infiltrationPlanListener)
                .start(reconStep)
                .next(attackStep)
                .build();
    }

    @Bean
    public Step reconStep(JobRepository jobRepository, PlatformTransactionManager transactionManager) {
        return new StepBuilder("reconStep", jobRepository)
                .tasklet((contribution, chunkContext) -> {
                    Map<String, Object> infiltrationPlan = (Map<String, Object>)
                            chunkContext.getStepContext()
                                    .getJobExecutionContext()
                                    .get("infiltrationPlan");
                    log.info("침투 준비 단계: {}", infiltrationPlan.get("targetSystem"));
                    log.info("필요한 도구: {}", infiltrationPlan.get("requiredTools"));
                    return RepeatStatus.FINISHED;
                }, transactionManager)
                .build();
    }

    @Bean
    public Step attackStep(
            JobRepository jobRepository,
            PlatformTransactionManager transactionManager,
            Tasklet attackStepTasklet  // 주입받은 Tasklet 사용
    ) {
        return new StepBuilder("attackStep", jobRepository)
                .tasklet(attackStepTasklet, transactionManager)
                .build();
    }

    @Bean
    @StepScope
    public Tasklet attackStepTasklet(
            @Value("#{jobExecutionContext['infiltrationPlan']}") Map<String, Object> infiltrationPlan
    ) {
        return (contribution, chunkContext) -> {
            log.info("시스템 공격 중: {}", infiltrationPlan.get("targetSystem"));
            log.info("목표: {}", infiltrationPlan.get("objective"));

            Random rand = new Random();
            boolean infiltrationSuccess = rand.nextBoolean();

            if (infiltrationSuccess) {
                log.info("침투 성공! 획득한 데이터: {}", infiltrationPlan.get("targetData"));
                contribution.getStepExecution().getJobExecution().getExecutionContext()
                        .put("infiltrationResult", "TERMINATED");
            } else {
                log.info("침투 실패. 시스템이 우리를 감지했다.");
                contribution.getStepExecution().getJobExecution().getExecutionContext()
                        .put("infiltrationResult", "DETECTED");
            }

            return RepeatStatus.FINISHED;
        };
    }
}
마지막으로 Job/Step/Tasklet 레벨에서 동적 파라미터 주입 및 사용이 가능한데,
- job에서는 .listener(infiltrationPlanListener)를 통해 동적 파라미터 주입
- step에서는
Map<String, Object> infiltrationPlan = (Map<String, Object>) chunkContext.getStepContext() .getJobExecutionContext() .get("infiltrationPlan");를 통해 동적 파라미터를 추출(*ChunkContext) - step에서는
@Value("#{jobExecutionContext['infiltrationPlan']}") Map<String, Object> infiltrationPlan의 방식으로(jobExecutionContext[key] - 변수명) 형식으로 동적 파라미터를 주입하고 추출(*Value)
이렇게 각 단계마다 다양한 방식으로 동적인 파라미터를 주입 및 추출할 수 있겠다.
이전에 동적파라미터를 주입할때 사용한 @Value를 jobExecutionContext에서 주입받아 사용할 수 있다는 점도 숙지하도록 한다.
꼭 기억해야 할 점, Job에서 생성한 ExecutionContext는 해당 job을 실행하는 모든 step에서 공유할 수 있으며 그 반대인 Step에서 생성한 ExecutionContext는 그 위계층(Job)으로의 공유는 불가능하다.
5-1. 생성자 주입/final의 관계
참고로, 어느 config에는 생성자 주입을 하고
@Slf4j
@Configuration
public class SystemMonitoringConfig {

    private final JobRepository jobRepository;
    private final PlatformTransactionManager transactionManager;

    public SystemMonitoringConfig(JobRepository jobRepository, PlatformTransactionManager transactionManager) {
        this.jobRepository = jobRepository;
        this.transactionManager = transactionManager;
    }
어느 config에는 생성자 주입을 하지 않고
/*
* job/step/tasklet을 통한 동적 구성
* */
@Slf4j
@Configuration
@RequiredArgsConstructor
public class AdvancedSystemInfiltrationConfig {
    //생성자 주입 by RequiredArgsConstructor
    private final InfiltrationPlanListener infiltrationPlanListener;

//    public AdvancedSystemInfiltrationConfig(InfiltrationPlanListener infiltrationPlanListener) {
//        this.infiltrationPlanListener = infiltrationPlanListener;
//    }
약간의 의문이 있을 수 있는데, 이는 단순히 어노테이션(RequiredArgsConstructor)의 차이지 별 다른건 없다.
참고로, final을 붙인다면 해당 필드 혹은 생성자 주입 등 온전한 객체주입이 일어나지 않는다면 컴파일 시점에서 오류메시지를 내뱉기에 안전한 프로젝트를 구성하기에 알맞은 키워드이다.
final은 상수와 같은 의미로, 말 그대로 변경시키지 않겠다는 의미인데 읽어보면 꽤 흥미로우니 한번 이해해보는 것을 추천한다.
- 실무에서는 final을 많이 쓰는가?
1) 의존성이 반드시 필요한 것임을 명시함
final이 붙어 있으면 “이 의존성은 반드시 초기화되어야 함”이라는 의미가 자연스럽게 드러난다.
2) 생성자에서 초기화하지 않으면 컴파일 에러
즉, 누락 방지 목적이다.
3) Lombok의 @RequiredArgsConstructor가 final 필드를 기준으로 생성자 생성
final이 없으면 Lombok이 생성자를 자동으로 만들지 않는다.
참고로 위에서 기술한 두가지 주입방식 모두 런타임시점에 일어난다.
5-2. value / stepscope 활용 Remind
@Value를 활용하여 주입을 받아야할 경우, 애플리케이션을 실행하는 시점엔 해당 Value context가 존재하지 않기에 반드시 Step/Batch job을 실행하는 시점, Context가 온전하게 존재하는 순간에 Bean객체를 주입받아 사용하는 StepScope를 반드시 같이 사용해주어야 한다.
따라서, beforeJob/class로 이미 만들었든 상관없이 값을 주입받기 위해서는 그 값이 존재하는 시점에 주입을 받아야 하며, 이를 위해 StepScope를 반드시 같이 사용해주어야 한다는 점을 기억한다.
@StepScope
@Bean
public Tasklet myTasklet(
    @Value("#{jobExecutionContext['infiltrationPlan']}") Map<String, Object> infiltrationPlan
){
    return (contribution, chunkContext) -> { ... }
}
Tasklet Bean은 애플리케이션 시작 시점에 생성되지 않고, Step 실행 전에 “지연 생성(Proxy)”된다(Proxy만 생성되고, 실제 객체주입은 proxy가 응답하여 실객체를 호출하는 방식으로 진행).
이때 jobExecutionContext[...]가 존재하므로 정상 주입된다.
6. job parameter의 한계
cli 등을 통해 job parameter를 전달받았다면, Spring Batch의 사상적/구조적으로 그 job parameter는 절대 수정할 수 없다.
Batch의 특징으로,
- 재현 가능성(Repeatability), 즉 동일한 job parameter를 전달하였다면 job은 항상 동일한 실행결과를 보장한다.
- 일관성(Consistency), 배치작업의 실행기록(JobExecution/JobInstance 등) 및 job parameter는 메타 데이터 저장소에 보관, job parameter가 변경가능하다면 이러한 기록들은 일관적이지 못할 수 있다.
따라서 이러한 사상을 바탕으로 구조적/설계적으로 Spring Batch는 job parameter는 수정 불가하며, 대신 위의 ExecutionContext를 통해 동적 파라미터를 추가하거나 정제하는 등의 작업이 가능하도록 그 기능을 제공해주고 있다.
따라서 이러한 점을 고려하면서, 어느 정도 수용가능한 범위에서는 job parameter를 그대로 활용하고(특히 일자), 이를 넘어선 범위에 대해 ExecutionContext를 통해 파라미터를 동적으로 주입받도록 한다.
7. ExecutionContextPromotionListener를 활용한 계층간 데이터 공유 흐름의 승격(Promotion)
기존 JobExecutionContext를 활용하여 그 아래 수준의 Step/Tasklet에서 해당 Context 내용을 공유받아 Step간 자원공유가 가능하였지만, 반대로 아래단계에서 위단계로의 Context 공유는 불가능하였다.
이러한 한계를 극복하기 위해, "승격", 즉 Promote라는 명제로 ExecutionContextPromotionListener라는 구현체를 통해 Step수준의 Context를 Job 수준의 Context로 승격하여 내용을 공유해줄 수 있도록 구성가능하다.
참고로, Step의 afterStep()을 통해, 커밋 이후의 단계에서 Context를 구성하고 이를 job에게 승격공유를 할 수 있다.
@Bean
    public ExecutionContextPromotionListener promotionListener() {
        ExecutionContextPromotionListener listener = new ExecutionContextPromotionListener();
        listener.setKeys(new String[]{"targetSystem"});
        return listener;
    }
Spring Batch는 위와 같이 ExecutionContextPromotionListener를 통해 step 수준의 context를 job 수준의 context로 활용 가능하도록 승격을 도와주고 있고, 이를 step에서
@Bean
    public Step scanningStep(
            JobRepository jobRepository,
            PlatformTransactionManager transactionManager
    ) {
        return new StepBuilder("scanningStep", jobRepository)
                .tasklet((contribution, chunkContext) -> {
                    String target = "판교 서버실";
                    ExecutionContext stepContext = contribution.getStepExecution().getExecutionContext();
                    stepContext.put("targetSystem", target);
                    log.info("타겟 스캔 완료: {}", target);
                    return RepeatStatus.FINISHED;
                }, transactionManager)
                .listener(promotionListener())
                .build();
    }
위와 같이, context를 추출하여 value put하는 것이 가능해진다.
해당 step에서 리스너로 promotionListener를 호출, 여기서 값을 주입하고 StepScope를 통해 lazy injection한 값을 다른 step에서 그대로 추출하여 사용이 가능해진다.
@Value의 구조를 보면 jobExecutionContext의 targetSystem이란 key값에서 target value를 주입받아 사용이 가능한데, job 수준의 execution으로 승격이 되었기에 가능한 로직이다.
다만 Step은 각각의 단계가 별도로, 서로 영향을 받지 않도록 독립적으로 설계하는 것이 가장 최선의 방법이며, Batch의 특징인 재사용성과 유지보수성/일관성을 최대한 확보할 수 있는 방향으로 구현해주는 것이 좋겠다.
Step간의 데이터 공유나 승격이 늘어난다면, 관리가 그만큼 힘들어지고 의존성이 증가하기에 결합도가 늘어날 수 밖에 없다.
8. Listener + JobScope/StepScope
기존에는 아래와 같이,
@Bean
    public Step attackStep(
            JobRepository jobRepository,
            PlatformTransactionManager transactionManager,
            Tasklet attackStepTasklet  // 주입받은 Tasklet 사용
    ) {
        return new StepBuilder("attackStep", jobRepository)
                .tasklet(attackStepTasklet, transactionManager)
                .build();
    }
@Bean
@StepScope
public Tasklet attackStepTasklet(
@Value("#{jobExecutionContext['infiltrationPlan']}") Map<String, Object> infiltrationPlan
) {
return (contribution, chunkContext) -> {
log.info("시스템 공격 중: {}", infiltrationPlan.get("targetSystem"));
log.info("목표: {}", infiltrationPlan.get("objective"));
Random rand = new Random();
boolean infiltrationSuccess = rand.nextBoolean();
if (infiltrationSuccess) {
log.info("침투 성공! 획득한 데이터: {}", infiltrationPlan.get("targetData"));
contribution.getStepExecution().getJobExecution().getExecutionContext()
.put("infiltrationResult", "TERMINATED");
} else {
log.info("침투 실패. 시스템이 우리를 감지했다.");
contribution.getStepExecution().getJobExecution().getExecutionContext()
.put("infiltrationResult", "DETECTED");
}
return RepeatStatus.FINISHED;
};
}tasklet의 @Value 파라미터가 있어도, 일단은 step에서 해당 tasklet 클래스를 주입받아 사용하는 형태이었다.
이때 각 tasklet은 @StepScope를 사용하여 배치클래스 호출 시점에 해당 값을 주입을 받았었다.
하지만 이러한 방법 말고도, job에서 아예 리스너로 파라미터를 주입받아 사용할 수 있는 방법이 있고, job에서 jobscope를 사용하여 지연주입받는 방안도 고려해볼 수 있겠다.
즉, tasklet에서 stepscope와 @Value를 사용하여 동적/정적 파라미터를 주입받기도 하고, job에서 리스너와 jobscope, @Value를 활용하여 정적인 job parameter를 주입받는 두가지 방식이 모두 가능하다는 점이다.
(쉽게 말하면 리스너를 통해서 job parameter를 주입받을 수 있다는 의미이다)
@Bean
    public Job killDashNineJob(JobRepository jobRepository, Step terminationStep) {
        return new JobBuilder("killDashNineJob", jobRepository)
                .listener(systemTerminationListener(null))  // 파라미터는 런타임에 주입
                .start(terminationStep)
                .build();
    }
@Bean
@JobScope
public JobExecutionListener systemTerminationListener(
@Value("#{jobParameters['terminationType']}") String terminationType
) {
return new JobExecutionListener() {
@Override
public void beforeJob(JobExecution jobExecution) {
log.info("시스템 제거 시작! 제거 방식: {}", terminationType);
}
@Override
public void afterJob(JobExecution jobExecution) {
log.info("작전 종료! 시스템 상태: {}", jobExecution.getStatus());
}
};
}위와 같이 job에서 리스너를 호출하되, 리스너 내부에서 @Value 형태로 Jobparameter를 주입받는 것이다.(주입시점은 당연히 batch 실행 후 job parameter를 온전히 전달했을때의 시점)
리스너는 당연히 JobScope에서 job parameter를 주입받도록 구성해주면 된다.
8-1. Batch 구성 시 유의점
적절한 Listener를 선택한다.
어느 시점에 어떠한 공통관심사를 처리할지 구현한다.
모든 예외가 발생했다고 해서 무작정 Batch 실행을 중단하지는 말자.
적절한 CheckException 구성을 통해, 일부 예외에 대해서는 로그만 수집하고 다음 Batch로 넘어가도록 try-catch문을 구현해줄 수도 있겠다(당연히 catch문에서 CheckedException을 작성하고, 여기서 예외를 throw 하지 않는다면 Step을 중단하지 않고 다음 단계로 넘어갈 수 있고, throw를 했을때 Step을 중단시킬 수 있다).
리스너의 책임은 "감시" "통제"이다.
말 그대로 리스너의 책임인 감시와 통제, 앞서 언급한 동적 파라미터 구성 정도의 역할만 담당하도록 설계한다.
유지보수성과 개발자 입장에서도 편의를 위해 필요한 부분이다.
호출빈도까지 고려한 설계가 이루어져야 한다.
job/step listener는 말 그대로 job, step 실행마다 수행되므로 덩어리의 크기를 감안하면 그리 호출빈도가 상대적으로 높지 않을 수 있다.
하지만 item listener는 말이 달라진다. 읽어온 아이템 하나하나에 대해 호출되므로, 호출빈도가 상대적으로 매우 높을 수 밖에 없으므로 호출빈도를 고려하여 로직의 무게까지 적절히 배치해주는 것이 맞다.
어쨌거나 리스너 사용은 최소화하라.
리스너는 어디까지나 부가적인 로직이다.
사용과 구현을 최소화하도록 하고, 불가피하다면 그 비중을 최소화한다.
8-2. step/tasklet의 DI 주입방식과 Listener의 빈객체 호출을 위한 파라미터 전달 방식의 차이
이때 의문인 부분이 한가지 생기는데, step/tasklet을 전달할때는 매개변수없이 전달을 해주는데 유독 listener만 매개변수를 null로 처리하여 번거롭게 전달을 하는지에 대한 의문이 생길 것이다.
먼저 결론부터 살펴보도록 한다.
| 컴포넌트 | 런타임 파라미터 필요 가능? | Scope 사용 방식 | 왜 null을 넣는가? |
|---|---|---|---|
| Job | 가능 | @JobScope | X |
| Step | 가능 | @StepScope | X |
| Tasklet | 매우 자주 필요 | @StepScope | X |
| Listener | 가능 | @JobScope / @StepScope | O (Builder에 등록하기 위해 1회 호출 필요) |
즉, job/step/tasklet은 기본적으로 DI를 통해 주입하는 방식이고, 이 주입은 런타임이 아닌 클래스 호출 시점에 파라미터를 주입받을 수 있기에(StepScope/JobScope와 @Value 혼용 등으로), 파라미터를 직접 전달하지 않고 클래스를 호출하는 방식이 가능하다.
따라서 listener의 경우 JobScope/StepScope와 같이 사용한다면, 해당 job/step 빌더로 생성되는 리스너빈을 먼저 생성해주어야 하는데, 이를 위해 반드시 해당 클래스가 런타임에 1번 호출되어야 한다.
즉, 위 경우처럼 호출이 반드시 런타임에 선제되어야 하기에 최초 파라미터를 null로 전달하는 식으로 일단 리스너 빈 객체(dummy)를 먼저 생성해주는 작업이 필요, 이후에 호출 시점에 값을 주입받아 실 객체를 생성하는 방식으로 진행되는 것이다.
9. 참고자료
Spring Batch 모식도 - https://ckck803.github.io/2023/04/04/spring/spring-batch/job/spring-batch-16-SimpleJob/