01. 가상환경(Virtual Environment) 구축
프로젝트별로 독립적인 패키지 관리를 위해 가상환경을 생성하고 설정함.
1) 가상환경 생성 및 활성화
venv 모듈을 사용하여 가상환경을 생성함.
# 가상환경 생성 (이름: dataproject)
python -m venv dataproject

# 가상환경 진입 (Windows 기준)
# 생성된 폴더 내 Scripts/activate 실행
D:\path\to\venvs\dataproject\Scripts> activate
2) Jupyter Notebook 커널 연결
가상환경을 Jupyter Notebook에서 사용하기 위해 ipykernel을 설치하고 등록함.
# ipykernel 모듈 설치
pip install ipykernel

# 가상환경을 Jupyter 커널로 등록
python -m ipykernel install --user --name dataproject --display-name "Python(dataproject)"
설정 후 Jupyter Notebook의 Kernel > Change kernel 메뉴에서 Python(dataproject)를 선택하여 사용 가능함.
02. PostgreSQL 데이터베이스 연동
Python에서 PostgreSQL에 접속하기 위해 psycopg2 라이브러리를 사용함.
1) 라이브러리 설치 및 연결 설정
# 라이브러리 설치
pip install psycopg2-binary
import psycopg2

# 데이터베이스 연결 설정
conn = psycopg2.connect(
    host="localhost",
    database="postgres",
    user="postgres",
    password="1111"
)

# 커서(Cursor) 생성: SQL 실행을 위한 객체
cur = conn.cursor()
2) 쿼리 실행 및 트랜잭션 관리
데이터 조회(SELECT)와 조작(INSERT) 시 트랜잭션 확정(commit) 및 에러 처리(rollback)가 필수적임.
# 1. 데이터 조회
cur.execute("SELECT * FROM public.user_info")
rows = cur.fetchall()
for row in rows:
    print(row)

# 2. 데이터 삽입 및 트랜잭션 처리
query = "insert into public.user_info values ('chris2','인선미', ...);"

try:
    cur.execute(query)
    conn.commit() # 변경사항 확정
    print("데이터 입력 성공")
except Exception as e:
    print("에러 발생:", e)
    conn.rollback() # 에러 발생 시 되돌리기
03. Pandas를 활용한 데이터 로드
SQL 쿼리 결과를 데이터프레임으로 변환하여 분석에 활용함. pd.read_sql 함수를 사용하면 커서 순회 없이 바로 데이터프레임 생성이 가능함.
import pandas as pd

# DB 연결 객체(conn)를 사용하여 데이터프레임 생성
chick_info = pd.read_sql("SELECT * FROM fms.chick_info", conn)
prod_info = pd.read_sql("SELECT * FROM fms.prod_result", conn)
# ... 기타 테이블 로드
04. Flask 마이크로 웹 프레임워크 기초
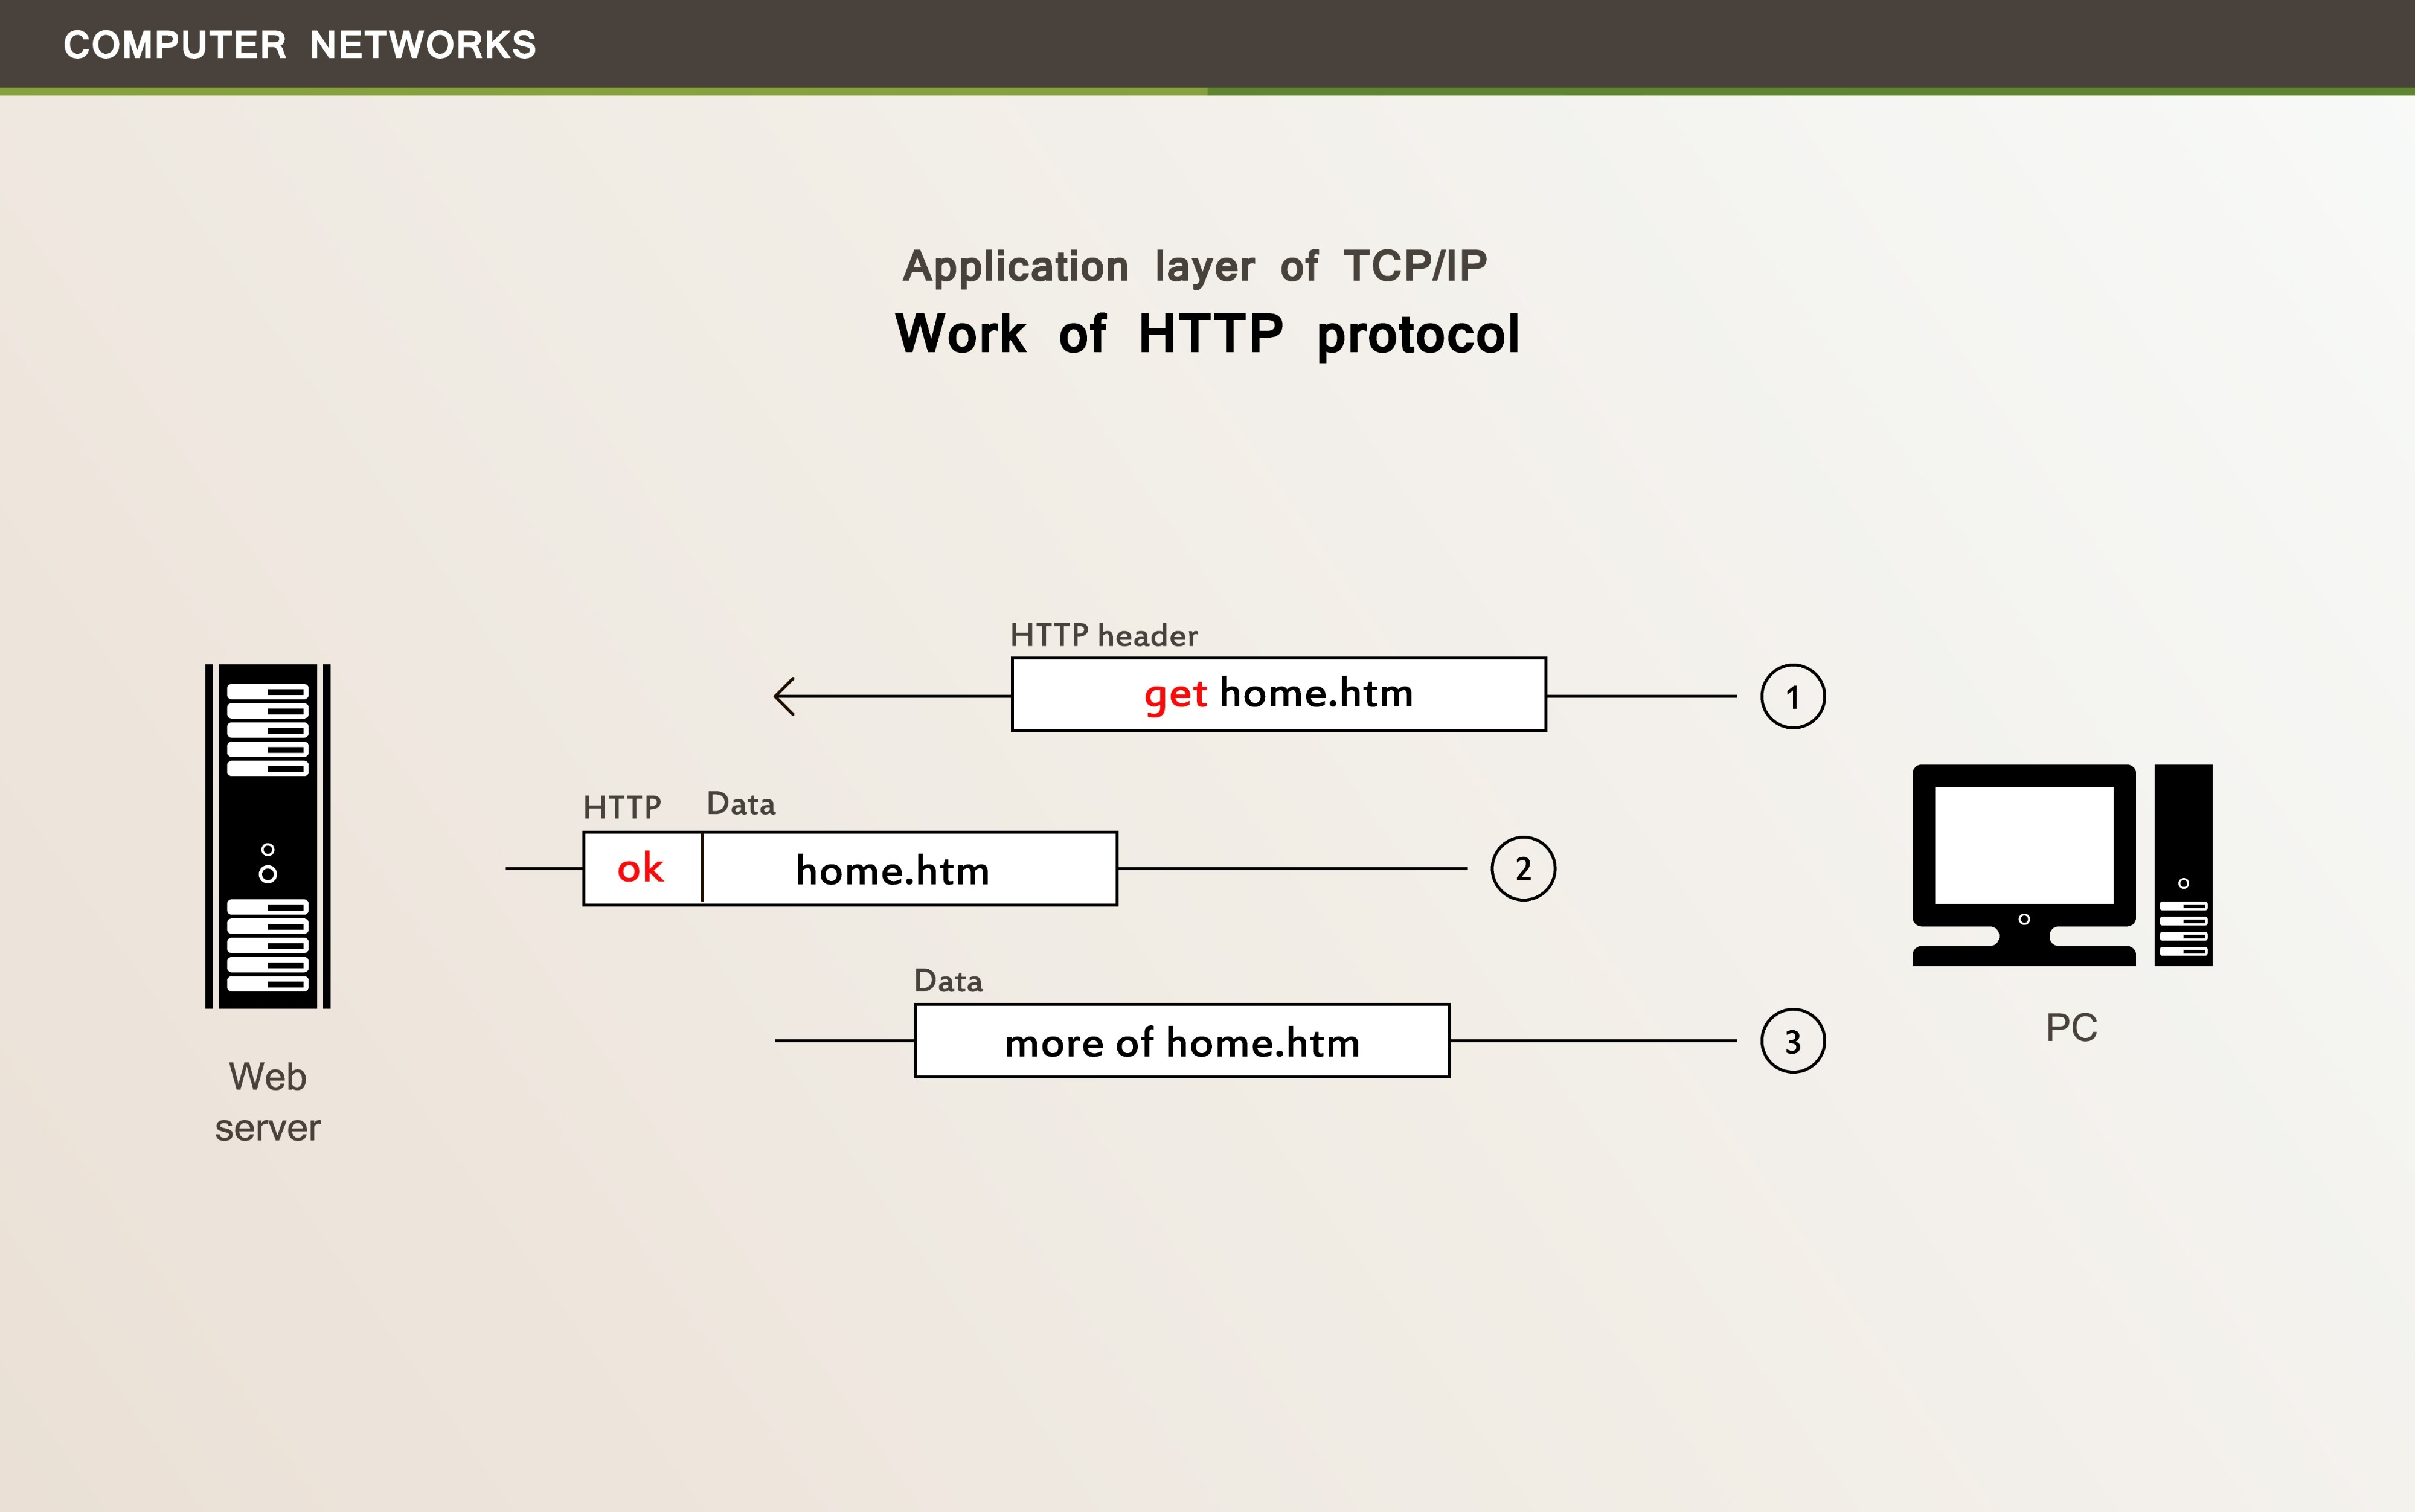
Flask는 Python으로 웹 사이트나 API 서버를 쉽고 빠르게 만들 수 있는 마이크로 프레임워크임. 필요한 기능만 최소한으로 갖추고 있어 확장이 용이함.
1) 설치 및 기본 실행
# Flask 설치
pip install flask
기본 디렉토리 구조
app.py: 메인 실행 파일templates/: HTML 파일 저장 폴더.env: 환경 변수 저장 파일
2) Flask 코드 상세 분석 (app.py)
from flask import Flask

# 1. Flask 객체 생성
app = Flask(__name__)

# 2. 라우팅 설정
@app.route("/")
def hello():
    return "hello, world!"

# 3. 서버 실행 조건
if __name__ == "__main__":
    app.run()
코드 상세 설명
app = Flask(__name__)- Flask: 웹 서버를 만드는 도구(클래스).
__name__: 현재 실행 중인 파일의 모듈 이름. Flask에게 "현재 실행 위치가 여기다"라고 알려주어, 템플릿이나 정적 파일을 어디서 찾아야 할지 기준점을 잡아주는 역할을 함.- app: 생성된 웹 서버 객체(인스턴스).
@app.route("/")@(데코레이터): URL 주소와 함수를 연결해 주는 기능."/": 웹 사이트의 대문(메인 페이지) 주소. (예:www.google.com/뒤에 아무것도 없는 상태). 만약"/menu"로 설정하면www.mysite.com/menu로 접속했을 때 동작함.
def hello(): ...- 사용자가 해당 주소로 접속하면 실행되는 함수.
return "hello, world!": 서버가 브라우저에게 전달하는 응답 값. 사용자는 흰 화면에 이 텍스트를 보게 됨.
if __name__ == "__main__":- 직접 실행 시 (python app.py):
__name__변수에"__main__"이 할당되어 조건이 참(True)이 됨app.run()실행 (서버 켜짐). - 외부에서 호출 시 (import app):
__name__에 파일명이 할당되어 조건이 거짓(False)이 됨 서버가 켜지지 않고 기능만 빌려줌.
3) 서버 구동 및 디버그 모드
코드를 수정할 때마다 서버를 재시작하지 않기 위해 디버그 모드를 활성화하는 것이 좋음.
# Windows CMD에서 디버그 모드 설정
set FLASK_DEBUG=true

# 서버 실행
flask run
실행 후 http://127.0.0.1:5000 주소로 접속하여 결과 확인 가능함.
4) 환경 변수 관리 (.env)
DB 접속 정보 등 민감한 정보는 소스 코드에 직접 작성하지 않고 .env 파일을 생성하여 관리함.
python-dotenv 설치
pip install python-dotenv
05. Flask 애플리케이션 기능 상세 분석
1) 환경 설정 및 데이터베이스 연결
보안을 위해 환경 변수(.env)를 로드하고, psycopg2를 이용해 PostgreSQL에 연결함.
# .env 파일 로드 (로컬 환경)
if os.path.exists('.env'):
    load_dotenv()

# DB 연결 함수
def get_db_connection():
    conn = psycopg2.connect(
        host=os.getenv('DB_HOST'),
        # ... (생략)
    )
    conn.autocommit = True # 트랜잭션 자동 커밋 설정
    return conn
load_dotenv(): 소스 코드에 비밀번호를 노출하지 않기 위해.env파일에서 환경 변수를 불러옴.autocommit=True: 별도로conn.commit()을 호출하지 않아도 쿼리가 즉시 반영되도록 설정함.
2) 게시판 CRUD (Create, Read, Update, Delete)
게시글 작성 (Create) & RETURNING 절 활용
@app.route('/create/', methods=['POST'])
def create_post():
    # ... (데이터 검증)
    cursor.execute("INSERT INTO board.posts ... VALUES ... RETURNING id", (title, content, author))
    post_id = cursor.fetchone()[0] # 생성된 ID를 즉시 받아옴
    return redirect(url_for('view_post', post_id=post_id))
RETURNING id:INSERT쿼리 실행 후, 방금 생성된 행의 ID를 바로 반환받아 상세 페이지로 리다이렉트할 때 사용함. 별도의 조회 쿼리를 줄여 효율적임.
상세 조회 및 조회수 증가 (Read)
@app.route('/post/<int:post_id>')
def view_post(post_id):
    # 1. 조회수 1 증가
    cursor.execute('UPDATE board.posts SET view_count = view_count + 1 WHERE id = %s', (post_id,))
    # 2. 게시글 내용 조회
    cursor.execute('SELECT * FROM board.posts WHERE id = %s', (post_id,))
    # 3. 댓글 목록 조회
    cursor.execute('SELECT * FROM board.comments WHERE post_id = %s ...', (post_id,))
    # ...
- 트랜잭션 순서: 조회수 증가 게시글 조회 댓글 조회 순으로 로직이 실행됨.
수정 및 삭제 (Update, Delete)
- 수정:
UPDATE문을 사용하여 제목, 내용, 그리고 수정일시(updated_at)를 현재 시간으로 갱신함. - 삭제:
DELETE문을 사용하여 해당 ID의 게시글을 삭제함.
3) 부가 기능: 댓글 및 좋아요 (IP 중복 방지)
댓글 (Comment)
게시글 ID(post_id)를 외래키로 하여 댓글 테이블에 데이터를 적재함.
좋아요 (Like) - IP 기반 중복 방지 로직
로그인 기능이 없는 상태에서 중복 좋아요를 막기 위해 사용자 IP(request.remote_addr)를 활용함.
@app.route('/post/like/<int:post_id>', methods=['POST'])
def like_post(post_id):
    user_ip = request.remote_addr # 접속자 IP 확인

    # 이미 좋아요를 눌렀는지 확인
    cursor.execute('SELECT COUNT(*) FROM board.likes WHERE post_id = %s AND user_ip = %s', (post_id, user_ip))
    already_liked = cursor.fetchone()[0] > 0

    if already_liked:
        # 이미 눌렀다면 -> 좋아요 취소 (DELETE & 카운트 감소)
        cursor.execute('DELETE FROM board.likes ...')
        cursor.execute('UPDATE board.posts SET like_count = like_count - 1 ...')
    else:
        # 안 눌렀다면 -> 좋아요 등록 (INSERT & 카운트 증가)
        cursor.execute('INSERT INTO board.likes ...')
        cursor.execute('UPDATE board.posts SET like_count = like_count + 1 ...')
- 토글(Toggle) 방식: 한 번 누르면 등록, 다시 누르면 취소되는 로직을 구현함.
4) 양계장 데이터 대시보드 (/fms/result)
DB에 저장된 원시 데이터를 가져와 파이썬 레벨에서 데이터 전처리 및 통계 산출을 수행함.
데이터 전처리 로직
- 합격/불합격 판별: 데이터에 한글('부적합')과 영어('Fail')가 섞여 있어도 정확히 카운팅하도록 처리함.
status = str(row.get('부적합여부', '')).strip()
if status == '부적합' or status.lower() == 'fail':
    summary['fail'] += 1
- 무게 데이터 정제:
'62g','1,200'등 문자열로 저장된 수치 데이터를 순수float형으로 변환함.
weight_val = float(str(weight).replace('g', '').replace(',', '').strip())
시각화 데이터 구조화
Chart.js나 Matplotlib 등 프론트엔드 차트 라이브러리에서 바로 사용할 수 있도록 데이터를 리스트와 딕셔너리 형태로 가공하여 전달함.
weights_all: 히스토그램용 전체 무게 리스트.weights_by_breed: 품종별 박스플롯(Boxplot)용 딕셔너리.
5) CSV 파일 내보내기 (In-Memory Export)
서버 디스크에 파일을 저장하지 않고, 메모리 상에서 파일을 생성하여 즉시 다운로드하게 함. 서버 용량 관리 측면에서 매우 효율적임.
from io import StringIO
import csv

@app.route('/fms/export')
def export_fms():
    # ... 데이터 조회 ...

    # 1. 가상 파일 객체(메모리) 생성
    si = StringIO()
    cw = csv.writer(si)

    # 2. 헤더 및 데이터 쓰기
    if rows:
        cw.writerow(rows[0].keys())
        for row in rows:
            cw.writerow(row.values())

    # 3. 응답 객체(Response) 생성 및 헤더 설정
    output = make_response(si.getvalue())
    output.headers["Content-Disposition"] = "attachment; filename=fms_result.csv"
    output.headers["Content-type"] = "text/csv"

    return output
StringIO: 문자열을 파일처럼 다룰 수 있게 해주는 객체.Content-Disposition: 브라우저에게 이 응답이 파일 다운로드임을 알려주는 헤더.
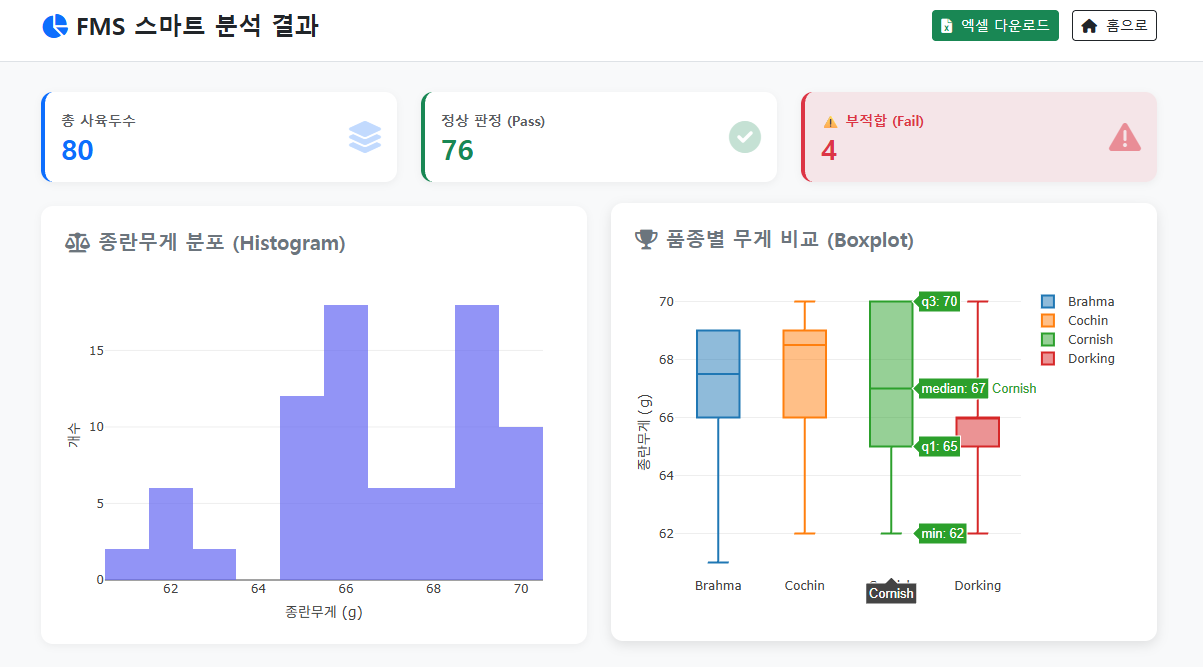
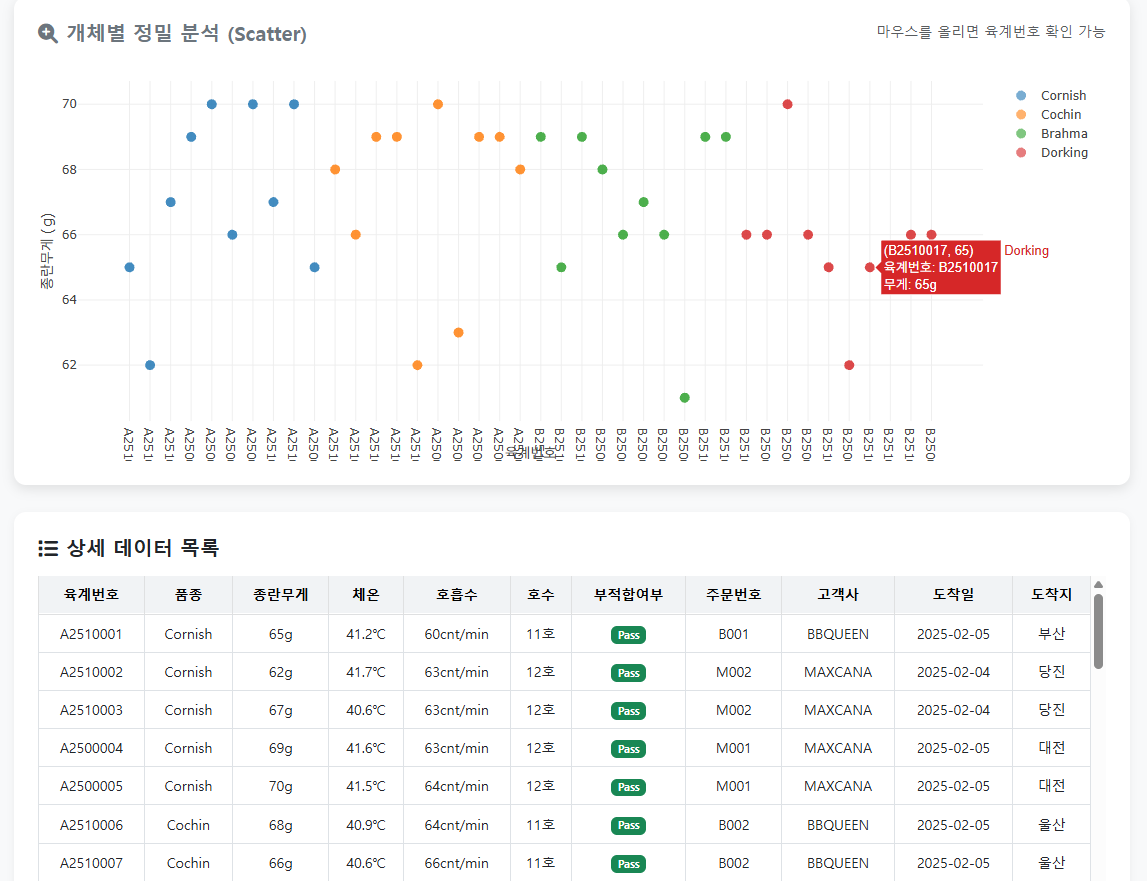
해당 기능을 구현한 웹페이지, 마우스오버 시 자세한 정보가 나오도록 함.