microsoft_dataschool
1.[Python] NumPy 핵심 요약 정리

01. NumPy란? 파이썬의 고성능 과학 계산을 위한 필수 패키지 💡 주요 제공 객체 ndarray: 다차원 배열 객체. 파이썬 리스트 대비 효율적인 메모리 사용 masked arrays: 결측치 등 유효하지 않은 값을 가려두고 계산에서 제외할 수 있는 특수
2.[Python] Pandas 핵심 요약

01. Pandas란? 데이터 분석 및 조작을 위한 파이썬 핵심 라이브러리. 통계 분석에 주로 사용됨 🚀 주요 특징 고성능: 대용량 데이터의 빠른 읽기/쓰기 지원 유연성: 데이터 재구성(Reshaping), 피벗(Pivot), 그룹화(Groupby) 용이 편의
3.[Data Analysis] CRISP-DM

01. 데이터 관련 직무 구분 (Roles) 데이터 직무 구분 데이터를 다루는 세 가지 핵심 직무의 차이점 02. CRISP-DM 방법론 CRoss Industry Standard Process for Data Mining 데이터 마이닝 전문가들이 사용하는 산업 표준 프로세스 (6단계) Phase 1. Business U
4.[Python] Pandas 데이터 전처리
01. DataFrame 재구조화 (Reshaping) 데이터의 형태를 분석 목적에 맞게 넓게(Wide) 펴거나 길게(Long) 쌓는 기능 1) Pivot & Melt (형태 변경) 서로 반대되는 개념으로 데이터의 차원을 변경함 Pivot (df.pivot):
5.[Python 실습] 유성우가 언제 떨어질까? 데이터로 예측해보기
01. 프로젝트 개요 혜성이 지나간 자리에 남은 유성체(Meteoroid)들이 지구 공전 궤도와 만나면 유성우(Meteor Shower)가 발생합니다. 하지만 유성우가 떨어진다고 해서 언제나 볼 수 있는 것은 아닙니다. 관측 가능 조건: 위치: 관측자의 위도가
6.[VScode] VScode 터미널에 Gemini 연동하기 (Gemini CLI)
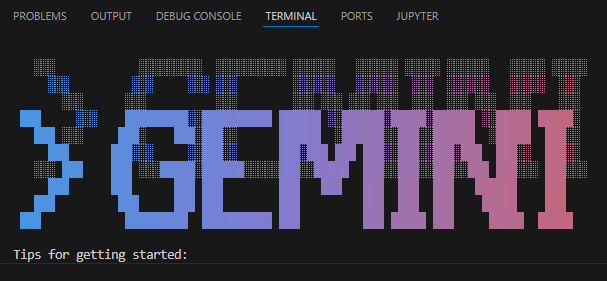
이후 설치 파일을 실행합니다 이런 이름으로 download 되어있습니다 쭉 next를 눌러서 라이선스 동의 하고, 기본 설정을 유지하여 설치
7.[Data Analysis] 서울시 공공자전거 '따릉이' 이용 패턴 분석 및 시각화
서울시 열린 데이터 광장의 공공데이터를 활용하여 따릉이의 대여 이력과 대여소 위치 정보를 결합하고, 요일별/시간대별 이용 패턴을 시각화함. 01. 데이터 수집 및 읽기 분석을 위해 서울 열린 데이터 광장(https://data.seoul.go.kr/)에서 두 가지
8.파이썬 웹 크롤링 : Selenium 기초
파이썬의 Selenium 라이브러리를 활용해 웹 페이지의 데이터를 자동으로 수집하도록 하겠습니다. 1. 환경 설정 가장 먼저 브라우저 자동화를 위한 selenium 라이브러리를 설치합니다. 2. Selenium의 핵심: 웹 요소(Element) 찾기 데이터를
9.[DevOps] 쿠버네티스(K8s)와 CI/CD 핵심 개념 요약
Part 1. 쿠버네티스 (Kubernetes) 01. 왜 쿠버네티스인가? (Computing Evolution) 컴퓨팅 환경은 효율성을 높이는 방향으로 3단계를 거쳐 발전함. Traditional (물리 서버): 한 애플리케이션이 자원을 독점하거나, 유휴 자원
10.[Power BI] 데이터 전처리부터 DAX 기초
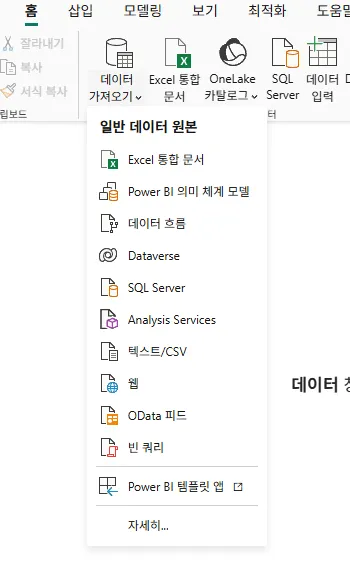
01. 데이터 가져오기 및 지도 시각화 설정 데이터 가져오기 Power BI Desktop 실행 후 데이터 가져오기를 클릭하면 원본 데이터 형식(Excel, CSV, SQL 등)에 맞는 버튼이 제공됨. 지도 시각화 오류 해결 데이터 로드 후 지도(Map) 시각화 개체를 생성할 때 보안 경고나 오류가 발생하는 경우가 있음. 이를 해결하기 위해 보안 ...
11.[Power BI] 시각화 개체 다루기
01. 보고서 페이지 다루기 Power BI에서는 엑셀의 시트처럼 여러 개의 보고서 페이지를 생성하고 관리할 수 있음. 페이지 생성 및 관리 새 페이지 추가: 하단 탭의 '+' 기호를 클릭하여 빈 페이지를 생성함. 이름 변경: 탭을 더블 클릭하여 원하는 이름(예: '매출 분석')으로 변경함. 페이지 복제: 탭에서 마우스 오른쪽 버튼 > 페이지 복제를...
12.[SQL] 데이터베이스 기초
1. [Database] 데이터와 데이터베이스 핵심 개념 정리 01. 데이터의 정의 및 분류 데이터(Data)는 현실 세계에서 관찰하거나 측정하여 수집한 객관적인 사실이나 값 그 자체를 의미함. 이를 특성에 따라 다양하게 분류할 수 있음. 형태에 따른 분류 정량적 데이터(Quantitative Data): 수치로 표현 가능한 데이터 (예: 온도, 몸...
13.[SQL] SQL 기초 문법 및 데이터 분석 쿼리 실습
01. 데이터 조회 및 필터링 (SELECT & WHERE) 데이터 분석의 가장 기초가 되는 조회와 조건 필터링 기능을 실습함. 1) 기본 조회 및 정렬 데이터 전체를 보거나, 정렬(ORDER BY)하고, 개수를 제한(LIMIT)하는 방법임. 2) 조건 필터링 (WHERE) 다양한 연산자를 활용하여 분석 대상 데이터를 추출함. 02. 문자열 함...
14.[SQL] 심화 문법 완전 정복: Subquery, View, Pivot, Function
01. 서브쿼리 (Subquery) 하나의 SQL 문장 안에 포함된 또 다른 SQL 문장을 의미함. 메인 쿼리가 실행되기 전에 한 번 실행되어 그 결과를 메인 쿼리에 전달하는 역할을 수행함. 1) WHERE 절 서브쿼리 (Nested Subquery) 가장 일반
15.[SQL] PostgreSQL 함수, 프로시저, Job 스케줄링
01. 사용자 정의 함수 (User Defined Function) 개념 사용자가 직접 로직을 정의하여 SQL 문 내에서 호출할 수 있는 함수임. 복잡한 연산을 캡슐화하거나 재사용성을 높이는 데 사용됨. SQL 함수: 단순한 SQL 쿼리의 집합. PL/pgSQL 함수: 변수 선언, 반복문, 조건문 등 프로그래밍 언어의 기능을 포함한 절차적 언어. ...
16.[SQL] DB 오브젝트와 쿼리 최적화: Trigger, Index, Window Function
01. 트리거 (Trigger): 데이터 변경 자동 감지 및 처리 트리거는 테이블에 대한 이벤트(INSERT, UPDATE, DELETE)가 발생할 때 자동으로 실행되는 특수한 프로시저임. 데이터 무결성 유지, 로그 기록, 유효성 검사 등에 사용됨. 1) 건강 상태 변경 감지 및 감사 로그 (Audit Log) 닭의 건강 정보가 수정될 때, 변경 전/...
17.[Python] 가상환경 구축과 DB 연동, Flask 웹 서버 입문
01. 가상환경(Virtual Environment) 구축 프로젝트별로 독립적인 패키지 관리를 위해 가상환경을 생성하고 설정함. 1) 가상환경 생성 및 활성화 venv 모듈을 사용하여 가상환경을 생성함. 2) Jupyter Notebook 커널 연결 가상환경
18.[Azure] VS Code + GitHub Actions로 Flask 웹앱 배포
[Azure] VS Code + GitHub Actions로 Flask 웹앱 배포하기 (feat. 트러블슈팅) 로컬에서 개발한 Flask 애플리케이션을 마이크로소프트 애저(Azure) Web App에 배포하는 전체 과정을 정리함. VS Code 확장 프로그램과 GitHub Actions를 활용하여 CI/CD 파이프라인까지 구축하는 것이 목표임. 01....
19.[Azure Functions] Blob Trigger 실습: 로컬 테스트, ARM 템플릿 배포
01. Blob Trigger란? Azure Storage에 새로운 파일(Blob)이 업로드되면 자동으로 실행되는 함수임. 주로 이미지 썸네일 생성, 로그 분석, 데이터 백업 등의 이벤트 기반 작업에 사용됨. 실습 목표 사용자가 samples-workitems 컨테이너에 이미지를 업로드함. Azure Function이 이를 감지하여 썸네일을 생성함. ...
20.[Azure] Event Hub: 빅데이터 스트리밍과 아키텍처
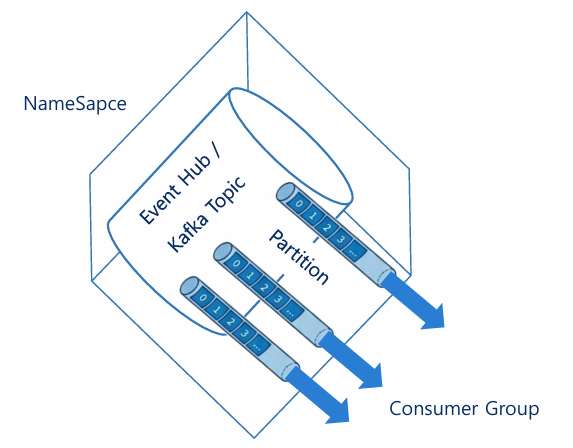
01. Azure Event Hubs 개요 빅데이터를 위한 가장 강력한 프런트 도어(Front Door) 역할을 수행하는 완전 관리형 실시간 데이터 수집 서비스임. 주요 특징 초당 수백만 개의 이벤트 처리: 대규모 데이터 유입을 안정적으로 수용함. 낮은 지연 시간: 실시간 분석 및 처리에 최적화됨. 유연성과 비용 효율성: 사용량에 따라 탄력적으로 대...
21.[Azure] Stream Analytics & Power BI 실시간 대시보드 구축 가이드
Azure Event Hubs의 실시간 데이터를 Stream Analytics로 처리하고 Power BI로 시각화하는 전체 파이프라인 구축 과정을 정리함. 1. Power BI 작업 영역 설정 데이터를 수신할 Power BI의 작업 영역을 생성하고 고유 ID를 확보해야 함. 1-1. 작업 영역 생성 Power BI 접속: 웹 브라우저에서 Powe...
22.[Azure] Stream Analytics & Power BI 실시간 태양광 발전량 대시보드 구축
Azure Event Hubs로 유입되는 실시간 데이터를 Stream Analytics로 전처리하고, Power BI를 통해 실시간으로 시각화하는 전체 파이프라인 구축 과정을 정리함. 1. Power BI 작업 영역 설정 Stream Analytics에서 데이터를 송신할 목적지인 Power BI 작업 영역을 생성하고 고유 ID를 확보해야 함. 1-1...
23.[Azure] Cosmos DB + OpenAI로 RAG 기반 챗봇 구축하기 (Full Guide)
이번 포스팅에서는 Azure의 핵심 PaaS 서비스들을 활용하여 RAG (Retrieval-Augmented Generation) 아키텍처 기반의 챗봇을 구축하는 과정을 정리합니다. 1. 아키텍처 개요 전체적인 시스템의 데이터 흐름과 사용되는 핵심 기술 스택은
24.[데이터 분석] 통계 기초, 머신러닝, Azure ML
데이터 시대를 살아가며 데이터를 올바르게 이해하고 분석하는 능력은 필수적이 되었습니다. 오늘은 통계의 기초 개념부터 머신러닝의 원리, 그리고 클라우드 기반의 Azure Machine Learning 활용법까지 데이터 분석의 전 과정을 아우르는 핵심 내용을 정리해 보겠습니다. 💡 Part 1. 데이터와 머신러닝 개요 1. 데이터와 통계: 팩트풀니스(...
25.Azure Databricks를 활용한 데이터 병렬처리1
목차 Apache Spark란? Spark의 핵심 기능들 Azure Databricks란? Azure Databricks 주요 기능 Azure Databricks 실습 — 프로비저닝 및 기본 사용법 Azure Databricks 인프라 구조 Unity Catalog
26.[Databricks] Azure Databricks 기본 조작 & Delta Lake 심화
1단계: 노트북 기본 조작 및 유틸리티 하나의 노트북 안에서 파이썬과 SQL을 자유롭게 넘나들고, 파일 시스템을 탐색하는 기본 코드입니다. 언어 변경 및 매직 커맨드 기본적으로 노트북의 언어가 지정되어 있지만, 매직 커맨드(%)를 통해 셀 단위로 언어를 변경할 수
27.[Azure] SQL Server VM 구축부터 Azure SQL Database 마이그레이션까지
본 포스팅에서는 Azure 환경에서 Linux/Windows VM 기반의 SQL Server(IaaS)를 구축하고, 이를 Azure SQL Database(PaaS)로 마이그레이션한 뒤 웹 앱(Flask)의 연동을 전환하는 전체 과정을 실습함. 📌 시스템 아키텍처 흐름 시스템 흐름: 데이터 수집 → 전처리/벡터화 → Cosmos DB 저장 → 사용자...
28.SQL 인덱스(Index) 및 성능 최적화 가이드
인덱스는 데이터베이스 테이블의 검색 속도를 비약적으로 높여주는 '책의 색인'과 같은 데이터 구조임.도입 효과: 대용량 데이터 환경에서 쿼리 성능을 최대 100배 이상 개선할 수 있음.작동 원리: 데이터 전체를 뒤지는 'Full Table Scan'을 방지하여 디스크 I