01. Azure Event Hubs 개요
빅데이터를 위한 가장 강력한 프런트 도어(Front Door) 역할을 수행하는 완전 관리형 실시간 데이터 수집 서비스임.
주요 특징
- 초당 수백만 개의 이벤트 처리: 대규모 데이터 유입을 안정적으로 수용함.
- 낮은 지연 시간: 실시간 분석 및 처리에 최적화됨.
- 유연성과 비용 효율성: 사용량에 따라 탄력적으로 대응하는 이벤트 스트리밍 서비스임.
- 통합성: Azure 내부 및 외부의 다양한 분석 서비스와 원활하게 연동됨.
02. 핵심 구성 요소 (Core Components)
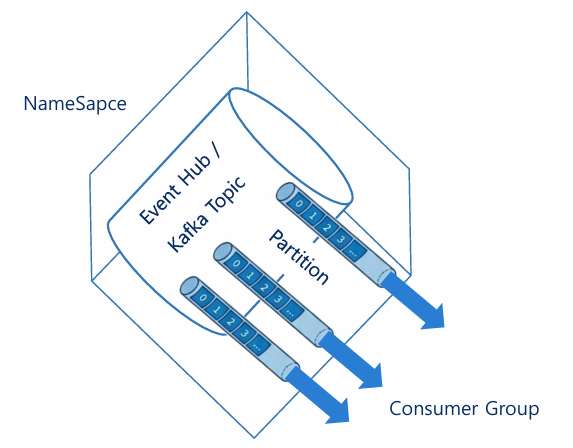
Event Hubs를 구성하는 4가지 핵심 요소임.
- Namespace (네임스페이스): Event Hubs의 관리 컨테이너. 용량 할당 및 재해 복구 설정의 단위가 됨.
- Event Hub (이벤트 허브): 데이터가 저장되는 추가 전용(Append-only) 분산 로그.
- Partitions (파티션): 처리량을 늘리기 위한 확장의 기본 단위. 병렬 처리를 가능하게 함.
- Consumer Group (소비자 그룹): 여러 소비자가 독립적인 속도와 오프셋(Offset)으로 데이터를 읽을 수 있게 하는 논리적 그룹.
03. 데이터 흐름과 아키텍처
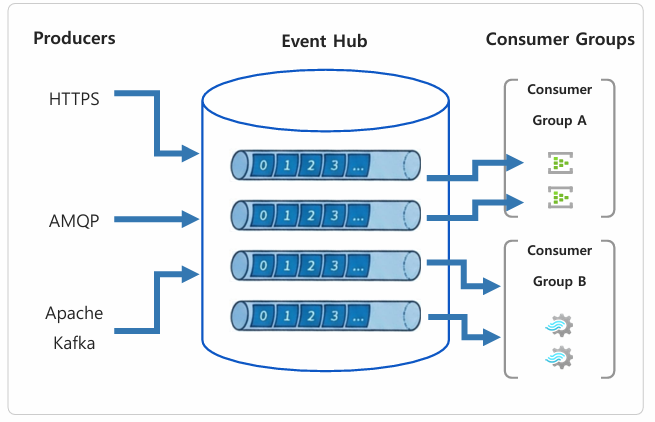
"생산자(Producer)에서 소비자(Consumer)로의 흐름"은 고성능 데이터 스트리밍의 핵심 구조임. 대량의 데이터를 여러 경로로 받아 파티션별로 나누어 저장하고, 서로 다른 목적을 가진 시스템이 각자 데이터를 처리함.
1) 생산자 (Producer)
데이터를 생성하여 이벤트 허브로 전송하는 주체들임.
- 역할: 웹사이트, 모바일 앱, IoT 센서 등 다양한 소스에서 발생하는 데이터를 수집(Ingest)함.
- 프로토콜: HTTPS, AMQP, Apache Kafka 등 다양한 통신 방식을 지원함.
2) Event Hub (중앙 버퍼)
데이터가 유입되어 임시로 저장되고 관리되는 핵심 영역임.
- 파티션 (Partitions): 중앙의 파이프와 같은 구조로, 데이터는 효율적인 처리를 위해 여러 파티션으로 나뉘어 저장됨.
- 순서 보장: 파티션 내부의 숫자(0, 1, 2...)는 이벤트의 순서를 나타내며, 각 파티션 내에서는 FIFO(선입선출) 순서가 보장됨.
- 역할: 생산자와 소비자를 분리(Decoupling)하는 버퍼 역할을 수행하여, 데이터 폭증 시에도 시스템 안정성을 유지함.
3) Consumer Groups (소비자 그룹)
저장된 데이터를 읽어가서 실제로 처리하는 영역임.
- 독립적 처리: Group A와 Group B는 서로 독립적임. Group A가 데이터를 읽어도 데이터는 사라지지 않으며, Group B도 동일한 데이터를 자신만의 속도로 읽을 수 있음.
- 활용 예시:
- Group A: 실시간 모니터링 대시보드용.
- Group B: 장기 저장을 위한 데이터베이스 기록용.
04. 확장성 및 대용량 메시지 처리
자동 팽창 (Auto-inflate)
- 트래픽 증가 시 처리량 단위(Throughput Units)를 자동으로 확장함.
- 과도한 비용 발생을 방지하기 위해 상한선을 설정할 수 있음.
Large Message Support
- 최대 20MB 크기의 단일 이벤트를 수용 가능함.
- 작은 세그먼트로 나눌 수 없는 대용량 메시지 처리에 유리함.
05. Apache Kafka 네이티브 호환성
Azure Event Hubs는 Apache Kafka 프로토콜을 기본적으로 지원함.
Kafka vs Event Hubs
- 온프레미스 Kafka: 인프라 구축 비용이 높고, 서버 패치 및 관리 등 운영 비용(OpEx)이 많이 듦.
- Azure Event Hubs: PaaS 형태로 제공되어 관리 포인트가 최소화됨.
Seamless Migration (무중단 마이그레이션)
기존 Kafka 애플리케이션의 코드를 수정할 필요 없이 엔드포인트(Endpoint) 변경만으로 이관이 완료됨.
비유: 이사 갈 때 가구(코드)는 그대로 두고 집 주소(Endpoint)만 바꾸는 것과 같음.
- 변경 전:
my-kafka-server.com- 변경 후:
my-azure-eventhub.servicebus.windows.net
06. 보안 구성 (Security)
OAuth 2.0 구성 (권장)
- Microsoft Entra ID(구 AD)를 통해 중앙 집중식으로 보안을 관리함.
- 복잡한 ACL(Access Control List) 관리의 번거로움을 제거함.
SAS (공유 액세스 서명)
- OAuth를 사용할 수 없는 경우의 대체 옵션임.
- 키 관리가 필요하며 상대적으로 보안성이 낮을 수 있음.
07. Azure Event Hubs Schema Registry
분산 애플리케이션 환경에서 데이터 구조(스키마)의 불일치로 인한 파이프라인 중단을 방지하기 위한 솔루션임. 스키마의 중앙 저장소 역할을 수행하며 엄격한 유효성 검사를 제공함.
도입 효과
- 운영 오버헤드 최소화: 스키마 관리 자동화.
- 데이터 일관성 유지: 명확한 데이터 계약(Contract)을 통해 품질 보장.
- 스키마 진화 단순화: 비즈니스 요구사항 변화에 유연하게 대응.
- 상호 운용성 향상: 이종 시스템 간 원활한 데이터 교환 지원.
- 네트워크 효율성 증대: 전체 스키마 대신 스키마 ID만 전달하여 페이로드 크기를 획기적으로 줄임. (메시지 전송 효율 최적화)
작동 방식: Producer와 Consumer는 동일한 스키마 레지스트리를 참조하여 데이터 무결성을 상호 검증함. 인프라 내부에 스키마가 안전하게 저장되므로 해석 오류를 원천 차단함.
08. Azure Event Hubs Capture (데이터 캡처)
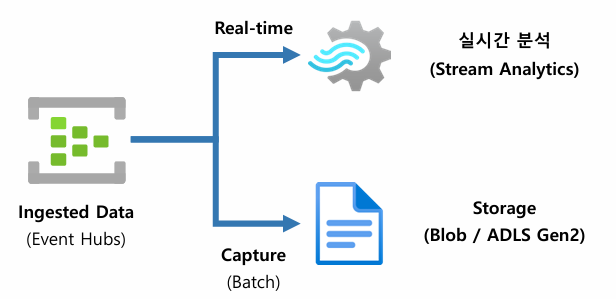
Event Hubs로 들어오는 스트리밍 데이터를 Azure Blob Storage 또는 Azure Data Lake Storage(ADLS) Gen2로 자동 전송(아카이빙)하는 기능임.
데이터 처리 경로 (Hot vs Cold)
- Hot Path: 즉각적인 통찰력 도출을 위한 실시간 처리 경로.
- Cold Path (Capture): 장기 보관 및 배치 분석을 위한 경로.
- 확장성: 아키텍처 변경 없이 나중에 실시간 처리를 추가하거나 배치 시스템을 확장할 수 있음.
데이터 흐름과 아키텍처 상세
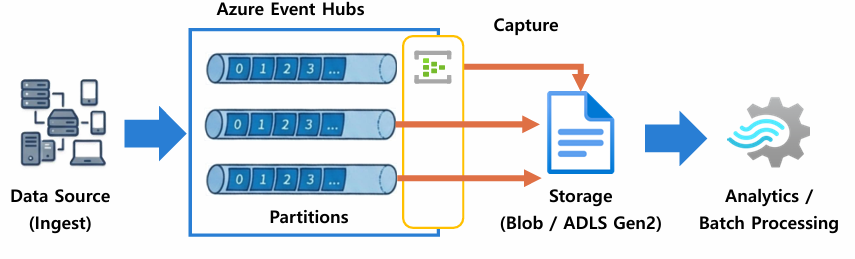
- Data Source (Ingest): 서버, 모바일, IoT 등에서 데이터가 유입되어 파티션에 분산 저장됨.
- Capture (핵심 기능): 파티션의 실시간 데이터 스트림을 별도의 코드 작성 없이 자동으로 가로채서 파일로 만듦.
- Storage (Blob/ADLS Gen2): 캡처된 데이터는 주로 Avro 형식으로 저장됨. Avro는 바이너리 형식으로 크기가 작고 처리가 빠름.
- Analytics / Batch Processing: 저장된 파일은 Azure Databricks, HDInsight, Synapse Analytics 등을 통해 배치 분석, 머신러닝 학습 등에 활용됨.
캡처 윈도우 정책: "선착순 (First Wins)"
데이터 저장은 시간과 크기 두 가지 조건 중 하나라도 먼저 도달하는 시점에 트리거됨.
- 설정 예시: 시간 15분, 크기 100MB
- 시나리오: 데이터 유입이 빨라 1분 40초 만에 100MB가 찼다면?
- 15분을 기다리지 않고 즉시 파일 생성.
- 반대 경우: 데이터가 느리게 들어온다면 크기가 덜 찼어도 15분마다 파일 생성.
확장성 및 성능 (Throughput Management)
Capture 기능 활성화는 실시간 데이터 처리 성능에 영향을 주지 않음.
- 자동 확장: Throughput Units가 늘어나면 Capture 처리 능력도 함께 증가함.
- 송신 할당량(Quota) 우회: Capture는 내부 스토리지 대역폭을 사용하므로, 일반적인 데이터 읽기(Egress) 할당량을 소모하지 않음. 즉, Stream Analytics 같은 다른 도구의 속도 저하를 유발하지 않음.
파일 저장 경로 및 명명 규칙
저장소에 파일이 쌓일 때 계층적인 폴더 구조를 가짐.
- 구조:
/{네임스페이스}/{이벤트허브명}/{파티션ID}/{년}/{월}/{일}/{시}/{분}/{초} - 특징:
- 파티션 ID별로 폴더 분리.
- 연/월/일/시/분/초 순서의 깊이 있는 구조로 특정 시점 데이터 쿼리에 최적화됨.
- 파일명에는 캡처가 발생한 정확한 초 단위 시점이 반영됨 (예:
.../17.avro).