오늘은 ICLR '24 Spotlight인 ModernTCN: Pure Convolution for Time Series Analysis 를 정리해보고자 한다. 직전에 리뷰한 PatchTST가 시계열 분야에서 CNN기반 모델들의 실효성에 대해 의문을 제기하면서 Transformer-based 모델을 제시했다면, 한 해가 지나고 ModernTCN이 기존의 TCN을 발전시킨 새로운 순수 Convolution-based 모델을 제시했다!
1. Introduction & Related Work
- 최근 트랜스포머 및 MLP 기반 모델들이 시계열 분야에서 강세를 보이면서 Convolution 기반 모델들이 성능 저하로 주목받지 못하고 있는 상황에서, 이 논문은 시계열 분석에서 convolution을 더 효과적으로 활용하는 방법을 탐구하고 traditional TCN을 modernize하여 modernTCN을 제안했다.
- 합성곱 기반 모델들이 타 모델들에 비해 가장 부족한 점은 바로 제한된 Effective Receptive Field (ERF) 때문인데, 트랜스포머와 MLP 기반 모델들의 경우 큰 ERF를 가지고 있어 long-term temporal dependency를 훨씬 잘 포착할 수 있다.
- 이전 합성곱 기반 모델인 MICN, SCINet도 합성곱을 다시 시계열에 도입하려 했으나, 주로 기존의 전통적인 합성곱에 복잡한 추가 구조를 설계하는 데에 집중하고 convolution architecture 자체를 업데이트 하려는 시도를 하지 않아 성능 향상이 제한적이었다.
- 따라서 ModernTCN은 컴퓨터 비전 분야의 합성곱 자체 최적화에서 영감을 받아 1D convolution을 현대화하고 이전 합성곱 기반 모델들보다 훨씬 더 큰 커널 사이즈를 활용해 ERF를 증가시켜 5가지 주요 시계열 테스크에서 SOTA 성능을 달성하였다.
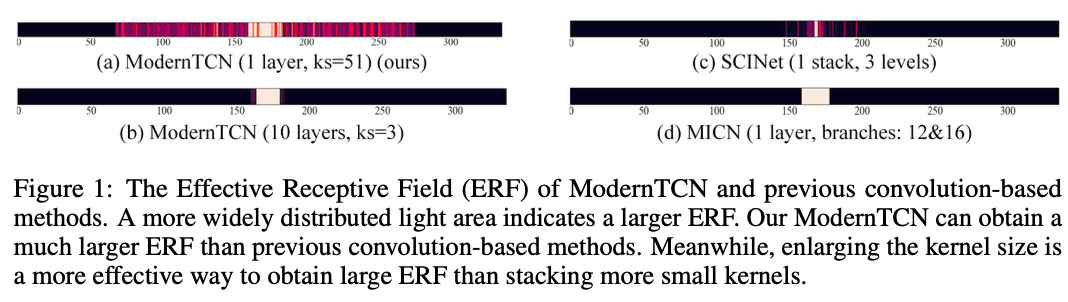 또한 convolution은 cross-variable dependency를 잘 포착할 수 있다는 이점이 있기에 이러한 이점은 살렸다는 데에도 그 contribution이 있다.
- ConvNets이 한 때 지배적인 백본 구조였는데, Vision Transformers(ViTs)가 등장하여 이를 능가하자 ConvNeXt가 트랜스포머의 아키텍처 디자인에서 영감을 받아 컨볼루션 블록을 재설계함. (Group Convolution, Depthwise Convolution, Larger Kernel Size)
Receptive Field: CNN에서 특정 output 뉴런이 input 데이터에서 영향을 받는 영역을 의미함. 하나의 출력이 입력의 어디를 보고 만들어졌는지를 나타내는 범위. 하단 그림과 같이 kernel사이즈를 키울 경우 RF가 커지게 됨. 트랜스포머 기반 모델은 Self-attention mechanism을 사용하기 때문에 입력 시퀀스의 모든 위치가 출력 시퀀스의 모든 위치에 영향을 끼침. 따라서 RF가 크다. 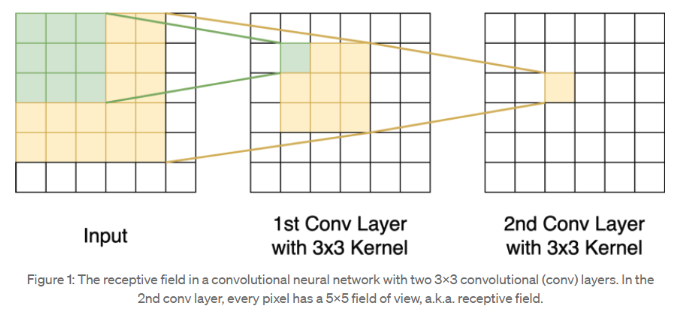
e.g.
1. input image가 28x28이고 kernel이 3x3, stride가 1x1이라면 RF는 3x3이 됨.
2. kernel이 5x5, stride가 2x2라면 RF는 9x9가 됨.
2. ModernTCN
2.1 1D Convolution Block의 현대화
- 앞서 언급한 ConvNeXt 논문의 아이디어를 따라서 1D Convolution Block 자체를 재설계했다.
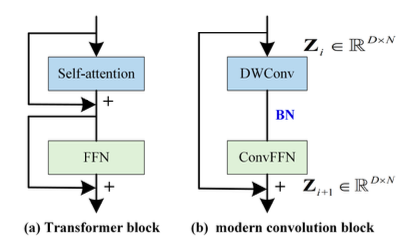
- DWConv (Depth-wise Convolution): 토큰 간의 시간 정보를 피처별로 학습하는 역할을 한다. 이는 결국 Transformer의 Self-attention 모듈과 동일한 역할을 하게 된다.
- ConvFFN (Convolutional Feed-Forward Network): Transformer의 FFN과 유사한 형태를 띈다. 두 개의 PWConv (Point-wise Convolution)으로 구성되며, Inverted Bottleneck구조를 채택하여 히든 채널이 인풋 채널보다 r배 넓고, 이 모듈은 각 토큰의 새로운 Feature representation을 독립적으로 학습!
- 이러한 설계를 통해서 시간 정보의 혼합과 피처 정보의 혼합을 분리하여, 기존에 두차원에서 동시에 정보를 혼합하는 traditional convolution 구조와 차별화를 뒀다. 이 decoupling 설계는 학습 테스크를 보다 쉽게 만들고, 계산 복잡도를 줄이는 핵심이다. 그럼에도 불구하고 CV 분야와 동일한 방식으로는 시계열 작업에서 큰 성능 향상을 거두기 힘들기 때문에 시계열에 적합한 추가 수정을 거쳐야 했다. 특히, 시계열은 피처 차원과 시간 차원 외에 변수 차원(variable dimension)을 가지고 있기 때문에 Multivariate 시계열에서 변수 간 의존성(cross-variable dependency)이 중요한 점을 고려하였다.
2.2 시계열 관련 수정
-
Patchify variable-independent embedding
CV에서 흔히 사용하는 변수 혼합 임베딩(variable-mixing embedding) (예: 여러 변수를 단일 D차원 벡터로 임베딩)은 시계열에 적합하지 않다. 시계열 변수 간의 차이는 RGB 채널보다 훨씬 크며, 이러한 임베딩은 복잡한 변수 의존성을 학습하지 못하고, 변수 차원을 버려 개별 변수의 특성을 잃게 만든다. 이를 해결하기 위해 Patchify variable-independent embedding이 제안되었으며 채널 개수 M, 시간 길이 L, Stride S (얼마나 오버래핑하는가를 결정) 활용해 차원으로 패치화 및 패딩 과정을 거쳐 1D 컨볼루션 스템 레이어를 통해 D차원 임베딩 벡터(패치 개수 N)로 변환된다. 이 때 각 univariate time series는 독립적으로 임베딩되기 때문에 차원 변수를 유지할 수 있다. 즉, 모든 변수는 같은 Convolution filter를 공유하지만, 변수 간 정보는 혼합되지 않는다. -
DWConv 수정 -> 여기서는 그룹의 수가 M x D (하나의 변수 내 특정 피처 따로 학습)
이 레이어는 원래 시간 정보를 학습하기 위해 설계했음으로 변수간의 cross-variable dependency를 동시에 학습하기 어렵다고 판단. 따라서 각 Patch마다 다른 kernel을 적용시켜 피처 독립적인 동시에 변수 독립적으로 수정하여, 각 univariate time series의 temporal dependency만 학습하는 것으로 하였다 (셀프 어텐션처럼). 이 때 ERF를 늘리기 위해 큰 커널을 채택.
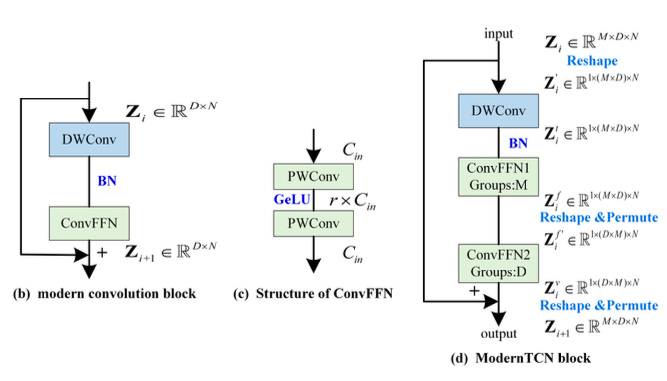
- ConvFFN1 and ConvFFN2 - Decoupling ConvFFN:
DWConv가 피처 및 변수 독립적이기 때문에, ConvFFN은 피처 및 변수 차원 전반에 걸쳐 정보를 혼합해야 하는데, 단일 ConvFFN을 쓸 경우 계산 복잡성이 높고 성능이 저하될 수 있다. 따라서 저자는 ConvFFN을 ConvFFN1과 ConvFFN2로 디커플링. PWConv를 그룹 컨볼루션(group PWConv)으로 대체하고 그룹 수를 다르게 설정하였다.
-
ConvFFN1 --> 여기서는 그룹의 수가 M (하나의 변수 내 D개 피처 상호작용)
M (변수 수)을 그룹 수로 설정하여 변수별로 새로운 피처 표현을 학습. 즉, 동일한 변수 내의 피처들만 상호작용하게 된다. 각 패치 별로 혼합. PWConv로 차원을 늘렸다가 줄이는 Inverted Bottleneck 구조. -
ConvFFN2: --> 여기서는 그룹의 수가 D (하나의 피처 내 M개 변수 상호작용)
D (피처 차원)을 그룹 수로 설정하여 피처별로 교차 변수 의존성을 학습. 이는 동일한 피처 내의 여러 변수들이 상호작용하도록 한다. 각 변수 별로 혼합. PWConv로 차원을 늘렸다가 줄이는 Inverted Bottleneck 구조.
이러한 수정 후, 최종 ModernTCN 블록은 DWConv, ConvFFN1, ConvFFN2 각각 시간, 피처, 변수 차원 중 하나에서만 정보를 혼합하여 디커플링 원칙을 따르게 된다.
3. Experiments
참 잘하더라... + 효율적이기까지 !💡
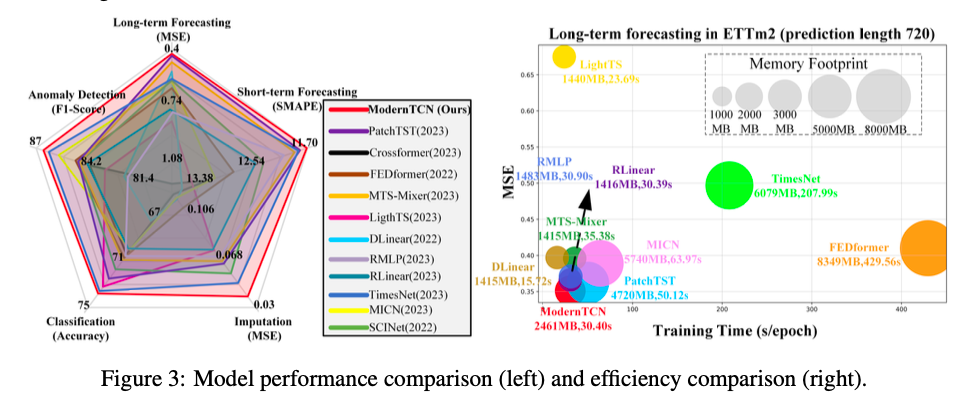
- Long and Short term Forecasting, Imputation, Classification and Anomaly Detection의 5가지 주요 분석 테스크에 대해 실험을 진행했고, 일관되게 좋은 성능과 높은 효율성을 보였다. 특히 Transformer 기반(PatchTST, Crossformer, FEDformer), MLP 기반(MTS-Mixer, LightTS, DLinear, RLinear, RMLP), 컨볼루션 기반(TimesNet, MICN, SCINet) 모델들을 모두 포함하여 실험을 진행.
- Long-term Forecasting의 경우, 성능 면에서 최고인 PatchTST와 대등하면서도 더 빠른 속도와 적응 메모리 사용량을 보여 효율성-성능 균형이 우수했고, 기존 컨볼루션 모델들은 크게 앞질렀다.
- Short-term Forecasting의 경우, 일관되게 성능이 좋았다.
- Imputation (결측치 보간)에서 역시 기존의 PatchTST와 DLinear같은 모델들이 변수-독립적 방법이라 cross-variable dependency를 고려하지 못해 성능이 저조한 한 편, ModernTCN은 이러한 점을 고려한 설계로 뛰어난 성능을 달성했다.
- Classification에서는 최고 성능을 달성했고, Anomaly Detection에서도 최신 모델인 TimesNet과 Comparable한 성능을 달성. Classification에서는 Epoch당 평균 55.1% (3.19s vs 7.10s), 이상 감지 작업에서는 57.3% (132.65s vs 310.62s)의 학습 시간을 절약하여 두 작업 모두에서 효율성과 성능의 더 나은 균형을 보였다.
References
원문은 여기에! ModernTCN: A Modern Pure Convolution Structure for General Time Series Analysis