Time Series 개념정리를 하고 한달이 지난 지금.. 뒤늦게 갑자기 PatchTST 논문 정리를 시작해보려한다. ICLR '23에 발표된 <A TIME SERIES IS WORTH 64 WORDS:
LONG-TERM FORECASTING WITH TRANSFORMERS>는 PatchTST라는 모델을 소개함으로써 Time Series Forecasting에서 가장 유명한 SOTA중 하나로 자리매김하게 된다!
1. Introduction
-
Transformer 모델이 자연어 처리, 컴퓨터 비전, 음성 등 다양한 분야에서의 성공을 거두면서 Informer, Autoformer, FEDformer와 같은 Transformer 기반 변형 모델들이 시계열 데이터 분석 및 예측 작업에도 활발히 사용되기 시작하였다.
-
2022년, Zeng et al.의 연구에서 단순한 선형 모델(e.g. DLinear)이 복잡한 Transformer 기반 모델들보다 여러 벤치마크 데이터셋에서 더 나은 성능을 보이는 결과가 제시되었다. 또한 일부 시계열 데이터, 특히 금융 데이터의 경우 효율적 시장 가설(efficient market hypothesis)에 따라 이전 시점 값이 최적의 예측이 될 수 있으며, 단순 반복 모델도 특정 데이터셋(Exchange-rate)에서 경쟁력 있는 성능을 보이며 시계열 예측에서 Transformer의 유용성에 대해 의문이 제기되었다.
-
이러한 상황에서 PatchTST는 Time Series의 Long-term Forecasting과 Self-supervised Representation Learning을 위한 효율적인 Transformer 기반 모델을 제시하였다.
PatchTST의 두가지 핵심 설계
-
Patching: Input 시계열 데이터를 더 낮은 시계열 수준의 패치로 분할하고, 이 패치들을 Transformer의 input token으로 활용한다. 따라서 Locality와 Semantic information을 자연스럽게 임베딩에 담을 수 있다.
-
Channel-independence: multivatriate time series의 각 채널은 동일한 임베딩 및 weight를 공유하지만, 독립적으로 처리된다. 각 univariate time series는 자신만의 어텐션 패턴을 학습하며, 기존의 channel-mixing 방식의 한계점을 극복하며 서로 다른 패턴을 가진 시계열에 대해 더 잘 적응할 수 있고, 이에 따라 overfitting의 위험성이 줄어든다.
PatchTST의 두가지 핵심 설계의 이점
-
계산 복잡성 감소 : 입력 토큰 수(N)가 전체 시퀀스 길이(L)에서 패치 스트라이드(S)에 비례하여 L/S로 줄어들어, 어텐션 맵의 메모리 사용량 및 계산 복잡성이 제곱에 비례하여 감소한다. (O(N²) → O((L/S)²)). 실질적인 학습 속도도 이에 따라 줄어든다.
-
Longer look-back window로부터 학습이 가능해짐: 계산 효율성이 높아지면서 모델이 GPU 메모리나 학습 시간 제약 하에서도 더 긴 과거 시퀀스를 효율적으로 활용하여 예측 성능을 향상시킬 수 있다. 예컨대, 연속적인 N=96개의 시계열 데이터를 학습시켰을 때보다 4개의 time step마다 데이터를 샘플링하여 총 L=390의 긴 과거 시퀀스를 보았을 때 MSE가 훨씬 감소한 것을 관찰할 수 있었다. 같은 개수의 input tokens를 활용하더라도 긴 look-back window를 가지는 것이 더욱 중요한 정보를 전달하고 있음을 알 수 있다.
-
Representation Learning에서의 강점: Simple한 Linear 모델들은 제한된 표현력을 가지고 있는 반면, non-linear layers of abstraction을 활용하여 transfer learning과 self-supervised representation learning에서 우수한 성능을 보인다. 우수한 fine-tuning 성능을 달성하며, 특히 대규모 데이터셋에서는 supervised learning으로 학습하는 것보다 더 뛰어난 성능을 보이며 transfer learning에서도 장기 예측 SOTA를 달성하였다.
2. Related Work
Transformer-based Long-term Time Series Forecasting
-
최근 몇 년간 Transformer 모델을 장기 시계열 예측에 적용하려는 연구가 활발히 이루어졌고, LogTrans, Informer, Autoformer, FEDformer, Pyraformer 등이 대표적인 SOTA Transformer 기반 시계열 예측 모델로 언급돼왔다.
-
이 모델들은 주로 원래 트랜스포머의 어텐션 메커니즘 복잡성을 줄이기 위한 새로운 메커니즘 설계에 초점을 맞춰왔다. 예를 들어, LogTrans는 LogSparse 어텐션, Informer는 ProbSparse 어텐션, Autoformer는 분해 및 자기 상관(auto-correlation), FEDformer는 푸리에 강화 구조, Pyraformer는 피라미드형 어텐션을 사용했다.
-
하지만 대부분의 이 모델들은 시계열의 시간 스텝을 개별적인 포인트 단위로 취급하는 어텐션(point-wise attention)을 사용하여 패치의 중요성을 간과했다는데 한계점이 있다. LogTrans는 포인트 단위 연산을 피했지만 여전히 단일 시간 스텝에 기반하며, Autoformer는 자기 상관을 사용하지만 수작업 방식이며 패치 내 모든 의미 정보를 포함하지 못하고 있다. 또한, Triformer는 패치 어텐션을 제안했지만 입력 단위로 패치를 사용하거나 의미적 중요성을 드러내는 목적은 아니었다.
-
PatchTST는 이러한 기존 Transformer 모델들이 패칭을 제대로 활용하지 못했다는 점을 지적하며, 시계열에 특화된 패칭 설계를 통해 성능을 향상시켰다.
3. Proposed Method
3.1. Model Structure
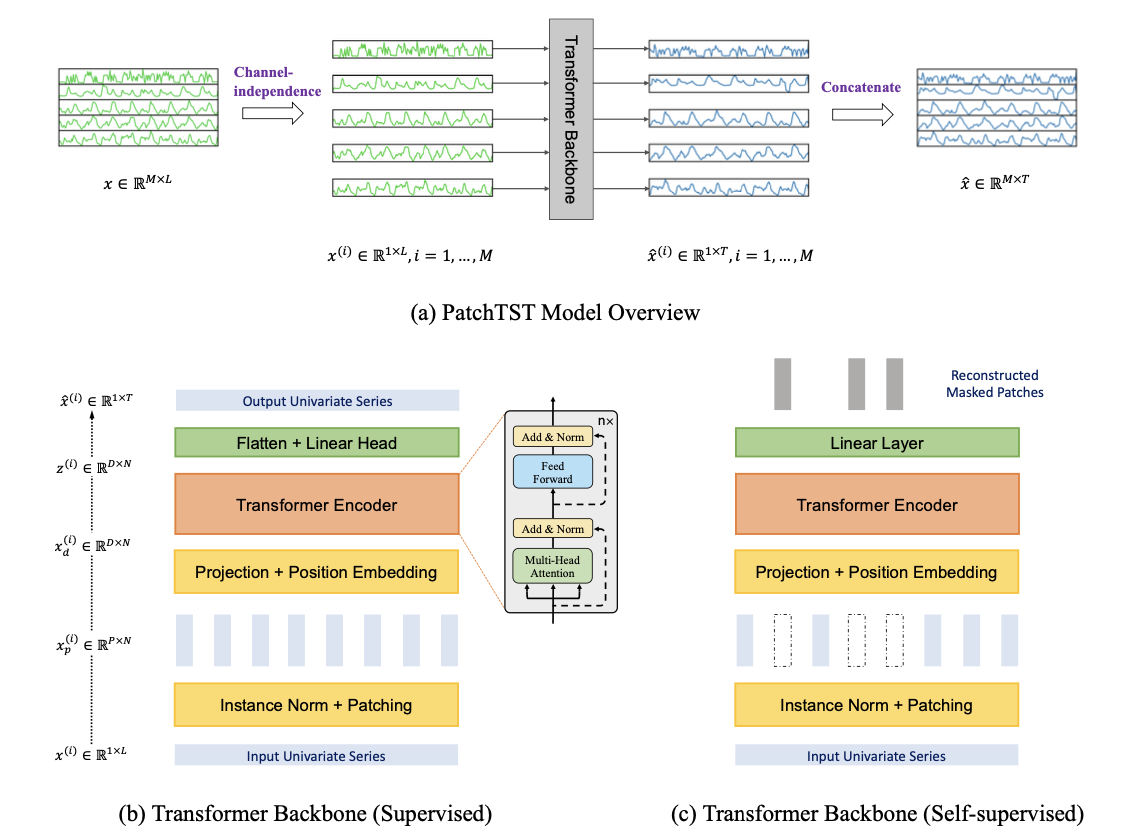
Patching
- Input Time Series를 하위 시계열 수준의 '패치'로 분할한다. 이 패치화 과정은 각 채널에 대해 독립적으로 수행된다. 시계열 는 총 길이 L을 가지게 된다.
- 패치 길이 (P)는 각 패치가 포함하는 타임 스텝의 개수를 정의한다. 즉, 각 패치는 길이가 P인 하위 시계열이다.
- 스트라이드 (S)는 연속적인 두 패치 사이의 시작 시점 간격으로, 이는 다음 패치가 시작하기 전에 건너뛰는 타임 스텝 수를 의미한다. 예컨대, 스트라이드 S가 패치 길이 P 보다 작으면 패치들이 서로 overlapped되며 S와 P가 같은 경우, 패치들이 non-overlapped된다. 논문에서는 이 두가지 방식이 모두 가능하다고 언급되지만, self-supervised learning에서는 마스킹의 편의를 위해 주로 S=P를 사용한다고 한다.
- 입력 시계열 길이 L, 패치 길이 P, 스트라이드 S가 주어지면, 패치화 과정은 총 N개의 패치 시퀀스를 생성하게 된다. 패치 수는 로 계산된다. 만약 시계열 길이 L이 P와 S의 조합으로 딱 떨어지지 않아 마지막 패치를 만들기에 길이가 부족한 경우, 원본 시퀀스의 마지막 값 을 S번 반복하여 추가하는 패딩(padding)을 수행하며, 이 패딩을 통해 마지막 패치도 스트라이드 S 간격으로 생성될 수 있도록 한다.
- 전통적인 Transformer 모델들이 point-wise (개별 시점)을 input token으로 사용하였기 때문에, 이 경우 input token의 수 N은 시퀀스 길이 L과 같아지게 되지만, PatchTST의 경우 패치 하나하나를 입력 토큰으로 사용하여 위에 언급한 복잡도 측면에서 큰 이점을 가지게 된다. 패치화된 각 토큰은 입력되기 전 linear projection을 거쳐 임베딩 공간으로 매핑되며 시간적 순서의 반영을 위해 positional encoding이 추가된다.
Transformer Encoder
- 이렇게 생성된 패치들은 Transformer의 latent space으로 매핑된다. 패치는 차원 D를 갖는 latent space으로 이동하게 되고, 이는 trainable linear projection 를 통해 이루어집니다.
- 패치들의 시간적 순서를 모델이 인지하도록 하기 위해, learnable additive position encoding 이 추가됩니다.
- 이 과정을 거친 후, Transformer Encoder에 입력되는 최종 데이터는 형태가 된다.
- Transformer Encoder의 핵심인 Multi-head attention을 거치며, 각 어텐션 헤드 h는 입력 를 사용하여 Query (Q), Key (K), Value (V) 행렬을 생성한다. 어텐션 출력은 Scaled dot-product attention 방식으로 계산된다:
Loss Function
- Mean Squared Error (MSE) 손실 함수를 사용하며, 이는 먼저 각 채널에 대해서 계산된다. 이후 모든 M개의 univariate time series에 걸쳐 이 손실값을 평균하여 overall objective loss L을 구한다.
Instance Normalization
- Instance Normalization은 PatchTST 모델의 데이터 전처리 단계에서 중요한 역할을 수행하며, 학습 데이터와 테스트 데이터 사이의 distribution shift를 완화하는 데 도움을 주기 위해 사용된다.
- 각 time series instance 를 평균이 0이고 표준편차가 1이 되도록 정규화한다. 이 정규화는 Patching을 수행하기 전에 이루어지며, 정규화 시 계산된 평균과 표준편차 값은 저장해 두었다가, 모델의 최종 출력에 다시 더해져 원래의 스케일로 되돌린다.
- Instance Normalization은 예측 성능을 약간 향상시킨다는 것이 실험을 통해 확인되었으나, 저자는 실험결과를 통해 PatchTST의 주요 성능 향상이 Patching 및 Channel-independence에서 이뤄졌음을 강조하였다.
3.2. Representation Learning
Masked Autencoder
-
supervised learning과 동일한 transformer encoder에서 prediction head를 제거하고 차원의 선형 레이어를 부착한다. 앞서 언급하였듯이, S=P를 활용하여 패치들이 non-overlapped하도록 나눠 마스크된 패치의 정보가 observed된 패치에 포함되지 않도록 설계하였다. 이어 패치 인덱스의 부분집합을 랜덤하게 uniformly 선택하여 해당 패치들을 0값으로 마스킹하였으며, 논문 실험에서는 40%의 높은 마스킹 비율을 활용했다.
-
이는 기존의 time series에서 single 타임 스텝을 정해놓고 마스킹하던 방식과 비교했을 때 두가지 차별점을 가진다. 우선, 단일 타임 스텝 마스킹은 바로 이전 또는 이후 타임 스텝 값의 간단한 interpolation으로 쉽게 추론될 수 있어, 전체 시퀀스에 대한 high quality abstract representation learning의 목표와 충돌했는데, PatchTST는 패치 단위의 마스킹을 통해 이를 재구성하려면 단순 interpolation이상의 고차원적 이해가 필요하도록 모델을 학습하게 하였다. 또한, 모든 타임 스텝에 해당하는 representation vector를 예측 결과로 매핑할 경우 예측 시퀀스 길이나 채널 수가 많을 때 파라미터 수가 급격히 커져 overfitting을 유발할 수 있는데 이 문제에서 비교적 자유로워졌다.
4. Experiments
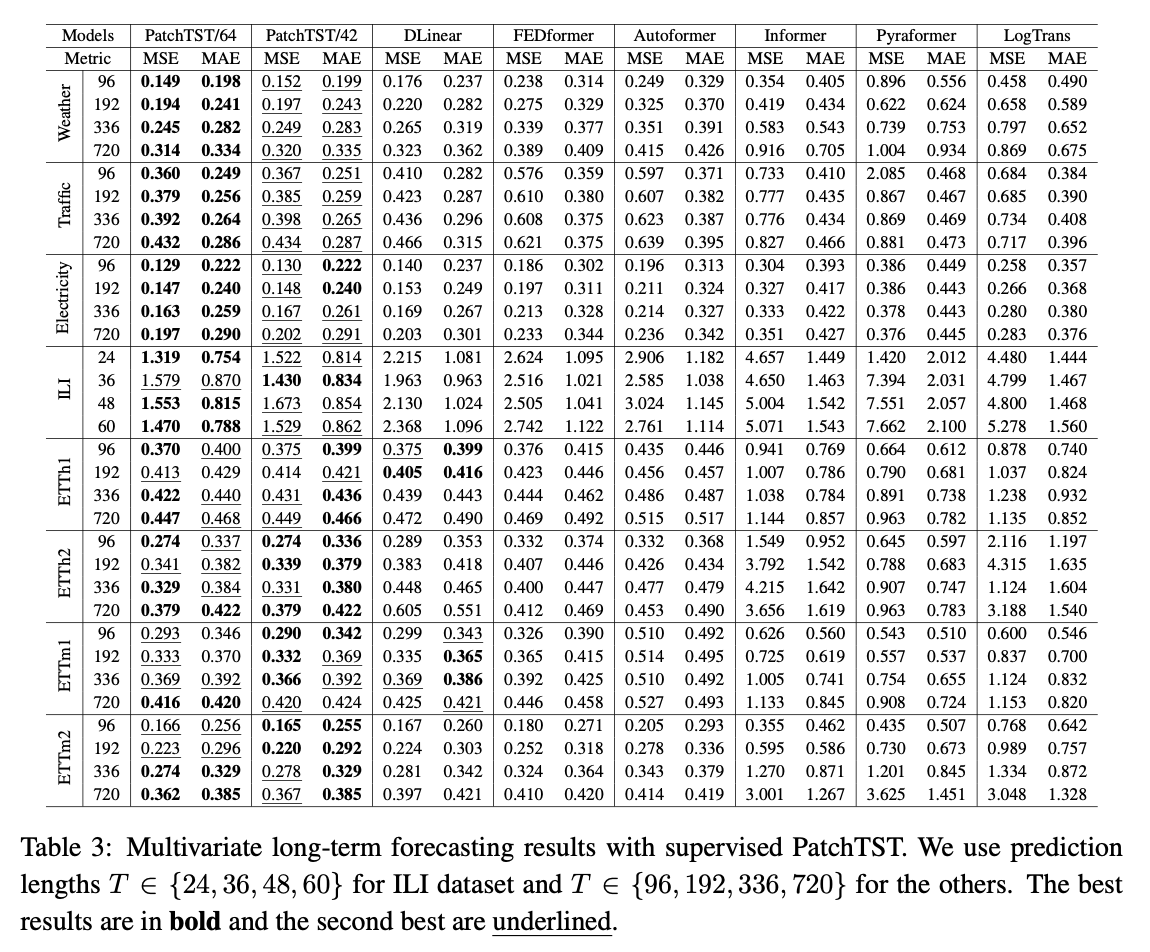
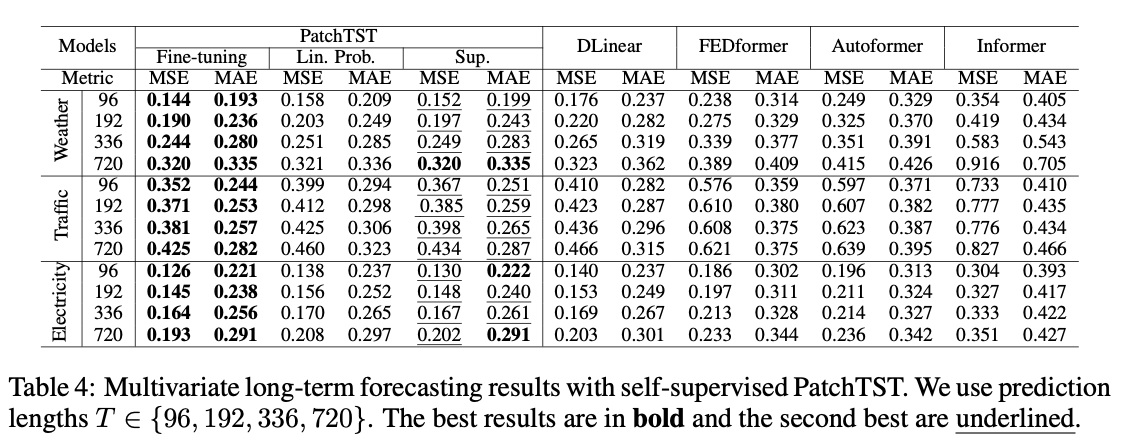
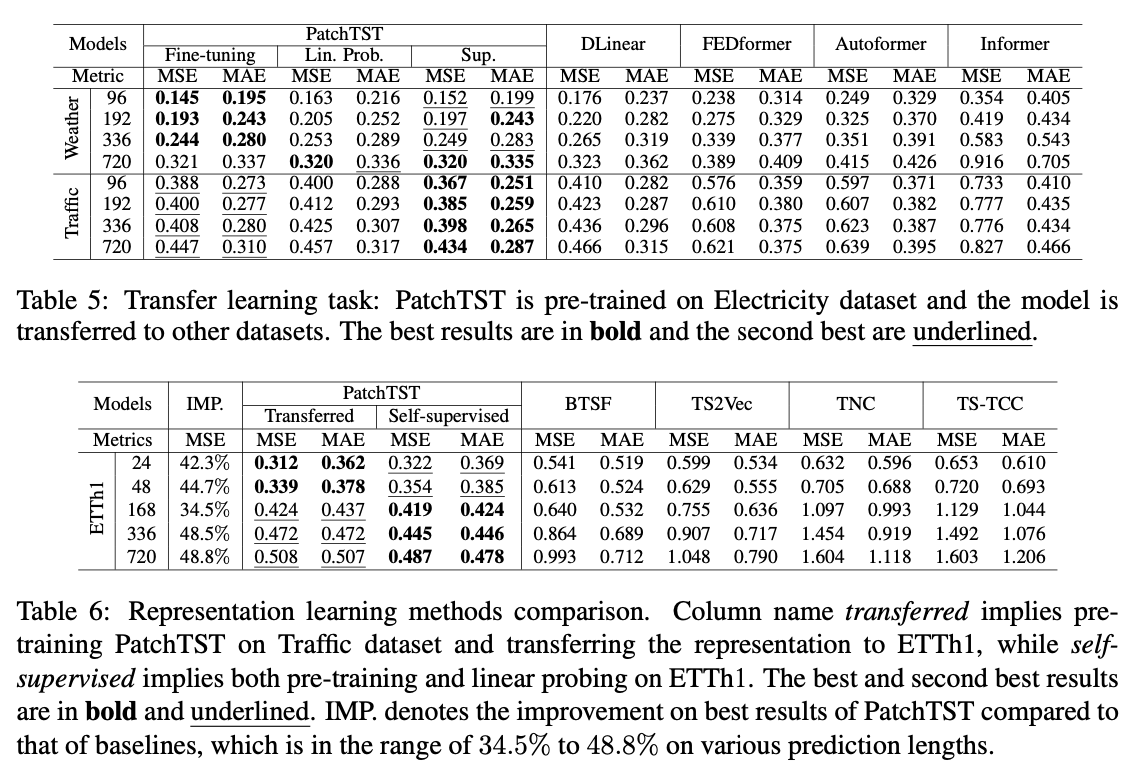
- Weather, Traffic, Electricity, ILI 및 4개의 ETT 데이터셋(ETTh1, ETTh2, ETTm1, ETTm2)을 포함한 8개의 공개 데이터셋을 활용하였으며, Baseline 모델로는 FEDformer, Autoformer, Informer, Pyraformer, LogTrans와 같은 기존 SOTA Transformer 기반 모델들과, Transformer의 유용성에 의문을 제기하며 우수한 성능을 보였던 선형 모델인 DLinear가 사용되었다.
- 다양한 예측 길이 T와 Look-back Window (L)에 대해 실험을 진행하였다.
- 전반적으로 상당히 우수한 예측 성능을 보이면서, supervised learning 뿐만 아니라, self-supervised learning에서 뛰어난 성능이 보였다. linear probing에서도 성능이 우수했지만, 특히 모델 전체를 fine-tuning할 때 가장 우수한 결과를 얻었고, 다른 SOTA (BTSF, TS2Vec, TNC, TS-TCC 등)과 비교해도 더 좋은 퍼포먼스를 보였다.
- Ablation했을 때도 패칭과 Channel-independence가 둘다 들어갈 때 제일 성능이 좋은 모습을 보였다.