자연어 처리 분야에서는 RNN 계열 모델의 한계(장거리 의존성 소실, 순차 처리의 비효율)를 극복하며 Transformer가 등장했고, 병렬 처리와 Self-Attention 메커니즘을 통해 비약적인 성능 향상을 이뤄냈다.
반면 Vision 분야는 AlexNet, ResNet 등 CNN 계열 모델과 YOLO 같은 Detection 특화 모델이 발전하고 있었지만, Transformer를 Vision에 적용하려는 시도는 없었다. CNN은 지역성(Locality)과 이동불변성(Translation Invariance)이라는 Inductive Bias 덕분에 적은 데이터로도 학습이 가능했지만, 전역적인 문맥 이해에는 한계가 있었다.
이에 Google은 "Transformer를 이미지에 그대로 적용할 수 없을까?" 라는 발상으로 ViT를 제안했다. ViT는 이후 CLIP, LLaVA 등 멀티모달 모델의 Vision Encoder로 활용되며, 현재 AI가 텍스트를 넘어 이미지·영상 등 다양한 데이터를 함께 처리할 수 있는 기반을 마련했다.
오늘은 이 논문을 바탕으로 ViT를 이해하고 한번 코드 구현까지 해보고자 한다.
AN IMAGE IS WORTH 16X16 WORDS: TRANSFORMERS FOR IMAGE RECOGNITION AT SCALE
핵심 포인트
1. 기존의 한계와 새로운 접근 방식 (Method)
기존 컴퓨터 비전 분야는 ResNet과 같은 CNN 기반 아키텍처가 지배적이었다. 연구진은 이미지를 NLP의 '단어(Token)'처럼 취급하기 위해, 이미지를 고정된 크기(예: 16x16)의 패치(patch)들로 잘라냈다.
- 이 패치들을 1차원 벡터로 평탄화(flatten)한 후 선형 투영(Linear Projection)을 거쳐 임베딩한다.
- 패치들의 공간적 위치 정보를 보존하기 위해 위치 임베딩(Position Embedding)을 더해준다.
- 또한 전체 이미지의 분류를 수행하기 위해 BERT 모델처럼 시퀀스 맨 앞에 학습 가능한 [class] 토큰을 추가하여, 표준 트랜스포머 인코더에 그대로 입력한다.
2. 귀납적 편향(Inductive Bias)의 극복과 데이터 규모의 중요성
CNN은 지역성(locality)이나 이동 등변성(translation equivariance)과 같이 이미지에 특화된 2차원적 구조의 '귀납적 편향'을 모델 층 전반에 걸쳐 본질적으로 가지고 있다. 반면 ViT는 이러한 편향을 거의 가지고 있지 않다.
- 그 ImageNet과 같은 중간 규모의 데이터셋으로만 학습할 경우, 동급 크기의 ResNet(CNN)보다 성능이 약간 떨어지는 모습을 보였다.
- 하지만 대규모 훈련이 이 귀납적 편향의 부재를 압도한다. 1,400만 장(ImageNet-21k)에서 최대 3억 장(JFT-300M)에 이르는 대규모 데이터셋으로 모델을 훈련하자 상황이 완전히 역전되었다.
3. 주요 성과 (Results)
대규모 데이터셋으로 사전 학습을 마친 ViT는 더 적은 데이터를 가진 다른 과제들로 전이 학습을 했을 때 놀라운 성능을 보여줬다.
- 가장 큰 모델의 경우 ImageNet에서 88.55%, CIFAR-100에서 94.55% 등 기존 최첨단 CNN(BiT, Noisy Student 등)을 능가하거나 근접하는 정확도를 기록
- ViT는 동일하거나 더 높은 성능을 달성하는 데 있어 기존 SOTA CNN 구조보다 사전 학습에 소요되는 컴퓨팅 리소스(TPU 계산량)를 약 2~4배가량 적게 소모(계산 효율성 증가)
우리가 Transformer에 단어들을 입력으로 집어 넣듯 이미지를 특정 단위로 잘라서 문장을 입력하듯 Transformer에 입력하면 이미지도 다룰 수 있게 되었다는 것이다. 꽤 흥미로운 사실인 것 같다.
그럼 어떻게 이미지를 나눴는지 한 번 알아보자.
이미지 패치(Patch): 하나의 이미지를 여러개의 단어로
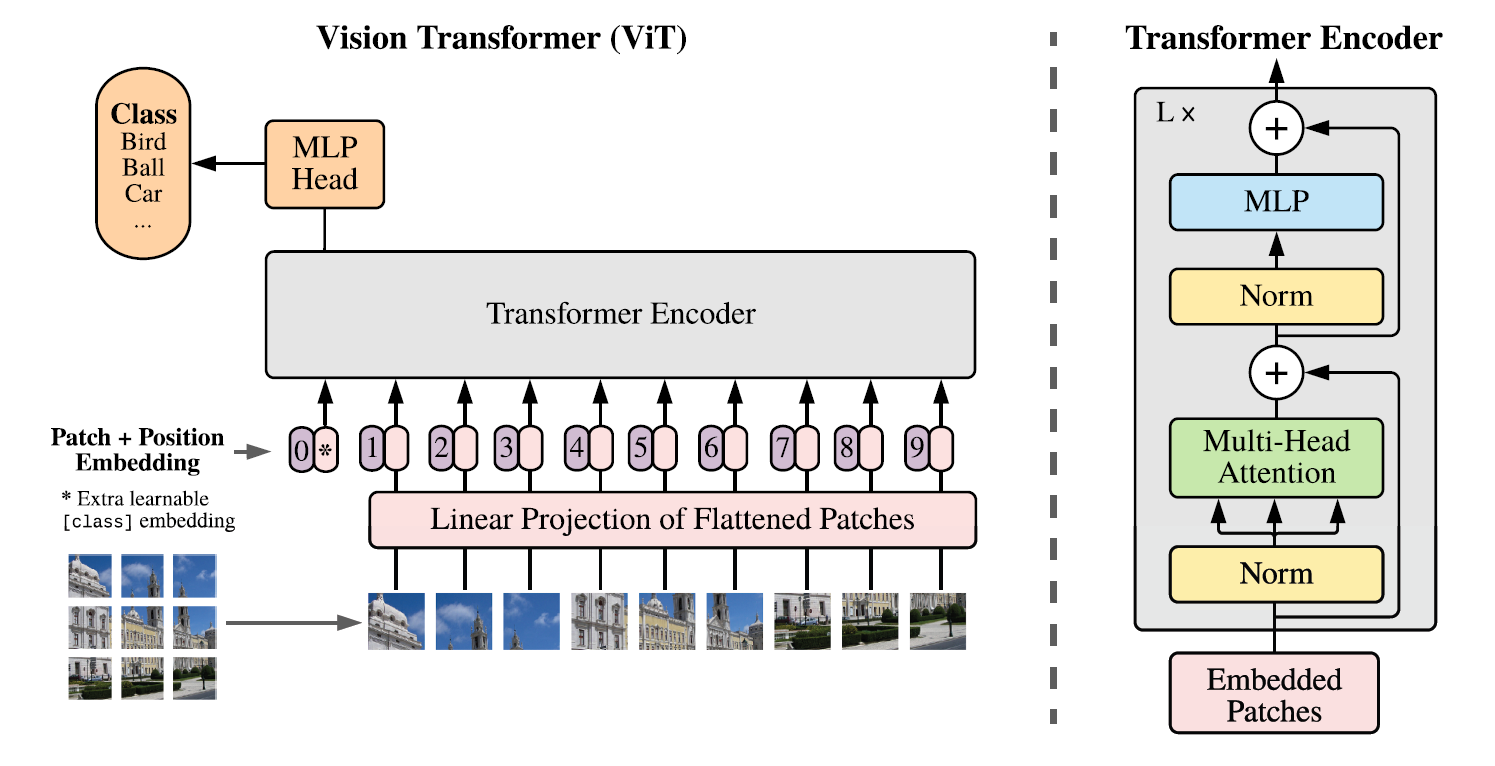
이미지만 봤을 땐, 이미지를 단순히 n등분 하여 이걸 병렬로 트랜스포머 인코더에 집어 넣은 것 같다.
좀 더 자세히 알아보자.
1. 이미지 분할 및 평탄화 (Patch Extraction & Flattening)
우리가 위 도식에서 추측한대로 이미지를 이미지 패치라는 단위로 자르고 이를 1차원 벡터로 나눠준다. 그럼 만약 패치 크기가 라고 하고 이미지의 높이를 , 너비를 라고 할때 생성되는 패치의 수는
가 된다. 아무렇게나 막 패치 크기를 정하면 안되고 원본 이비지 크기에 맞는 크기로 잘라줘야한다.
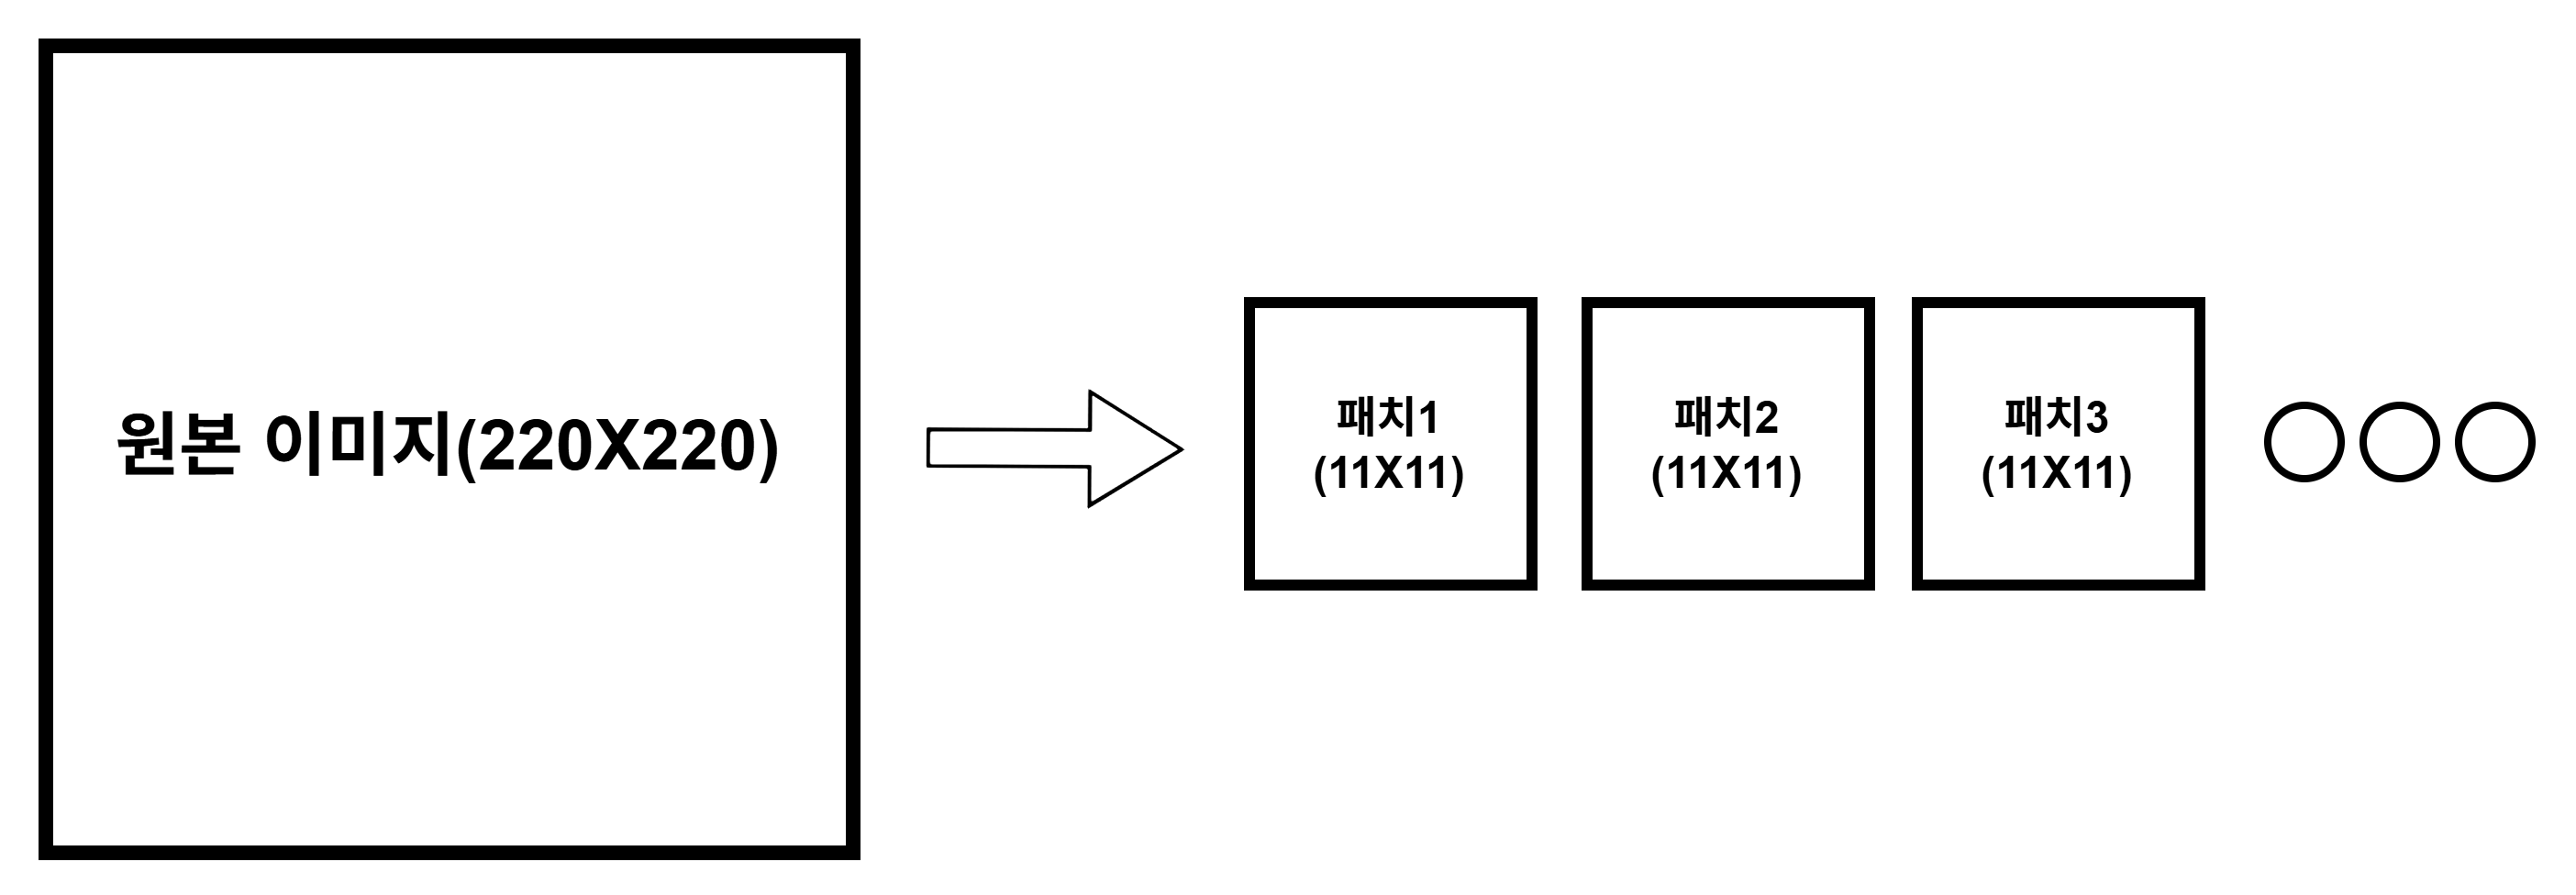
위 그림 처럼 N등분가능한 크기를 지정해서 잘라줘야하며 패치 크기에 따라 트레이드오프를 고려하여 잘라줘야한다.
| 패치 크기 | 패치 수 | 특징 |
|---|---|---|
| 작게(8x8) | 많아짐 | 세밀한 정보 ↑, 연산량 ↑↑ |
| 크기(32x32) | 적어짐 | 연산량 ↓, 세밀한 정보 손실 |
그래서 논문에서는 정확도와 연산량의 최적점으로 16X16을 선택했다.
다음은 이를 긴 실 처럼 1차원 벡터로 바꿔줘야한다. 이를 **평탄화(flatten)이라고 한다.
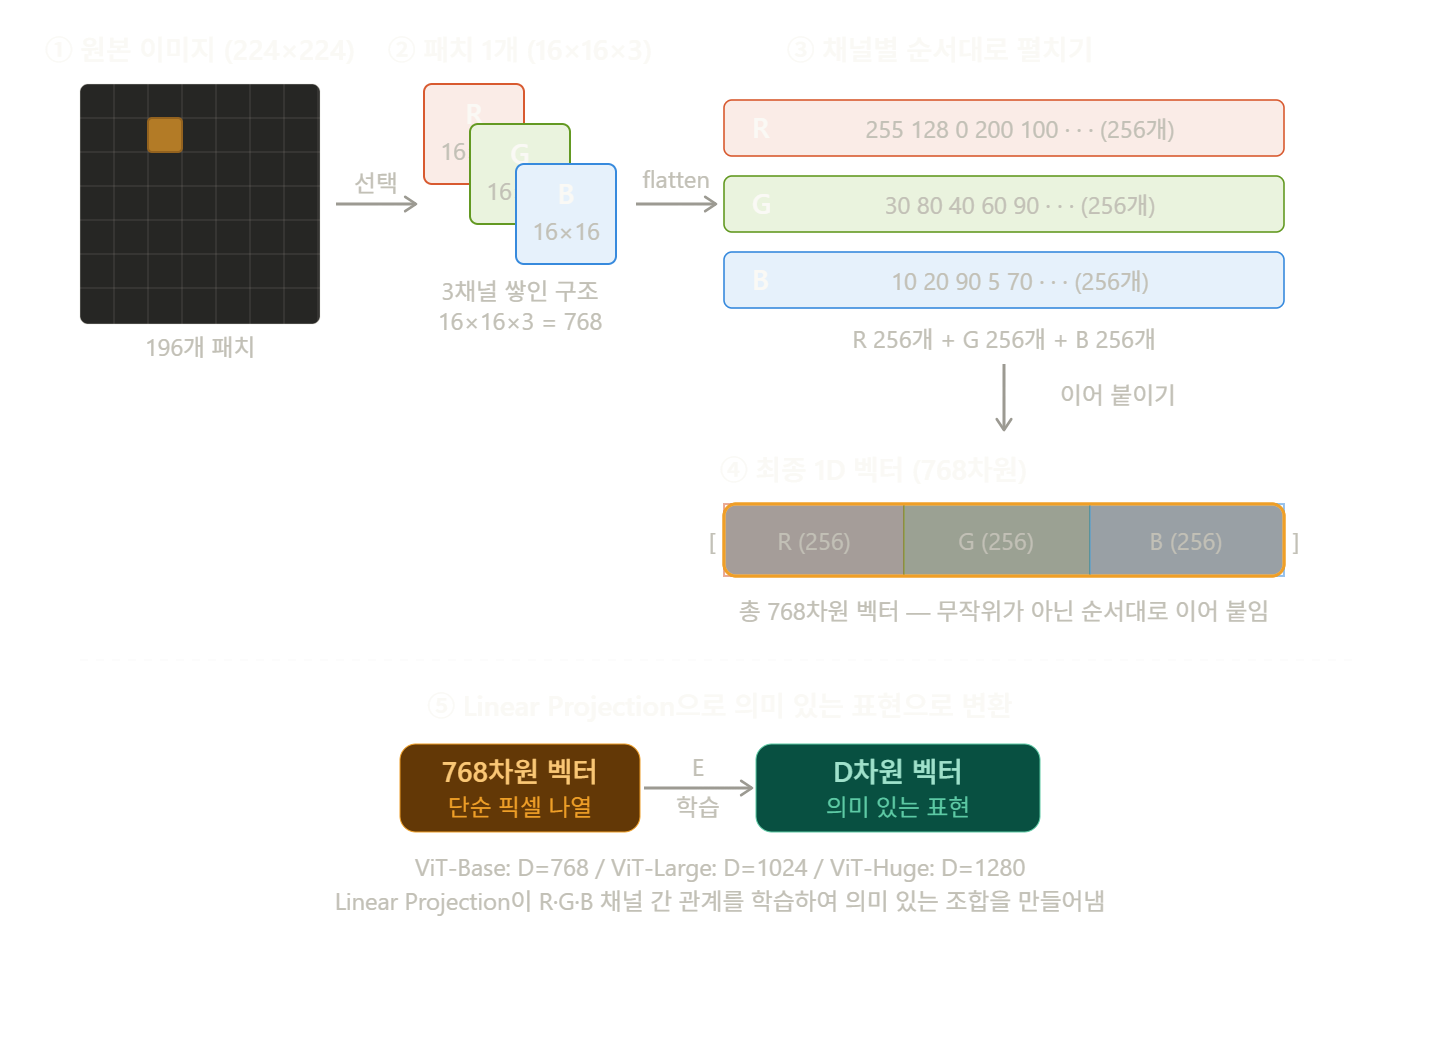
이미지의 각 채널을 아무렇게나 이어붙이는게 아니고 각 채널을 1차원으로 변환하고 순서대로 이어붙이는 것이 중요하다. 논문에서 패치크기를 16x16으로 했기 때문에 총 768차원의 벡터로 변환이 되게 된다.
2. 선형 투영을 통한 패치 임베딩 (Linear Projection)
우리가 이미지를 1차원 벡터로 변환한 것은 단순 숫자를 1줄로 나열한 것에 불과하다. 그래서 모델은 해당 벡터가 고양이 귀 이미지 관련 벡터인지 자동차 이미지 관련 벡터인지 모르기 때문에 특정 패턴을 갖는 행렬(가중치 행렬 E)로 선형 연산을 하여 의미를 추가해줘야 한다. 논문에서 이를 trainable linear projection이라고 표현 했다.
수식은
이고 각 요소의 설명은 아래와 같다.
| 요소 | 설명 |
|---|---|
| 번째 패치를 Flatten한 벡터 (768차원) | |
| 학습 가능한 가중치 행렬 (768 × D) | |
| 패치에 E를 곱해 D차원으로 변환한 패치 임베딩 | |
| 분류를 위한 학습 가능한 CLS 토큰 | |
| 패치 위치 정보를 담은 Position Embedding | |
| Transformer Encoder의 최종 입력 시퀀스 |
행렬 연산 차원은 최종적으로 아래와 같이 변하게 된다.
가중치 행렬과 곱해줘야 하는 이유


두 이미지는 각각 사과(위), 자동차(아래)의 일부이다. ViT에선 이미지를 이와같이 자르고 이를 수치 벡터로 확인하는데 우리는 이미지로 바로 이해하니 맞출 수 있지만 AI는 픽셀 정보만 가지고 이 둘의 차이를 모른다. 그래서 각 이미지에서 보이는 특징 행렬을 랜덤으로 초기화해서 선형변환을 해줘야 하는데 이 과정은 토큰화(Tokenize)+임베딩 변환과정과 굉장히 유사하다.
3. [class] 토큰 추가 (Classification Token): 답안지(백지) 분배
뜬금 없이 시험이 얘기가 나왔는데 우리는 시험을 보면 빈 답안지를 받고 각각 문제를 읽고 정답을 제출한다. 그럼 선생님, 교수님, 채점 시스템에선 제출된 답안지만 참고해서 채점을 하고 점수를 매긴다.
이 ViT에서도 동일하다. 우리가 이미지를 잘게 나눠서 ViT의 Transformer Encoder에 입력하고, 최종적으로 각 페치의 어텐션 스코어가 계산된 출력 값이 나왔다고 생각 해보자. 그럼 모델은 어떤 패치를 참고해서 분류결과를 생성해야할까? 각 패치는 이미지의 일부분에 대한 정보만 담고 있어 예를들어 고양이 이미지의 눈 부분 패치만 보면 정답이 눈(eye)가 될 수 있다.
하지만 진짜 정답은 고양이여서 결국 전체 패치에 대한 정보를 요약해서 담고 있는 특정 토큰이 필요한 것이다. 그래서 연구진들은 BERT모델처럼 제일 앞에 CLS라는 특수 토큰을 추가해여 MLP에서 해당 토큰만 참조하여 결과를 출력하도록 하였다. 이 역시 랜덤한 값으로 이뤄져 있어 역전파로 업데이트가 된다.(a learnable embedding)
4. 위치 임베딩 더하기 (Position Embedding): 퍼즐 맞추기의 정답
Transformer 모델은 입력값을 병렬로 계산한다. 각 토큰을 순차적으로 계산하는게 아니라 한번에 계산하여 토큰의 순서를 모른다. 그래서 NLP에서도 어텐션 블록에 입력되기 전에 단어의 순서를 담는 위치 임베딩(Postion Embedding)을 더 해주는데 이미지의 경우도 마찬가지다.
우리가 퍼즐을 풀 때, 각 조각마다 정해진 위치가 있어 다 맞춰지면 하나의 이미지가 되어서 어떤 이미지 인지 알 수 있게 된다. 그런 것과 동일하게 각 패치의 원래 위치와 순서가 있을 텐데 그것에 대한 위치 벡터를 추가해주게 되면 계산이 되고도 이 위치정보가 있어 어떤 이미지인지 알 수 있게 된다.
논문 실험 결과
논문 Figure 7, Table 8에서 Position Embedding 방식 4가지를 비교하였다.
| 방식 | 설명 | 성능 |
|---|---|---|
| No Pos. Emb. | 위치 정보 없음 | 0.613 |
| 1D Pos. Emb. | 패치를 1열로 순서 부여 | 0.642 |
| 2D Pos. Emb. | X축, Y축 따로 위치 부여 | 0.640 |
| Relative Pos. Emb. | 패치 간 상대적 거리 | 0.640 |
핵심 결과 1 — 위치 정보 유무가 결정적이다.
위치 정보가 없으면 0.613, 있으면 0.640 이상으로 성능이 크게 오른다.
핵심 결과 2 — 방식 간 차이는 거의 없다.
2D 이미지이므로 2D Position Embedding이 더 좋을 것 같지만, 단순한 1D 방식으로도 충분하다.
패치 단위로 입력받기 때문에 공간 해상도가 이미 낮아져 있어 (14×14), 정교한 2D 위치 인코딩이 필요하지 않기 때문이다.
결론: 위치 정보는 반드시 필요하지만, 단순한 1D 방식으로도 충분하다.
ViT의 구조적 특징
기존 Transformer Encoder와 동일하지만, 입력이 이번엔 **이미지로 바뀌었다. 그래서 입력전에 어텐션을 계산 할 수 있는 형태로 바꿔주는 Layer가 있었다.
그리고 논문에서도 강조한 것은
"우리는 기존 Transformer의 형태를 거의 그대로 보존하였다."
이다.
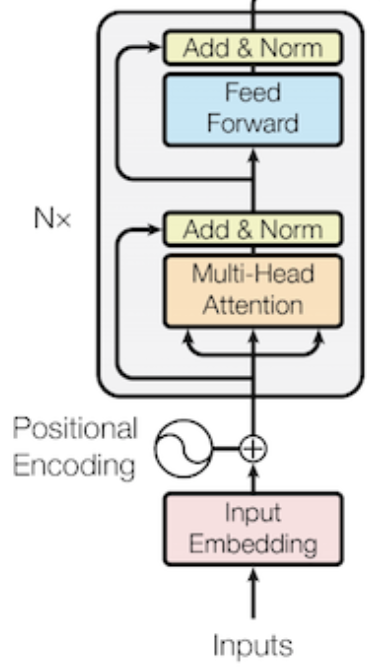
이것은 원래 Transformer Encoder이고
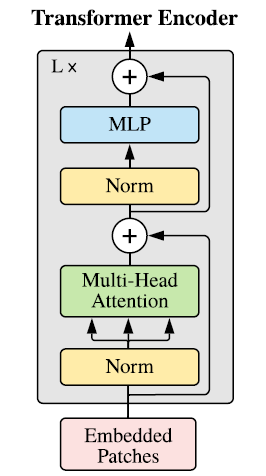
이건 ViT의 Encoder이다.
보게되면 정규화(LayerNorm) 위치만 바뀌었다. 이는 학습 안정성을 위해 순서를 바꾼 것이라고 한다.
단순히 말해 만약 정규화를 어텐션 계산후 진행하게 되면 값이 너무 커지거나 작아질 수 있다. 이는 특히 Layer가 깊어져 Gradient가 발산, 수렴해서 생기는 문제이다. 그래서 이를 막기 위해 값을 미리 정규화하여 안정적으로 Gradient가 변하도록 한 것이다.
실험 결과 및 결론
실험 결과가 다소 놀라웠다. 큰 효과가 있을 줄 알았던 반면 소규모 데이터셋에선 기존 CNN이 더 좋은 성능을 보인 것이다.
실험 결과
대규모 데이터셋(JFT-300M) 사전학습 시 CNN을 능가하였다.
| 모델 | ImageNet | 사전학습 비용 |
|---|---|---|
| ViT-H/14 | 88.55% | 2.5k TPU-days |
| ResNet152x4 | 87.54% | 9.9k TPU-days |
| EfficientNet-L2 | 88.4% | 12.3k TPU-days |
동일 성능을 4~5배 적은 연산량으로 달성하였다.
소규모 데이터셋에서는 CNN보다 낮은 성능을 보였다.
| 데이터셋 | 결과 |
|---|---|
| ImageNet (1.3M) | ResNet보다 낮음 |
| ImageNet-21k (14M) | ResNet과 대등 |
| JFT-300M (300M) | ResNet 완전히 능가 |
결론
① CNN 없이도 Vision 문제를 풀 수 있다.
이미지 특화 구조(CNN) 없이 순수 Transformer만으로 SOTA를 달성하였다.
② 대규모 데이터가 Inductive Bias를 대체한다.
CNN의 Inductive Bias(지역성, 이동불변성)가 없어도 데이터가 충분하면 스스로 학습할 수 있다.
③ 연산 효율이 뛰어나다.
동일 성능 대비 ResNet보다 훨씬 적은 사전학습 비용으로 학습이 가능하다.
한계 및 향후 과제
- 소규모 데이터에서 여전히 CNN보다 성능이 낮다.
- Detection, Segmentation 등 다른 Vision Task 적용이 필요하다.
- Self-supervised 사전학습 가능성 탐색이 필요하다. (실험 결과 79.9%, Supervised 대비 4% 낮음)
결론: 대규모 데이터로 사전학습하면 Transformer를 Vision에 그대로 써도 CNN보다 잘 된다.
큰 효과가 있다기 보단 정말 이미지 분야에서 Transformer가 사용될 수 있다는 것을 보여준 의미 있는 연구인 것 같다. 특히 Encoder를 사용해서 분류 모델을 만든 점이 인상적이었고 Decoder를 사용하면 이미지를 생성할 수 있는 건가?라는 점과 전통적 텍스트 Transformer Encoder, Decoder를 조합해서 멀티 모달 모델을 만들 수 있을까?가 궁금했다.
요약 및 다음 내용
- "ViT는 이미지를 16×16 패치로 잘라 토큰처럼 취급하고, Transformer에 수정 없이 입력했다.
- CNN이 가진 Inductive Bias가 없어 소규모 데이터에선 불리하지만, 대규모 데이터셋에서는 CNN의 편향 없이 더 자유롭게 패턴을 학습해 성능이 우수했다."
2문장으로 요약했다. 당연히 눈으로 확인해보는 것이 좋을 것이니 CNN과 ViT를 직접 Pytorch로 작성해서 학습해보고 비교해보려고 한다.
그리고 ViT를 공부했으니 다음은 이미지와 텍스트를 같은 공간에 놓고 서로 연결시키는 모델인 CLIP를 한번 공부해보겠다.