시간도 많이 남으니 논문 리뷰도 꾸준히 하려고 한다. 그동안 읽고 그냥 방치한 것도 많은데 엔지니어로 취직하게 되면 많은 논문을 읽고 문제 상황에 맞는 모델을 찾아야하니 영어도 익숙해질 겸 2~3주에 1개씩 읽고 정리할 예정이다.
The Llama 3 Herd of Models
1. 개요
이 논문은 Meta AI에서 개발한 LLM 시리즈인 Llama-3를 소개하는 논문이다. 모델은 8B, 70B, 405B 세 가지 사이즈로 구성된 다국어 지원 dense Transformer기반의 파운데이션 모델이다.
해당 모델의 개발 목표는 다음과 같다.
1. Llama-2 대비 훨씬 방대하고 정제된 학습 데이터 구축
2. 역대 최대 규모의 파라미터를 갖는 405B 모델을 학습한다.
3. dense Transformer를 유지해 훈련 안정성을 최대화 한다.
dense Transformer란?(추가 예정)
모델은 세 가지 다른 사이즈 이외에도 Fine-tune된 모델인 Instruct모델도 제공하고 있다.
2. 모델 특징
아키텍쳐
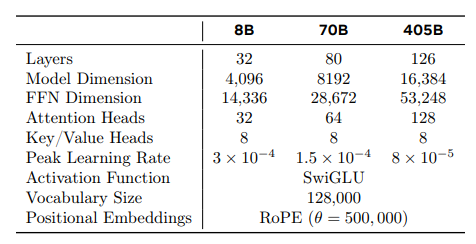
Llama 3는 MoE 없이 표준 Dense Transformer decoder-only 구조를 채택했다. 복잡성을 최소화하고 훈련 안정성을 높이기 위한 의도적인 선택이다. 주요 아키텍처 개선 사항은 다음과 같다.
- 8개의 key-value head를 공유하는 GQA를 전 모델 크기에 적용. 추론 속도를 높이고 KV 캐시 메모리를 대폭 절감한다.GQA (Grouped Query Attention):
- tiktoken 기반 100K 토큰에 비영어권 언어 지원을 위한 28K 토큰을 추가해 총 128K 어휘 사전 구성. Llama 2 대비 인코딩 효율이 15% 이상 향상됐다.128K 토크나이저:
- RoPE base frequency를 500,000까지 높여 128K 토큰의 긴 컨텍스트를 안정적으로 지원한다.RoPE (Rotary Positional Embedding):
- 동일 시퀀스 내 서로 다른 문서 간 self-attention을 차단하는 마스크를 적용해, 특히 긴 컨텍스트 훈련 단계에서 성능이 개선됐다.Document Attention Mask:
모델별 파라미터 정리표이다.
훈련 파이프라인
모델 학습 관련해서 사전 훈련(Pre-training), 사후 훈련(Pre-training) 두 단계로 진행 되었다.
- 훈련 인프라: • 16,000개의 H100 GPU(80GB HBM3, 700W TDP)를 활용하며, Data / Model / Pipeline 세 가지 병렬화 기법을 결합해 400+ TFLOPS/GPU의 컴퓨트 효율을 달성했다.
- Pre-training: 15T+ 다국어 토큰으로 다음 토큰 예측(next-token prediction) 학습. 초기 8K 컨텍스트로 훈련 후 6단계에 걸쳐 점진적으로 128K까지 컨텍스트를 확장한다. 장문 컨텍스트 훈련에는 약 800B 토큰이 사용됐다.
- Post-training: • SFT(Supervised Fine-Tuning) → Rejection Sampling → DPO(Direct Preference Optimization) → PPO(Proximal Policy Optimization)의 순서로 여러 라운드 반복 수행. Llama 3 405B가 소형 모델의 post-training용 합성 데이터 생성에도 활용됐다.
멀티모달 확장
해당모델에 멀티모달로서 확장을 위해 이미지 인코더, 비디오 인코더, 음성 인코더를 각각 따로 학습한 뒤 언어 모델에 결합하는 방식으로, 이미지·영상·음성 인식 태스크에서 최고 수준에 준하는 성능을 보인다.(논문 발표 당시 개발중)
3. 훈련 데이터
Llama 3는 공개 소스에서만 수집한 약 15T(15조) 개의 다국어 토큰으로 훈련됐다. Llama 2의 1.8T 대비 약 8배 이상 규모다.
데이터 수집 및 전처리
데이터 수집과 전처리 절차는 다음과 같다.
- 웹 크롤링 기반 수집: Web crawl 데이터가 대부분을 차지하며, 품질·안전성·다양성 기준의 다단계 필터링 파이프라인을 거친다.
- 언어 식별: fastText 기반 언어 분류기를 사용해 비영어 문서를 분류하고, 최종적으로 영어·독일어·프랑스어·이탈리아어·포르투갈어·힌디어·스페인어·태국어 등 8개 주요 언어를 지원한다.
- 중복 제거 (Deduplication): URL 수준·문서 수준·라인 수준의 3단계 중복 제거를 수행해 데이터 품질을 높인다.
- 품질 필터링: 학습된 분류기(fastText 기반)와 Heuristic 기반 필터를 조합해 저품질 콘텐츠를 제거한다. 과도한 사과 표현, 불필요한 이모지, 편향된 표현 등도 제거 대상이다.
도메인별 데이터 전략
- 코드 데이터: GitHub 저장소 수준의 고품질 코드 데이터를 포함하며, 코드 전문가 모델은 85% 이상 코드 데이터로 구성된 믹스로 continued pre-training을 거쳤다.
- 수학 데이터: 수학 관련 웹 페이지 및 문제 풀이 데이터를 추가 확보해 수학적 추론 능력을 강화했다.
- 다국어 데이터: 비영어권 데이터의 비율을 Llama 2 대비 대폭 확대해 다국어 성능을 높였다.
- 합성 데이터 (Synthetic Data): Post-training 단계에서 Llama 3 405B가 소형 모델 학습용 합성 데이터를 생성하는 데 활용됐다. 이는 인간 어노테이션의 효율적인 대안으로 사용된다.
🔬 데이터 오염(Contamination) 이슈
- 논문에서는 MMLU 등 주요 벤치마크와의 훈련 데이터 오염 가능성을 인정하면서도, 오염 기준을 8단어 이상 겹침으로 높이면 성능 추정이 불가능할 정도로 오염 점수가 높아진다고 밝혔다.
- 벤치마크 점수 해석 시 유의해야 한다.
4. 벤치마크 성능 비교
논문은 Llama 3를 GPT-4, GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro, Nemotron 4 340B 등 당시 최고 수준의 모델들과 150개 이상의 벤치마크에서 비교 평가했다.
주요 벤치마크 결과
| 벤치마크 | Llama 3.1 405B | GPT-4o | Claude 3.5 Sonnet |
|---|---|---|---|
| MMLU (5-shot) | 87.3% | 89.1% | 89.9% |
| MMLU (0-shot, CoT) | 88.6% | 88.7% | 88.3% |
| IFEval | 88.6% | 85.6% | 88.0% |
| HumanEval (코딩) | 89.0% | 90.2% | 92.0% |
| GSM8K (수학) | 96.8% | 96.1% | 96.4% |
| MATH (0-shot) | 73.8% | 76.6% | 71.1% |
| ARC-C (추론) | 96.9% | 96.7% | ~96% |
| MGSM(다국어) | 91.6% | 90.5% | 91.6% |
항목별 우위 분석
- 수학 분야 (GSM8K/MATH): GSM8K에서 96.8%로 GPT-4(94.2%)와 Claude 3.5 Sonnet(96.4%)를 능가했다. MATH 벤치마크에서도 73.8%로 Claude 3.5 Sonnet(71.1%)과 GPT-4(64.5%)를 크게 앞선다.
- 명령 수행 (IFEval): 88.6%로 GPT-4o(85.6%)와 Claude 3.5 Sonnet(88.0%)을 모두 소폭 상회하는 수준으로, 사용자 지시를 따르는 능력이 뛰어나다.
- 장문 컨텍스트: InfiniteBench 등 초장문 컨텍스트 벤치마크에서 GPT-4(72.1%)를 큰 폭으로 앞서는 83.4%를 기록했다. 128K 컨텍스트를 실질적으로 활용하는 능력에서 강점을 보인다.
- Frontier 대비 전반적 동등성: 전체적으로 Llama 3.1 405B는 GPT-4o 및 Claude 3.5 Sonnet과 비슷한 수준의 성능을 보이며, 일부 태스크에서는 이를 능가한다. 소형 모델인 8B와 70B는 각 파라미터 크기에서 오픈소스 SOTA를 달성했다.
⚠️ 주의 사항
벤치마크 비교 수치는 Meta가 자체 발표한 수치를 기반으로 하며, 모델마다 평가 방법(few-shot 수, 프롬프트 포맷 등)이 다를 수 있다.
독립적인 서드파티 평가에서는 일부 항목(예: MMLU-Redux)에서 GPT-4o 대비 성능 차이가 더 크게 나타난 경우도 있다.
5. 결론 및 적용 시나리오
결론
Llama 3는 오픈소스 LLM의 역사에서 중요한 전환점이 되는 모델이다. 논문이 제시하는 주요 성과와 한계를 요약하면 다음과 같다.
- 성과 1 — 오픈소스 최초의 프론티어급 모델: 405B 파라미터 모델은 GPT-4o·Claude 3.5 Sonnet과 동급의 성능을 오픈소스로 달성해, 기존의 '오픈소스는 클로즈드 모델에 뒤처진다'는 통념을 깼다.
- 성과 2 — 스케일링 법칙 재조명: Chinchilla optimal 기준을 훨씬 초과한 15T 토큰으로 훈련해도 모델 성능이 log-linear하게 계속 향상됨을 실증했다. 소형 모델에서도 과훈련(overtraining)은 추론 효율 측면에서 유리하다.
- 성과 3 — 상업적 활용 허용 라이선스: 월 활성 사용자 7억 명 미만의 서비스라면 상업적 사용이 허용되며, Llama 3 출력물을 다른 모델 훈련(蒸溜)에도 사용할 수 있도록 라이선스를 완화했다.
한계
하지만 여전히 한계점은 존재하였다.
- 한계 — 멀티모달 미공개: 이미지·비디오·음성 통합 멀티모달 모델은 논문에서 실험 결과를 제시했으나, 공식 릴리즈에서는 제외됐다. 향후 공개 예정.
- 한계 — 추론 속도: 405B 모델은 GPT-4o·Claude 3.5 Sonnet 대비 토큰 생성 속도(throughput)가 느린 경향이 있다.
모델별 사용 시기 추천
- 온프레미스/프라이빗 배포(8B/70B): 클라우드 API에 데이터를 보내지 않고 사내 서버에서 직접 구동 가능
- 합성 데이터 생성(405B): 소형 모델 fine-tuning용 고품질 합성 레이블·응답 생성에 활용
- 코드 생성 어시스턴트(70B/405B): HumanEval 89%로 GPT-4 수준의 코딩 성능, 오픈소스로 서비스 구축 가능
- 비용 최적화 RAG(8B/70B): API 비용 없이 저렴한 GPU 비용만으로 GPT-4급 지식 검색 응답 구축
- 다국어 서비스(3.1 계열 전체): 8개 언어 네이티브 지원, MGSM에서 GPT-4o를 소폭 앞서는 다국어 추론
- Fine-tuning 베이스 모델(8B/70B): 가중치 공개로 도메인 특화 fine-tuning이 자유로움
- 긴 문서 분석(3.1 계열 128K): 128K 토큰(약 300 페이지 분량) 문서를 단일 컨텍스트로 처리 가능
6. 마무리
오늘은 오픈소스로 공개된 LLM 모델인 Llama-3가 어떤 문제를 해결하기 위해 개발하게 되었는지, 어떻게 학습하고 어떤 성과를 이뤘는지 알아보았다. 특히 흥미로웠던 것은 학습 및 실험파트였는데 그곳에서 Llama 3.1 405B의 출력을 이용해 소형 모델(8B/70B)을 증류(distillation)하거나 fine-tuning 데이터를 생성하는 파이프라인이 흥미로웠다. 흔히 다양한 언어모델이 나오고 많은 작업을 수행할 수 있어짐에 따라 모델을 통해 튜닝을 하거나 데이터셋을 구성한다는 것은 익히 알고 있었는데, 논문에서도
- 소형 모델 Post-training용 합성 데이터 생성
- LLM-as-a-Judge (모델 평가자로 활용)
- Rejection Sampling(대형 모델로 후보 답변 생성)
- FP8 양자화 (경량화)
에 사용했었다. 직접 데이터를 수집하고 검수해서 모델 학습이나 조정을 진행할 수 있지만, 이런식으로 큰 모델이 작은 모델을 키운다는 구조가 참 인상깊었다. 시간날때 Llama 자체 아키텍쳐, 상세 실험 과정을 좀 읽어보고 추가 리뷰를 하려고 한다. 재미있는 논문이었다.