실행계획(EXPLAIN)이란?
옵티마이저가 SQL문을 어떤 방식으로 어떻게 처리할 지를 계획한 것을 의미
실행 계획 조회 방법
EXPLAIN [SQL문]
실행 계획 상세 조회 방법
EXPLAIN ANALYZE [SQL문]
EXPLAIN문 실행할 때, 결과로 나오는 칼럼 정리
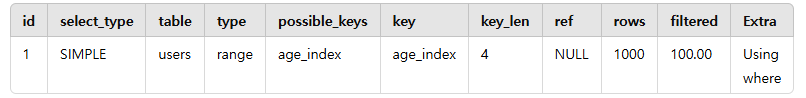
EXPLAIN 결과 항목 정리
- id : 실행 순서
- select_type : 쿼리의 종류
- table : 실행되는 테이블명
- type : 테이블의 데이터를 어떤 방식으로 조회했는지
- possible_keys : 쿼리 실행 시 사용가능한 인덱스의 목록
- key : 실제로 사용된 인덱스
- key_len : 사용된 인덱스에서 비교하는 키의 길이
- ref : 조인할때 대상이 되는 칼럼
- rows : 쿼리에서 검색해야 하는 예상 행 수(추정치) <- 해당 값을 줄이는게 튜닝의 핵심
- filtered : 쿼리 실행 시 필터링된 레코드의 비율(100개의 레코드 대비 실 사용된 레코드 비율(추정치). 해당 값이 작으면 작을수록 비효율적인 계획)
- Extra : 쿼리 실행과 관련된 추가적인 정보
EXPLAIN_Type 정리
- ALL : 풀 테이블 스캔으로 인덱스를 사용하지 않는 유일한 방식. 위에서 아래로 값을 전부 찾을 때까지 스캔한다. ex) select * from users order by name
- INDEX : 풀 인덱스 스캔으로 인덱스를 처음부터 끝까지 스캔하며 찾는 방식. ALL보다 효율적이나 동일하게 인덱스를 위에서 아래로 스캔한다는 방식에 있어서 완전 효율적이라고 보기는 어렵다. ex) (name에 인덱스가 걸려있을 때) select * from users order by name
- CONST : 조회하고자 하는 1건의 데이터를 바로 찾을 수 있는 방식. UNIQUE 제약 조건이 걸린 칼럼 혹은 PK와 같이 중복이 없는 경우가 CONST 방식이 된다.(UNIQUE가 아닐 경우, 중복된 값이 있을 수 있기 때문에 다른 데이터들도 체크해봐야 함)
- RANGE : 인덱스를 활용해 범위 형태의 데이터를 조회. (BETWEEN, 부등호, IN, LIKE) 인덱스가 애초에 정렬이 되어 있기에 효율적인 방식이라고 볼 수 있지만, 범위가 클 경우에는 오히려 성능의 저하가 발생할수도 있다.
- REF : 유일하지 않은(=UNIQUE가 아닌) 인덱스를 활용하는 방식. (CONST의 반대)
이외에도 eq_ref, index_merge, ref_or_null 등의 방식이 존재한다.
EXPLAIN ANALYZE문 실행할 때, 결과로 나오는 정보 정리
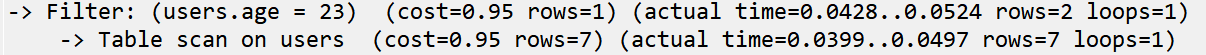
Table scan on users : users 테이블을 풀 스캔
rows=7 : 접근한 데이터의 총 수
time=0.0399..0.0497 : 첫 데이터 접근 시간 .. 마지막 데이터 접근 시간
Filter: (users.age = 23) : 필터링을 통한 데이터 추출 시간
※ 실제 필터링에 걸린 시간 : 0.0524 - 0.0497 = 0.0037
어제보다 더 나은 하루