비전 AI 모델의 논문이나 아키텍처를 분석하다 보면 종종 이런 의문이 들 수 있습니다.
"단순히 공간(Spatial) 도메인의 이미지를 주파수(Frequency) 도메인으로 변환하는 것 아닌가요? 이게 전체를 보는 '전역성(Globalness)'과 대체 무슨 관련이 있을까요?"
이는 모델의 구조와 연산 특성을 꿰뚫어 보는 매우 예리하고 핵심적인 지적입니다. 결론부터 말씀드리면, 공간 도메인을 주파수 도메인으로 변환하는 수학적 과정 자체가 이미지 전체 픽셀을 한 번에 합산(Integration)하는 과정이기 때문입니다.
오늘은 푸리에 변환의 본질과, 실무에서 이를 훌륭하게 대체하는 팽창 합성곱(Dilated Convolution)의 원리를 단계별로 파헤쳐 보겠습니다.
1. 푸리에 변환과 '전역성(Globalness)'의 비밀
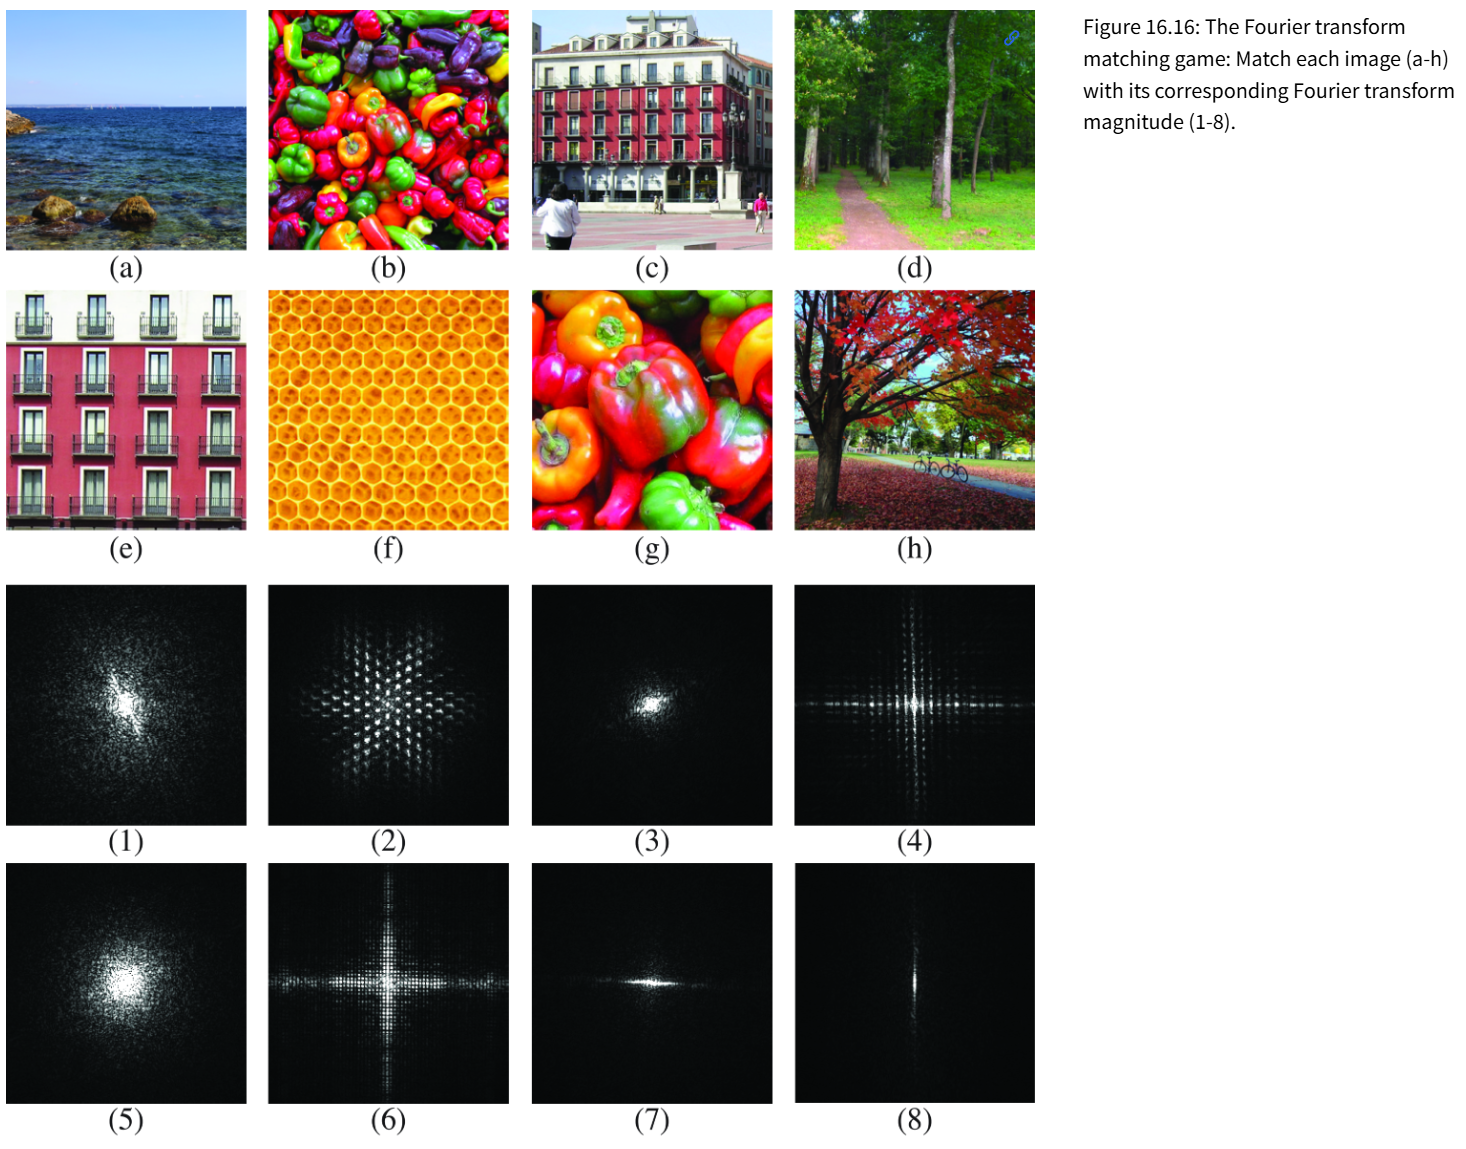
푸리에 변환은 픽셀의 밝기 값을 2차원 공간(x, y 좌표)에 나열한 이미지를 다양한 주기를 가진 사인파와 코사인파(주파수)들의 합으로 분해하는 작업입니다. 이 과정이 왜 '전역성'을 띠는지 수식을 통해 명확히 확인할 수 있습니다.
2D 이산 푸리에 변환(DFT) 식은 다음과 같습니다:
- : 원본 이미지(공간 도메인)의 특정 픽셀 값
- : 주파수 도메인에서의 특정 점 (특정 주파수 성분의 강도)
여기서 가장 중요한 핵심은 바로 (시그마) 기호입니다. 주파수 도메인에서 단 하나의 점 값을 계산하기 위해, 공간 도메인의 모든 픽셀 (높이 , 너비 전체)가 연산에 참여하게 됩니다.
이를 일반적인 합성곱과 비교해 보면 그 차이가 극명합니다.
| 연산 방식 | 수용 영역 (Receptive Field) | 특징 |
|---|---|---|
| 일반 3x3 Conv | 극히 제한적 (Local) | 커널 중심을 기준으로 주변 8개 픽셀만 관찰. 512x512 이미지에서는 한 번에 볼 수 있는 영역이 매우 좁음. |
| 푸리에 합성곱 (FFC) | 이미지 전체 (Global) | 텐서를 주파수 도메인으로 변환 후 조작. 주파수 도메인에서의 미세한 조작 하나가 역변환 시 원래 이미지 전체 영역에 영향을 미침. |
즉, FFC는 단 하나의 레이어만으로도 이미지 전체 크기와 동일한 '유효 수용 영역'을 확보합니다. 이것이 바로 건물 창문의 배열이나 반복되는 패턴 등 거대한 마스크 영역 너머의 정보를 단번에 파악하는 전역성의 비밀입니다.
2. 현실적인 대안: 팽창 합성곱 (Dilated Convolution)
FFC가 전역성 측면에서 완벽해 보이지만, 모바일 기기와 같이 연산 자원이 제한적인 배포 환경에서는 사용하기 까다로울 수 있습니다. 이에 대한 실용적인 대안으로 등장한 것이 바로 팽창 합성곱(Dilated Convolution)입니다.
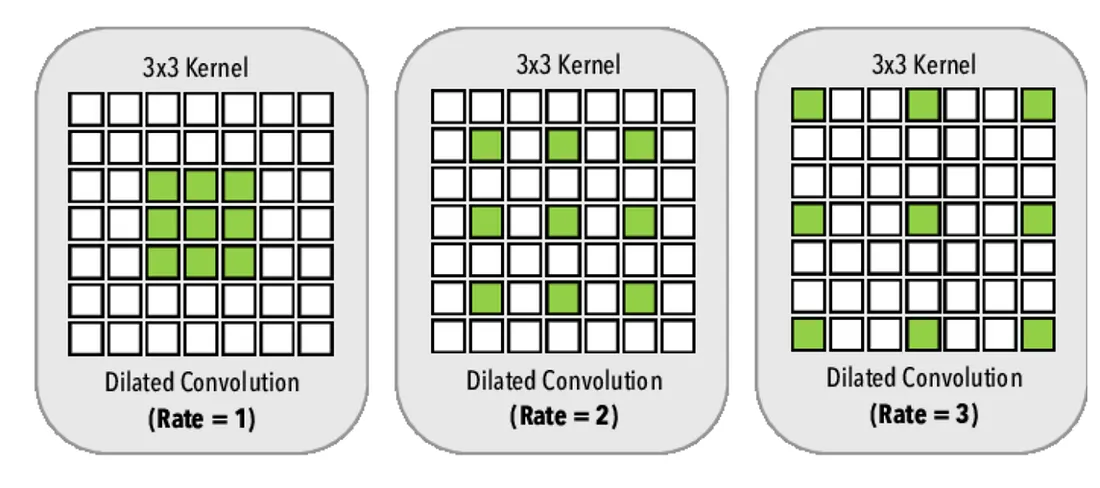
이 기법은 필터 커널의 요소들 사이에 의도적으로 빈 공간(Hole)을 띄워놓고 연산합니다. 파라미터 수는 그대로 유지하면서, 모델이 바라보는 시야(수용 영역)만 넓히는 마법 같은 방법입니다.
- Dilation Rate = 1 (일반 Conv): 우리가 아는 촘촘한 3x3 필터입니다. 수용 영역은 3x3입니다.
- Dilation Rate = 2: 픽셀 1개씩을 건너뛰며 필터를 적용합니다. 실제 곱해지는 가중치 개수는 9개로 동일하지만, 수용 영역은 5x5로 넓어집니다.
- Dilation Rate = 4: 픽셀 3개씩을 건너뜁니다. 파라미터는 여전히 9개지만, 수용 영역은 9x9가 됩니다.
3. 인페인팅에서 이 두 가지가 반드시 필요한 이유
이미지 인페인팅(Inpainting)은 화면에 거대한 구멍(Mask)이 뚫려 있는 상태에서 픽셀을 복원하는 작업입니다. 만약 네트워크의 수용 영역이 이 구멍 크기보다 작다면 어떻게 될까요? 모델은 구멍 주변에 정상적인 픽셀이 어떤 패턴으로 존재하는지 전혀 볼 수 없는 '장님 상태'가 됩니다.
이 문제를 해결하기 위해 각 모델 구조는 다음과 같은 접근을 취합니다.
- 일반 CNN (ResNet 등): 수용 영역이 화면 전체를 덮으려면 3x3 레이어를 100층, 200층씩 매우 깊게 쌓아야 합니다. 당연히 파라미터가 무거워지고 연산량이 폭증합니다.
- Dilated Conv (실용적 타협안): 레이어를 쌓을 때 Dilation 비율을 1, 2, 4, 8, 16으로 기하급수적으로 늘려갑니다. 불과 몇 층만 거쳐도 수용 영역이 화면 전체로 팽창하므로, 파라미터를 늘리지 않고도 전역 맥락을 빠르게 파악할 수 있습니다.
- FFC (끝판왕): 층을 깊게 쌓을 필요조차 없습니다. 단 1개의 변환 블록만 거쳐도 수용 영역이 무조건 이미지 전체의 100%가 됩니다.
요약하자면, 모델이 지워진 영역을 자연스럽게 채워 넣기 위해서는 반드시 '숲(전체 이미지)'을 볼 수 있어야 합니다. 푸리에 변환은 수학적 합산을 통해 단숨에 숲을 보여주고, 팽창 합성곱은 파라미터의 희생 없이 시야를 빠르게 넓혀 숲을 보게 해주는 핵심 기술입니다.