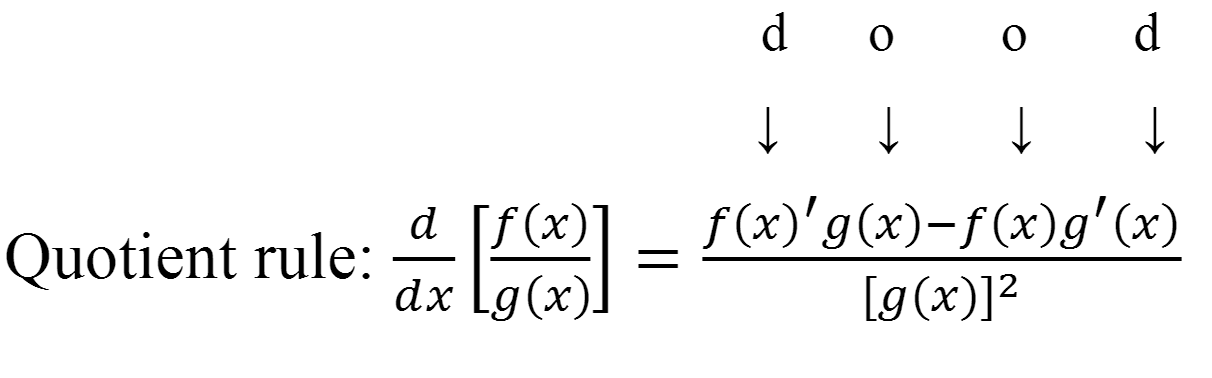Cross-Entropy와 Softmax의 미분

김회정·2023년 7월 2일

머신러닝

목록 보기
1/7

1. 개요

다중 분류를 위한 인공신경망을 빌드할 때 보통 마지막 레이어의 출력값에 Softmax를 직용시키고 실제 레이블값과 비교하여 Cross-Entropy Loss를 계산한다. Softmax를 통해 마지막 레이어의 출력값을 확률값으로 변환할 수 있고 Cross-Entropy를 통해 실제 분포와 확률값이 얼마나 차이나는지 측정할 수 있기 때문이다.
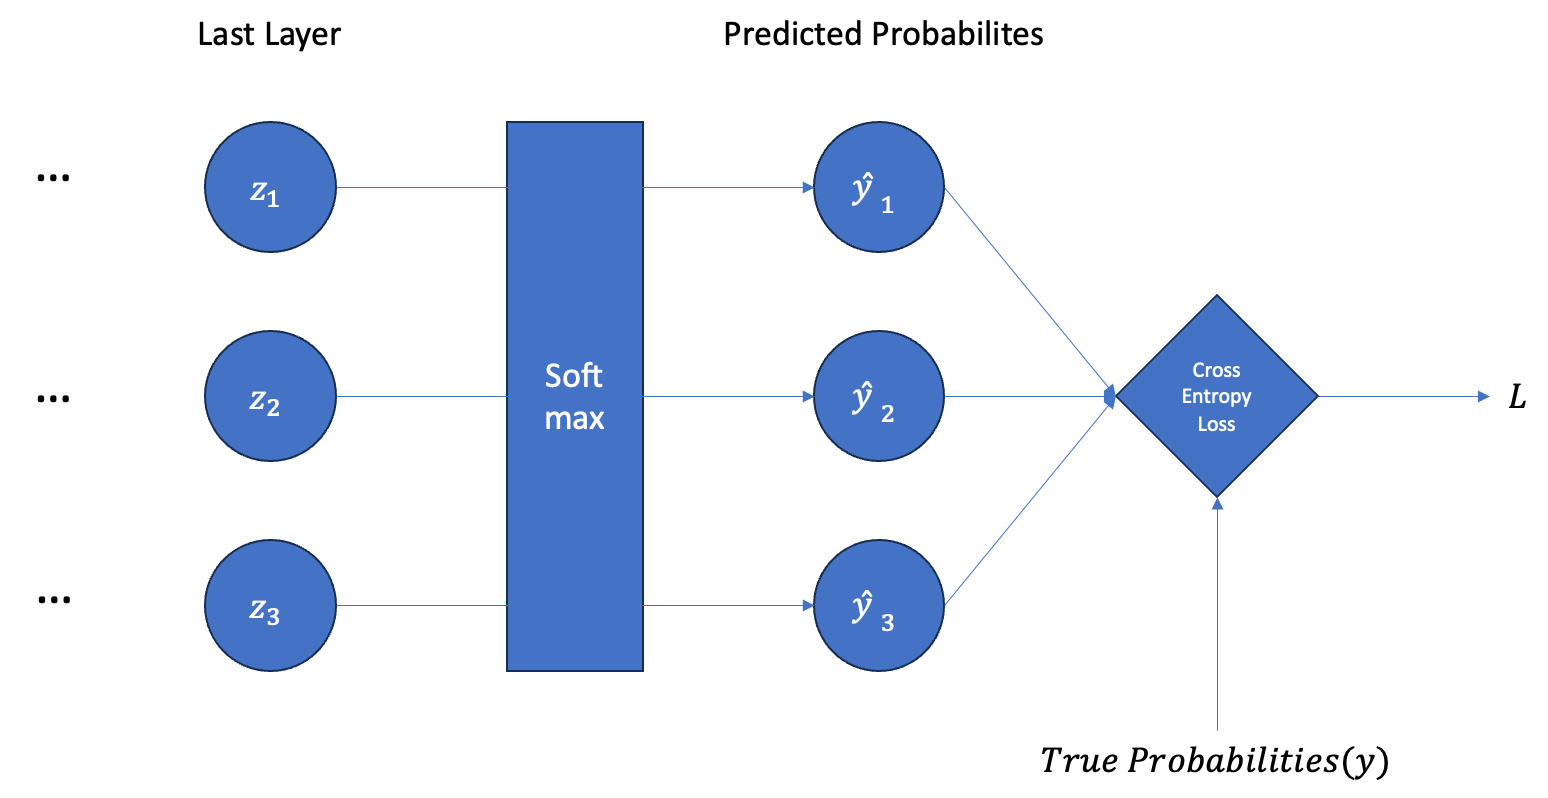
따라서 Softmax와 Cross-Entropy를 세트로 묶어서 보기도 한다. Softmax를 적용하고 Cross-Entropy를 통해 손실값의 신경망의 마지막 출력값 ziz_i에 대한 미분값은 다음과 같이 표현된다. 이러한 공식이 어떻게 도출되었는지 차례대로 확인해보자.

∂L∂z=𝑦^−y{∂L \over ∂z}=𝑦̂-y

2. Softmax의 미분

Softmax의 수식은 다음과 같다. ii번째 클래스에 대한 확률의 예측값은 다음과 같이 계산된다.

𝑦^i=ezi∑j=1cezj𝑦̂_i={e^{z_i} \over \sum\limits_{j=1}^ce^{z_j}}

이를 ziz_i에 대해서 미분해보자. 몫 규칙(quotient rule)에 의해 우선 다음과 같이 미분할 수 있다. exe^x를 xx에 대해 미분하면 그대로 exe^x인 것도 참고하자.

∂𝑦^i∂zi=ezi∗∑j=1cezj−(ezi)2(∑j=1cezj)2{∂𝑦̂_i \over ∂z_i}={e^{z_i}*{\sum\limits_{j=1}^ce^{z_j}}\\ - (e^{z_i})^2 \over (\sum\limits_{j=1}^ce^{z_j})^2}

위의 식은 아래와 같이 전개할 수 있다.

∂𝑦^i∂zi=ezi∑j=1cezj∗∑j=1cezj−ezi∑j=1cezj{∂𝑦̂_i \over ∂z_i}={e^{z_i} \over \sum\limits_{j=1}^ce^{z_j}}*{\sum\limits_{j=1}^ce^{z_j}\\-e^{z_i} \over \sum\limits_{j=1}^ce^{z_j}}

𝑦^i=ezi∑j=1nezj𝑦̂_i={e^{z_i} \over \sum\limits_{j=1}^ne^{z_j}} 이므로 이는 결국 다음과 동일하다.

∂𝑦^i∂zi=𝑦^i∗(1−𝑦^i){∂𝑦̂_i \over ∂z_i}=𝑦̂_{i}*(1-𝑦̂_{i})

하지만 𝑦^𝑦̂의 인덱스와 zz의 인덱스(ii)가 서로 다르다면 미분값은 달라진다. ziz_{i} 값은 znz_{n}에 의존하지 않으므로 다음과 같이 미분된다.

∂𝑦^i∂zn=0∗∑j=1cezj−ezi∗ezn(∑j=1cezj)2{∂𝑦̂_i \over ∂z_n}={0*{\sum\limits_{j=1}^ce^{z_j}}\\ - e^{z_i}*e^{z_n} \over (\sum\limits_{j=1}^ce^{z_j})^2}
∂𝑦^i∂zn=−ezi∗ezn(∑j=1cezj)2{∂𝑦̂_i \over ∂z_n}=-{e^{z_i}*e^{z_n} \over (\sum\limits_{j=1}^ce^{z_j})^2}
∂𝑦^i∂zn=−ezi∑j=1cezj∗ezn∑j=1cezj{∂𝑦̂_i \over ∂z_n}=-{e^{z_i} \over \sum\limits_{j=1}^ce^{z_j}}*{e^{z_n} \over \sum\limits_{j=1}^ce^{z_j}}
∂𝑦^i∂zn=−𝑦^i∗𝑦^n{∂𝑦̂_i \over ∂z_n}=-𝑦̂_i*𝑦̂_n

따라서 다음과 같이 정리할 수 있다.

∂𝑦^i∂zn={𝑦^i∗(1−𝑦^i)(i=n)−𝑦^i∗𝑦^n(i≠n){∂𝑦̂_i \over ∂z_n}=\begin{cases} 𝑦̂_{i}*(1-𝑦̂_{i}) \quad(i=n) \\ -𝑦̂_{i}*𝑦̂_{n} \quad(i \not=n) \end{cases}

3. Cross-Entropy의 미분

Cross-Entropy Loss의 수식은 다음과 같다.

L=−∑i=1cyi∗log(𝑦^i)L=-\sum\limits_{i=1}^cy_{i}*log(𝑦̂_{i})

이를 차례대로 znz_{n}에 대해 미분해보자. yiy_{i}는 상수이고 ∑\sum는 znz_{n}에 의존하지 않으므로 무시할 수 있다.

∂L∂zn=−∑i=1cyi∗∂log(𝑦^i)∂zn{∂L \over ∂z_n}=-\sum\limits_{i=1}^cy_{i}*{∂log(𝑦̂_{i}) \over ∂z_{n}}

연쇄 법칙에 의해 다음과 같이 전개할 수 있다.

∂L∂zn=−∑i=1cyi∗∂log(𝑦^i)∂𝑦^i∗∂𝑦^i∂zn{∂L \over ∂z_n}=-\sum\limits_{i=1}^cy_{i}*{∂log(𝑦̂_{i}) \over ∂𝑦̂_{i}}*{∂𝑦̂_{i} \over ∂z_{n}}

log(x)log(x)의 미분은 1x{1 \over x}와 같다.

∂L∂zn=−∑i=1cyi∗1𝑦^i∗∂𝑦^i∂zn=−∑i=1cyi𝑦^i∗∂𝑦^i∂zn{∂L \over ∂z_n}=-\sum\limits_{i=1}^cy_{i}*{1 \over 𝑦̂_{i}}*{∂𝑦̂_{i} \over ∂z_{n}}=-\sum\limits_{i=1}^c{y_{i} \over 𝑦̂_{i}}*{∂𝑦̂_{i} \over ∂z_{n}}

∂𝑦^i∂zn{∂𝑦̂_{i} \over ∂z_{n}}은 Softmax의 미분과 동일하다. 따라서 i=n{i=n}인 경우와 i≠n{i\not=n}인 경우로 나누어서 생각할 수 있다.

∂L∂zn=−yn𝑦^n∗𝑦^n∗(1−𝑦^n)+∑i≠ncyi𝑦^i∗𝑦^i∗𝑦^n{∂L \over ∂z_n}=-{y_{n} \over 𝑦̂_{n}}*𝑦̂_{n}*(1-𝑦̂_{n})+\sum\limits_{i\not=n}^c{y_{i} \over 𝑦̂_{i}}*𝑦̂_{i}*𝑦̂_{n}

식을 정리하면 다음과 같다.

∂L∂zn=−yn+yn∗𝑦^n+∑i≠ncyi∗𝑦^n{∂L \over ∂z_n}=-y_{n}+y_{n}*𝑦̂_{n}+\sum\limits_{i\not=n}^cy_{i}*𝑦̂_{n}
∂L∂zn=−yn+∑i=1cyi∗𝑦^n{∂L \over ∂z_n}=-y_{n}+\sum\limits_{i=1}^cy_{i}*𝑦̂_{n}

yy는 원-핫 인코딩 벡터이므로 yiy_{i} 중 하나만 1의 값을 가진다. 따라서 다음과 같이 정리된다.

∂L∂zn=−yn+𝑦^n=𝑦^n−yn{∂L \over ∂z_n}=-y_{n}+𝑦̂_{n}=𝑦̂_{n}-y_{n}

따라서 ∂L∂z{∂L \over ∂z}이 𝑦^−y𝑦̂-y임을 증명할 수 있다.

profile
안녕하세요

0개의 댓글