[논문리뷰] You Only Look Once: Unified, Real-Time Object Detection(2016, YOLOv1)
YOLOv1 용어 정리
주요 용어 및 설명
-
비최대 억제 (Non-Maximal Suppression)
- 중복된 경계 상자 중 신뢰도 점수가 가장 높은 하나만 남기고 나머지는 제거.
- 목적: 동일 물체를 여러 번 감지하지 않도록 함.
<비최대 억제 동작 방식>
신뢰도 점수 기준 정렬
모델이 예측한 모든 경계 상자를 신뢰도 점수(confidence score)를 기준으로 내림차순 정렬한다.
가장 높은 점수 선택
가장 신뢰도가 높은 상자를 선택하고 이를 최종 결과에 포함한다.
IOU 계산
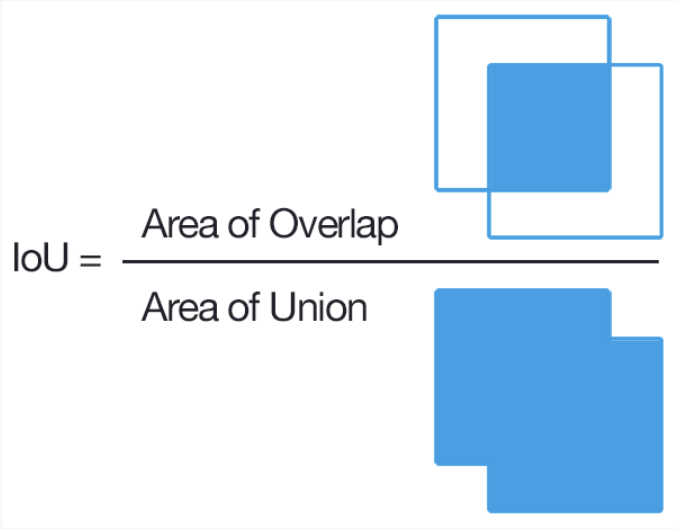
선택된 상자와 나머지 상자 간의 교차비율(Intersection Over Union, IOU)을 계산한다.
임계값 초과 상자 제거
IOU가 설정된 임계값(예: 0.5)을 초과하는 상자는 중복된 것으로 간주하여 제거한다.
과정 반복
남은 상자 중에서 신뢰도 점수가 높은 순서대로 반복적으로 처리한다.
-
전역 판단 (Global Reasoning)
- 이미지 전체를 한 번에 보고 맥락(Context)을 이해하며 물체를 감지하는 방식.
- 장점: 배경에서 물체를 잘못 감지하는 오류를 줄임. YOLO가 예술 작품과 같은 일반적이지 않은 데이터에서도 물체를 탐지하는 능력을 보이는 이유는, 이미지 전체를 맥락적으로 판단하여 각 물체를 인식하기 때문. (Figure6에서 피카소 그림으로 추론해봄)
- 배경 오류를 줄임 (Fast R-CNN과 비교해 배경에서 잘못 감지된 비율이 낮음).
- 물체와 배경 간의 구분을 더 잘 수행.
- 새로운 도메인(예: Picasso 데이터셋)에서도 높은 일반화 능력을 발휘.
-
경계 상자 (Bounding Box)
- 이미지에서 물체의 위치를 정의하는 사각형.
- 정보: x, y 좌표(위치), 폭(width), 높이(height).
-
그리드 셀 (Grid Cell)
- 입력 이미지를 S×S 크기로 나눈 구역.
- 각 셀이 담당 물체의 위치, 크기, 클래스 예측.
-
평균 정밀도 (Mean Average Precision, mAP)
- 탐지 모델의 성능을 평가하는 지표.
- 여러 클래스에 대해 정밀도(Precision)를 평균내어 계산.
-
회귀 문제 (Regression Problem)
- YOLO가 물체 감지를 분류 문제가 아닌 좌표값(x, y, 폭, 높이)을 예측하는 회귀 문제로 정의.
- 장점: 단순하고 빠른 예측.
-
슬라이딩 윈도우 (Sliding Window)
- 기존 방법에서 분류기를 이미지 전체에서 이동시키며 탐지.
- 단점: 연산 비용이 매우 큼.
-
영역 제안 (Region Proposal)
- 이미지에서 물체가 있을 가능성이 높은 후보 영역을 생성.
- 예시: R-CNN의 Selective Search.
-
교차비율 (Intersection Over Union, IOU)
- 예측 경계 상자와 실제 경계 상자가 겹치는 비율.
- 목적: 경계 상자 예측의 정확도 평가.
-
End-to-End 학습
- 입력부터 최종 출력까지 하나의 네트워크로 학습.
- 중간 단계를 제거해 단순화 및 최적화 가능.
-
손실 함수 (Loss Function)
- 모델 예측과 실제 값 간의 차이를 계산하는 함수.
- YOLO에서는 위치, 크기, 클래스 예측 오차를 평가.
YOLOv1 논문 리뷰
도표와 그림
Figure1
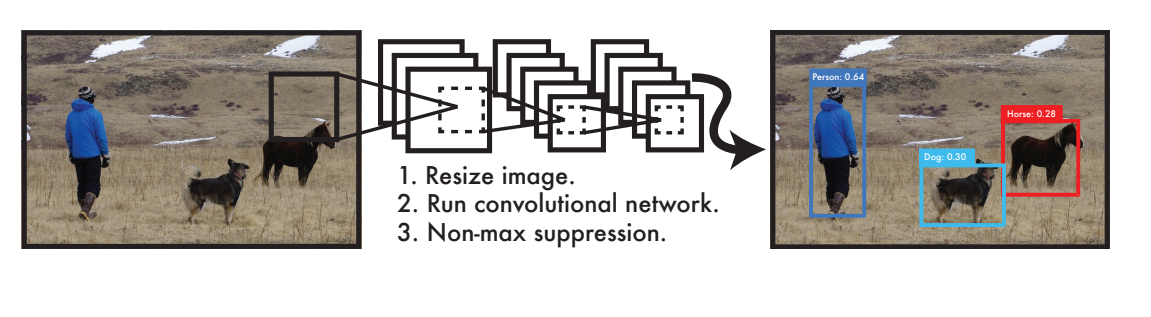
YOLO 탐지 시스템은 이미지를 처리하는 단순하고 직관적인 방법을 제공한다. 1. 먼저 입력 이미지를 고정된 크기인 448×448로 조정한다. 2. 단일 합성곱 신경망을 통해 이미지를 처리하여 물체의 위치를 나타내는 경계 상자와 클래스(예: 사람, 개, 말 등)를 예측한다. 3. 비최대 억제(non-maximal suppression)를 적용하여 중복된 경계 상자를 제거하고, 모델의 신뢰도 점수를 기준으로 최종 결과를 도출한다. 4. 최종적으로 감지된 물체에 대해 경계 상자, 클래스 이름, 그리고 신뢰도 점수를 포함한 결과를 출력한다. 예를 들어, "Person: 0.64", "Dog: 0.30", "Horse: 0.28"과 같은 형태로 표시된다.
Figure2
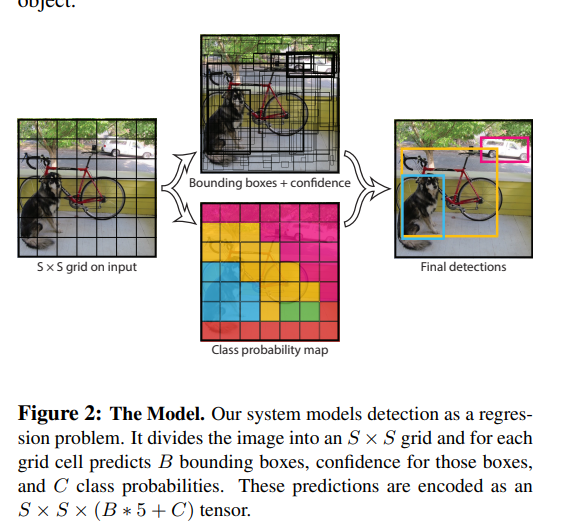
우리 시스템은 물체 감지를 회귀 문제로 모델링한다.
이미지를 그리드로 나누며, 각 그리드 셀은 개의 경계 상자(bounding boxes), 해당 상자들의 신뢰도(confidence), 그리고 개의 클래스 확률(class probabilities)을 예측한다.
이러한 예측 값들은 다음과 같은 텐서로 인코딩된다:
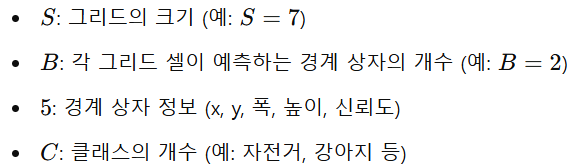
Figure3
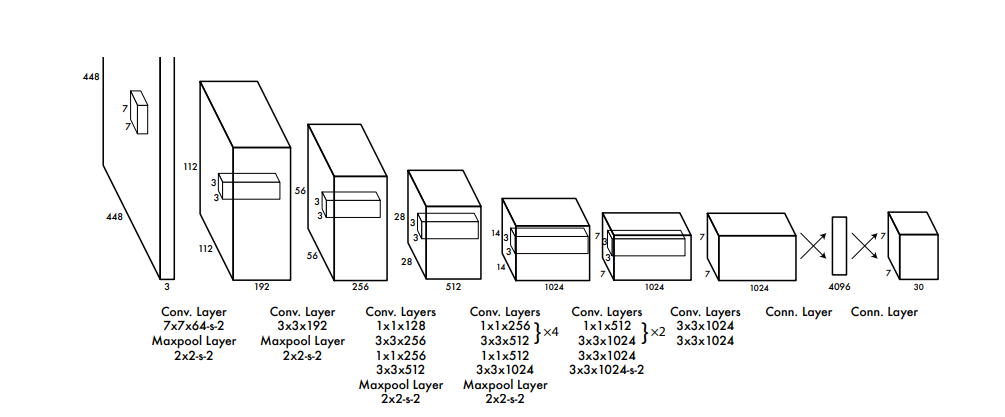
우리의 탐지 네트워크는 24개의 합성곱 계층(convolutional layers)과 그 뒤를 잇는 2개의 완전 연결 계층(fully connected layers)로 구성된다.
-
1×1 합성곱 계층:
- 교대로 배치된 1×1 합성곱 계층은 이전 계층의 특징 공간(feature space)을 축소한다.
- 특징 공간을 축소하면서도 중요한 정보를 유지한다.
-
사전 학습 (Pretraining):
- 합성곱 계층은 ImageNet 분류 작업에서 224×224 크기 입력 이미지로 사전 학습되었다.
- 탐지 작업을 위해 입력 해상도를 두 배로 늘린다 (448×448 크기).
-
계층 구성:
- 초기 계층에서 이미지의 공간적 해상도를 줄이고, 깊은 계층에서는 더 복잡한 특징을 추출한다.
- 최종 출력은 7×7×30 형태로 나타나며, 이는 각 그리드 셀이 예측한 경계 상자와 클래스 확률을 포함한다.
표 1: PASCAL VOC 2007에서의 실시간 시스템
Real-Time Detectors의 성능과 속도를 비교한 내용이다. Fast YOLO는 PASCAL VOC 탐지 기록에서 가장 빠른 탐지기로, 여전히 다른 모든 실시간 탐지기보다 두 배 더 정확하다. YOLO는 Fast YOLO보다 mAP가 10 더 높으면서도 여전히 실시간 속도를 훨씬 초과한다.
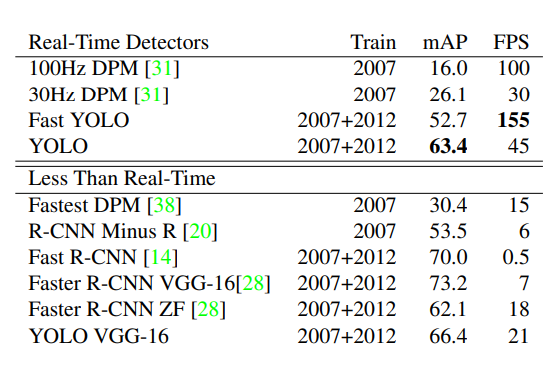
Figure4
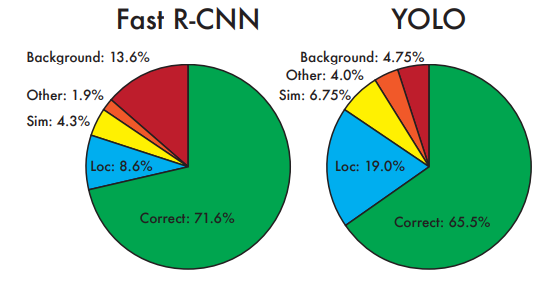
Figure 4: 오류 분석: Fast R-CNN vs. YOLO
이 차트는 다양한 카테고리에서 상위 N개의 탐지 결과(N = 해당 카테고리의 객체 수)에 대해 위치 오류(localization error)와 배경 오류(background error)의 비율을 나타낸다.
- Other: 클래스가 잘못되었고, IOU > 0.1인 경우.
- Background: IOU < 0.1인 모든 객체.
(배경 오류는 IOU < 0.1인 경계 상자가 감지된 경우, 즉 배경을 물체로 잘못 탐지)
Table2
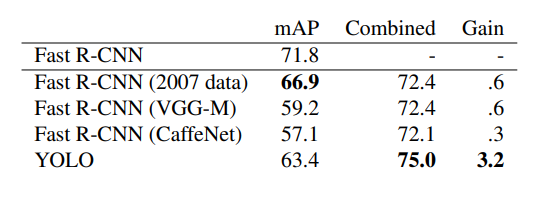
VOC 2007에서의 모델 결합 실험
Fast R-CNN의 최적 버전과 다양한 모델을 결합했을 때의 효과를 분석했다. Fast R-CNN의 다른 버전은 작은 성능 향상만을 제공하는 반면, YOLO는 상당한 성능 향상을 보여준다.
Table3
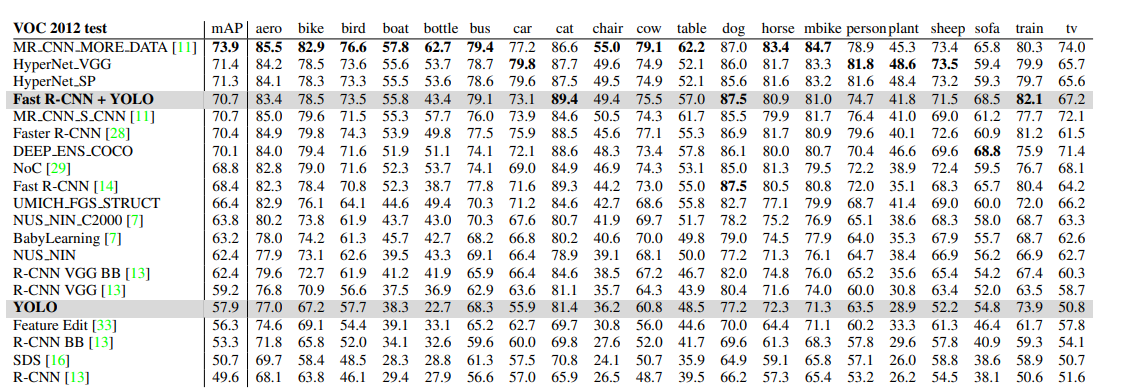
Table 3: PASCAL VOC 2012 리더보드
YOLO는 2015년 11월 6일 기준으로 comp4 (외부 데이터 사용 허용) 공개 순위표에서 평가되었다. 표에는 다양한 탐지 방법에 대한 평균 정밀도(mean average precision, mAP)와 클래스별 평균 정밀도가 나와 있다. YOLO는 유일한 실시간 탐지기로, Fast R-CNN에 비해 2.3% 성능 향상을 보여주는 네 번째로 높은 점수의 방법이다.
Figure5
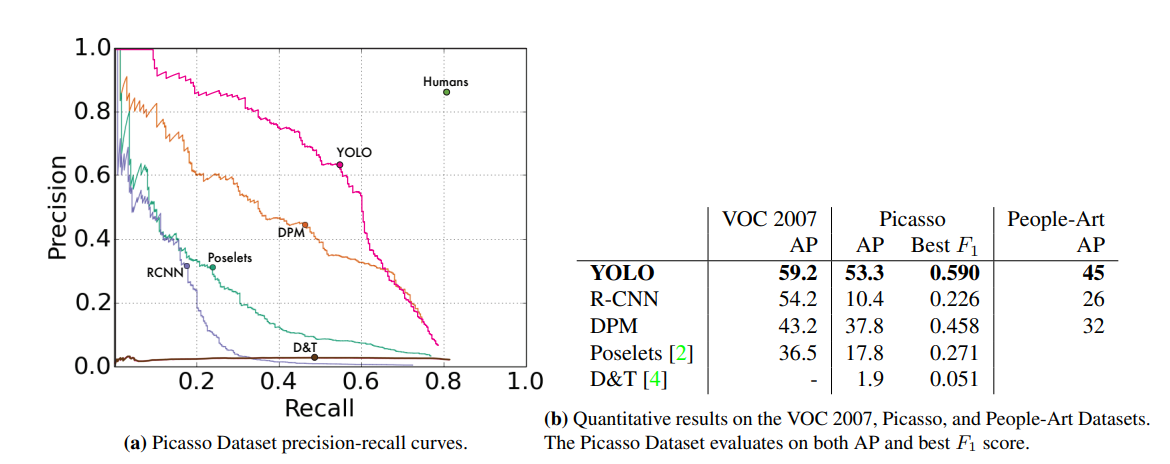
Figure 5: Picasso and People-Art 데이터셋에서의 일반화 결과
(a) Picasso 데이터셋의 정밀도-재현율(precision-recall) 곡선.
YOLO는 RCNN, DPM, Poselets와 비교하여 높은 정밀도와 재현율을 유지하며, 특히 Humans 클래스에서 우수한 성능을 보인다.
(b) VOC 2007, Picasso, People-Art 데이터셋에 대한 정량적 결과.
- YOLO는 VOC 2007에서 59.2 AP를 기록하며, Picasso와 People-Art 데이터셋에서도 각각 53.3 AP, 45 AP로 가장 높은 성능을 보인다.
- Picasso 데이터셋에서는 YOLO가 최고 Score(0.590)를 달성한다.
- 다른 모델인 RCNN, DPM, Poselets와 비교했을 때, YOLO는 예술적인 데이터셋에서도 뛰어난 일반화 능력을 보여준다.
Figure
정성적 결과 (Qualitative Results)
인터넷에서 수집한 예술 작품과 자연 이미지를 대상으로 수행한 결과를 보여준다. 대부분 정확한 결과를 보여주지만, 한 인물을 비행기로 잘못 인식하는 경우도 포함되어 있다.
Abstract
- YOLO는 기존 물체 감지 방식을 회귀 문제(regression problem)로 재구성한 접근법.
- 하나의 신경망으로 경계 상자(bounding box)와 클래스 확률(class probabilities)을 동시에 예측.
- End-to-End 최적화를 통해 기존의 복잡한 파이프라인을 단순화.
- 속도:
- 기본 YOLO: 초당 45프레임.
- Fast YOLO: 초당 155프레임.
- 강점:
- 배경에서의 잘못된 긍정 예측(false positives) 감소.
- 새로운 도메인에서도 뛰어난 일반화 성능(generalization).
1. Introduction
- 사람의 시각 시스템은 빠르고 정확하며, 복잡한 물체 간 상호작용도 인지 가능.
- YOLO의 등장 배경:
- 기존 방법(DPM, R-CNN): 느리고 복잡한 파이프라인(슬라이딩 윈도우, 영역 제안) 사용.
- YOLO의 혁신:
- 단일 합성곱 신경망을 사용해 물체를 감지.
- 입력 이미지를 그리드로 나누어 각 그리드 셀(grid cell)에서 물체 존재 여부와 위치, 클래스를 예측.
- End-to-End 학습으로 탐지 성능 최적화.
YOLO의 주요 특징
-
빠른 속도:
- Titan X GPU 기준, 기본 YOLO는 초당 45프레임, Fast YOLO는 초당 150프레임 이상.
- 스트리밍 비디오를 실시간(지연 25ms 미만)으로 처리 가능.
-
전역 판단(Global reasoning):
- YOLO는 이미지 전체를 보고 맥락(Context)을 반영하여 물체 감지.
- Fast R-CNN보다 배경 감지 오류가 절반 이하.
-
뛰어난 일반화 성능:
- 자연 이미지로 학습 후 예술 작품 같은 새로운 도메인에서도 높은 성능.
2.3. Inference
- 테스트 시 단일 네트워크 평가(single network evaluation)만으로 결과를 예측.
- PASCAL VOC 데이터셋 기준:
- 이미지당 약 98개의 경계 상자와 각 상자에 대한 클래스 확률을 예측.
- 비최대 억제(non-maximal suppression):
- 중복 감지를 제거해 평균 정밀도(mean Average Precision, mAP)를 약 2~3% 향상.
2.4. Limitations of YOLO
-
공간적 제약(Spatial Constraints):
- 각 그리드 셀은 두 개의 경계 상자와 하나의 클래스만 예측.
- 가까운 물체나 작은 물체 그룹(예: 새 떼) 감지에 어려움.
-
비정상적인 형태의 물체:
- 새로운 종횡비(aspect ratio)나 독특한 형태의 물체에 대해 일반화가 어렵다.
-
손실 함수의 한계:
- 작은 경계 상자에서의 오류가 큰 영향을 미침.
- 주요 오류는 잘못된 위치(localization errors)에서 발생.
3. Comparison to Other Detection Systems
Deformable Parts Model (DPM):
- 슬라이딩 윈도우 기반으로 정적 특징을 추출해 물체 감지.
- YOLO는 DPM의 복잡한 파이프라인 대신 단일 신경망으로 모든 작업 수행.
- 결과: 더 빠르고 정확한 모델.
R-CNN:
- 영역 제안(region proposal)을 사용하여 물체 감지.
- 복잡한 다단계 파이프라인(Selective Search → 특징 추출 → SVM 분류 → 비최대 억제).
- 테스트 시간: 이미지 한 장당 40초 이상.
- YOLO:
- Selective Search 대신 98개의 경계 상자만 생성.
- 단일 모델로 모든 작업을 공동 최적화하여 효율성 향상.
6. Conclusion
- YOLO는 통합 모델(unified model)로, 단순하고 효율적.
- End-to-End 학습을 통해 탐지 성능 최적화.
- Fast YOLO는 문헌상 가장 빠른 범용 물체 감지기(general-purpose object detector).
- 뛰어난 속도와 일반화 성능으로 다양한 응용 분야에 적합.
참고: 훈련 과정
- 데이터셋:
- ImageNet(사전 학습)과 PASCAL VOC 2007/2012(탐지 학습).
- 주요 설정:
- 입력 이미지 크기: 448×448.
- 배치 크기: 64, 모멘텀: 0.9, 학습률 스케줄링.
- 데이터 증강: HSV 변환, 크기 조정, 이동.
- 최적화:
- 손실 함수에서 경계 상자와 물체 없는 셀의 손실 가중치를 조정(λcoord=5, λnoobj=0.5). YOLO의 마지막 문장은 손실 함수에서 특정 항목의 중요도를 조정한다는 뜻이다.
손실 함수는 모델이 예측한 결과를 실제 정답과 비교해서 얼마나 잘 맞았는지 평가한다. 여기서 특정 항목들이 더 중요한 경우, 그 항목에 더 큰 비중(가중치)을 둔다.
- 손실 함수에서 경계 상자와 물체 없는 셀의 손실 가중치를 조정(λcoord=5, λnoobj=0.5). YOLO의 마지막 문장은 손실 함수에서 특정 항목의 중요도를 조정한다는 뜻이다.
-
λcoord (λ = 5):
- 경계 상자 위치(x, y, 너비, 높이) 예측의 정확도를 중요하게 여긴다.
- 경계 상자를 잘 맞추는 것이 물체 탐지에서 매우 중요하기 때문에, 이 손실에 더 큰 비중을 둔다.
-
λnoobj (λ = 0.5):
- 물체가 없는 그리드 셀에서의 손실에 낮은 비중을 둔다.
- 이미지의 대부분은 물체가 없는 배경이기 때문에, 물체가 없는 셀에서의 오류가 학습을 방해하지 않도록 중요도를 낮춘다.
- 경계 상자의 위치 예측은 매우 중요한 항목이므로 더 큰 비중(λcoord = 5)을 주어 모델이 이를 더 잘 학습하도록 한다.
- 물체가 없는 셀의 손실은 너무 많을 수 있으므로 낮은 비중(λnoobj = 0.5)을 주어 모델이 "물체 없음"에만 집중하지 않도록 한다.
참고2: 평균 정밀도 (Mean Average Precision, mAP)
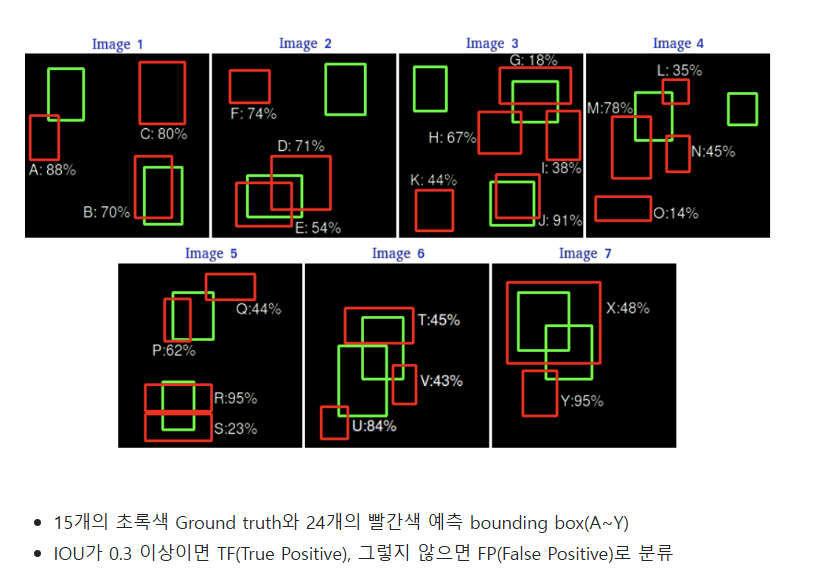
평균 정밀도(mAP)는 객체 탐지 및 분류 모델의 성능을 평가하기 위한 지표로, 정밀도(Precision)와 재현율(Recall)의 관계를 기반으로 계산된다.
Precision: 모델이 True라고 분류한 것 중 실제 True인 것의 비율
Recall: 실제 True인 것 중 모델이 True라고 예측한 것의 비율
1. 정밀도와 재현율
-
정밀도 (Precision)는 다음과 같이 계산된다.
-
재현율 (Recall)은 다음과 같이 계산된다.
2. 평균 정밀도 (mAP) 계산 과정
-
정밀도-재현율 곡선 생성
특정 클래스에 대해 재현율(Recall)을 x축, 정밀도(Precision)을 y축으로 설정하여 곡선을 생성한다. 각 임계값에서 정밀도와 재현율을 계산한다. -
AP (Average Precision) 계산
특정 클래스에 대해 정밀도-재현율 곡선 아래 면적(Area Under Curve, AUC)을 계산한다.
불연속적인 점에서 측정되므로 다음 식을 사용한다:- : n번째 점에서의 정밀도
- : n번째 점에서의 재현율
-
mAP (Mean Average Precision) 계산
모든 클래스에 대해 AP를 평균내어 계산한다:- : 클래스의 총 개수
- : 클래스 의 평균 정밀도
3. 요약
- mAP는 클래스별 정밀도-재현율 곡선의 평균 면적으로 계산된다.
- 모든 클래스의 AP를 평균내어 모델의 전반적인 성능을 평가한다.
- mAP 값이 높을수록 모델의 객체 탐지 성능이 우수하다는 것을 의미한다.
