YOLOv3 논문 번역
Abstract
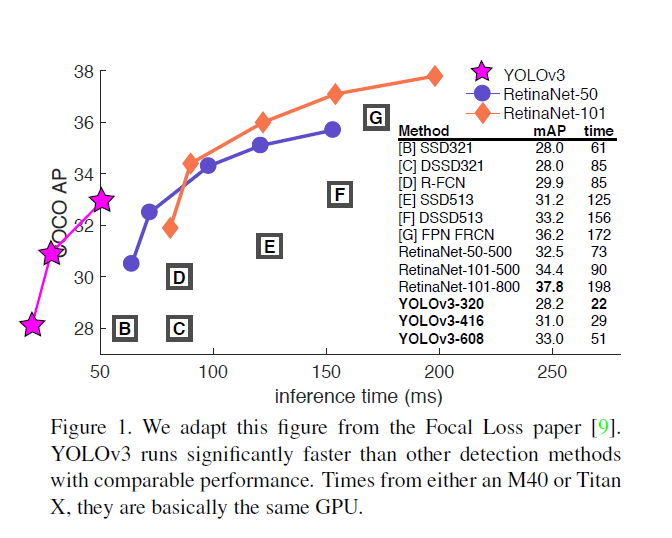
우리는 YOLO에 몇 가지 업데이트를 적용했습니다! 여러 작은 디자인 변경을 통해 더 나아지게 만들었고, 새로운 네트워크를 훈련했으며 이 네트워크는 꽤 훌륭합니다. 이전보다 약간 더 크지만 더 정확합니다. 하지만 여전히 빠르니 걱정하지 마세요. 크기에서 YOLOv3는 22ms에 28.2 mAP를 기록하며, SSD와 비슷한 정확도를 제공하지만 세 배 더 빠릅니다. 이전 IOU mAP 검출 지표를 기준으로 보면 YOLOv3는 꽤 우수합니다. Titan X에서 에 를 달성한 반면 RetinaNet은 에 를 기록하여 성능은 비슷하지만 YOLOv3가 배 더 빠릅니다. 모든 코드는 https://pjreddie.com/yolo/에 공개되어 있습니다.
1. Introduction
때로는 1년 동안 대충 넘어가는 경우도 있죠. 솔직히 올해는 많은 연구를 하지 않았습니다. 트위터에서 시간을 많이 보냈고, GAN으로 이것저것 실험도 좀 해봤습니다. 작년에 했던 일에서 남은 약간의 추진력을 사용해 YOLO를 개선할 수 있었습니다. 하지만 솔직히 말해 대단히 흥미로운 건 아니고, YOLO를 약간 더 나아지게 만드는 작은 변경 사항들뿐이었습니다. 또한 다른 사람들의 연구를 조금 도왔습니다.
사실, 우리가 여기 온 이유도 그것입니다. 카메라 준비 마감일이 다가왔고 YOLO에 제가 추가한 여러 업데이트를 인용해야 하지만 출처가 없었습니다. 그래서 TECH REPORT를 작성하게 되었습니다!
기술 보고서의 좋은 점은 도입부가 길 필요가 없다는 겁니다. 여러분도 우리가 왜 여기에 있는지 이미 아실 테니까요. 그래서 도입부의 마지막 부분에서 나머지 논문의 내용을 간략히 안내하겠습니다. 먼저 YOLOv3의 현황을 설명하고, 어떻게 구현했는지 알려드리겠습니다. 시도했으나 실패한 것들에 대해서도 이야기하겠습니다. 마지막으로, 이 모든 것이 무엇을 의미하는지 고찰해보겠습니다.
2. The Deal (YOLOv3의 현황)
YOLOv3의 핵심은 우리가 다른 사람들의 좋은 아이디어를 많이 차용했다는 것입니다. 또한 기존의 네트워크보다 더 나은 새로운 분류기 네트워크를 훈련했습니다. 시스템 전체를 처음부터 설명하며 이해를 돕겠습니다. 그림 1을 참조하세요. 이 그림은 Focal Loss 논문에서 가져왔습니다 [9].
YOLOv3는 유사한 성능을 제공하면서도 다른 검출 방법보다 훨씬 빠릅니다. 실행 시간은 M40이나 Titan X와 같은 GPU에서 측정되었으며, 두 GPU는 성능이 거의 동일합니다.
2.1 Bounding Box Prediction (경계 상자 예측)
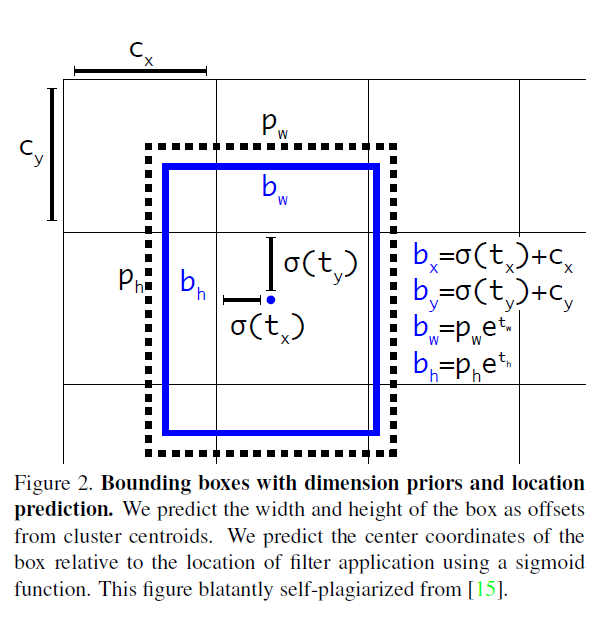
YOLO9000과 마찬가지로 우리의 시스템은 앵커 박스(anchor box)로서 차원 클러스터를 사용하여 경계 상자를 예측합니다 [15]. 네트워크는 각 경계 상자에 대해 라는 4개의 좌표를 예측합니다. 이미지의 왼쪽 상단 모서리로부터 셀(cell)의 오프셋이 이고, 경계 상자 사전(prior)의 폭과 높이가 일 때, 예측은 다음과 같습니다:
훈련 시에는 제곱 오차 합 손실(squared error loss)을 사용합니다. 특정 좌표 예측의 실제값이 라면, 기울기(gradient)는 다음과 같습니다:
이 실제값은 위 식을 역으로 계산하여 쉽게 구할 수 있습니다.
YOLOv3는 각 경계 상자에 대해 객체 존재 점수(objectness score)를 로지스틱 회귀를 사용해 예측합니다. 만약 경계 상자 사전이 다른 어떤 경계 상자 사전보다 특정 객체와 더 많이 겹치면 점수는 1이 됩니다. 그렇지 않은 경우, 예측은 무시됩니다.
2.2 Class Prediction (클래스 예측)
각 상자는 다중 레이블 분류(multilabel classification)를 사용해 경계 상자에 포함될 수 있는 클래스를 예측합니다. 우리는 softmax를 사용하지 않습니다. 대신 독립적인 로지스틱 회귀 분류기를 사용하며, 이는 성능에 충분했습니다. 훈련 시 클래스 예측에는 이진 교차 엔트로피 손실(binary cross-entropy loss)을 사용합니다.
이 접근 방식은 Open Images Dataset [7]과 같은 더 복잡한 도메인에 적합합니다. 이 데이터셋은 Woman과 Person처럼 많은 중복 레이블이 존재합니다. softmax는 각 상자에 정확히 하나의 클래스만 있을 것이라는 가정을 하므로 부적합합니다. 다중 레이블 접근법은 데이터를 더 잘 모델링합니다.
2.3 Predictions Across Scales (다중 스케일 예측)
YOLOv3는 세 가지 다른 스케일에서 경계 상자를 예측합니다. 시스템은 Feature Pyramid Networks(FPN) [8]와 유사한 개념으로 이 스케일에서 피처를 추출합니다. 기본 피처 추출기에서 여러 합성곱 층을 추가하며, 마지막 층은 경계 상자, 객체 존재 여부, 클래스 예측을 포함하는 3차원 텐서를 생성합니다.
COCO 데이터셋 [10]을 기준으로 각 스케일에서 세 개의 상자를 예측하므로 텐서 크기는 다음과 같습니다:
여기서 4는 경계 상자 좌표, 1은 객체 점수, 80은 COCO 클래스 수를 의미합니다.
다음으로, 네트워크에서 이전 두 층의 피처 맵을 가져와 크기를 배로 업샘플링합니다. 이후 네트워크에서 더 초기에 추출된 피처 맵과 결합(concatenate)하여 업샘플링된 피처에서 더 의미 있는 의미론적 정보를 얻고, 초기 피처 맵에서 더 세부적인 정보를 확보합니다. 그 후 이 결합된 피처 맵을 처리하기 위해 몇 개의 합성곱 레이어를 추가로 사용하여 유사한 텐서를 예측하지만 이번에는 크기가 두 배로 증가합니다.
이 설계를 한 번 더 반복하여 최종 스케일에서 예측을 수행합니다. 이렇게 하면 3번째 스케일의 예측이 이전 계산의 모든 이점뿐 아니라 네트워크 초반의 세부 피처의 이점도 활용할 수 있습니다.
우리는 여전히 K-means 클러스터링을 사용해 경계 상자 사전을 결정합니다. 9개의 클러스터와 3개의 스케일을 임의로 선택한 후 이를 스케일별로 균등하게 분할했습니다. COCO 데이터셋에서 9개의 클러스터는 다음과 같습니다:
2.4 Feature Extractor (피처 추출기)
우리는 새로운 네트워크를 사용해 피처를 추출합니다. 이 네트워크는 YOLOv2에서 사용한 Darknet-19와 최신의 잔여 네트워크(Residual Network) 방식을 혼합한 하이브리드 접근법입니다. 이 네트워크는 연속적인 및 합성곱 레이어를 사용하며, 몇 가지 단축 연결(shortcut connection)을 포함합니다. 또한 이전보다 훨씬 크며 53개의 합성곱 레이어를 가지고 있습니다. 그래서 이를 Darknet-53이라고 부릅니다.
Darknet-53은 Darknet-19보다 훨씬 강력하며, ResNet-101 또는 ResNet-152보다 효율적입니다. 다음은 ImageNet 결과입니다:
| Backbone | Top-1 | Top-5 | BnOps | BFLOP/s | FPS |
|---|---|---|---|---|---|
| Darknet-19 | 74.1 | 91.8 | 7.29 | 1246 | 171 |
| ResNet-101 | 77.1 | 93.7 | 19.7 | 1039 | 53 |
| ResNet-152 | 77.6 | 93.8 | 29.4 | 1090 | 37 |
| Darknet-53 | 77.2 | 93.8 | 18.7 | 1457 | 78 |
모든 네트워크는 동일한 설정으로 훈련되었으며, 단일 크롭 정확도를 기준으로 테스트되었습니다. 실행 시간은 Titan X에서 측정되었습니다. Darknet-53은 최첨단 분류기와 비슷한 성능을 제공하면서도 더 적은 부동소수점 연산을 수행하며 더 빠릅니다. ResNet-101보다 배 빠르고, ResNet-152와 비슷한 성능을 제공하지만 배 빠릅니다.
Darknet-53은 가장 높은 부동소수점 연산 초당(FLOPS)을 기록하며, 이는 네트워크 구조가 GPU를 더 잘 활용하여 더 효율적이고 빠르게 평가할 수 있음을 의미합니다.
2.5 Training (훈련)
우리는 여전히 전체 이미지를 사용해 훈련하며, 하드 네거티브 마이닝(hard negative mining) 같은 기술은 사용하지 않습니다. 대신 다중 스케일 훈련, 다양한 데이터 증강, 배치 정규화 등 표준적인 방법을 모두 활용합니다. 훈련과 테스트에는 Darknet 신경망 프레임워크를 사용했습니다 [14].
3. How We Do (성능 평가)
YOLOv3는 꽤 괜찮습니다! 아래 표를 참고하세요. COCO의 특이한 평균 mAP 지표(average mean AP metric) 기준으로는 SSD 변형 모델과 비슷한 수준이지만 3배 더 빠릅니다. 그러나 RetinaNet과 같은 다른 모델에 비해서는 여전히 이 지표에서 많이 뒤처집니다.
하지만 "구식" 탐지 지표인 @ (또는 차트에서 로 표시)를 기준으로 보면 YOLOv3는 매우 강력합니다. RetinaNet과 거의 동등하며 SSD 변형 모델보다 훨씬 높은 점수를 기록합니다. 이는 YOLOv3가 객체에 적합한 경계 상자를 생성하는 데 매우 뛰어난 탐지기임을 나타냅니다. 그러나 IOU 임계값이 증가할수록 성능이 크게 저하되는 것을 확인할 수 있습니다. 이는 YOLOv3가 경계 상자를 객체에 정확히 맞추는 데 어려움을 겪는다는 점을 시사합니다.
과거에 YOLO는 작은 객체 탐지에서 약점을 보였습니다. 하지만 이제 새로운 다중 스케일 예측 덕분에 이 추세가 반전되었습니다. YOLOv3는 비교적 높은 (작은 객체에 대한 성능)를 기록했습니다. 그러나 중간 크기 및 큰 크기의 객체에서는 상대적으로 더 낮은 성능을 보입니다. 이에 대한 추가 조사가 필요합니다.
지표에서 정확도와 속도를 플롯하면 (그림 5 참조) YOLOv3가 다른 탐지 시스템에 비해 상당한 이점을 가지고 있음을 확인할 수 있습니다. 즉, 더 빠르고 더 우수합니다.
4. Things We Tried That Didn’t Work (시도했으나 실패한 것들)
YOLOv3를 개발하면서 여러 가지 시도를 해보았습니다. 그 중 많은 것이 성공하지 못했는데, 기억나는 몇 가지를 정리해 보았습니다.
-
앵커 박스 오프셋 예측:
앵커 박스 예측 메커니즘에서 오프셋을 상자의 너비나 높이의 배수로 예측하도록 했습니다. 선형 활성화(linear activation)를 사용했지만, 이 방식은 모델의 안정성을 감소시키며 성능이 좋지 않았습니다. -
로지스틱 대신 선형 예측:
로지스틱 활성화 대신 선형 활성화를 사용해 오프셋을 직접 예측해 보았습니다. 하지만 이 방식은 점수를 몇 포인트 감소시켰습니다. -
Focal Loss:
Focal Loss를 적용해 보았으나 점수가 약 2포인트 감소했습니다. YOLOv3는 이미 객체 점수(objectness score) 예측과 조건부 클래스 예측을 분리하고 있기 때문에, Focal Loss가 해결하려는 문제에 대해 이미 강력한 내성을 가지고 있는 것으로 보입니다. -
이중 IOU 임계값과 진리 매칭 (Dual IOU thresholds and truth assignment):
Faster R-CNN은 훈련 중에 두 개의 IOU 임계값을 사용합니다. 예측이 진리 상자와 이상 겹치면 긍정 예제로 간주되고, 사이일 경우 무시되며, 미만일 경우 부정 예제로 간주됩니다. 이와 유사한 전략을 시도했지만, 좋은 결과를 얻지 못했습니다.
결론적으로, 현재의 YOLOv3 방식이 적어도 로컬 최적점(local optima)에 도달한 것으로 보입니다. 이러한 기술 중 일부는 나중에 적절히 튜닝해 안정성을 높인다면 좋은 결과를 낼 가능성도 있습니다.
5. What This All Means (결론)
YOLOv3는 좋은 탐지기입니다. 빠르고 정확합니다. COCO의 에서 IOU 평균 mAP 지표에서는 최고는 아니지만, IOU 기준의 구식 탐지 지표에서는 매우 우수합니다.
왜 우리는 탐지 지표를 바꾸었을까요? COCO 논문에는 "평가 서버가 완료되면 평가 메트릭에 대한 전체 논의가 추가될 것"이라는 모호한 문장만 있었습니다. Russakovsky 등의 연구에 따르면, 사람이 IOU와 IOU를 시각적으로 구분하는 데 어려움을 겪는다고 보고했습니다. "IOU가 인 경계 상자와 인 경계 상자를 구별하도록 인간을 훈련시키는 것은 놀라울 정도로 어렵다." [18] 인간이 차이를 구분하기 어렵다면, 얼마나 중요한 차이일까요?
더 나은 질문은 "이 탐지기들로 무엇을 할 것인가?"일 것입니다. 이 연구를 진행하는 사람들 대부분은 Google이나 Facebook에 있습니다. 적어도 기술이 신뢰할 수 있는 손에 있다는 점은 알 수 있습니다. 물론, 개인 정보를 수집하고 판매하지 않으리라는 보장은 없습니다... 아, 잠시만요, 그게 바로 실제 사용 사례라고요? 아, 그렇군요.
컴퓨터 비전 기술이 이미 의심스러운 용도로 사용되고 있지만, 연구자로서 우리는 우리의 작업이 초래할 수 있는 해악을 고려하고 이를 완화하는 방법을 생각할 책임이 있습니다. 세상에 그 정도의 책임은 져야 한다고 생각합니다.
References
[1] Analogy. Wikipedia, Mar 2018. 1
[2] M. Everingham, L. Van Gool, C. K. Williams, J. Winn, and
A. Zisserman. The pascal visual object classes (voc) chal
lenge. International journal of computer vision, 88(2):303
338, 2010. 6
[3] C.-Y. Fu, W. Liu, A. Ranga, A. Tyagi, and A. C. Berg.
Dssd: Deconvolutional single shot detector. arXiv preprint
arXiv:1701.06659, 2017. 3
[4] D. Gordon, A. Kembhavi, M. Rastegari, J. Redmon, D. Fox,
and A. Farhadi. Iqa: Visual question answering in interactive
environments. arXiv preprint arXiv:1712.03316, 2017. 1
[5] K. He, X. Zhang, S. Ren, and J. Sun. Deep residual learn
ing for image recognition. In Proceedings of the IEEE con
ference on computer vision and pattern recognition, pages
770–778, 2016. 3
[6] J. Huang, V. Rathod, C. Sun, M. Zhu, A. Korattikara,
A. Fathi, I. Fischer, Z. Wojna, Y. Song, S. Guadarrama, et al.
Speed/accuracy trade-offs for modern convolutional object
detectors. 3
[7] I. Krasin, T. Duerig, N. Alldrin, V. Ferrari, S. Abu-El-Haija,
A. Kuznetsova, H. Rom, J. Uijlings, S. Popov, A. Veit,
S. Belongie, V. Gomes, A. Gupta, C. Sun, G. Chechik,
D. Cai, Z. Feng, D. Narayanan, and K. Murphy. Open
images: A public dataset for large-scale multi-label and
multi-class image classification. Dataset available from
https://github.com/openimages, 2017. 2
[8] T.-Y. Lin, P. Dollar, R. Girshick, K. He, B. Hariharan, and
S. Belongie. Feature pyramid networks for object detection.
In Proceedings of the IEEE Conference on Computer Vision
and Pattern Recognition, pages 2117–2125, 2017. 2, 3
[9] T.-Y. Lin, P. Goyal, R. Girshick, K. He, and P. Doll´ar.
Focal loss for dense object detection. arXiv preprint
arXiv:1708.02002, 2017. 1, 3, 4
[10] T.-Y. Lin, M. Maire, S. Belongie, J. Hays, P. Perona, D. Ra
manan, P. Doll´ ar, and C. L. Zitnick. Microsoft coco: Com
monobjects in context. In European conference on computer
vision, pages 740–755. Springer, 2014. 2
[11] W. Liu, D. Anguelov, D. Erhan, C. Szegedy, S. Reed, C.
Y. Fu, and A. C. Berg. Ssd: Single shot multibox detector.
In European conference on computer vision, pages 21–37.
Springer, 2016. 3
[12] I. Newton. Philosophiae naturalis principia mathematica.
William Dawson & Sons Ltd., London, 1687. 1
[13] J. Parham, J. Crall, C. Stewart, T. Berger-Wolf, and
D. Rubenstein. Animal population censusing at scale with
citizen science and photographic identification. 2017. 4
[14] J. Redmon. Darknet: Open source neural networks in c.
http://pjreddie.com/darknet/, 2013–2016. 3
[15] J.RedmonandA.Farhadi. Yolo9000: Better, faster, stronger.
In Computer Vision and Pattern Recognition (CVPR), 2017
IEEE Conference on, pages 6517–6525. IEEE, 2017. 1, 2, 3
[16] J. RedmonandA.Farhadi. Yolov3: Anincrementalimprove
ment. arXiv, 2018. 4
[17] S. Ren, K. He, R. Girshick, and J. Sun. Faster r-cnn: To
wards real-time object detection with region proposal net
works. arXiv preprint arXiv:1506.01497, 2015.
[18] O. Russakovsky, L.-J. Li, and L. Fei-Fei. Best of both
worlds: human-machine collaboration for object annotation.
In Proceedings of the IEEE Conference on Computer Vision
and Pattern Recognition, pages 2121–2131, 2015. 4
[19] M.Scott. Smart camera gimbal bot scanlime:027, Dec 2017.
4
[20] A. Shrivastava, R. Sukthankar, J. Malik, and A. Gupta. Be
yond skip connections: Top-down modulation for object de
tection. arXiv preprint arXiv:1612.06851, 2016. 3
[21] C. Szegedy, S. Ioffe, V. Vanhoucke, and A. A. Alemi.
Inception-v4, inception-resnet and the impact of residual
connections on learning. 2017.
YOLOv1, YOLOv2, YOLOv3 비교
| 특징 | YOLOv1 | YOLOv2 | YOLOv3 |
|---|---|---|---|
| 출시 시기 | 2016 | 2017 | 2018 |
| 주요 목표 | 객체 탐지의 속도와 단순성 | 정확도 향상과 소형 객체 탐지 개선 | 다중 스케일 탐지와 더 높은 정확도 |
| 백본 네트워크 | GoogleNet | Darknet-19 | Darknet-53 |
| 예측 방식 | 단일 그리드에서 각 셀이 하나의 객체만 예측 | 앵커 박스를 사용해 다중 객체 탐지 가능 | 다중 스케일에서 앵커 박스 기반 예측 |
| 클래스 예측 방식 | Softmax | Softmax | 독립적인 로지스틱 회귀 (Binary Cross-Entropy) |
| 손실 함수 | 합성 손실 (로컬라이제이션 + 분류 손실) | 합성 손실 (로컬라이제이션 + 분류 + 객체 점수) | 합성 손실 (로컬라이제이션 + 분류 + 객체 점수) |
| 앵커 박스 사용 여부 | 사용하지 않음 | 사용 | 사용 |
| 다중 스케일 예측 | 지원하지 않음 | 지원하지 않음 | 지원 (Feature Pyramid Networks 기반) |
| 주요 개선 사항 | 단순화된 구조로 속도 강조 | 앵커 박스 도입, 높은 해상도 학습, Batch Norm | 다중 스케일 예측, Residual Connection, FPN 사용 |
| mAP 성능 (COCO) | 약 63.4 (VOC) | 약 76.8 (VOC) | 약 57.9 (COCO 기준) |
| 처리 속도 | 약 45 FPS (Titan X) | 약 40-67 FPS (Darknet) | 약 78 FPS (Darknet-53, Titan X) |
| 단점 | 작은 객체 탐지에 약점 | 앵커 박스 크기 튜닝 필요 | IOU 임계값이 높아질수록 성능 저하 |
| 대표 코드베이스 | YOLOv1 코드 | YOLOv2 코드 | YOLOv3 코드 |
