ELECTRA: PRE-TRAINING TEXT ENCODERS AS DISCRIMINATORS RATHER THAN GENERATORS
국민대학교 인공지능학회 (XAI)
Abstract
BERT와 같은 Masked Language Modeling 기반의 사전 학습 방법은 입력 문장의 일부 토큰을 [mask]로 대체해 손상시키고 모델이 원래의 토큰을 복원하도록 학습시킨다.
MLM은 다양한 downstream NLP 작업에 전이 학습될 때 좋은 성능을 내지만 효과를 보기 위해선 일반적으로 매우 많은 계산 자원이 필요하다
이에 대한 대안으로 ELECTRA 논문인 Replaced Token Detection이라는 samle-efficient pre-training task를 제안한다.
이 방식은 입력을 마스킹하는 대신 작은 생성기 네트워크로부터 그럴듯한 대체 토큰을 샘플링해 일부 토큰을 교체함으로써 입력을 손상시킨다.
그리고 손상된 토큰의 원래 정체를 맞추는 방식이 아니라 각 토큰이 원본인지 생성된 것인지를 예측하는 discriminative model(판별 모델)을 학습시킨다.
실험 결과, 이 새로운 사전 학습 과제는 MLM보다 더 효율적임이 입증되었다. 이는 MLM은 일부 마스크된 토큰만 학습 대상으로 삼는 반면에 RTD는 모든 입력 토큰에 대해 학습을 수행하기 때문이다.
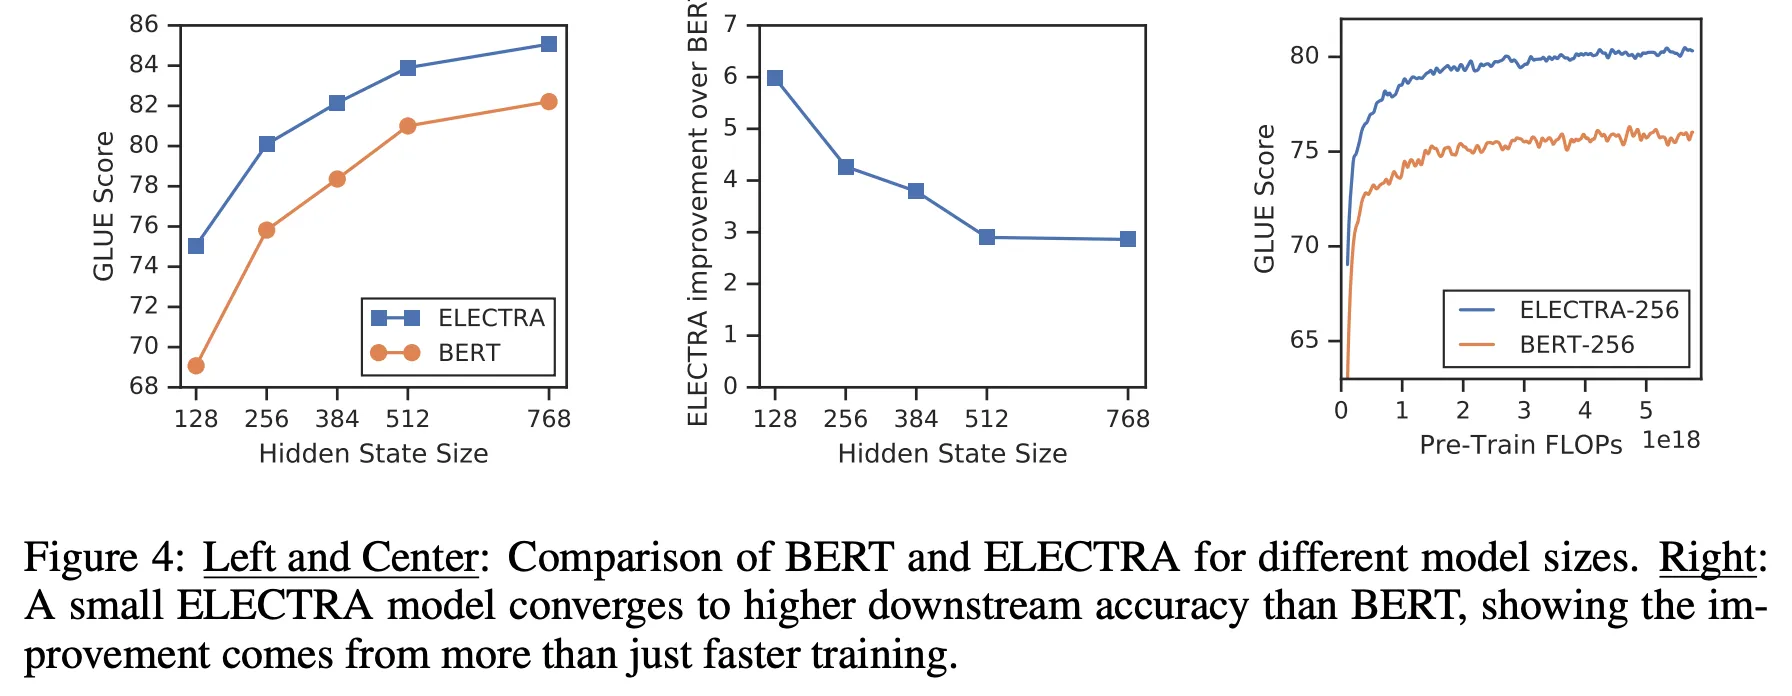
그 결과 동일한 모델 크기, 데이터, 계산 자원을 사용할 경우 RTD의 방식이 학습한 문맥 표현은 BERT를 크게 능가한다.
특히 소형 모델에서 그 성능 향상이 두드러지는데
ex)
- GPU 하나로 4일간 학습한 모델이, 30배 더 많은 꼐산을 사용한 GPT보다도 GLUE 벤치마크에서 더 나은 성능을 낸다.
- 대규모 상황에서도 효과적으로 작동한다 RoBERTa나 XLNet과 유사한 성능을 내면서도 계산량은 1/4이하에 불과하고
- 동일한 계산량을 쓸 경우에는 위의 모델들 보다도 더 좋은 성능을 낸다.
1. Introduction
ELECTRA는 기존의 사전학습 방식이 가진 비효율성을 해결하기 위해 등장한 언어 모델이다. 기존의 대표적인 방식인 BERT는 입력 문장에서 일부 단어(보통 15%)를 [mask]라는 특수 토큰으로 가리고 모델이 그 가려진 단어들을 원래대로 복원하도록 학습한다. 이 방법은 문맥을 이해하는 능력을 효과적으로 기를 수 있지만 근본적인 비효율성이 존재한다. 바로 학습에 실제로 사용되는 정보가 전체 문장의 극히 일부이다. 나머지 85%의 토큰은 계산은 하지만 학습 신호로는 거의 기여하지 못한다. 그리고 [MASK]라는 토큰은 실제로는 존재하지 않는 인공적인 요소이기 때문에 사전학습과 실제 활용(파인튜닝) 간에 괴리가 생긴다는 문제도 있다.
ELECTRA는 이 문제를 다른 방식으로 접근한다. 단어를 가리는 대신 입력 문장의 일부 단어들을 그럴듯하지만 잘못된 다른 단어로 교체해버린다. 예를 들어 “나는 고양이를 좋아한다”라는 문장에서 “고양이”를 “강아지”로 바꾸는 식이다. 이때 바꿔치는 단어는 작은 생성기 모델(Generator)을 통해 선택된다. 그런 다음 메인 모델은 각 단어가 원래 문장에 있었던 단어인지 아니면 생성기를 통해 바뀐 가짜 단어인지 구별하도록 학습된다.
ELECTRA는 단어 하나하나에 대해 “Real or Fake”를 맞추는 이진 분류 문제를 푸는 식으로 학습되는 것이다.
이 방식의 가장 큰 장점은 모든 입력 토큰을 학습하지만 ELECTRA는 전체 문장을 대상으로 학습한다 그래서 같은 양의 계산으로 훨씬 더 많은 학습이 이뤄진다. 위에서 언급했듯이 속도뿐만 아니라 성능도 향상된 것을 볼 수 있다.
결국 ELECTRA가 보여주는 핵심 아이디어는 “생성 대신 판별”이다. 기존 방식처럼 단어를 직접 생성해내는 게 아니라 그 단어가 맞는지를 판단하도록 학습시키는 것만으로도 더 효율적이고 강력한 언어 표현을 만들 수 있다는 것을 입증했다. 이 접근은 특히 꼐산 자원이 한정된 상황에서 매우 실용적이다.
2. Method
ELECTRA는 두 개의 신경망을 함께 학습시키는 방식이다.
하나는 Generator(G) 다른 하나는 Discriminaotr(D)이다. 둘 다 기본적으로 Transformer 기반의 인코더 모델로 입력 문장을 받아 각 토큰마다 문맥 정보를 담은 벡터 표현을 만들어낸다.
먼저 Generator는 기존의 BERT와 마찬가지로 Masked Language Modeling 방식을 따른다. 전체 문장에서 무작위로 일부 토큰(15%)을 골라 [mask]로 바꾸고 이 마스킹된 토큰들이 원래 어떤 단어였는지를 예측하도록 학습된다. Generator의 출력은 같은 마스크 위치 t에서 특정 토큰이 정답일 확률을 나타내는 softmax 확률 분포다.
- : 후보 단어 의 임베딩 벡터
- : 입력 문장에서 위치 t에 대한 Generator의 문맥 벡터
Generaotr는 이 확률 분포를 이용해 마스킹된 자리마다 가장 그럴듯한 단어를 샘플링한다. 그렇게 해서 만들어진 조작된 문장을 Discriminator에 넘긴다. Discriminator는 이 조작된 문장을 보고 각 단어가 원래 문장에서 온 진짜 단어인지 아니면 Generator가 만든 가짜 단어인지를 판별하는 역할을 한다. 이를 위해 각 토큰 위치에서 sigmoid 출력을 사용한다.
Discriminator는 워낼 문장과 Generator가 샘플링한 단어를 비교하면서 위치마다 진짜인지 가짜인지 정답을 부여받고 학습된다. Generator는 원래 단어를 잘 예측하게 학습되고 Discriminator는 그 예측 결과가 진짜인지 가짜인지를 판별하게 되는 구조이다.
Generaotr의 loss는 일반적인 MLM loss이고 Discriminator의 loss는 이진 분류 문제에서의 cross-entropy loss와 같다. 전체적으로 ELECTRA는 다음과 같은 두 loss를 사용하며 이를 동시에 최소화하는 방식으로 학습한다.
여기서 중요한 점은 ELECTRA가 GAN처럼 보이지만 GAN은 아니라는 점이다. Generator와 Discriminator가 동시에 학습되긴 하지만 Generator는 Discriminator를 속이기 위해 adversarial하게 학습되지 않는다. 대신 maximum likelihood 방식으로 학습된다. 이는 gan에서 흔히 발생하는 sampling 과정에서 gradient를 전달할 수 없다는 문제인데, ELECTRA는 이걸 회피하면서도 효율적으로 학습할 수 있다.
또한 GAN처럼 noise vector를 Generator에 입력으로 주지도 않는다. 이 방식은 자연어 처리에 잘 맞지 않기 때문이다. 결과적으로 ELECTRA는 전체 loss를 최소화하는 방향으로 학습된다. 학습이 끝난 뒤에는 Generator는 폐기하고, Discriminator만 다운스트림 작업에 fine-tuning해서 사용한다. 이렇게 하면 모든 입력 토큰을 학습에 활용하면서도, 학습 속도와 효율성은 BERT보다 훨씬 더 뛰어나게 된다.
- : 사전학습에 사용되는 전체 텍스트 코퍼스
- : Generator(G)를 위한 masked language modeling loss
- : Discriminator(D)를 위한 replaced token detection loss
- 전체 목표는 G와 D를 동시에 최적화하여 두 loss의 합을 최소화하는 것
Figure 2

1. 입력 문장 준비
the [MASK]
chef chef
cooked [MASK]
the the
meal meal
여기서 일부 단어는 [mask]로 가려져 있다. 이 구조는 기존의 BERT처럼 MLM과 유사한 입력이다.
2. Generator (작은 MLM 모델)
이 [mask]가 포함된 문장을 Generator에게 넣는다 Generator는 보통 small BERT model(masked language model)로 구성되어 있으며 [mask] 자리에 들어갈 가능성 있는 단어를 샘플링해서 채워 넣는다. 예를 들어
the [MASK]    → the
cooked [MASK] → cooked ate
⇒ 여기서 “ate”는 Genrator가 만든 fake token이다
3. Discriminator (ELECTRA)
3번째가 진짜 중요한 단계 ELECTRA 본체이다. Generator가 만든 “조작된 문장”을 Discriminator에 입력한다.
Discriminator의 역할은 각 단어가 원래 문장에서 온 진짜인지 아니면 생성기에서 만든 fake token인지 하나하나 판별하는 것이다.
the    → original
chef   → original
ate    → replaced
the    → original
meal   → original
//the 는 [mask]해서 생성된 fake token이지만 정답이 맞기때문에 original로 반별- Generator는 학습 중에는 같이 사용되지만 pre-training이 끝나면 폐기
- Downstream task에서 사용하는 것은 오직 Discriminator(ELECTRA 모델) 뿐
- GAN처럼 구조는 비슷하지만 Generator는 adversarial하게 학습되지 않고 Maximum Likelihood 방식으로 훈련된다. (GAN은 텍스트에 적용하기 어렵기 때문이다.)
3. Experiments
| 모델 | 파라미터 | GLUE 성능 | SQuAD 성능 | FLOPs 효율성 |
|---|---|---|---|---|
| BERT-Base | 110M | 82.2 | 88.5 | 기준 |
| ELECTRA-Base | 110M | 85.1 | 90.8 | 동일 FLOPs |
| ELECTRA-Small | 14M | 79.9 | - | 단일 GPU로 학습 가능 |
| ELECTRA-Large | 335M | 89.4 | 91.4 (SQuAD 2.0) | RoBERTa 대비 1/4 FLOPs |
4. Related Works
4.1 Self-Supervised Pre-training for NLP (자기지도 학습)
- 과거에는 Word2Vec, Glove처럼 단어 수준의 임베딩을 학습했다.
- 이후에는 문맥 기반 표현 학습이 등장했고 대표적으로는 BERT는 [mask]를 예측하는 방식(MLM)을 사용
- MASS, UniLM : BERT를 생성(generation) 작업에도 적용
- ERNIE, SpanBERT: 연속된 span 단위로 마스킹 ⇒ 더 나은 문장 표현 학습
- XLNet: [MASK] 대신 랜덤 순서로 auto-regressive 생성 ⇒ BERT보다 괴리 적음
- TinyBERT, MobileBERT: BERT를 작게 압축
ELECTRA는 속도와 효율성에 초점을 맞춰 처음부터 작은 모델(ELECTRA-Small)도 직접 학습
4.2 GANs과의 관련성
- ELECTRA는 구조상 Generator + Discriminator라는 점에서 GAN과 유사
- 하지만 GAN처럼 adversarial(서로가 경쟁하면서 학습하는 방식)하게 학습하지 않고, Generator는 Maximum Likelihood로 학습
- ELECTRA의 Generator는 MaskGAN과 구조적으로 비슷하지만 목적은 다름
4.3 Contrastive Learning (대조 학습)
- ELECTRA는 실제 토큰과 가짜 토큰을 구분하는 이진 분류(binary classification) 문제를 통해 학습
- 이는 Noise-Contrastive Estimation (NCE) 방식과 유사
- Word2Vec의 CBOW + Negative Sampling 구조도 ELECTRA와 개념적으로 비슷 → 주변 문맥을 보고 중심 단어가 진짜인지 아닌지를 맞추는 구조 → ELECTRA는 이것을 Transformer 기반으로 확장한 대규모 버전으로 볼 수 있음
5 CONCLUSION
We have proposed replaced token detection, a new self-supervised task for language representation learning. The key idea is training a text encoder to distinguish input tokens from high-quality negative samples produced by an small generator network. Compared to masked language modeling, our pre-training objective is more compute-efficient and results in better performance on downstream tasks. It works well even when using relatively small amounts of compute, which we hope will make developing and applying pre-trained text encoders more accessible to researchers and practitioners with less access to computing resources. We also hope more future work on NLP pre-training will consider efficiency as well as absolute performance, and follow our effort in reporting compute usage and parameter counts along with evaluation metrics
