선박 데이터 사용량 집계 API 응답 속도 개선기
선박 데이터 사용량을 집계하는 API를 조회 기간을 한 달로 설정해 호출하면 응답에 약 4초가 걸려서 사용자 경험이 저하되는 문제가 있었습니다.
최적화 1. Backend Compression
원인 파악
응답의 병목점을 확인하기 위해 브라우저의 Timing 지표와 Grafana를 통해 응답 소요 시간을 확인했습니다. Timing 지표 상,Waiting For server response(TTFB)가 1.53초, Content Download 시간이 1.82초인 것을 확인했으며, Grafana 를 통해 서버의 응답 소요시간이 2.53초인 것을 확인했습니다. 각 지표의 의미는 다음과 같습니다.
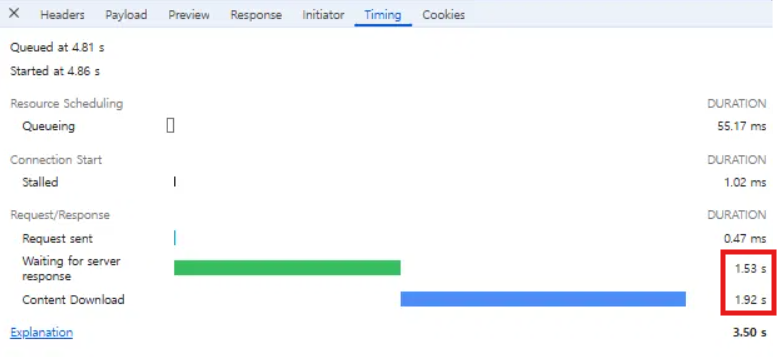
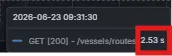
Waiting For server response(TTFB): 브라우저가 요청을 보내기 시작한 시점부터 서버로부터첫 응답 바이트를 받는 데 걸린 시간Content Download: 브라우저가첫 응답 바이트를 받은 순간부터마지막 바이트를 받는 데 걸린 시간, 즉순수한 데이터 전송 시간서버 응답 소요시간: 서버가 요청을 모두 받은 순간부터 응답의 마지막 바이트를 보내는 데 걸린 시간 즉, 처리 시간 + 네트워크 전송 시간
따라서, 다음과 같은 구조로 통해 응답 소요시간이 구성된다고 볼 수 있습니다.
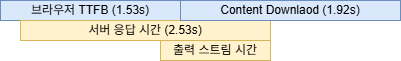
우선, 가장 많은 시간이 소요되는 Content Downalod 시간을 줄이기로 결정했습니다. 약 2초가 걸리는것으로 보아, 응답지연에 네트워크 전송 시간의 영향이 클것이라 예상했으며, 응답 데이터를 압축하면 네트워크 전송 시간 시간이 줄어 서버 응답 시간이 단축되고, 브라우저로 전달될 데이터 패킷 수가 줄어 Content Download 시간도 단축될 것이라 판단했습니다.
해결책
application.properties에 server.compression.enabled=true 설정을 추가해 서버 응답에 압축을 적용했습니다.
결과
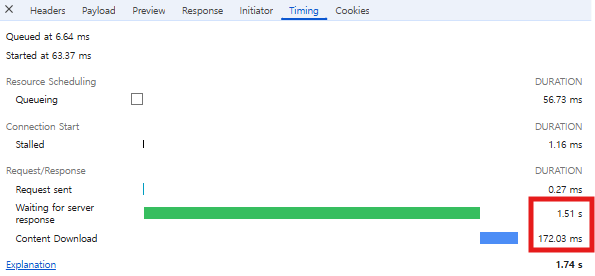
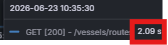
Content Download 시간과 실제 서버 응답 시간 모두 단축하여 결과적으로 3.50s → 1.74s, 약 50% 성능 개선을 이뤄냈습니다.
최적화 2. 병렬화 및 다운 샘플링
압축으로 약 50%를 개선했지만, 한 달 데이터 조회에 여전히 1.74s가 소요되는 것은 여전히 길다고 판단했습니다. Google 권장 기준에 따르면 모든 API는 약 200ms 내외를 유지해야 합니다. 우리 서비스는 B2B라 실사용자가 적어 엄격한 응답 속도가 요구되진 않지만, 느린 응답은 사용자 경험을 해치므로 분명한 개선이 필요하다 판단했습니다.
원인 파악
API를 잘게 해체해 병목을 분석했습니다. 해당 API는 두 개의 쿼리로 동작합니다.
구간 내 좌표 조회 쿼리:1.038초(= 0.232 + 0.806 네트워크 지연)안테나별 데이터 총 사용량 조회:0.406초
두 쿼리 시간의 합이 약 1.4초로, 전체 응답시간 API 1.7초의 대부분을 차지함에 따라 쿼리최적화가 필요함을 확인할 수 있었습니다.
최적화 2-1. 쿼리 병렬화
문제점
하나의 API에서 구간 내 좌표 조회 쿼리와 안테나별 데이터 총 사용량 조회가 순차적으로 실행되어 후자는 전자에 비해 약 2배 이상 빠른 응답속도를 가짐에도 응답이 지연되는 문제가 있었습니다. 두 쿼리는 상관관계가 없었기 때문에 병렬로 실행할 수 있었으므로 둘을 분리하기로 결정했습니다.
해결책
병렬 처리 방안은 두 가지였습니다.
- 하나의 요청 스레드에서 커넥션 두 개를 점유해 병렬 처리 — 트래픽이 몰릴 경우 커넥션 풀 고갈로 인한 데드락 위험이 있음. (현재는 트래픽이 적어 당장 문제가 되진 않지만, 잠재적 위험을 선택지에서 제외)
- API 자체를 두 개로 분리 — 프론트엔드 동료와 추가 협업이 필요하지만, 데드락 위험 없이 안정적으로 성능 향상 기대 가능
결과

프론트 동료와 함께 API를 두 개로 분리한 결과, 응답 시간을 평균 1초대로 개선하여 1.7초 대비 40% 성능 개선을 이뤄냈습니다.
최적화 2-2. 다운 샘플링
문제점
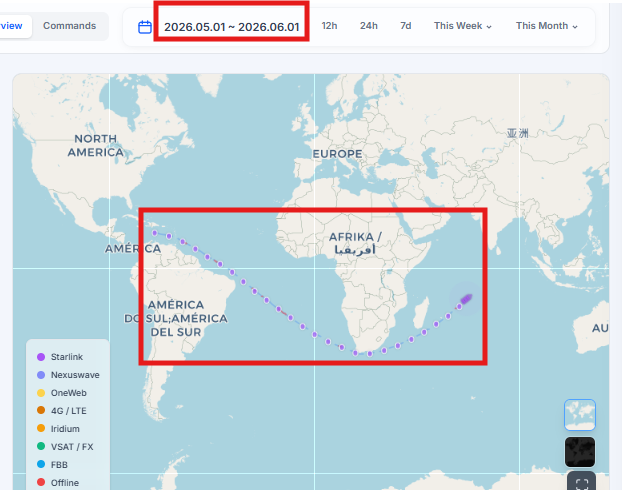
아래 사진의 점들은 구간 내 좌표 조회 API로 조회된 선박의 과거 이동 경로입니다. 앞선 압축·병렬화로 응답 시간을 1초대까지 줄였지만, 목표로 삼은 0.2s(200ms)에는 아직 미치지 못했습니다.
원인 파악
구간 내 좌표 조회 API는 약 1만 개의 데이터를 응답하지만, 위 사진에 보이듯 실제로 화면에 활용되는 좌표는 극히 일부로 대부분의 데이터가 낭비되고 있었습니다. (줌 인 시 추가 좌표가 활용되긴 하지만, 1만 개 전부가 쓰이는 경우는 없었습니다.) 따라서, 클라이언트가 사용하지 않는 데이터를 위해 DB는 구간내의 모든 행에 접근해 RANDOM ACCESS가 증가하여 응답속도가 늦어지는 것으로 판단했습니다.
2-2-1. 위치 정보 다운스케일링
원인 파악 (상세)
SELECT ...
FROM ...
WHERE ...
기존 쿼리 실행 계획의 Extra 칼럼에서 Using index가 없는것을 볼 수 있습니다. 현재 쿼리는 응답으로 전체 칼럼을 필요로 하기 때문에, 약 16174행 각각에 Clustered Index에 추가 접근해 Random Access으로 인한 성능저하가 있었을 것으로 예상했습니다.
해결책
따라서 RandomAccess를 최소화 하기 위해, 각 구간별 대표값만 산출하는 방식으로 개선했습니다. GROUP BY로 시간 구간을 묶어 구간마다 하나의 대표 시점(MIN(timestamp))만 남기고, Deferred Join을 통해 그 대표값에 대해서만 Clustered Index에 접근하도록 하여 RANDOM ACCESS를 최소화했습니다.
SELECT
	...
FROM (
    SELECT MIN(`timestamp`) AS target_timestamp
    FROM vessel_position
    WHERE ...
    GROUP BY FLOOR(
        TIMESTAMPDIFF(SECOND, :startAt, `timestamp`)
        / GREATEST(1, TIMESTAMPDIFF(SECOND, :startAt, :endAt) DIV :coordinateCount)
    )
) AS summary
JOIN ...
LEFT JOIN ...
ORDER BY vp.`timestamp`;
결과
그 결과 API 응답 속도를 1.47s → 0.28s로 개선했습니다.


2-2-2. 중요 정보 하이라이팅
문제점
선박 네트워크 모니터링에서 "중간에 연결이 끊긴 구간이 있었는가"는 가장 중요한 정보인데도 불구하고, 다운샘플링을 적용하면서 이 데이터가 유실될 수 있는 문제가 존재했습니다.
원인 파악
다운샘플링은 GROUP BY로 구간을 묶은 뒤 구간별 첫 번째 행(MIN(timestamp))만 응답합니다. 이 과정에서 나머지 행의 정보가 유실되면서, 연결 끊김 구간이 표기되지 않는 문제가 발생했습니다.
해결책
가장 단순한 방법은 각 좌표별로 인터넷이 끊겼는지 확인하기 위해 모든 행에 접근하는 것이었습니다. 하지만 이 경우 응답해야 할 행이 전과 같아져 두가지 문제가 발생했습니다.
-
조회 범위에 응답 지연 행(좌표)이 많을 시, 응답이 다시 커지는 문제
이 문제를 위해 응답 지연의 한 가지 특성에 주목했습니다. 인터넷 연결이 끊기거나 지연되는 현상은 단일 시점에서 단발적으로 발생하는 것이 아니라, 대부분구간 단위로 지속적으로 발생한다는 점입니다. 즉, 끊김이 시작되고 끝나는 상태가 바뀌는 순간(전환점)만 알면 끊김 정보를 유실 없이 보존하면서도 응답량을 줄일 수 있었습니다. -
인덱스 조회 결과의 각 행에 대한
Clsutered Index추가 접근에 따른 쿼리 지연 문제
응답지연 여부를 판단하는 칼럼의 갯수는 단 2개의 칼럼이였음으로,Index에 포함시켜Covering Index로 동작하도록 개선했습니다.
모든 행이 아니라 "인터넷 연결 상태가 바뀌는 순간"만 LAG() 윈도우 함수와 Covering Index로 추출해 다운샘플링 결과에 반영했습니다.
SELECT *
FROM
    (SELECT
        `timestamp`,
        ... AS curr_connection_available,
        LAG(...) AS prev_connection_available
    FROM ...
    WHERE ...
    ) t
WHERE NOT (t.curr_connection_available <=> t.prev_connection_available)
ORDER BY `timestamp`- 커버링 인덱스 적용 —
0.031초

결과
0.28s에서 0.29s로 5%의 추가 응답시간이 들게 됐지만, "중간에 연결이 끊긴 구간이 있었는가"에 대한 정보를 유실 없이 사용자에게 전달할 수 있게 됐습니다.
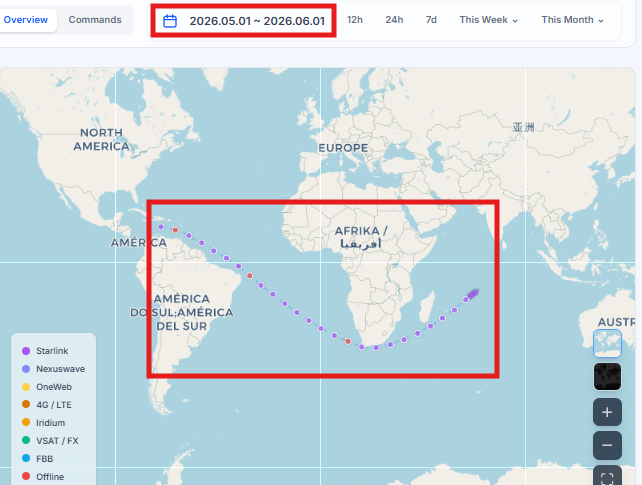
- 전환점 도입 전
- 전환점 도입 후

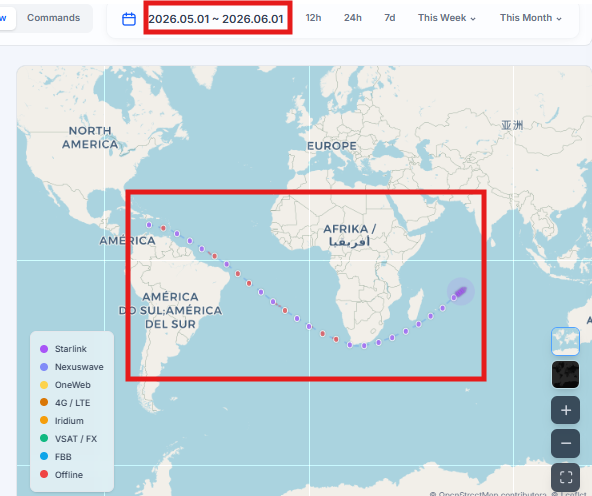
위 사진에서 볼 수 있듯, 이전에 유실됐던 인터넷 끊김 구간이 전환점 추출 쿼리 도입 후 자세히 표시되는 것을 확인할 수 있습니다.
마무리 (전체)
이번 글에서 가장 뜻깊었던 건 마지막 다운샘플링 - 하이라이팅 단계였습니다. 압축과 병렬화는 데이터를 그대로 둔 채 전송·실행 비용만 줄이는 최적화였지만, 다운샘플링은 대표값만 남기고 나머지 행을 버리는 방식이라 모니터링에서 가장 중요한 '연결 끊김 구간'이 유실되는 문제가 새로 나타나는 최적화였습니다.
긴 글 읽어주셔서 감사합니다.

대단합니다 추구하세요