API 응답속도가 약 12초까지 지연되는 현상
영업지원팀 매니저님으로부터 시스템 화면 로딩속도가 너무 느리다는 문의를 받았다. 선박에 직접 호출하는 데이터라, 선박이 사용중인 위성 인터넷에 따라 느린게 당연한 현상이라 설명을 드렸지만, 이후 레거시 관제시스템이 2초 내로 응답하는것을 보고 뭔가 다른 문제가 있음을 알 수 있었다. (현재 시스템에선 약 12초가 걸렸다. 약 5배 차이...)

분석
1. 레거시 시스템 vs 모던 시스템
가장 먼저 확인했던 포인트는 두 시스템이 사용하는 API에 차이가 있는지였다. 결론적으로 둘은 내부적으로 같은 함수를 사용하고 있었다. 레거시 시스템은 php를 사용함에 따라 함수 호출이고, 모던 시스템은 같은 함수를 활용하는 API를 사용할 뿐이였다.
2. Postman vs SpringBoot?
API 호출에 문제가 있는지 확인하기 위해 API를 Postman을 통해 확인한 결과, 같은 API를 활용하는 Spring Boot에서의 응답속도가 아닌, 레거시 시스템의 응답속도 2초와 유사한 빠른 응답속도를 확인할 수 있었다. 같은 서버, 같은 API, 같은 네트워크인데 Postman은 2초대였지만 서버에선 약 11초가 소요됐다. 네트워크 자체가 느린 것이라면 Postman도 똑같이 느려야 했다.
3. 프로파일을 통한 분석
Postman과 Spring Boot 에서의 API 호출 응답속도 차이의 원인을 파악하기 위해, Async-Profiler를 활용했다.
CPU 프로파일링은 스레드가 실제로 CPU를 사용하는 순간만 샘플링하기 때문에, 소켓 대기처럼 CPU를 쓰지 않고 블로킹된 시간은 그래프에 나타나지 않는다. 지금처럼 "응답은 느린데 서버 CPU는 한가한" 상황에서는 경과 시간 전체를 샘플링하는 wall-clock 모드를 써야 스레드가 어디서 시간을 흘려보내는지 보인다.
asprof -e wall -t -i 10ms -d 30 -f /tmp/all.jfr 384672-e wall로 wall-clock 모드를 지정하고, -t 옵션으로 스레드별 분리, -i 10ms로 샘플링 주기를 지정했다.
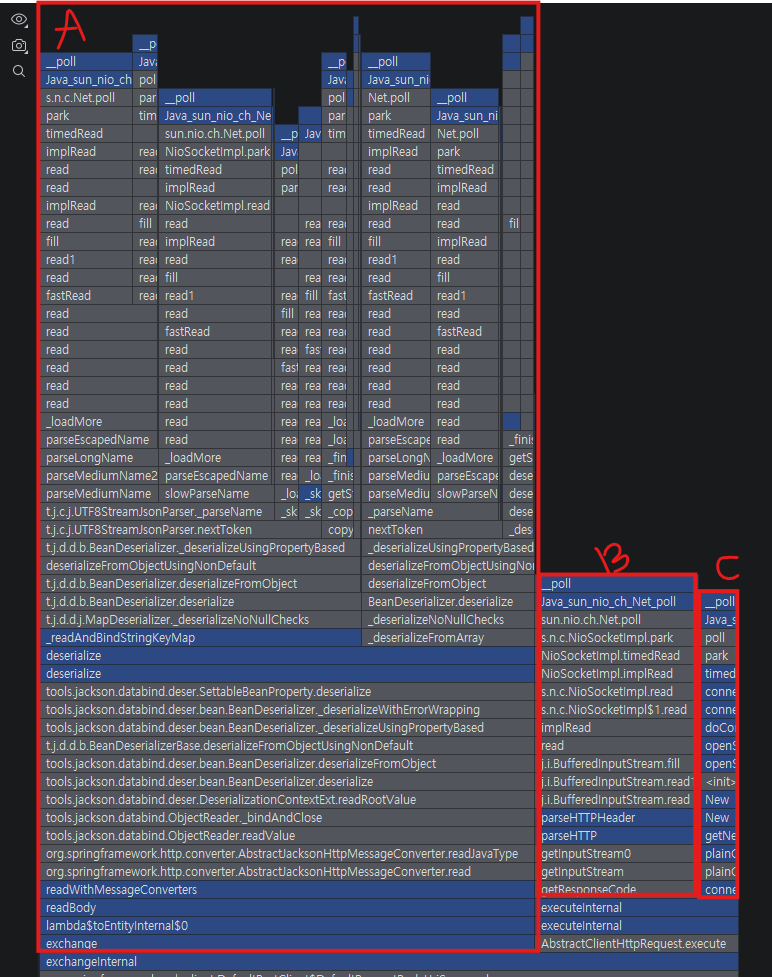
프로파일 대상 모던 시스템은 @HttpExchange의 RequestFactory로 SimpleClientHttpRequestFactory를 사용하고 있었다. 이 구현체는 JDK HttpURLConnection 기반이라, Flame Graph에는 HttpURLConnection 내부의 블로킹 소켓 호출이 그대로 드러난다.
위 Flame Graph에서 요청 스레드의 시간은 크게 세 구간으로 나뉜다. 각 구간은 스택 최상단 프레임으로 구분할 수 있다.
- A body 대기시간
- B header 대기시간
- C tcp connect 대기시간
시간 기준으로 A가 압도적이었다.
여기서 주목할 점은 A 구간의 형태다. Body를 읽는 동안 poll()이 한 번 길게 블로킹된 것이 아니라 반복적으로 발생했다. 이는 데이터가 한 번에 도착하지 않고 여러 세그먼트에 걸쳐 조금씩 도착했다는 의미이며, 각각으로 인한 Blocking 타임이 응답지연에 결정적인 영향을 미쳤다고 볼 수 있다.
아래 사진에서 볼 수 있듯 위성 네트워크는 기본적으로 긴 지연시간을 가진다.

RTT가 무려 1초이므로, 위의 Blocking 타임이 문제의 원인임을 알 수 있다.
4. 압축이 응답속도를 빠르게 하는 이유
그렇다면, Postman에서는 블로킹이 일어나지 않아서 응답속도가 빨랐던 걸까? 왜 같은 API 호출인데 블로킹이 일어나지 않았을까?
Postman은 압축을 지원하고 있었다. Postman은 Accept-Encoding: gzip 헤더를 보내고 압축 해제까지 자동으로 처리하여 응답이 빨랐던 반면, 스프링의 SimpleClientHttpRequestFactory는 JDK HttpURLConnection의 래퍼일 뿐이라 압축을 지원하지 않아 원본 JSON 전체를 위성 회선으로 받아 느렸던 것이다.
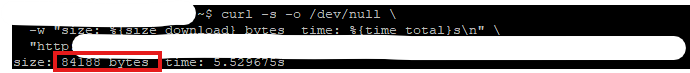
압축이 응답속도를 어떻게 줄이는지 알아보기 위해 압축 적용 전/후의 데이터 사이즈를 비교해보자.
압축 전: 84188 byte
압축 후: 2993 byte
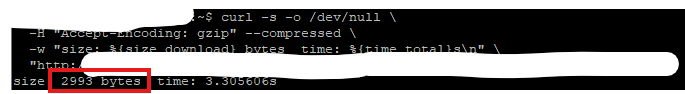
압축 후 데이터가 약 28배 적다는 것을 볼 수 있다. 그런데 여기서 "데이터가 작으니 전송이 빨라진다"고 대역폭 관점으로 결론짓기엔 부족하다. 84KB는 대역폭으로 나눠보면 1초도 안 걸리는 크기이기 때문이다. 데이터 크기가 응답속도에 영향을 미친 진짜 이유는 왕복 횟수에 있고, 이 왕복 횟수를 결정하는 것이 TCP Slow Start다.
위성 네트워크는 기본적으로 긴 지연시간을 가진다.
TCP는 연결 초기에 네트워크 용량을 모르기 때문에, 처음부터 대량 전송을 하지 않고 혼잡 윈도우 작게 잡고 시작한다. 리눅스 기본값은 10 MSS다. 송신 측은 ACK를 받아야 cwnd를 키울 수 있고, ACK가 돌아올 때마다 윈도우가 두 배씩 커진다. RTT 1초인 위성 네트워크에서는 윈도우가 한 번 커질 때마다 1초가 사라진다.
압축 전: 84188 byte ≈ 61 세그먼트
  RTT 1: cwnd 10 → 누적 10
  RTT 2: cwnd 20 → 누적 30
  RTT 3: cwnd 40 → 누적 61 (완료)
  → Body 수신에만 3 RTT ≈ 3초

압축 후: 2993 byte ≈ 3 세그먼트
  RTT 1: cwnd 10 → 한 번에 전송 완료
  → 1 RTT ≈ 1초
이렇게, 압축만으로 Body 구간에서 2 RTT, 약 2초가 사라진 셈이다. 그리고 이 "cwnd만큼 도착 → ACK 왕복 대기 → 다음 버스트 도착" 패턴이, 앞서 Flame Graph의 A 구간에서 poll()이 반복적으로 블로킹됐던 이유다.
해결
gzip 적용
원인이 SimpleClientHttpRequestFactory가 압축 협상을 하지 않는 것이었으므로, RequestFactory를 Apache HttpClient 기반의 HttpComponentsClientHttpRequestFactory로 교체했다. Apache HttpClient는 기본으로 Accept-Encoding: gzip 헤더를 붙이고, 압축된 응답의 해제까지 자동으로 처리한다. 즉 애플리케이션 코드는 손대지 않고 RequestFactory 교체만으로 Postman과 같은 조건이 된다.
HttpComponentsClientHttpRequestFactory를 사용하려면 의존성 추가가 필요하다.
// https://mvnrepository.com/artifact/org.apache.httpcomponents.client5/httpclient5
implementation("org.apache.httpcomponents.client5:httpclient5:5.6.2")
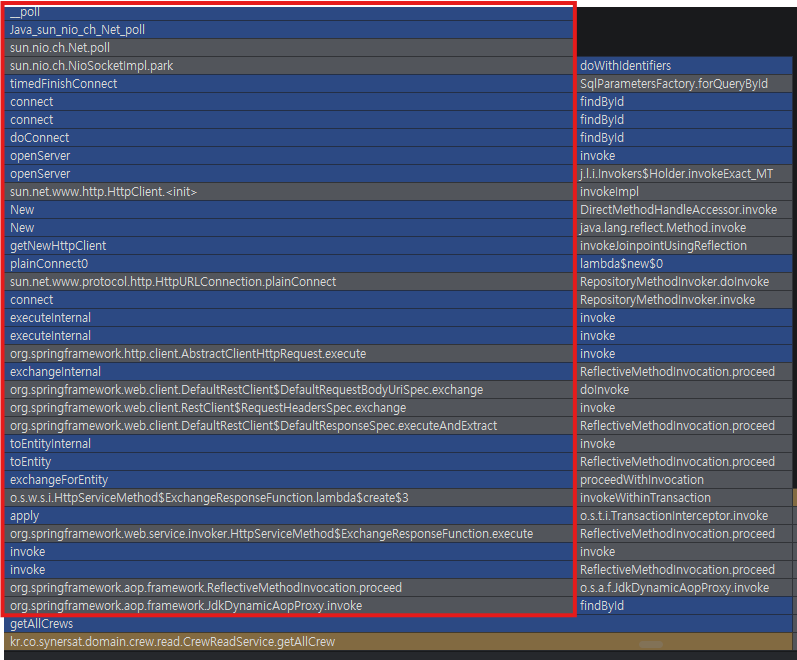
적용 결과, 응답속도가 약 11초에서 2.7초로 개선됐다.

프로파일링 결과도, 이전과 달리 하나의 poll로 처리되는것을 볼 수 있다.
참고
https://www.tunetheweb.com/blog/critical-resources-and-the-first-14kb/

관심있는 내용입니다