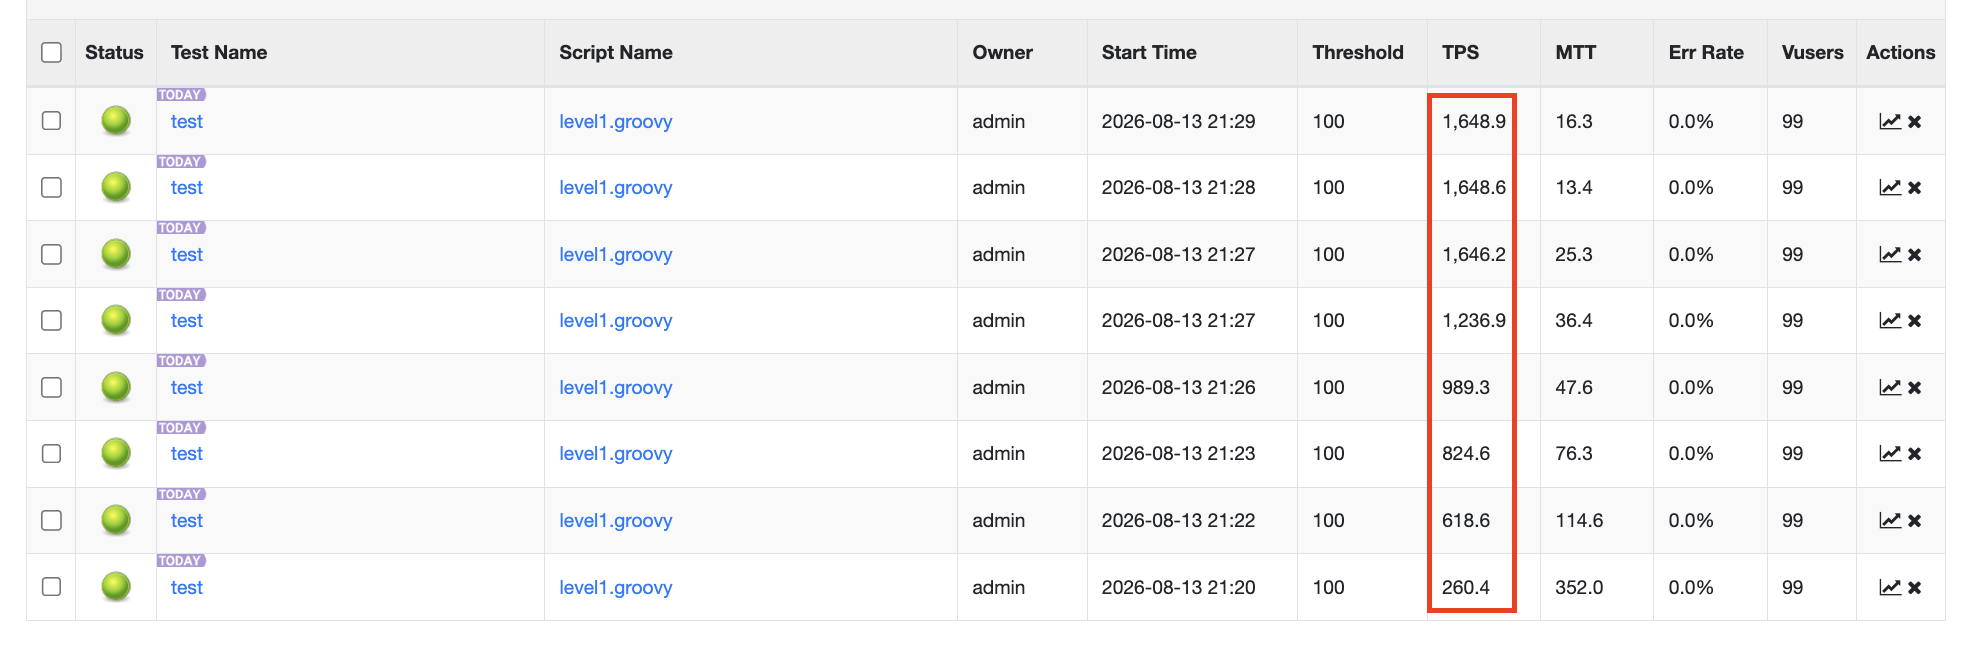
부하 테스트 중, 동일한 테스트임에도 실행 횟수가 많아질수록 TPS가 증가하는 현상을 확인할 수 있었습니다. 이번 글에선 JVM 내부의 어떤일로 이런 성능 차이가 생기는지 알아보겠습니다.
인터프리터와 JIT
1. Java로 작성된 언어는 런타임에 최적화
자바로 작성된 코드는 다음 과정을 거쳐 실행됩니다.
.java ──(javac)──> .class 바이트코드 ──(클래스로더)──> JVM 실행 엔진 ( JIT / 인터프리터 )자바는 런타임에 최적화를 수행
C/C++의 gcc -O2와 같은 컴파일 타임 최적화는, 빌드 타임에 수행되므로 컴파일 비용 제약 없이 깊은 전역 최적화가 가능하지만 입력 분포, 분기 확률, 실제 로드될 클래스 같은 런타임 프로파일이 없음에 따라 가능한 모든 실행 경로를 가정한 보수적 최적화만 가능하단 한계가 있습니다.
이와 반대로, 자바 진영의 JIT 컴파일러는 바이트 코드 컴파일 단계인 javac 에선 최적화를 거의 하지 않고, 컴파일 시점엔 알 수 없던 런타임 프로파일을 활용해 실제 워크로드에 더욱 적합한 최적화를 수행합니다.
또한, JVM은 대부분의 코드가 몇 번 실행되지 않는다는점을 활용해 처음에 모든 코드를 인터프리터로 돌립니다. (전체 실행 시간의 대부분은 소수의 핫 코드가 차지한다는 관찰), (컴파일 비용 아끼기...!)
2. 인터프리터와 JIT 컴파일러
JVM에서 인터프리터와 JIT 컴파일러는 독립적으로 동작합니다. 인터프리터는 어플리케이션 스레드 위에서 실시간으로 바이트 코드를 기계어로 변환하며, JIT 컴파일러는 백그라운드 스레드에서 동작하며, 통계값이 일정 임계점을 돌파한 코드를 최적화 컴파일 합니다.
3. 메소드 단위로 통계 수집
JIT 컴파일러는 통계값을 메소드 단위로 내며, 아래 두가지 지표를 카운팅합니다.
invocation counter(메소드 호출 횟수)backedge counter(내부 반복 횟수)
이 통계값이 임계점을 넘으면 해당 메소드가 "HOT"함을 인지하고, 이를 JIT 컴파일러의 C1, C2레벨로 최적화 합니다.
C1. 속도가 빠른 대신 얕은 최적화, C1 컴파일 큐를 가지고 있음
C2. 속도가 느린 대신 깊은 최적화, C2 컴파일 큐를 가지고 있음
4. 메소드 단위 컴파일
JIT 컴파일은 컴파일 큐를 통해 실행되며, 애플리케이션 스레드가 아니라 백그라운드 스레드 위에서 동작합니다. 백그라운드 스레드에서 컴파일되는 동안 메서드는 계속 기존 레벨로 실행되고, 완료되면 다음 호출부터 새 코드를 탑니다.
따라서, 워밍업 중엔 애플리케이션 스레드 외에 컴파일러 스레드가 추가되어 CPU 사용량이 증가합니다. — 부하테스트 초반에 CPU가 유난히 높은 이유 중 하나.
5. 최적화 레벨
JIT 컴파일러는 메소드별로 수집된 통계를 바탕으로 아래 5가지 방법으로 컴파일합니다.
Level 0: 인터프리터 동작 (프로파일 수집)
Level 1: C1, 최적화·프로파일링 없음 — 더 볼 것 없는 자명한 메서드용 (여기서 끝)
Level 2: C1 + 가벼운 프로파일링
Level 3: C1 + 완전한 프로파일링 — 일반적인 경유지
Level 4: C2 — 레벨 3에서 모은 프로파일을 근거로 최종 최적화
각 레벨 간 전이는 통계치가 임계치를 만족하는 순간 메소드 컴파일 요청이 큐에 제출되는 방식으로 일어납니다.
이때 컴파일 큐는 레벨별이 아니라 컴파일러별로 두 개 존재합니다
- Level 1~3 요청은 C1 큐 삽입
- Level 4 요청은 C2 큐로 삽입
큐별 전담 백그라운드 컴파일러 스레드가 삽입된 메소드 컴파일 태스크를 처리합니다.
큐에서 대기하는 메소드 컴파일 태스크가 대기하는 동안에도 메소드는 기존 레벨로 계속 실행됩니다.
또한, 프로파일 수집은 실행 속도에 큰 영향을 미칩니다. 완전한 프로파일링이 붙은 Level 3 코드는 프로파일링이 없는 Level 1 코드보다 25~30%가량 느립니다. 그래서 JIT 컴파일러는 컴파일 큐의 포화 상태를 레벨 판단에 반영합니다. 큐가 밀려 있으면 승격 임계치를 동적으로 상향해 "정말 핫한 메소드"만 큐에 제출하고, C2 큐가 정체되어 Level 3(느린 구간)에서의 대기가 길어질 것으로 예상되면 프로파일링이 가벼운 Level 2를 경유지로 선택합니다.
1) 0 -> 3 -> 1
모든 메소드는 level0 에서 시작합니다. 인터프리터로 컴파일되는 동안 수집된 통계가 임계치를 돌파해 level3 컴파일이 완료했지만, level3에서 수집된 프로파일을 분석했을 때 C2 컴파일 가치가 없어 level1로 마무리 하는 상황입니다.
2) 0 -> 3 -> 4
level3 전이가 완료 됐고, 추가적으로 C2 최적화 할 가치가 있다고 판단한 상황입니다.
3) 0 -> 2 -> 3 -> 4
level0에서 임계치가 돌파했지만, C2 컴파일러가 바빠 level3에서의 시간이 길어질거라 예상된 상황입니다. 이전에 언급했듯 프로파일링 정도에 따라 성능차이가 존재하며, level3는 프로파일링 정도가 가장 높은 구간이기에 level2를 중간 경유지로써 활용하도록 최적화됩니다.
6. 역최적화 (Deoptimization)
C2 최적화는 "지금까지 수집된 프로파일이 앞으로도 유효하다"는 가정으로 Level4로 유지됩니다. 예를 들어 특정 인터페이스의 구현체가 지금까지 하나만 관측됐다면, C2는 가상 호출을 직접 호출로 바꾸고 인라이닝까지 해버립니다. 그런데 런타임에 이 가정이 깨지면 — 새로운 구현체가 로드되거나, 한 번도 타지 않던 분기가 실행되면 — 해당 네이티브 코드는 폐기되고 메소드는 인터프리터(Level 0)로 강등됩니다. 이후 프로파일을 다시 쌓아 재컴파일될 때까지 성능이 일시적으로 하락합니다.
대표적인 트리거는 다음과 같습니다.
- 예측하지 못한 타입 등장 (다형성 가정 붕괴)
- 한 번도 실행되지 않아 컴파일에서 제외됐던 분기(uncommon trap) 진입
- 새로운 클래스 로딩으로 인한 클래스 계층 분석 무효화
- 코드 힙 고갈
Warm-Up 관련 메트릭
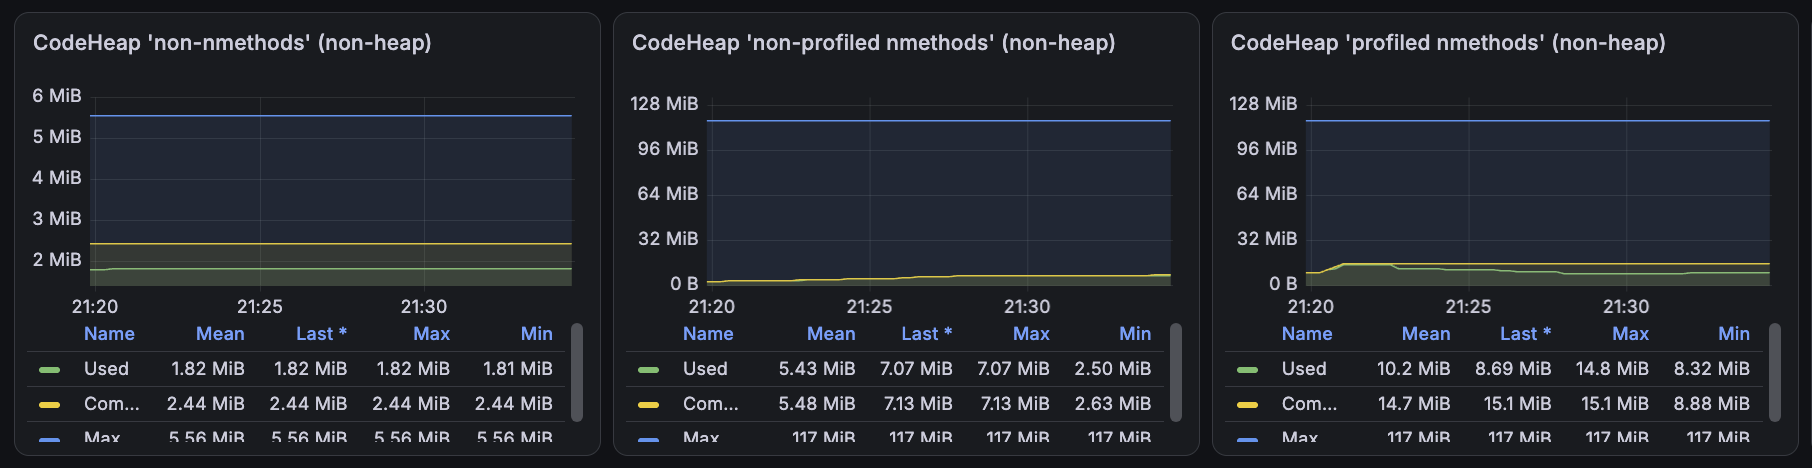
지금까지 설명한 워밍업 과정은 메트릭으로 직접 관측할 수 있습니다. JIT 컴파일러가 생성한 네이티브 코드는 코드 캐시(Code Cache) 영역에 저장되는데, JDK 9부터 이 영역이 세 개의 세그먼트로 분리되었습니다(JEP 197). 흥미로운 점은 컴파일 레벨별로 저장되는 세그먼트가 다르다는 것입니다. 덕분에 각 세그먼트의 사용량 변화만 봐도 지금 워밍업이 어느 단계인지 읽어낼 수 있습니다.
1. CodeHeap 'non-nmethods'
컴파일된 자바 메소드가 아니라 JVM 내부용 코드(인터프리터 본체, 호출 규약 변환용 어댑터 등)가 저장되는 공간입니다. JVM 기동 시점에 한 번 생성되고 이후 거의 변하지 않기 때문에, 그래프가 수평선이면 정상입니다.
2. CodeHeap 'profiled nmethods'
Level 2, 3의 산출물이 저장됩니다. 프로파일 수집 코드가 심어진 중간 단계 결과물이며, 해당 메소드가 Level 4로 승격되면 폐기되기 때문에 수명이 짧습니다. 워밍업이 시작되면 가장 먼저, 가장 가파르게 증가하는 영역입니다.
3. CodeHeap 'non-profiled nmethods'
Level 1, 4의 산출물이 저장됩니다. 프로파일링 코드가 제거된 최종 코드이며, 가장 오래 살아남습니다. profiled 영역보다 한 박자 늦게 증가하기 시작하는데, 이는 Level 3에서 프로파일이 충분히 쌓인 메소드들이 순차적으로 C2 컴파일을 통과하고 있다는 의미입니다.
메트릭으로 워밍업 단계 파악
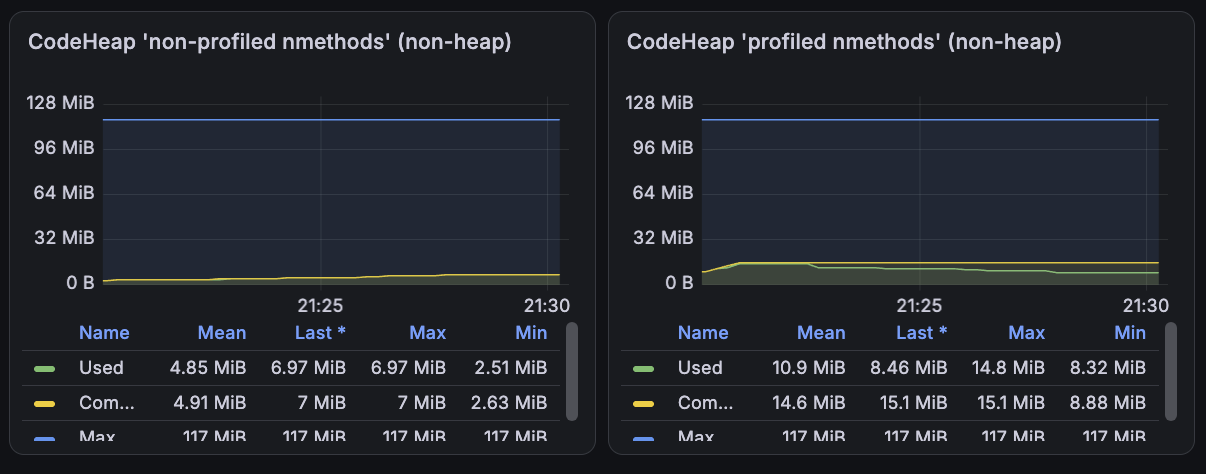
위 그래프에서 profiled nmethods가 먼저 부풀어 오르고(Level 3 경유 중), non-profiled nmethods가 뒤따라 증가하는(Level 4 도착) 흐름을 확인할 수 있습니다. 이 이동이 바로 앞서 본 0 → 3 → 4 승격 경로가 실제로 진행되는 모습이며, 부하 테스트에서 TPS가 계단식으로 상승하던 구간과 일치합니다.
이 메트릭으로 알 수 있는 정보는 두가지입니다.
(1) 워밍업 완료 시점 판단
CodeHeap 'non-profiled nmethods' 영역의 증가가 멈추고 평탄해지는 시점을 "핫 메소드의 컴파일이 끝난 시점", 즉 서버가 최대 성능에 도달한 시점으로 판단할 수 있습니다.
실제로 아래 그래프에서 최신 3개 테스트는 이전과 달리 초반 상승 구간 없이 Max TPS를 일정하게 유지하고 있습니다. 동일 시간대의 CodeHeap 'non-profiled nmethods' 메트릭 역시 추가 증가 없이 평탄하게 유지되었는데, 이는 앞선 테스트에서 이미 핫 메소드들의 C2 컴파일이 완료되어, 이후 테스트는 컴파일된 네이티브 코드 위에서 처음부터 최대 성능으로 수행되었음을 의미합니다.
(2) 코드 캐시 고갈 감지
코드 캐시가 가득 차면 JIT은 컴파일을 중단하고 애플리케이션은 인터프리터에 의존해 컴파일이 진행됩니다. 힙과 달리 OOM 같은 명시적인 에러 없이 성능만 떨어지기 때문에, 어플리케이션의 성능이 갑자기 떨어지면 이 지표를 확인해 보는것도 좋겠습니다.
JVM 옵션으로 워밍업 변인 통제하기
빠른 결과를 얻기 위해 JVM 옵션으로 C2 레벨까지의 컴파일을 제거했습니다.
우선, 웜업 시간이 너무 길어 코드 개선에 따른 성능 향상 추이를 분석하고 빨리 적용해보기엔 피로도가 컸으며, 이 성능 측정에서 확인하려는 것은 캐싱 적용 전후의 성능 차이지 JIT 컴파일러가 만들어내는 성능 향상 추이가 아니였기 때문입니다.
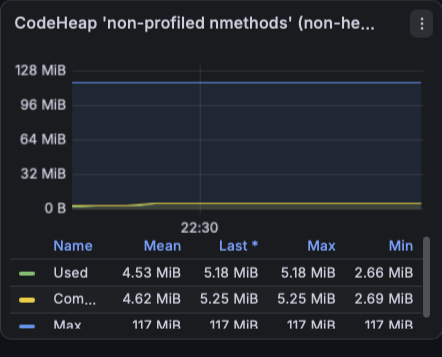
테스트 시작 후 5분이 경과했음에도 여전히 non-profiled code cache가 증가하고 있는 것을 볼 수 있습니다.
시도할 수 있는 옵션은 두 가지입니다.
-Xint                      # JIT 비활성화, 인터프리터로만 실행
-XX:TieredStopAtLevel=1    # C2 비활성화, C1(Level 1) 컴파일까지만 허용
-XX:CompileThresholdScaling=0.1 # 임계값에 배율 적용
1. 인터프리터 방식(-Xint)을 선택하지 않은 이유
처음엔 JIT 컴파일러를 완전히 꺼버리는 것도 고려했습니다. 컴파일 자체가 일어나지 않으니 워밍업 곡선이 사라지고, 어차피 측정하려는 것은 절대 성능이 아니라 개선 전후의 비율이니 문제없을 거라 생각했기 때문입니다.
그러나 비율 비교라 해도 왜곡이 발생할 수 있습니다. 인터프리터의 성능 페널티는 CPU 실행 구간에만 적용되고, I/O 대기 구간에는 적용되지 않기 때문입니다. 응답 시간을 I/O 대기 + CPU 실행으로 나눠보면 다음과 같습니다.
[C2 (운영 환경)]
캐싱 전: DB 10ms + CPU 2ms  = 12ms
캐싱 후: 캐시 0.1ms + CPU 2ms ≈ 2ms      → 약 83% 개선

[인터프리터 (-Xint), CPU 15배 느려진다고 가정]
캐싱 전: DB 10ms + CPU 30ms = 40ms
캐싱 후: 캐시 0.1ms + CPU 30ms ≈ 30ms    → 약 25% 개선
캐싱이 제거하는 것은 주로 I/O(DB 조회) 구간인데, 인터프리터에서는 CPU 구간이 수십 배 부풀어 응답 시간의 지배 요인이 I/O에서 CPU로 바뀌어버립니다. 그 결과 같은 캐싱을 적용해도 성능 향상 비율이 실제보다 훨씬 작게 측정됩니다.
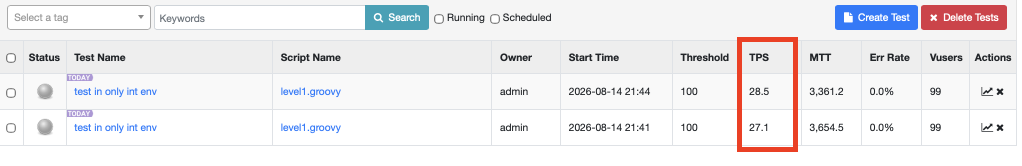
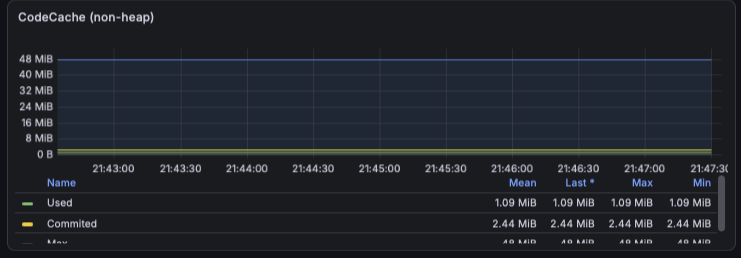
보다시피, 컴파일이 진행되지 않아 CodeCache에 변동이 없는것을 확인할 수 있습니다.
2. C1 컴파일로 제한 (-XX:TieredStopAtLevel=1)
그래서 운영 환경에 그나마 근사한 TieredStopAtLevel=1을 선택했습니다. 컴파일을 Level 1에서 멈추도록 제한하는 옵션으로, C1 코드는 C2 대비 10~30% 정도 느린 수준이라 CPU/I/O 비율 구조가 운영 환경과 거의 유지되어 성능개선 비율도 거의 왜곡 없이 측정할 수 있습니다.
물룬 인터프리터와 달리 웜업 문제가 생기지만, C2에 비하면 빠르면서도 성능 향상폭이 보전되는 절충안이라고 판단했습니다.
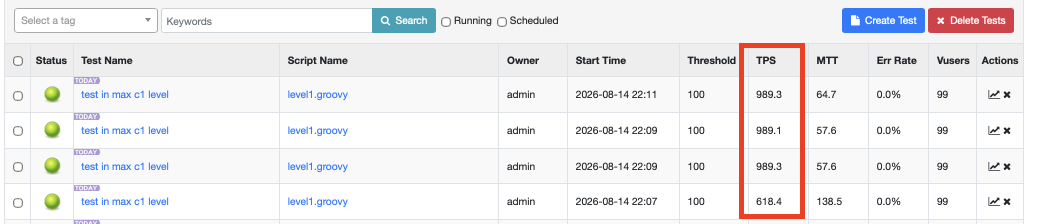
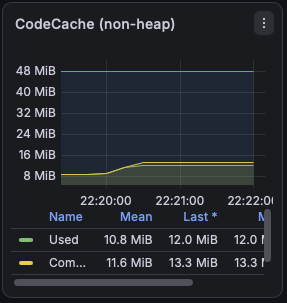
실제 웜업 시간을 비교한 결과, 아래와 같이 웜업 1분만에 코드 캐시가 안정화된 모습을 볼 수 있습니다.
정리
따라서, 부하 테스트 반복 시 TPS가 점진적으로 증가한 원인은 핫 메소드들이 인터프리터에서 Level 4 네이티브 코드로 교체된 영향이였고, 이는 CodeHeap 'non-profiled nmethods' 메트릭의 증가 곡선으로 직접 확인할 수 있었습니다.
이 워밍업이 이후의 성능 비교 테스트(캐시 도입, 인덱스 추가 등)를 왜곡하지 않도록 -XX:TieredStopAtLevel=1로 JIT 컴파일을 제한했습니다. 웜업 구간은 짧게 유지하면서도 CPU, I/O 비율 구조는 운영 환경과 유사하도록 하여, 개선 요인의 효과를 신뢰할 수 있는 비율로 측정할 수 있게 되었습니다.
+) 결과 확인
./asprof -e cpu -d 30 -f jit_cpu_profile.html

결국엔 제로썸게임이라는게 글의 요지군요 대단합니다 정.확.흔