이전 글에서 캐싱과 스레드 풀 튜닝을 통해 기존 TPS 대비 10배의 성능향상을 이뤄냈습니다. 동시에, 사용자가 늘어남에 따른 캐싱 메모리 문제가 발생했는데, 이번 글에선 어떤 문제가 발생했고 이를 어떻게 해결했는지 기록합니다.
1. 문제 파악
기존 캐싱은 "게시글 목록 + 사용자 읽음 상태"를 한 엔트리에 캐싱하고 있었습니다.
	@Cacheable(
		cacheNames = ARTICLE_FIRST_PAGE_WITH_USER_CACHE,
		key = "#memberId",
		condition = "#pageable.getOffset() == 0"
	)
	public Slice<ReadArticleResponse> getReadArticlesV3(Long memberId, Pageable pageable) {
		return articleRepository.findReadArticles(memberId, pageable);
	}
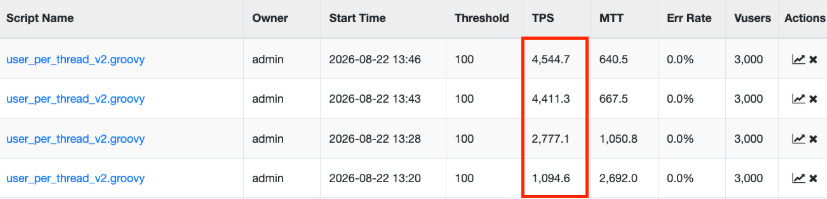
동시 사용자 3000명인 상황에서도 약 4400TPS의 성능을 뽑아낼 수 있을 정도로 성능 개선을 이뤘으나, 아래와 같은 문제가 동시에 발생했습니다.
1-1) 메모리 공간 낭비 문제
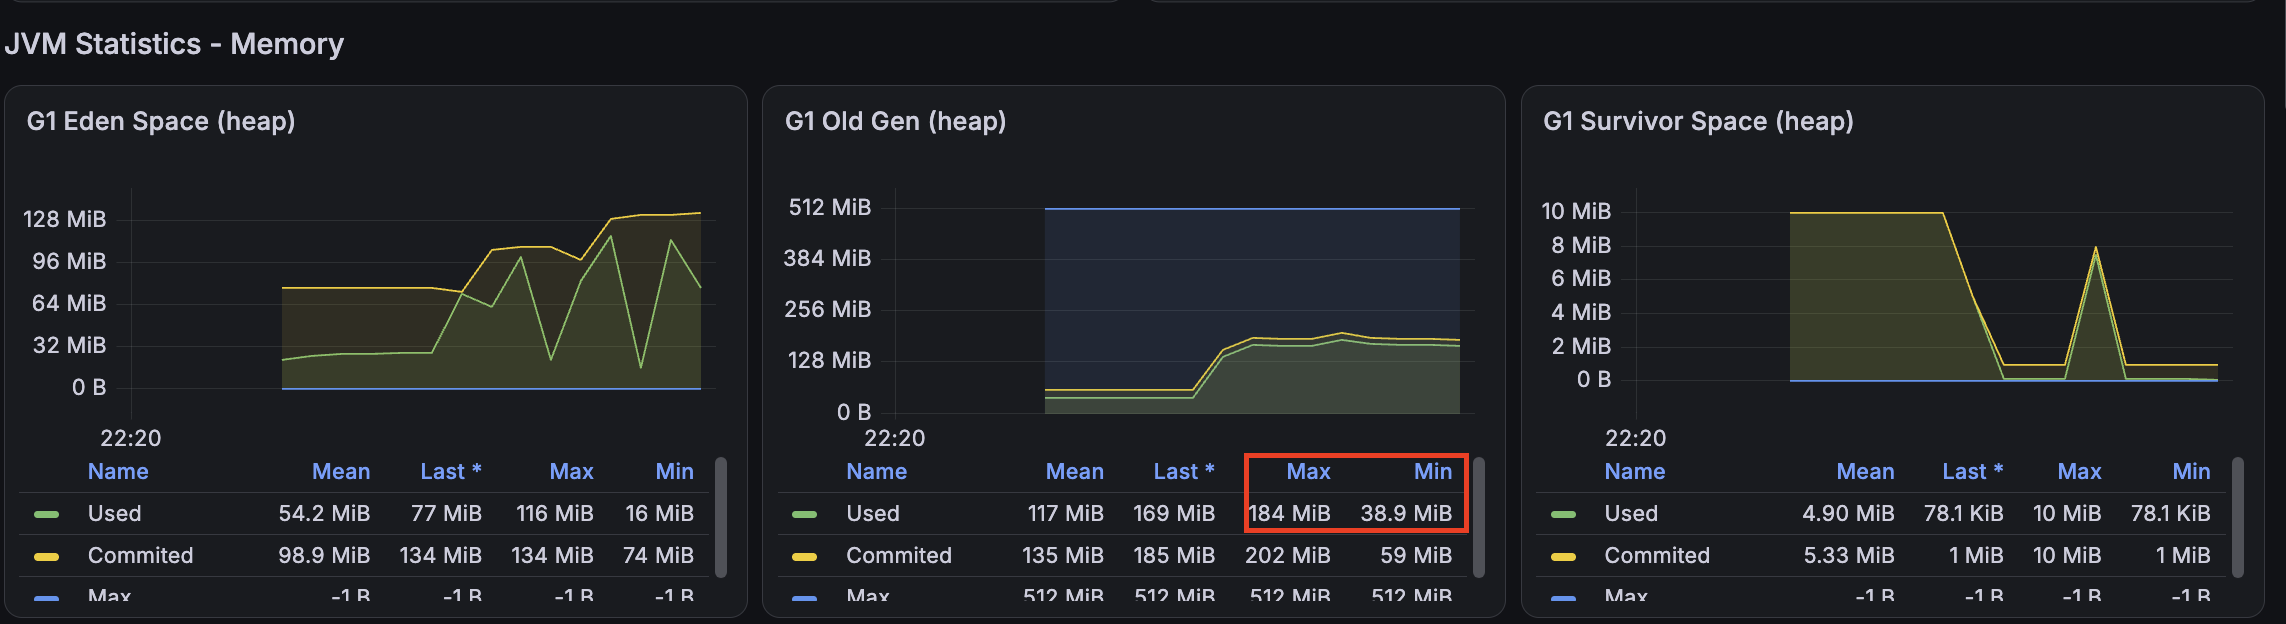
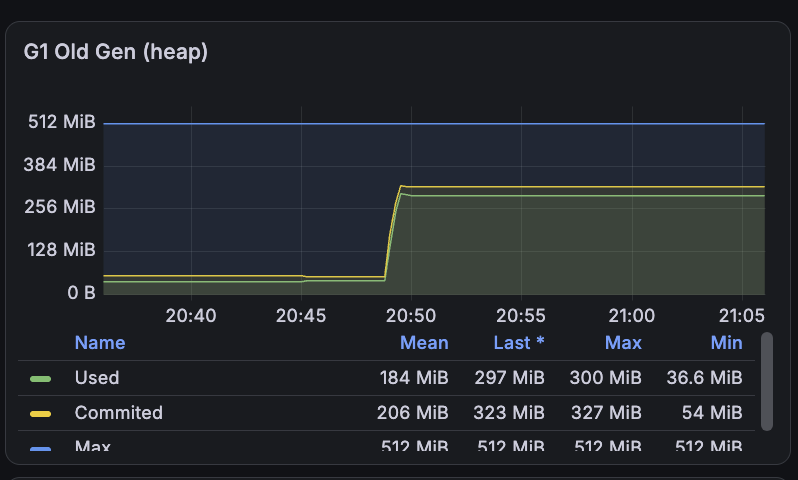
첫번째 문제는 메모리 사용량이 지나치게 많다는 점입니다. 아래 메트릭을 보면 사용자 3000명에 대한 캐싱을 위해 약 150MB가 사용되고 있는것을 볼 수 있으며, 이런 상황에선 동시 사용자가 두배 세배로 늘어났을때 힙메모리 부족으로 인해 Full GC이 지속적으로 유발 위험, 잦은 캐시 교체로 인한 캐시 스레싱 위험이 존재합니다.
1-2) 게시글 추가 시 전체 무효화 문제
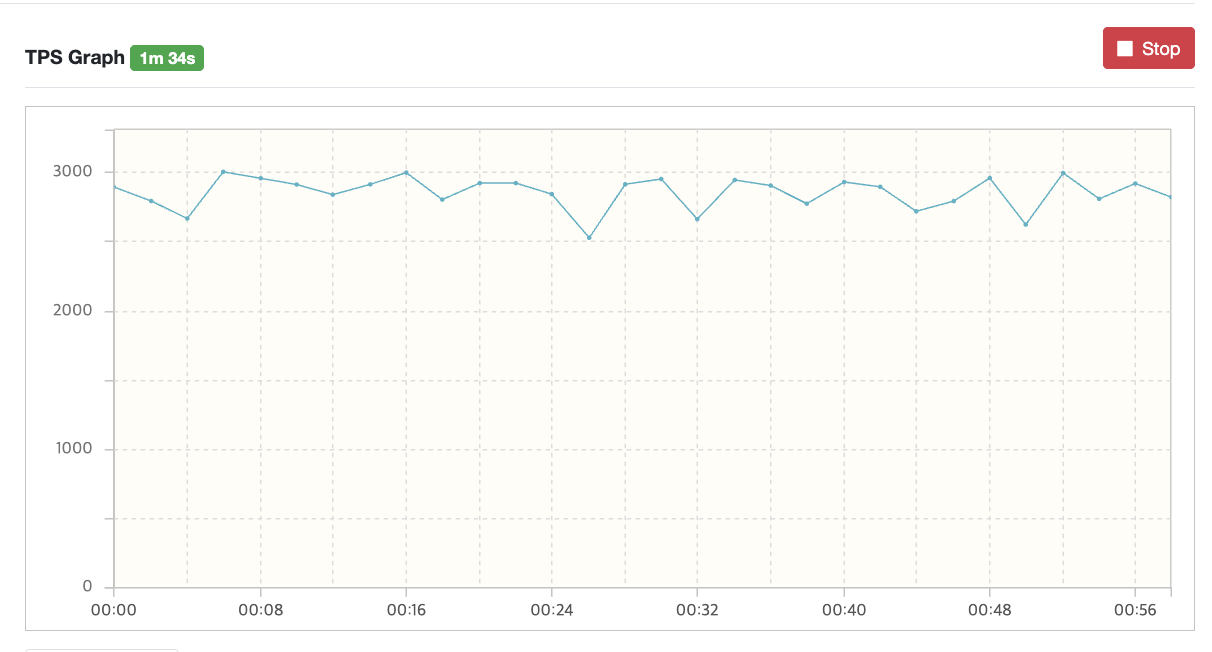
게시글은 어느정도의 실시간성이 요구됩니다. 사용자는 게시글 추가/삭제 작업 후 조회 결과로 업데이트된 게시글 목록을 기대하게 되는데, 캐시 갱신이 바로 이뤄지지 않는다면 이것이 반영되지 않아 사용자 경험이 저하될 수 있습니다. 따라서 게시글이 추가/삭제 될때마다 기존 캐시 엔트리를 초기화해 최신화하는데, 문제는 게시글 목록이 사용자별 캐시 엔트리에 중복되어 저장되어 있다는 점입니다. 게시글 하나가 바뀌면 특정 엔트리만이 아니라 모든 캐시 엔트리를 evict 해야 함으로, 순간적으로 TPS가 급락하게 됩니다. 아래 사진은, 부하 테스트 중 게시글을 4번 추가했을때 나온 TPS 그래프입니다.
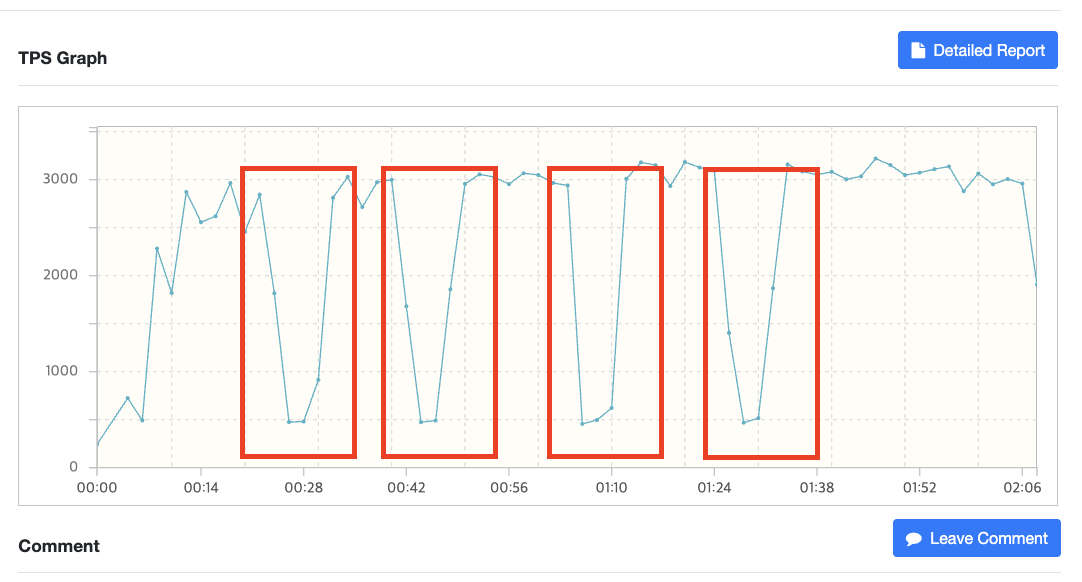
실제 운영환경에선 훨씬 더 잦은 게시글 추가/삭제가 있을것임으로, 이 급락이 상시적으로 일어나게 됩니다.
2. 문제 해결
2-1) Global Data / User Specific Data 분리
문제의 원인이 "공통 데이터와 사용자별 데이터가 한 엔트리에 묶여 있다"는 점이었음으로, 둘을 분리해서 각각 캐싱했습니다. 모든 사용자에게 공통인 게시글 목록을 Global Data, 사용자별로 달라지는 읽음 상태를 User Specific Data로 두었습니다.
	public Slice<ReadArticleResponse> getReadArticlesV4(Long memberId, Pageable pageable) {
		final Set<Long> userReadPages = userReadLogManager.readLogs(memberId);
		final Slice<Article> articles = articlePageQueryManager.getReadArticlesV3(pageable);

		return articles.map(article -> new ReadArticleResponse(
			article.getId(),
			article.getTitle(),
			article.getCreatedMemberId(),
			userReadPages.contains(article.getId()),
			article.getCreatedAt(),
			article.getUpdatedAt())
		);
} @Cacheable(
cacheNames = USER_READ_LOG_CACHE,
key = "#memberId"
)
public Set<Long> readLogs(Long memberId) {
return articleReadLogRepository.findArticleReadLogByReadMemberId(memberId).stream()
// 지연 로딩 프록시라도 id 만 꺼낼 땐 추가 쿼리가 발생하지 않는다
.map(readLog -> readLog.getArticle().getId())
.collect(Collectors.toSet());
} @Cacheable(
cacheNames = ARTICLE_FIRST_PAGE_CACHE,
condition = "#pageable.getOffset() == 0"
)
public Slice<Article> getReadArticlesV3(Pageable pageable) {
return articleRepository.findBy(pageable);
}이 분리로 1장의 두가지 문제가 같이 해결됐습니다.
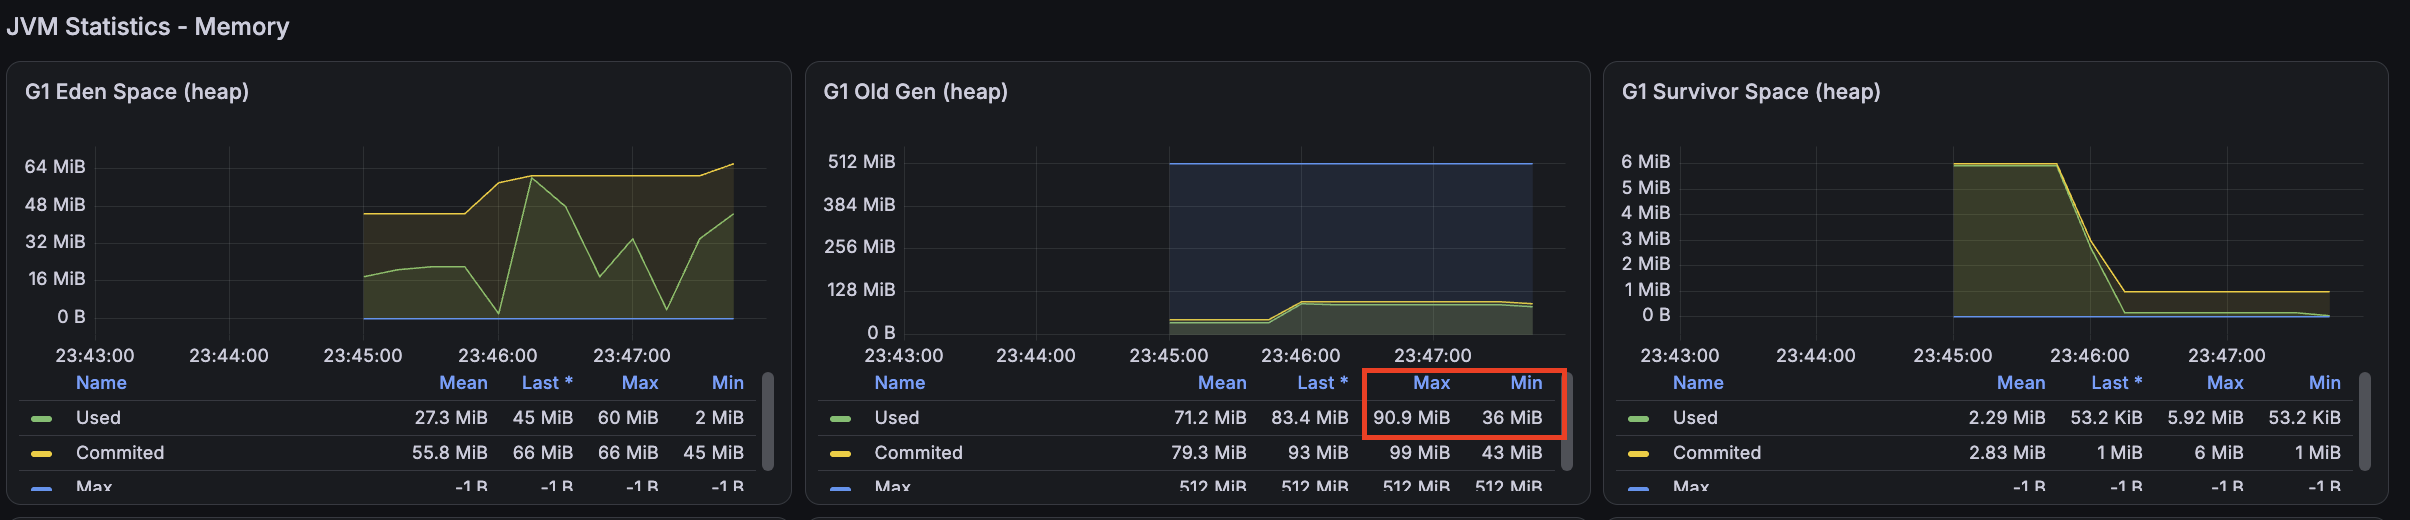
먼저 게시글 목록이 사용자 수만큼 복제되던게 한벌로 줄어듭니다. 기존 186MB를 사용하던 캐싱 메모리가 90MB로 약 1/2로 줄어든것을 확인할 수 있습니다.
또한 게시글 추가/삭제 시 무효화 대상이 Global Data 엔트리 하나뿐입니다. 사용자별 읽음 상태는 그대로 남고, 재적재도 쿼리 한번이면 끝남으로 미스가 DB로 몰리지 않습니다. 실제로 조회 트래픽 중간에 새로운 포스팅이 생겨도 이전과 같은 TPS 저하가 일어나지 않았습니다.
2-2) User Specific Data 캐싱 고도화 필요성
하지만 분리 후에도 User Specific Data 쪽에는 여전히 사용자 수에 비례하는 메모리 문제가 남아 있습니다. 사용자 한 명이 게시글 1만 개를 읽었다면, 읽은 게시글 ID 집합을 캐싱하는 데 최소 80KB(10,000 × 8B)가 필요합니다. 동시 사용자가 1만 명이면 이 캐시만으로 약 800MB가 필요합니다.
더 큰 문제는 이 메모리 대부분이 낭비된다는 점입니다. 목록 조회 한 번에 화면에 노출되는 게시글은 수십 개인데, 사용자가 읽은 1만 개 전부를 들고 있는 셈입니다.
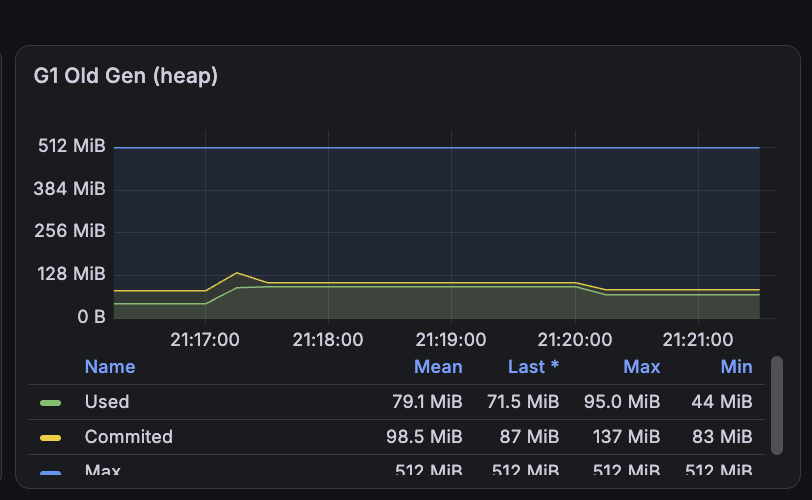
아래는 사용자 1~300명의 읽은 게시글 수를 각각 1만 개로 맞춘 상태로 부하 테스트를 진행한 결과입니다. 동시 사용자 수에 정비례해 힙 사용량이 증가하는 것을 볼 수 있습니다.
따라서 "읽은 게시글 ID 집합"을 통째로 들고 있지 않고, 실제로 조회에 필요한 최소 범위만 저장하도록 구조를 바꿔야 합니다.
2-3) 게시글 별로 읽은 사용자 목록 캐싱
목록 조회 시 실제로 필요한 정보는 "이 사용자가 지금 화면에 노출되는 게시글을 읽었는가"입니다.
캐시 키를 사용자에서 게시글로 변경해, 게시글별로 "이 글을 읽은 사용자 ID 집합"을 캐싱하도록 합니다. 기존 방식은 동시 사용자 수 × 사용자별 읽은 게시글 수로 커져 동시 사용자에 따라 메모리 사용량 예측이 어려웠지만, 새 방식은 캐시된 게시글 수 × 해당 글을 읽은 사용자 수이며, 캐시되는 게시글은 화면에 노출되는 최근 글 위주로 제한되므로 사용량을 어느 정도 예측하고 통제할 수 있습니다. 예를 들어 게시글 100개를 각각 10만 명이 읽었더라도 100 × 800KB = 80MB 수준입니다.
	// 게시글 별 캐싱
	public Slice<ReadArticleResponse> getReadArticlesV5(Long memberId, Pageable pageable) {
		final Slice<Article> articles = articlePageQueryManager.getReadArticlesV3(pageable);

		return articles.map(article -> new ReadArticleResponse(
			article.getId(),
			article.getTitle(),
			article.getCreatedMemberId(),
			userReadLogManager.getUsers(article.getId()).contains(memberId),
			article.getCreatedAt(),
			article.getUpdatedAt())
		);
	}

	@Cacheable(
		cacheNames = READ_USERS_PER_ARTICLE_CACHE,
		key = "#articleId"
	)
	public Set<Long> getUsers(Long articleId) {
		return articleReadLogRepository.findArticleReadLogByArticleId(articleId).stream()
			.mapToLong(ArticleReadLog::getReadMemberId)
			.boxed()
			.collect(Collectors.toSet());
	}
아래는 게시글별 캐싱을 적용한 결과입니다. 동시 사용자가 늘어도 힙 사용량이 거의 증가하지 않습니다.
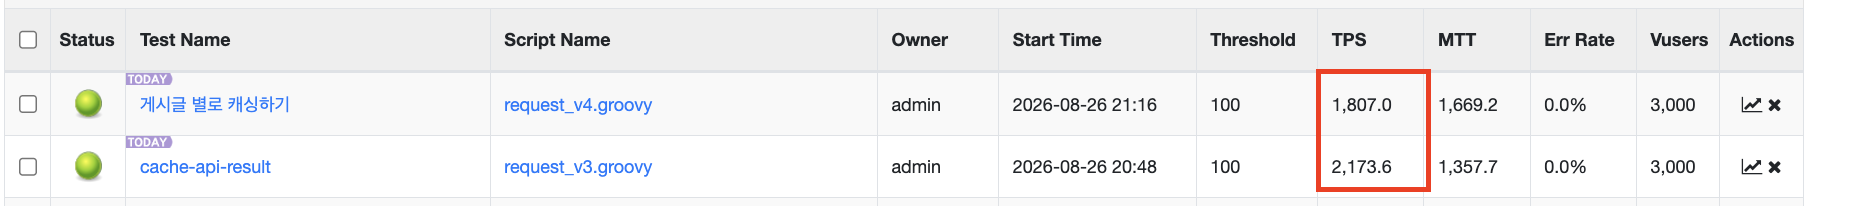
이 결과에서 아래와 같이 TPS의 감소가 있었는데, 이 원인에 대해선 다른 글에서 다뤄보겠습니다.
2-4) Roaring Bitmap ( 도입 X )
"게시글을 읽은 사용자 ID 집합"은 결국 정수 집합이므로, HashSet<Long> 대신 Roaring Bitmap으로 압축 저장하는 방법도 검토했습니다.
현재 메모리 상황에선 메모리 사용량이 충분히 최적화되었다고 판단해 도입하진 않았습니다.
Roaring Bitmap은 32비트 정수 집합을 상위 16비트 기준으로 65,536개 단위의 청크로 나누고, 청크마다 원소 밀도에 따라 저장 방식을 바꾸는 자료구조입니다. 원소가 4,096개 미만이면 정렬된 배열로, 그 이상이면 8KB 비트맵으로 저장해 저장공간을 최소로 활용합니다.
3. 정리
- 문제: 공통 게시글 목록과 사용자별 읽음 상태를 한 엔트리에 묶어 캐싱해, 메모리가 사용자 수만큼 중복되고 게시글 변경 시 전체 무효화가 필요했다. 동시 사용자가 증가했을때 GC, 캐시 스레싱으로 인한 성능 저하가 예상됐다.
- 1차 개선: 공통 데이터와 사용자별 데이터를 분리해 메모리를 절반으로 줄이고, 무효화 범위를 엔트리 하나로 좁혔다.
- 2차 개선: 사용자별 읽은 글 집합 대신 게시글별 읽은 사용자 집합으로 캐시 키를 변경하여, 메모리 상한이 동시 사용자 수가 아닌 캐시된 게시글 수에 의해 제어되도록 개선했다.
4. 번외
캐싱과 트랜잭션 함께 사용할땐 TransactionAwareCacheManagerProxy 사용하자
	@Bean
	public TransactionAwareCacheManagerProxy transactionAwareCacheManagerProxy() {
		return new TransactionAwareCacheManagerProxy(cacheManager());
	}