이번 글에서는 스케일 아웃으로 TPS를 끌어올린 과정과, 그 과정에서 마주친 문제들을 해결한 경험을 정리합니다.
문제들
1. CPU 리소스 제한
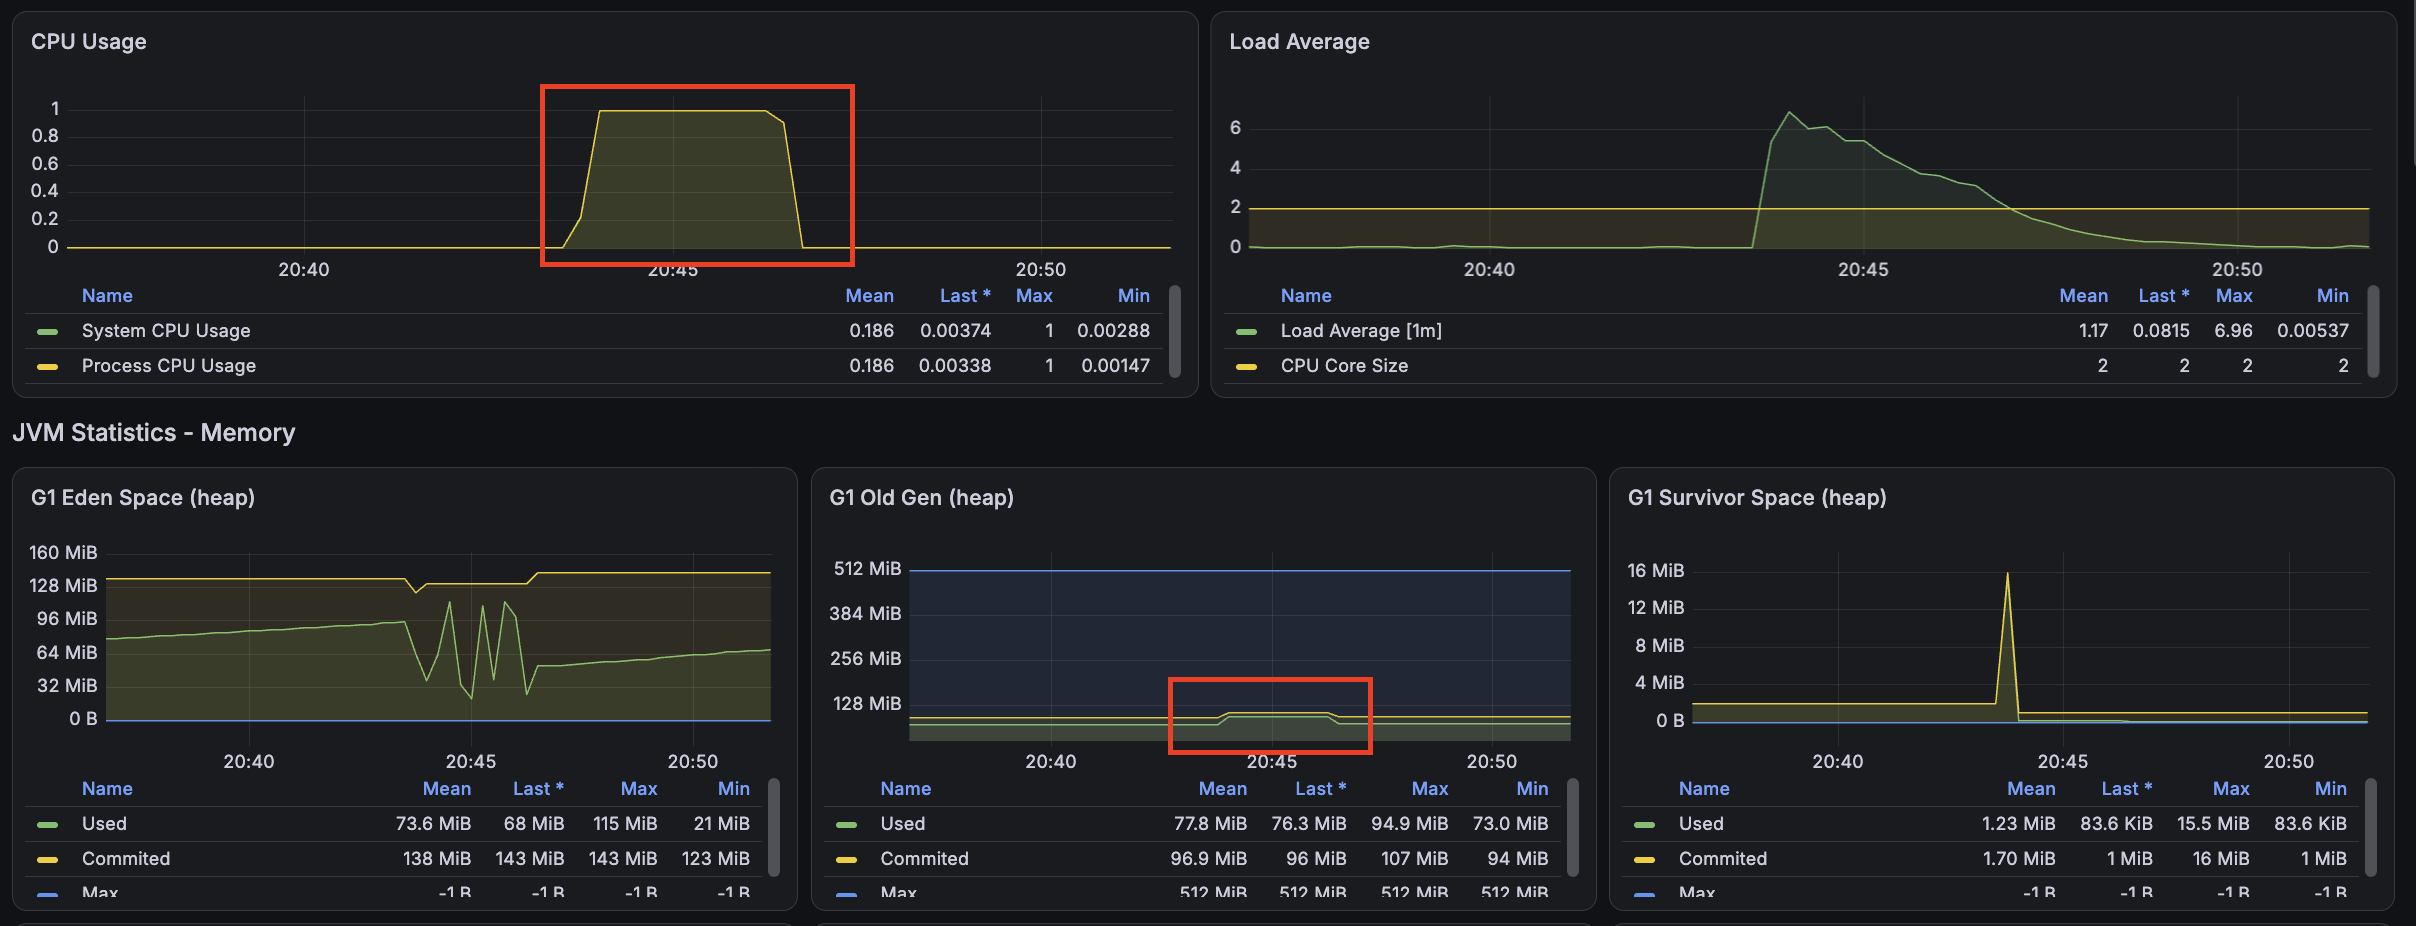
이전 글에서 캐시 구조를 바꿔 동시 사용자가 늘어나도 메모리는 안정적으로 유지할 수 있게 되었습니다. 하지만 아래 그래프처럼 CPU가 100%에 붙으면서 TPS가 약 [X]에서 더이상 올라가지 않았습니다. 이를 해결하기 위해 스케일 업 보단 인스턴스를 추가하는 스케일 아웃을 택했습니다. 단일 인스턴스의 스케일 업은 한계가 정해져있기도 하고, 무엇보다 지금까지 만든 로컬 캐시 구조가 여러 인스턴스 환경에서 어떤 문제를 일으키는지 확인해보고 싶었습니다.
1-1) 서버 인스턴스 추가 ( 스케일 아웃 )
docker compose 를 활용하여 다중 인스턴스 환경을 구성했습니다. nginx를 리버스 프록시로 두고 API 서버 컨테이너는 이전과 동일하게 리소스를 2 CPU, 2GB 제한하여 2대 띄웠습니다. 또한, Prometheus를 통해 Spring Boot API 서버와 MySQL, redis의 메트릭을 수집했습니다.
version: '3.8'
services:
  prometheus:
    image: docker.io/prom/prometheus
    container_name: prometheus
    ports:
      - "9090:9090"
    volumes:
      - ./prometheus:/etc/prometheus
    restart: always

  grafana:
    image: docker.io/grafana/grafana:latest
    container_name: grafana
    volumes:
      - ./grafana:/var/lib/grafana
    ports:
      - "3000:3000"
    restart: always

  mysql:
    image: docker.io/mysql:8.4
    container_name: mysql # 생성 할 컨테이너 이름
    # restart: always # 수동종료 전까지 항상 켜지도록 유지 (sleep 방지)
    volumes:
      - ./db/mysql/data:/var/lib/mysql
      - ./db/mysql/init:/docker-entrypoint-initdb.d
    environment:
      MYSQL_ROOT_PASSWORD: root
      MYSQL_DATABASE: perftest
    cpus: 4.0
    mem_limit: 4096M

  mysql-exporter:
    image: docker.io/prom/mysqld-exporter:latest
    container_name: mysql-exporter
    restart: always
    command:
      - "--mysqld.address=mysql:3306"
      - "--mysqld.username=exporter"
    environment:
      MYSQLD_EXPORTER_PASSWORD: exporterpw

  api1:
    image: performance-api:22.0
    container_name: apiServer1
    restart: always
    volumes:
      - ./:/app/config
    cpus: 2.0
    mem_limit: 2048m

  api2:
    image: performance-api:22.0
    container_name: apiServer2
    restart: always
    volumes:
      - ./:/app/config
    cpus: 2.0
    mem_limit: 2048m

  nginx:
    image: docker.io/library/nginx:1.27-alpine
    container_name: nginx
    restart: always
    ports:
      - "8080:8080"
    volumes:
      - ./nginx.conf:/etc/nginx/nginx.conf:ro
    depends_on:
      - api1
      - api2

  redis:
    image: docker.io/library/redis:latest
    container_name: 'redis'
    cpus: 2.0
    mem_limit: 2048m

  redis-exporter:
    image: docker.io/oliver006/redis_exporter:latest
    container_name: redis-exporter
    environment:
      - REDIS_ADDR=redis://redis:6379
    depends_on:
      - redis
    restart: always
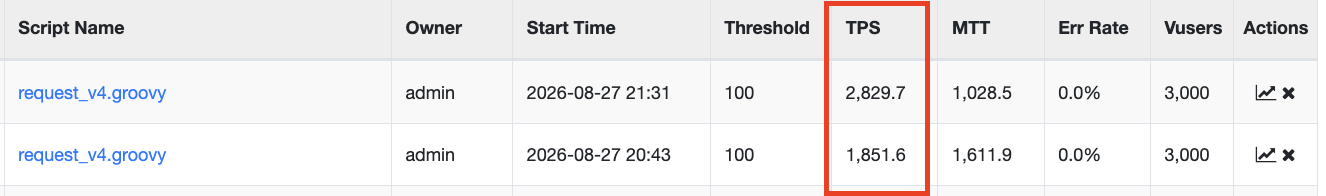
부하 테스트 결과 TPS가 1,851.6에서 2,829.7로 약 1.5배(+53%) 증가했습니다.
2. 캐시 동기화 문제
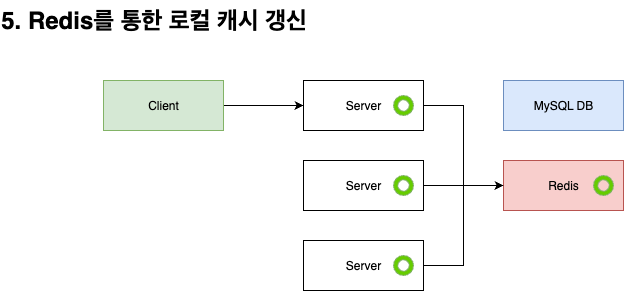
인스턴스 추가로 TPS는 올랐지만 각각 로컬 캐시를 사용함에 따라 각 서버가 갱신한 데이터가 다른 서버의 로컬 캐시에 반영되지 않는 문제가 있습니다. 사용자가 새로운 게시글을 읽거나 게시글을 추가하여 A 서버의 로컬 캐시가 갱신되어도, 동일 사용자의 후속 요청이 B 서버로 가면 남은 TTL 동안 갱신되지 않은 stale 데이터를 보게 됩니다.
이를 해결하기 위한 방안은 크게 세가지입니다.
2-1) Sticky Session
nginx에서 같은 사용자의 요청을 항상 같은 인스턴스로 보내는 방안입니다. 사용자별 데이터인 읽은 목록은 한 인스턴스의 캐시만 보게 되므로 불일치 문제 자체가 사라지고, TTL 만료 시점에 최신화된 데이터가 캐싱됩니다.
하지만, 게시글 목록 같은 공통 데이터는 모든 인스턴스에서 무효화해야 함으로 sticky session만으로는 해결이 불가능하며, 요청 단위가 아니라 사용자 단위로 라우팅이 고정되므로 인스턴스 간 부하가 균등하지 않아 TPS의 저하가 나타날 수 있습니다. 또한, 트래픽이 특정 인스턴스에 몰려 과부하문제가 발생할 수 있는 가능성이 있습니다.
2-2) Global Cache
로컬 캐시를 버리고 Redis 하나를 모든 인스턴스가 공유하는 방안입니다. 갱신 즉시 모든 인스턴스가 최신 데이터를 보게 되어 정합성은 가장 좋습니다.
대신 조회 트래픽 전체가 Redis 한 곳으로 몰리게 되어 Redis의 처리량이 곧 서비스 전체의 상한이 됩니다.
2-3) 이벤트 기반 Local Cache 갱신
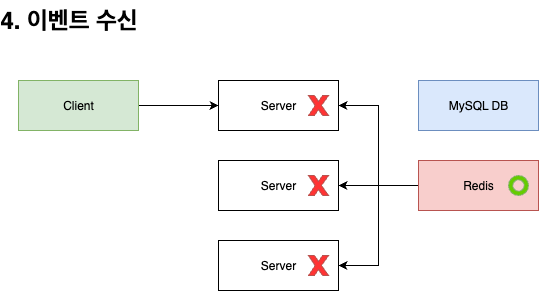
조회는 로컬 캐시 그대로 두고 데이터 변경이 있을 때만 이벤트를 발행해 모든 인스턴스가 자기 캐시를 갱신하는 방안입니다. 조회 경로에 네트워크 홉이 없어 응답 속도를 유지하면서, 공통 데이터와 사용자별 데이터 모두 같은 방식으로 갱신할 수 있습니다.
대신 이벤트 전파가 비동기이므로 이벤트 전달이 지연되는 동안은 stale 데이터가 노출됩니다.
결정: (3) 이벤트 기반 Local Cache 갱신
(1)은 공통 데이터 문제를 풀지 못한 채 부하 불균등이라는 비용만 추가되고, (2)는 티켓팅이나 선착순 이벤트처럼 실시간성이 중요한 경우라면 적합하겠지만 게시글 조회에는 과합니다. 게시글 조회는 어느정도의 지연이 허용되는데, 특히 읽은 목록은 사용자가 게시글을 읽고 나서 목록으로 돌아오기까지 수 초가 걸리므로 그 사이에 이벤트만 전달되면 사용자는 차이를 느끼지 못할거라 판단했습니다.
따라서 (3)을 택해 로컬 캐시의 빠른 응답 속도를 유지하면서, Redis나 DB 같은 외부 저장소로 조회 부하가 전파될 위험도 함께 피했습니다.
3. 캐시 갱신 최적화
이벤트를 받은 각 인스턴스가 로컬 캐시의 최신 게시글 목록과 읽은 사용자 목록를 어떻게 갱신할지 결정해야 했습니다.
(1) refresh
이벤트를 받으면 DB에 최신 데이터를 쿼리하여 캐시를 채우는 방식입니다.
캐시된 데이터가 여러 원본이 조합된 결과라 이벤트만으로 다음 상태를 만들 수 없어, DB 없이 인스턴스가 재현하기 어려운 경우에 어울립니다. 원본을 다시 읽어오므로 이벤트가 일부 유실되어도 다음 refresh 때 자연히 맞춰진다는 장점이 있습니다.
대신 이벤트 1건마다 N개의 인스턴스가 각각 원본을 조회하므로, 쓰기 1건이 N건의 읽기로 증폭됩니다. 이벤트 빈도가 낮을 땐 문제가 없지만, 초당 수천건씩 발생하는 이벤트에 refresh를 붙이면 인스턴스를 늘릴수록 DB 부하가 배로 늘어 스케일 아웃의 의미가 없어집니다.
따라서, "변경 빈도는 낮지만 재구성이 복잡한 데이터"에 적합한 방식입니다.
(2) 이벤트 페이로드로 갱신
캐시 갱신을 위해 DB에 접근하지 않고, 이벤트에 담긴 값만으로 캐시를 직접 수정하는 방식입니다.
캐시의 다음 상태를 이벤트 페이로드만으로 만들 수 있고 멱등할 때 어울립니다. 갱신에 조회가 아예 없어서 이벤트가 초당 수천건씩 발생해도 DB와 Redis에 부하가 전파되지 않고, 인스턴스를 늘려도 원본 부하는 그대로입니다.
대신 원본을 다시 읽는 과정이 없으므로 이벤트가 유실되어선 안됩니다. 이벤트를 하나라도 놓치면 그 인스턴스의 캐시는 TTL이 만료될 때까지 스스로 복구할 방법이 없습니다.
따라서, "변경 빈도는 높지만 상태 전이가 단순한 데이터"에 적합하며, 이벤트 유실을 막을 장치가 함께 필요합니다.
데이터 특성에 맞게 적용
데이터의 특성에 맞춰 다른 방향으로 캐싱하도록 결정했습니다. 읽은 목록은 "집합에 원소 추가"라 페이로드로 다음 상태를 만들 수 있지만, 게시글 목록은 게시글 추가/삭제 시 정렬과 페이징이 얽힌 목록 전체가 바뀜으로 페이로드만으로 재구성할 수 없습니다.
읽은 사람 목록(User Specific): 이벤트 페이로드로 로컬 집합에 직접 add게시글 목록(Global): 이벤트 수신 시 DB를 통해 refresh
4. 게시글 목록 조회 부하 완화 - 2 Level Caching
이벤트 기반 캐시 갱신 기능을 적용하고, ngrinder의 @RunRate를 활용해 전체 요청의 1/10 비율로 write를 포함하여 테스트를 진행했습니다.
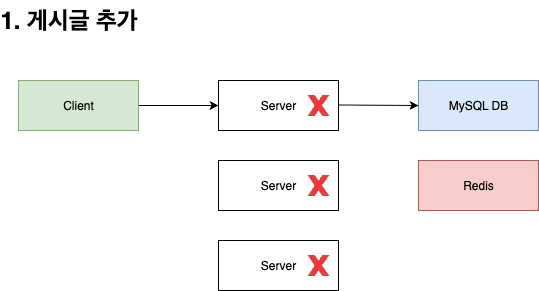
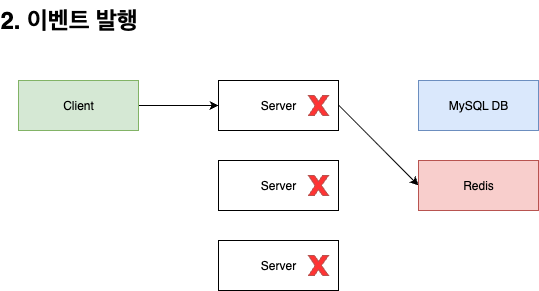
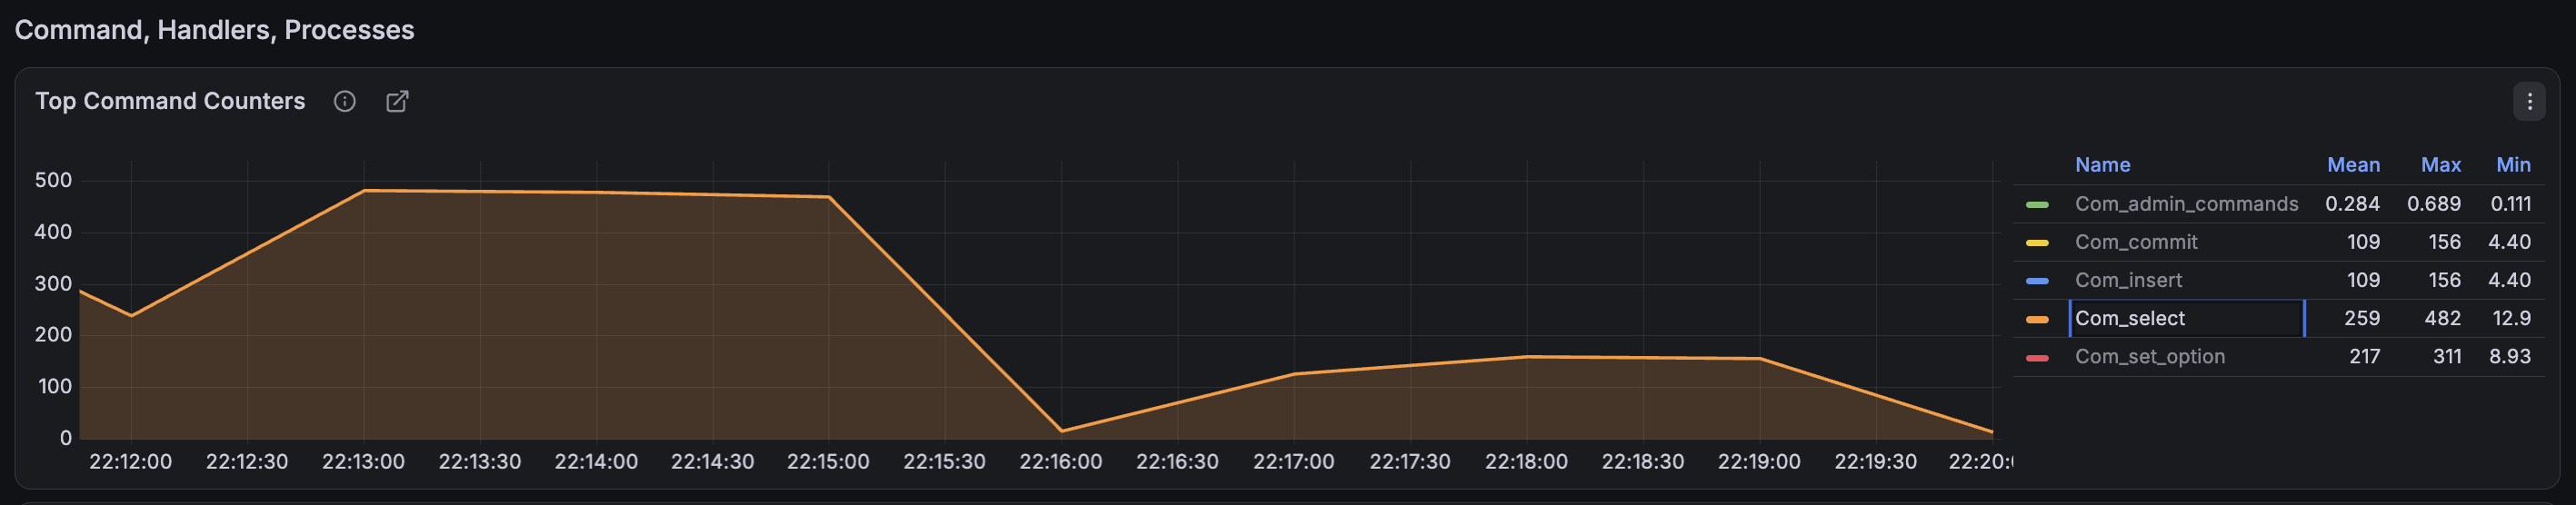
문제. DB에 순간적인 과부하 가능성 문제
게시글이 추가될 때마다 MySQL 읽기 QPS가 순간적으로 치솟았습니다. 현재 구조에서는 쓰기 이벤트가 발생하면 이벤트를 받은 N개의 인스턴스가 각자 DB를 조회해 로컬 캐시를 갱신하기 때문입니다. 쓰기 1건이 DB 읽기 N건으로 증폭되는 구조라 쓰기 트래픽이나 인스턴스 수가 늘어날수록 DB가 받는 순간 부하도 그에 비례해 커지고, 같은 DB를 쓰는
다른 서비스까지 영향을 받을 수 있습니다.
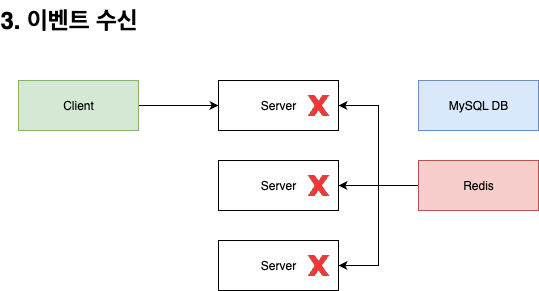
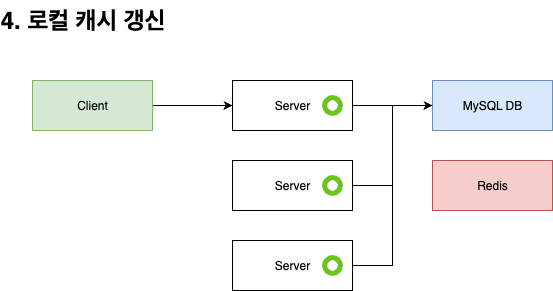
해결. 2-Level Cache 도입
이를 막기 위해 게시글을 추가/삭제한 인스턴스가 갱신된 목록 데이터를 이벤트 발행 전에
Redis에 적재해 두고, 이벤트를 받은 인스턴스는 DB 대신 Redis에서 읽도록 했습니다. DB에는 쓰기 1건과L2 적재를 위한 읽기 1건만 가고, N번의 refresh 읽기는 평균 처리량이 RDB를 훨씬 상회하는
Redis가 받음으로, 쓰기 1건당 DB 읽기가 N건 → 1건으로 줄어드는 셈입니다.
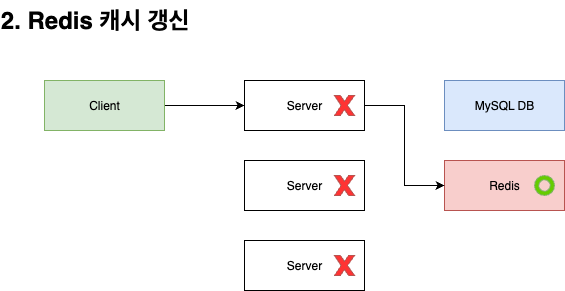
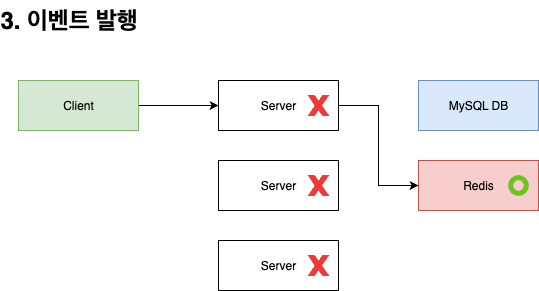
(적용 전후 DB QPS 그래프) 1/2이상 줄어든것을 확인할 수 있습니다.
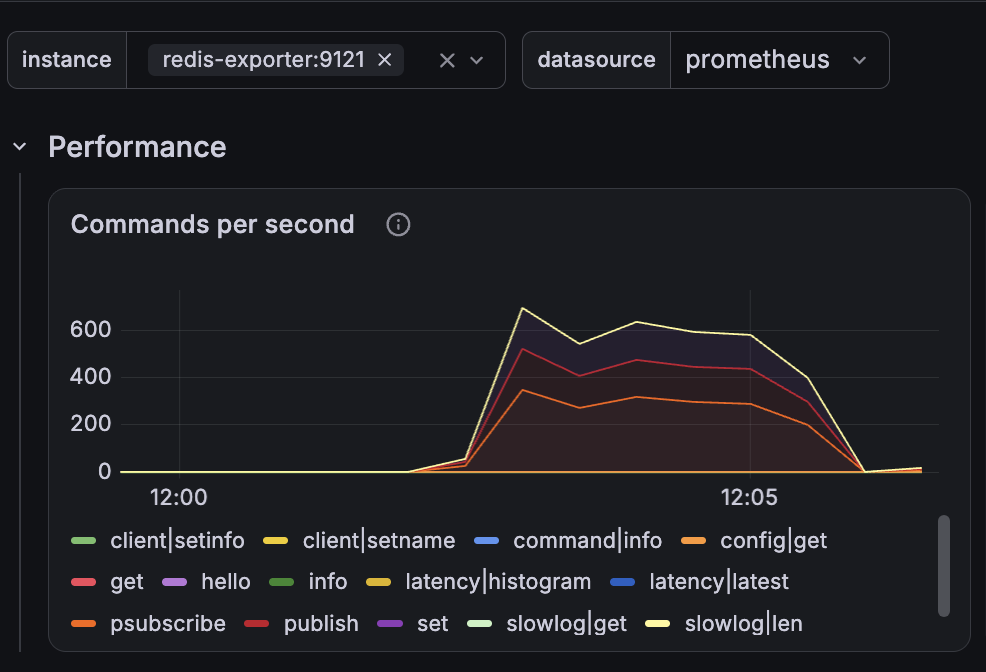
Redis 사용 형태
Redis 지표를 보면 쓰기 1건마다 SET(L2 적재)과 PUBLISH(갱신 이벤트)가 1건씩 나가고,
각 인스턴스의 refresh 읽기가 GET으로 잡히는 것을 확인할 수 있습니다. 이벤트 수신 시
발생하던 캐시 갱신용 DB 읽기가 그대로 Redis로 이동한 것입니다. 덕분에 DB는 본래의
쓰기만 감당하면 되고, 쓰기 비율이나 인스턴스 수가 늘어도 DB 부하가 증폭되지 않는
구조가 되었습니다.
정리
- CPU 한계로 멈춘 TPS를 스케일 아웃(2 인스턴스 + nginx)으로 1,851.6 → 2,829.7까지 끌어올렸습니다.
- 다중 인스턴스에서 발생하는 로컬 캐시 불일치는 이벤트 기반 갱신으로 해결하되, 데이터 특성에 따라 갱신 전략을 나눴습니다 — 상태 전이가 단순한
읽은 목록은 페이로드로 직접 갱신, 재구성이 복잡한게시글 목록은 refresh. - refresh가 만드는 "쓰기 1건 → DB 읽기 N건" 증폭은 L2(Redis)를 두어 DB 읽기 1건으로 줄였고, 갱신 부하가 인스턴스 수에 비례하지 않는 구조를 만들었습니다.
