AI Coding Agent를 사용하는 방식이 빠르게 바뀌고 있다.
예전에는 “어떤 프롬프트를 입력해야 더 좋은 답을 얻을까?”가 중요했다면, 이제는 Agent가 코드를 읽고, 도구를 실행하고, 테스트하고, 실패하면 다시 시도하는 작업 환경과 실행 구조 자체가 중요해지고 있다.
이 흐름을 이해할 때 다음과 같이 보면 꽤 직관적이다.
Prompt → Context → Harness → Loop → Graph
다만 이 순서는 공식적으로 정의된 기술 발전 단계는 아니다. “앞의 개념이 사라지고 다음 개념으로 대체된다”기보다는 AI에게 맡기는 작업의 범위가 넓어지면서 설계 대상도 함께 확장되고 있다고 보는 편이 정확하다.
1. 시작은 Prompt Engineering이었다
초기의 AI 활용에서는 한 번의 요청을 얼마나 잘 작성하는지가 중요했다.
예를 들어 Codex에게 다음과 같이 요청한다고 해보자.
User 조회 API를 만들어줘.요구사항이 부족하면 결과도 모호해진다.
그래서 역할, 제약 조건, 출력 형태 등을 프롬프트에 상세히 넣기 시작했다.
Spring Boot 환경에서 User 조회 API를 구현해줘.

조건:
- Controller / Service / Repository 구조를 따른다.
- 기존 응답 형식을 유지한다.
- Unit Test를 작성한다.
- 기존 테스트를 깨뜨리지 않는다.
이것이 Prompt Engineering의 영역이다.
핵심 질문은 단순하다.
AI에게 무엇을 어떻게 말할 것인가?
2. Prompt만으로는 부족했다 — Context Engineering
Coding Agent가 실제 프로젝트를 수정하기 시작하면서 좋은 프롬프트만으로는 한계가 생겼다.
Agent가 아무리 똑똑해도 프로젝트의 구조나 기존 규칙을 모르면 엉뚱한 코드를 만들 수 있기 때문이다.
예를 들어 Agent가 다음 내용을 알아야 할 수도 있다.
- 프로젝트 아키텍처
- 기존 코드
- API 규칙
- DB Schema
- 테스트 코드
- 팀의 Coding Convention
- 이전 작업 내용
- 현재 Git Diff
그래서 관심사가 프롬프트 자체에서 모델이 판단할 때 볼 수 있는 정보 전체로 확장됐다.
이것이 Context Engineering이다.
핵심 질문은 다음과 같다.
AI에게 무엇을 보여줄 것인가?
Context Engineering에서는 무조건 많은 정보를 넣는 것이 좋은 것도 아니다.
OpenAI의 Codex 팀 역시 거대한 하나의 AGENTS.md에 모든 정보를 넣는 방식을 사용했다가, Context를 과도하게 차지하고 오래된 규칙이 쌓이는 문제가 있었다고 설명한다. 이후 짧은 AGENTS.md를 지도처럼 사용하고 필요한 문서로 이동하는 구조를 사용했다.
즉,
많은 Context보다
현재 작업에 필요한 Context가 중요하다.
3. 그런데 Context만 잘 줘도 부족했다 — Harness Engineering
여기서 중요한 개념이 하나 더 등장한다.
바로 Harness Engineering이다.
Context Engineering이 Agent에게 어떤 정보를 제공할지를 다룬다면 Harness Engineering은 한 단계 더 넓다.
Agent가 실제로 일할 수 있도록 환경, 도구, 규칙, 검증 방법을 설계하는 것이다.
OpenAI는 2026년 2월 Codex를 이용해 내부 제품을 개발한 경험을 Harness Engineering이라는 이름으로 공개했다.
흥미로운 점은 초기 Codex의 문제가 모델 능력 자체가 아니었다는 것이다.
Agent에게
- 필요한 도구가 없거나
- 프로젝트 구조가 명확하지 않거나
- 검증 방법이 없거나
- 실행 결과를 직접 확인할 수 없는
환경에서는 높은 수준의 목표를 줘도 안정적으로 작업하기 어려웠다.
OpenAI는 이를 해결하기 위해 Repository 구조, 문서, 테스트, Linter, Worktree, 로그·메트릭, UI 조작 도구 등을 Agent가 직접 사용할 수 있도록 만들었다.
Codex 기준으로 생각하면 다음과 같은 것들이 Harness의 일부가 될 수 있다.
AGENTS.md
docs/
Skills
MCP / Connector
Shell
Git
Worktree
Test Runner
Linter
Browser
Logs
Metrics
CI
Permission / Sandbox
예를 들어 다음처럼 구성할 수 있다.
Codex

+ AGENTS.md
+ 프로젝트 문서
+ DB 조회 도구
+ Git
+ 테스트 실행 환경
+ Linter
+ Browser
+ Worktree
+ 검증 Script
이제 Agent는 단순히 코드를 생성하는 모델이 아니라 실제 개발 환경 안에서 작업하는 Agent가 된다.
Harness Engineering의 핵심 질문은 다음과 같다.
AI가 어떤 환경에서 어떤 도구와 규칙을 가지고 일하게 할 것인가?
Context와 Harness는 무엇이 다를까?
둘은 겹치는 부분이 많지만 관점을 나누면 이해하기 쉽다.
| 구분 | 핵심 질문 | 예시 |
|---|---|---|
| Prompt | 무엇을 말할까? | 작업 요청 |
| Context | 무엇을 보여줄까? | 코드, 문서, 상태, 메모리 |
| Harness | 어떤 환경에서 일하게 할까? | Tools, Skills, Test, Git, Sandbox, 규칙 |
예를 들어 ARCHITECTURE.md의 내용 자체를 Agent가 읽는 것은 Context다.
반면 Agent가 필요할 때 해당 문서를 찾아 읽도록 Repository 구조와 AGENTS.md를 구성하는 것은 Harness 설계에 가깝다.
실제 시스템에서는 이 경계가 명확히 나뉘기보다는 서로 겹친다.
4. Harness 다음에는 Loop Engineering이 등장했다
Harness가 잘 만들어지면 Agent는 혼자서 상당히 많은 작업을 수행할 수 있다.
그런데 여전히 사람이 다음 작업을 계속 지시한다면 어떨까?
개발자
 ↓
Codex에게 구현 요청
 ↓
Codex 구현
 ↓
개발자 테스트 확인
 ↓
"테스트 실패했어. 고쳐줘."
 ↓
Codex 수정
 ↓
개발자 다시 확인
AI를 사용하고 있지만 실제 Workflow의 제어자는 여전히 사람이다.
Addy Osmani는 이를 한 단계 더 자동화한 개념을 Loop Engineering이라고 설명한다.
흥미롭게도 그의 표현으로는 Loop Engineering이 “Harness보다 한 층 위에 있다”.
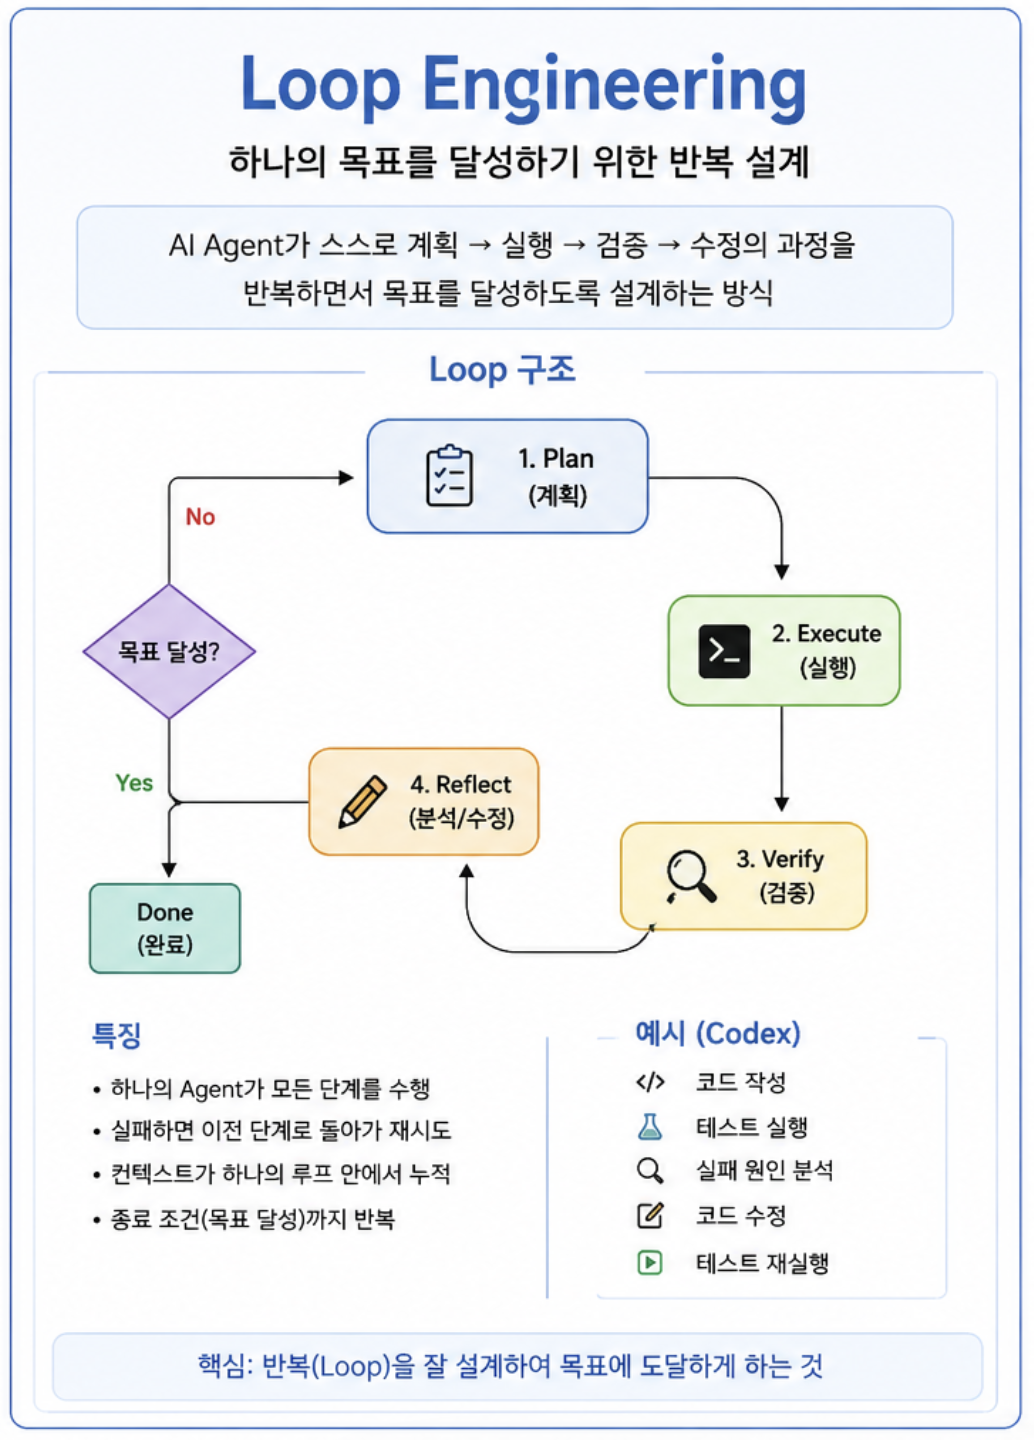
Harness가 하나의 Agent가 작업하는 환경을 만든다면, Loop는 그 환경에서 Agent가 목표를 달성할 때까지 반복하는 시스템을 만든다.
예를 들어 Codex에게 다음 목표를 준다고 해보자.
User 조회 API를 구현하고
관련 테스트가 모두 통과할 때까지 작업한다.
Loop는 다음처럼 동작할 수 있다.
목표 확인

→ 코드 분석
→ 구현
→ 테스트
→ 결과 검증

테스트 실패
→ 원인 분석
→ 수정
→ 다시 테스트

테스트 성공
→ 완료
이때 중요한 것은 단순한 무한 반복이 아니다.
좋은 Loop에는 반드시 다음과 같은 제어가 필요하다.
- Goal
- 상태 저장
- Verification
- Retry 조건
- Stop Condition
- 비용 / 시간 제한
- 실패 처리
- Human Escalation
예를 들어 같은 테스트를 계속 실패한다면 일정 횟수 이후 사람에게 넘길 수 있어야 한다.
retry >= 3
→ Human Review
즉, Loop Engineering의 핵심 질문은
AI가 어떻게 반복해서 목표에 도달하게 할 것인가?
이다.
5. 그런데 하나의 Loop가 너무 많은 일을 하기 시작했다
Loop는 강력하다.
하지만 Agent에게 더 큰 업무를 맡기면 문제가 생긴다.
예를 들어 다음 작업을 Codex에게 맡긴다고 해보자.
사용자 권한 시스템을 개편한다.

- 기존 권한 구조 분석
- DB Schema 변경
- Backend 수정
- Frontend 수정
- Migration 작성
- 테스트
- 보안 검토
- Regression Test
하나의 Agent Loop가 이 작업을 모두 수행할 수도 있다.
문제는 작업 규모가 커질수록 하나의 Loop에 너무 많은 책임이 모인다는 것이다.
문제 1. Context가 너무 커진다
하나의 Agent가 모든 작업을 수행하면 Context에 다음 정보가 계속 쌓인다.
요구사항
Backend 코드
Frontend 코드
DB Schema
Migration
테스트 로그
에러 로그
수정 이력
Review 결과
...
현재 작업과 관계없는 정보까지 함께 들어오면서 중요한 Context가 묻힐 수 있다.
문제 2. 역할이 너무 많아진다
하나의 Agent가 동시에
- 설계자
- Backend 개발자
- Frontend 개발자
- DBA
- Tester
- Reviewer
역할을 하게 된다.
특히 자신이 작성한 코드를 자신이 다시 검증하는 구조는 독립적인 검증이라는 측면에서도 한계가 있다.
문제 3. 병렬로 할 수 있는 작업도 순차적으로 처리된다
Backend 영향도 분석과 Frontend 영향도 분석이 서로 독립적이라면 동시에 수행할 수 있다.
하지만 하나의 Loop에서는 대부분 한 작업이 끝난 후 다음 작업으로 넘어간다.
문제 4. 작업마다 필요한 권한과 종료 조건이 다르다
예를 들어 구현 Agent는 코드를 수정할 수 있어야 한다.
반면 Review Agent는 코드를 수정하지 않고 문제점만 반환하도록 만들고 싶을 수 있다.
DB Migration은 최종 적용 전에 반드시 Human Approval을 요구할 수도 있다.
하나의 Agent에게 모든 권한을 주는 것보다 역할별로 분리하는 것이 안전하다.
6. 여기서 Graph Engineering이 나온다
이런 문제 때문에 관심사가 하나의 Loop를 잘 만드는 것에서 여러 작업을 어떻게 연결할 것인가로 확장된다.
이를 최근 Graph Engineering이라고 부르기 시작했다.
2026년 현재 Graph Engineering은 아직 정식 표준 용어는 아니지만, 일반적으로 여러 Agent 또는 Workflow Node 사이의
- Dependency
- Handoff
- Parallel Execution
- Join
- Shared State
- Permission
- Failure Propagation
등을 설계하는 문제를 의미한다.
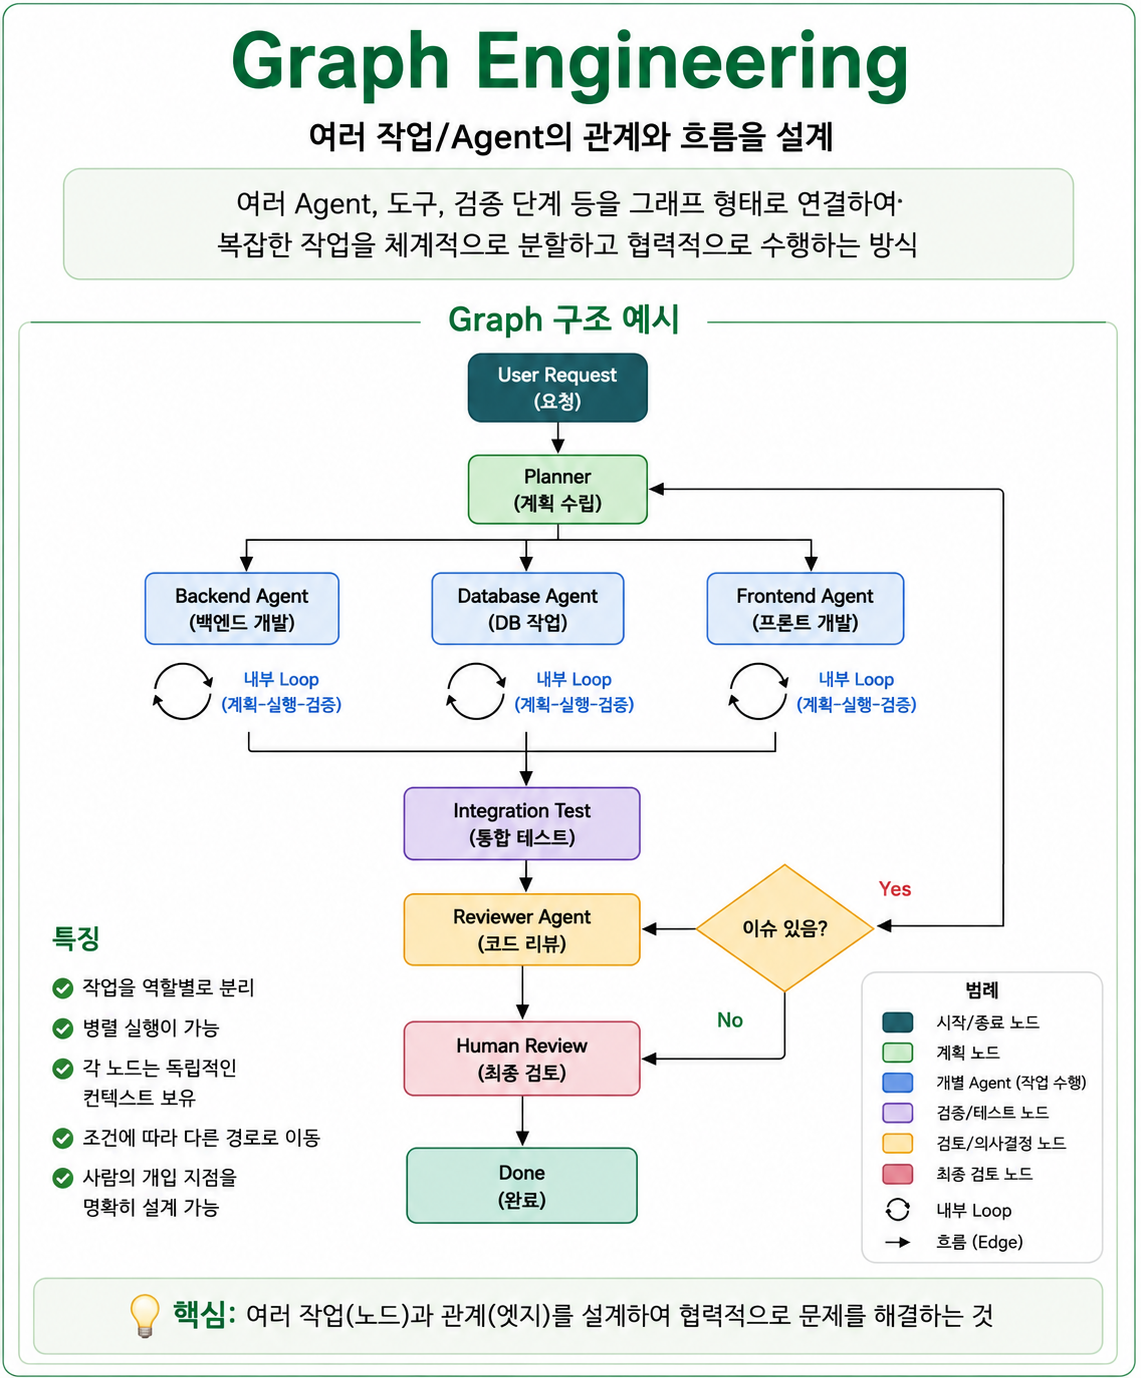
Graph Engineering의 핵심 질문은 다음과 같다.
여러 Agent와 Loop가 어떻게 역할을 나누고 협력하게 할 것인가?
7. Graph는 Loop를 대체하지 않는다
이 부분이 가장 중요하다.
Graph Engineering이 등장했다고 해서 Loop Engineering이 필요 없어지는 것이 아니다.
오히려 Graph의 각 Node 내부에 Loop가 들어갈 수 있다.
예를 들어 전체 Workflow가 다음과 같다고 해보자.
Planner → Backend / DB / Frontend 병렬 실행 → Integration Test → Reviewer → Human Approval
여기서 Backend Agent만 확대해서 보면 내부에서는 다시 Loop가 돈다.
Backend Agent

분석
→ 구현
→ 테스트
→ 실패
→ 수정
→ 테스트
→ 성공
DB Agent 역시 자신만의 Loop를 가질 수 있다.
Frontend Agent도 마찬가지다.
따라서 관계를 단순화하면 다음과 같다.
Harness
  ↓
Agent가 일할 수 있는 환경

Loop
  ↓
하나의 Agent가 목표까지 반복하는 구조

Graph
  ↓
여러 Loop가 협력하는 구조
실제로 Graph Engineering을 설명하는 최근 자료에서도 “하나의 Loop가 모든 Context, Tool, 전문성, 작업을 떠안아서는 안 될 때 Graph가 유용하다”고 설명한다.
8. 그렇다면 AI Engineering은 어떻게 확장되고 있는가?
지금까지의 내용을 한 문장씩 정리하면 다음과 같다.
Prompt Engineering
AI에게 무엇을 말할 것인가?
Context Engineering
AI에게 무엇을 보여줄 것인가?
Harness Engineering
AI가 어떤 환경과 도구 안에서 일하게 할 것인가?
Loop Engineering
AI가 어떻게 반복하며 목표까지 도달하게 할 것인가?
Graph Engineering
여러 AI 작업이 어떻게 역할을 나누고 협력하게 할 것인가?
이 흐름에서 중요한 것은 새로운 용어가 이전 용어를 대체하지 않는다는 점이다.
Graph가 있어도 좋은 Context가 필요하다.
좋은 Context가 있어도 Agent가 테스트할 수 있는 Harness가 없다면 불안정하다.
Harness가 있어도 사람이 계속 다음 행동을 지시해야 한다면 자율성이 제한된다.
Loop가 있어도 하나의 Loop에 모든 역할을 넣으면 Context와 권한, 병렬성 문제가 생긴다.
결국 각각은 서로 다른 문제를 해결한다.
9. 모든 작업에 Graph가 필요한 것은 아니다
Graph Engineering이라는 단어가 새롭게 등장했다고 해서 무조건 Multi-Agent 구조를 만들어야 하는 것은 아니다.
예를 들어 단순한 NullPointerException 수정이라면
분석
→ 수정
→ 테스트
→ 완료
정도의 단일 Loop가 훨씬 효율적이다.
Graph는 다음 상황에서 고려할 가치가 있다.
- 작업을 독립적인 단위로 나눌 수 있을 때
- 병렬 실행의 효과가 클 때
- 역할마다 필요한 Context가 크게 다를 때
- Tool이나 Permission을 격리해야 할 때
- 독립적인 Reviewer가 필요할 때
- 서로 다른 종료 조건을 적용해야 할 때
반대로 Node를 많이 만드는 것 자체가 목적이 되어서는 안 된다.
Agent가 늘어나면 그만큼
- Token 비용
- Handoff 비용
- 상태 관리
- 충돌 처리
- 실패 경로
도 함께 늘어나기 때문이다. Graph Engineering 관련 자료 역시 단순한 조직도처럼 Agent를 늘리는 대신, 분리했을 때 실제로 병렬성·Context 격리·권한 제어 등의 이점이 있는지를 먼저 확인해야 한다고 강조한다.
마무리
최근 Coding Agent의 발전을 보면서 가장 흥미로운 점은 개발자가 설계하는 대상 자체가 변하고 있다는 것이다.
과거에는 좋은 코드를 직접 작성하는 것이 개발자의 중요한 역할이었다.
AI Coding Agent 초기에는 좋은 프롬프트를 작성하는 것이 중요해졌다.
이제는 한 단계 더 나아가
Context
Tools
Rules
Verification
Environment
Loop
Agent Graph
Human Gate
를 설계하는 일이 중요해지고 있다.
OpenAI의 Harness Engineering 사례에서도 사람의 역할을 환경을 설계하고 의도를 명확히 하며 Agent가 신뢰성 있게 일할 수 있는 Feedback Loop를 만드는 것으로 설명한다.
Graph Engineering도 결국 같은 흐름의 연장선이라고 생각한다.
좋은 프롬프트를 작성하는 것에서
AI가 안정적으로 일할 수 있는 시스템을 설계하는 것으로.
그리고 그 시스템의 규모가 하나의 Agent를 넘어 여러 Agent와 Workflow로 커지기 시작할 때, Graph Engineering이 필요한 이유도 자연스럽게 보이기 시작한다.
참고 자료
- Addy Osmani, Loop Engineering, 2026-06-07
- OpenAI — Unrolling the Codex agent loop, 2026-01-23
Loop Engineering,Graph Engineering은 2026년 현재 아직 표준화된 소프트웨어 공학 용어가 아니다. 이 글에서는 최근 Agent Engineering 분야에서 사용되는 의미를 기준으로 설명했다.