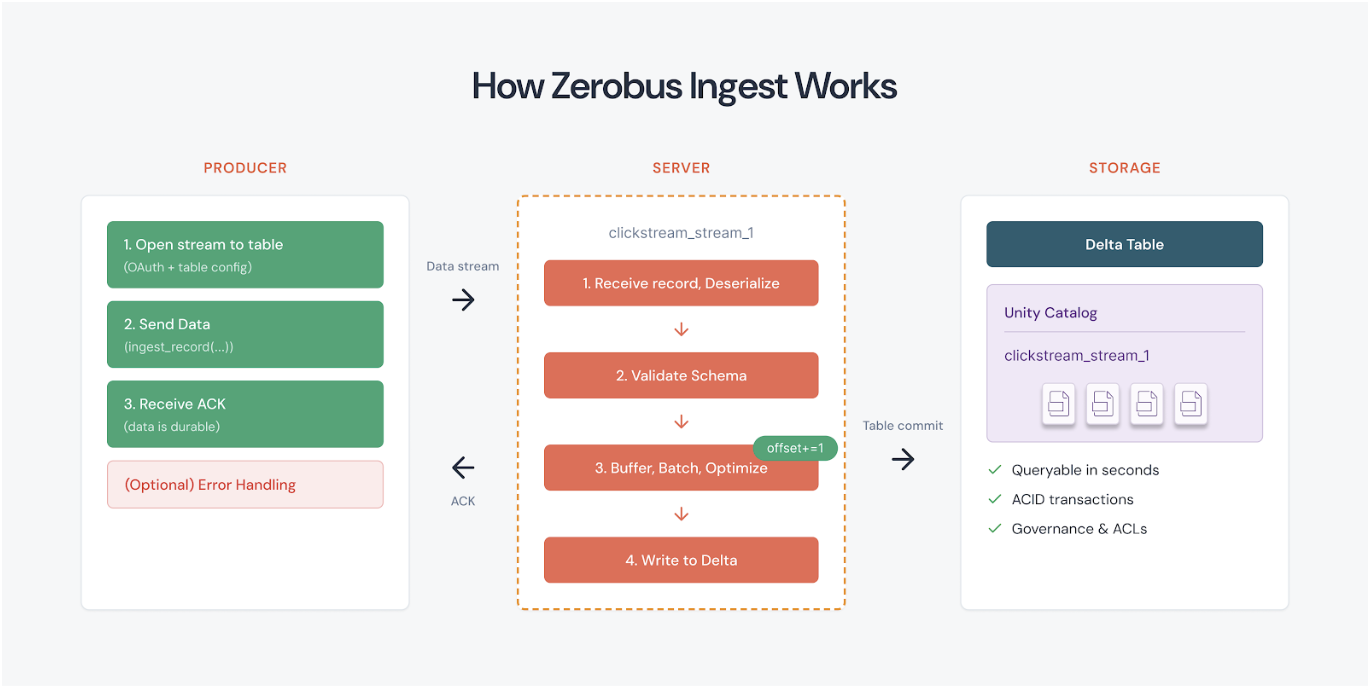
실시간 이벤트 데이터를 레이크하우스로 넣을 때 많은 팀이 보통 Kafka 같은 메시지 버스를 먼저 떠올립니다. 그런데 Databricks는 이 중간 계층 자체를 줄이는 방향으로 Zerobus Ingest를 내놓았습니다. Zerobus Ingest는 프로듀서가 데이터를 직접 Unity Catalog 기반 Delta 테이블로 밀어 넣는 push 기반 서버리스 수집 서비스로, 브로커나 파티션을 직접 운영하지 않아도 되는 것이 핵심입니다. Source
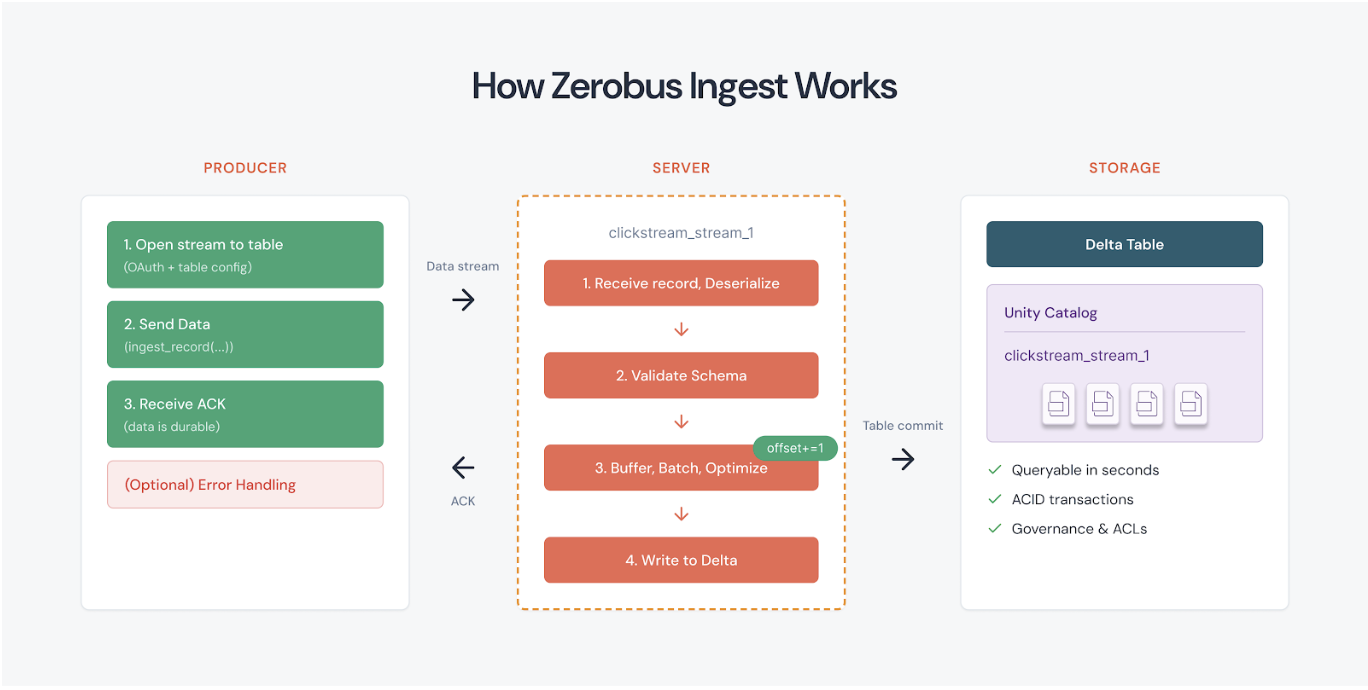
이미지 출처: Databricks Docs - Zerobus Ingest connector overview
왜 이름이 “ZeroBus”일까
Databricks가 강조하는 포인트는 단순합니다. 기존 스트리밍 아키텍처는 대개 소스 시스템 → 메시지 버스 → 스키마 레지스트리/커넥터 → 레이크하우스처럼 중간 계층이 여러 개 들어가는데, Zerobus Ingest는 이를 소스 시스템 → Zerobus Ingest → Lakehouse로 줄이겠다는 접근입니다. Databricks는 이 구조가 운영 복잡도, 저장소 중복, 장애 지점, 전담 운영 인력 부담을 줄인다고 설명합니다. Source

이미지 출처: Databricks Blog - Announcing General Availability of Zerobus Ingest
Zerobus Ingest가 정확히 하는 일
공식 문서 기준으로 Zerobus Ingest는 Unity Catalog의 관리형 Delta 테이블에 직접 데이터를 쓰는 push 기반 ingestion API입니다. 서버리스 방식이라 연결 수가 늘어나면 자동으로 확장되고, 사용자는 Kafka처럼 브로커 수나 파티션 수를 직접 설계할 필요가 없습니다. 데이터는 먼저 서비스 내부 버퍼에 내구성 있게 저장된 후, 최적화된 방식으로 Delta 테이블에 반영됩니다. Source
조금 더 쉽게 말하면, 애플리케이션이나 디바이스, 수집 에이전트가 Zerobus 엔드포인트로 이벤트를 보내면 Databricks가 이를 받아 스키마 검증, 내구성 확보, Delta 테이블 반영까지 처리해주는 구조입니다. 이때 테이블 스키마는 Zerobus가 임의로 만들지 않고, 사용자가 미리 만들어 둔 Unity Catalog 테이블이 기준이 됩니다. Source
어떤 상황에서 쓰기 좋은가
Zerobus Ingest는 특히 최종 목적지가 Databricks 레이크하우스 하나일 때 강점이 큽니다. Databricks는 IoT 텔레메트리, 클릭스트림, 애플리케이션 로그, 운영 이벤트, 보안 이벤트, 공장 센서 데이터 같은 near real-time 수집 시나리오를 대표 사용 사례로 제시합니다. 중간 버스를 범용 허브처럼 운영할 필요 없이, 수집 즉시 분석/AI/거버넌스가 가능한 Delta 테이블로 보내는 것이 핵심 가치입니다. Source
반대로 말하면, 여러 다운스트림 시스템으로 fan-out 해야 하거나, 메시지 버스 자체의 소비자 그룹 패턴이 중요한 환경이라면 기존 Kafka 계열이 더 적합할 수도 있습니다. Zerobus는 Databricks가 말하듯이 single-sink architecture, 즉 레이크하우스로 직접 넣는 목적에 최적화된 설계입니다. Source
핵심 장점
1. 메시지 버스 운영이 없다
Databricks는 Zerobus Ingest의 가장 큰 장점으로 브로커 없음, 파티션 튜닝 없음, 컨슈머 그룹 운영 없음, 클러스터 업그레이드 없음을 내세웁니다. 즉 Kafka 운영 지식이나 전용 운영팀 의존도를 줄일 수 있다는 뜻입니다. Source
2. Unity Catalog와 바로 연결된다
모든 쓰기가 Unity Catalog로 관리되는 Delta 테이블에 직접 들어가기 때문에, Databricks는 세분화된 접근 제어, 통합 거버넌스, 라인리지 측면에서도 이점을 강조합니다. 별도 임시 저장소나 중간 버스에 데이터가 머무는 시간이 줄어드는 점도 장점입니다. Source
3. 성능이 꽤 높다
공식 제한/가이드 기준으로 Zerobus는 스트림당 100MB/s, 테이블당 10GB/s, 스트림당 초당 15,000 레코드를 지원하며, Databricks는 near real-time 반영 시간이 보통 P50 5초 / P95 30초 수준의 table materialization, durability acknowledgment는 P50 200ms / P95 500ms라고 안내합니다. Source
Databricks 블로그에서는 더 공격적인 내부 벤치마크도 제시합니다. NASA NEOWISE 데이터를 활용한 테스트에서 24시간 내 1PB 수집, 단일 테이블 기준 12GB/s 지속 처리, 2,048 동시 워커, 1조 건 이상 레코드 수집 사례를 공개했습니다. 이는 제품의 지향점이 단순 API 수집기가 아니라, 대규모 실시간 ingestion 엔진이라는 점을 보여줍니다. Source
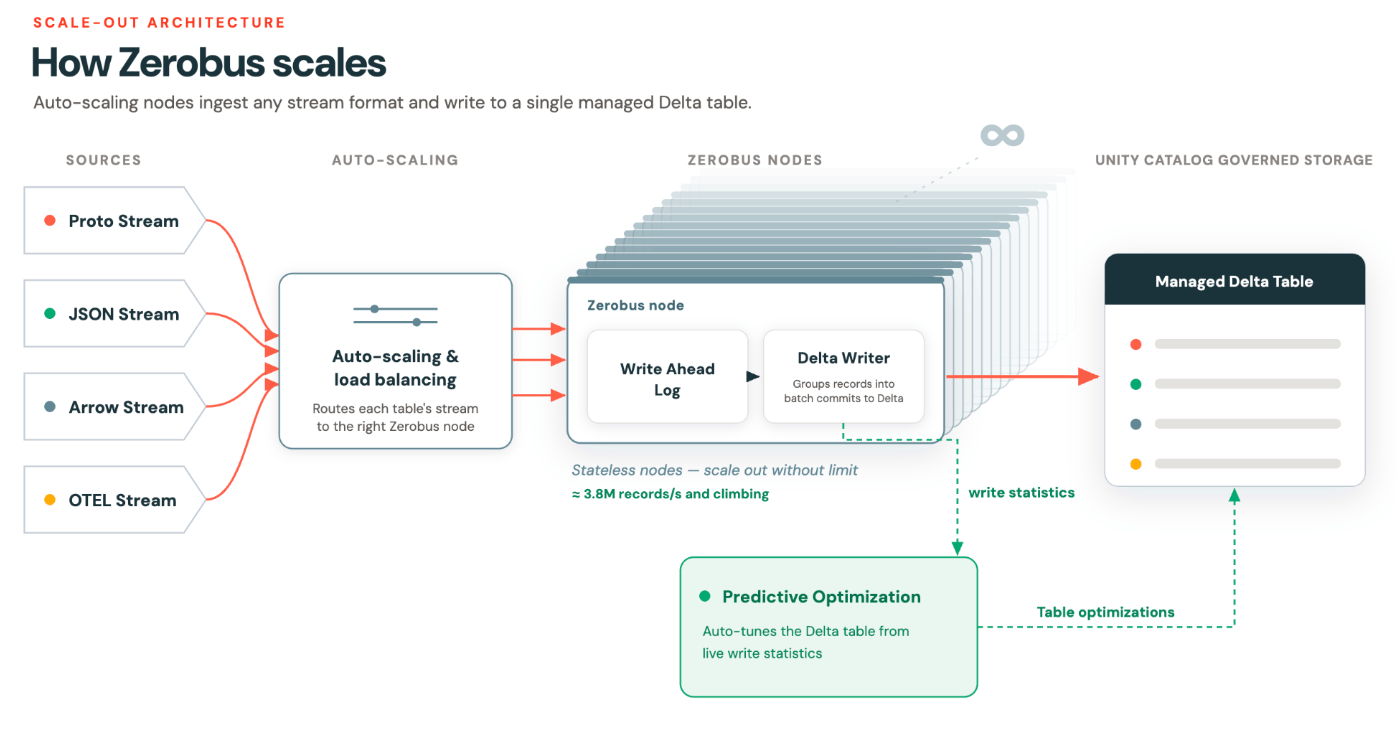
이미지 출처: Databricks Blog - Ingesting the Milky Way: Petabyte-Scale with Zerobus Ingest
지원 인터페이스는 무엇인가
Zerobus Ingest는 공식적으로 gRPC, REST, OTLP(OpenTelemetry) 를 지원합니다. Databricks SDK는 Python, Java, Rust, Go, TypeScript용으로 제공되며, gRPC 기반 장기 연결을 쉽게 다룰 수 있도록 도와줍니다. Source
인터페이스 선택 기준은 꽤 명확합니다.
- gRPC + SDK: 고처리량, 저지연, 지속 연결이 필요한 프로덕션 수집
- REST: 대규모 저빈도 디바이스나 웹훅처럼 stateless 요청이 더 자연스러운 경우
- OTLP: 이미 OpenTelemetry SDK/Collector를 쓰고 있다면 로그, 메트릭, 트레이스를 별도 커스텀 라이브러리 없이 바로 적재
- Arrow Flight: 컬럼형/배치 지향 워크로드에서 JSON/Proto 직렬화 오버헤드를 줄이고 싶을 때 Source Source Source
사용 전 꼭 알아둘 제약사항
Zerobus Ingest는 강력하지만, 아무 테이블에나 막 쓰는 구조는 아닙니다. 공식 제한 사항 중 실무적으로 중요한 것만 먼저 정리하면 다음과 같습니다. 관리형 Delta 테이블만 지원하고, 워크스페이스와 대상 테이블은 같은 지원 리전에 있어야 하며, private endpoint로 보호된 스토리지에는 쓰지 못합니다. 또 at-least-once 전달 보장만 제공하므로, 다운스트림에서 멱등성 전략이 필요할 수 있습니다. Source
또 하나 중요한 점은 스키마 자동 진화(auto-evolve)를 절대 하지 않는다는 것입니다. nullable 컬럼이 추가된 정도의 비파괴 변경은 허용되지만, 기본적으로 테이블 스키마와 들어오는 데이터 스키마가 맞아야 합니다. 메시지당 최대 크기는 10MB입니다. Source
Databricks Zerobus 사용법: 가장 기본적인 흐름
공식 문서 기준으로 시작 절차는 크게 4단계입니다.
- Zerobus endpoint 확인
- 대상 Unity Catalog Delta 테이블 생성
- 서비스 프린시펄 생성 및 권한 부여
- SDK 또는 API로 데이터 전송 시작 Source
1) 대상 테이블 만들기
Zerobus는 테이블을 자동 생성하지 않으므로 먼저 Unity Catalog에 테이블을 만들어야 합니다. Databricks 문서 예시는 아래와 같습니다. Source
CREATE TABLE unity.default.air_quality (
  device_name STRING,
  temp INT,
  humidity LONG
);
스트리밍 테이블로도 만들 수 있습니다. Source
CREATE STREAMING TABLE unity.default.air_quality (
  device_name STRING,
  temp INT,
  humidity LONG
);
2) 서비스 프린시펄과 권한 준비
Databricks는 개인 계정보다 서비스 프린시펄 + OAuth M2M 사용을 권장합니다. 그리고 카탈로그, 스키마, 테이블에 대해 최소한 아래 권한이 필요합니다: USE CATALOG, USE SCHEMA, MODIFY, SELECT. Source
GRANT USE CATALOG ON CATALOG <catalog> TO `<UUID>`;
GRANT USE SCHEMA ON SCHEMA <catalog.schema> TO `<UUID>`;
GRANT MODIFY, SELECT ON TABLE <catalog.schema.table_name> TO `<UUID>`;
3) 워크스페이스 URL과 Zerobus 엔드포인트 확인
워크스페이스 URL과 워크스페이스 ID를 알아낸 뒤, Zerobus 서버 엔드포인트는 다음 형태를 사용합니다. Source
<workspace-id>.zerobus.<region>.cloud.databricks.com예를 들어 region이 us-west-2 라면 대략 이런 형태입니다.
https://1234567890123456.zerobus.us-west-2.cloud.databricks.com4) Python SDK로 데이터 넣기
Databricks 공식 문서는 Python 3.9+ 환경에서 databricks-zerobus-ingest-sdk 설치 후 JSON 또는 Protocol Buffers 방식으로 적재할 수 있다고 안내합니다. JSON이 가장 간단하고, 프로덕션 row-oriented 워크로드에는 Protocol Buffers를 권장합니다. Source
pip install databricks-zerobus-ingest-sdk아래는 문서 예시를 바탕으로 이해하기 쉽게 정리한 기본 JSON 예제입니다. Source
from zerobus.sdk.sync import ZerobusSdk
from zerobus.sdk.shared import RecordType, StreamConfigurationOptions, TableProperties

SERVER_ENDPOINT = "https://1234567890123456.zerobus.us-west-2.cloud.databricks.com"
DATABRICKS_WORKSPACE_URL = "https://your-workspace.cloud.databricks.com"
TABLE_NAME = "main.default.air_quality"
CLIENT_ID = "your-client-id"
CLIENT_SECRET = "your-client-secret"

sdk = ZerobusSdk(SERVER_ENDPOINT, DATABRICKS_WORKSPACE_URL)

table_properties = TableProperties(TABLE_NAME)
options = StreamConfigurationOptions(record_type=RecordType.JSON)

stream = sdk.create_stream(
    CLIENT_ID,
    CLIENT_SECRET,
    table_properties,
    options
)

try:
    for i in range(10):
        record = {
            "device_name": f"sensor-{i}",
            "temp": 20 + i,
            "humidity": 50 + i
        }
        offset = stream.ingest_record_offset(record)
        stream.wait_for_offset(offset)  # 내구성 확인
finally:
    stream.close()
이 코드 흐름의 핵심은 간단합니다. 스트림 생성 → 레코드 전송 → offset ack 대기 → 종료입니다. Zerobus는 per-stream ordering을 보장하지만, 여러 스트림에 round-robin으로 뿌리면 전체 순서는 보장되지 않을 수 있습니다. Source
어떤 인터페이스를 선택해야 할까
실무에선 이 부분이 중요합니다.
JSON
빠르게 붙이기 가장 쉽습니다. 초기 PoC나 작은 이벤트 구조에는 편합니다. 다만 고성능 프로덕션에서는 protobuf나 Arrow Flight보다 비효율적일 수 있습니다. Source
Protocol Buffers
Databricks가 row-oriented 고처리량 프로덕션에 권장하는 방식입니다. 타입 안정성과 성능 면에서 균형이 좋습니다. 단, Delta 테이블 스키마와 protobuf 스키마가 사실상 1:1로 맞아야 합니다. Source Source
Arrow Flight
이미 Arrow 기반 배치나 컬럼형 데이터를 다루고 있다면 좋습니다. 넓은 스키마, 숫자 중심, 배치 전송에서 직렬화 오버헤드를 줄일 수 있어 Databricks도 이 경로를 별도 Beta 기능으로 제공합니다. Source
REST
많은 디바이스가 드물게 상태를 보내는 환경, 혹은 지속 연결이 부담인 환경에서 적합합니다. 대신 gRPC보다 request당 handshake 비용이 있으므로 고빈도/고처리량엔 불리합니다. Source
OTLP
이미 OpenTelemetry를 쓰고 있다면 가장 매력적인 경로입니다. 트레이스, 로그, 메트릭을 OTLP/gRPC로 바로 Delta 테이블에 넣을 수 있습니다. 다만 테이블은 미리 만들어야 하고, 요청당 대상 테이블은 하나이며, 현재는 OTLP/gRPC만 지원합니다. Source
운영 팁과 베스트 프랙티스
Zerobus는 “메시지 버스가 없어졌으니 아무 생각 없이 쓰면 된다”는 서비스는 아닙니다. 공식 문서 기준으로 실무에서 특히 중요한 팁은 다음과 같습니다.
첫째, 클라이언트와 엔드포인트를 같은 리전에 두는 것이 처리량 확보에 중요합니다. Databricks는 최고 처리량을 위해 동일 지리 리전 배치를 권장합니다. Source
둘째, 파티션 테이블은 주의해야 합니다. 5초 안에 100개 초과 파티션으로 쓰는 것은 지원되지 않으며, Databricks는 가능하면 partitioning보다 liquid clustering 사용을 권장합니다. liquid clustered table을 쓸 때는 predictive optimization을 켜 두는 것이 좋다고 설명합니다. Source
셋째, at-least-once 보장이므로 중복 허용/제거 전략을 꼭 고려해야 합니다. 데이터 수집 계층이 ack 전에 재시도하면 레코드 중복이 발생할 수 있으니, downstream 모델링이나 dedup 기준 키 설계가 필요합니다. Source
넷째, 스키마 변경은 신중해야 합니다. Zerobus는 스키마를 자동 진화시키지 않으며, 만약 내구성 확보 이후 테이블에 깨지는 변경이 생기면 서비스는 _zerobus/table_rejected_parquets/ 경로에 별도 Parquet로 남길 수 있습니다. Source
OpenTelemetry 수집에도 꽤 잘 맞는다
운영 로그, 메트릭, 트레이스를 Databricks로 모으고 싶은 팀이라면 Zerobus OTLP가 흥미롭습니다. 공식 문서에 따르면 Zerobus OTLP는 표준 OpenTelemetry Collector 서비스와 호환되는 엔드포인트를 제공하며, logs, metrics, traces를 각각 Delta 테이블로 적재할 수 있습니다. 기존 OpenTelemetry SDK나 Collector를 이미 쓰고 있다면, 별도 커스텀 수집기보다 훨씬 단순하게 연결할 수 있습니다. Source
그래서, Zerobus는 Kafka를 완전히 대체할까
이 질문에는 “상황에 따라 다르다”가 맞습니다. Databricks가 강조하는 것처럼 최종 목적지가 레이크하우스 하나이고, 실시간 분석/AI/거버넌스까지 Databricks 안에서 끝내고 싶다면 Zerobus는 매우 매력적입니다. 반면 여러 소비자 그룹, 재처리 패턴, 다중 싱크 브로드캐스트, 버스 중심 이벤트 플랫폼이 중요한 조직이라면 Kafka류 메시지 버스가 여전히 필요할 수 있습니다. Zerobus는 범용 이벤트 허브라기보다, Databricks 레이크하우스로의 직접 적재를 위한 고성능 ingestion 레이어로 이해하는 것이 가장 정확합니다. Source Source
정리
Databricks Zerobus Ingest는 “메시지 버스 없이 레이크하우스로 직접 넣자”는 철학의 실시간 수집 서비스입니다. Unity Catalog 기반 Delta 테이블로 직접 적재되기 때문에 거버넌스와 분석 연결성이 좋고, 서버리스 확장성과 높은 처리량도 장점입니다. 다만 모든 스트리밍 문제의 만능 해답은 아니고, 단일 싱크 중심, 관리형 Delta 테이블 중심, at-least-once, 명시적 스키마 관리라는 특성을 이해하고 도입해야 합니다. Databricks 중심 데이터 플랫폼을 운영한다면, 특히 IoT·로그·클릭스트림·운영 이벤트 수집에서 검토할 가치가 큰 옵션입니다. Source Source
참고 링크