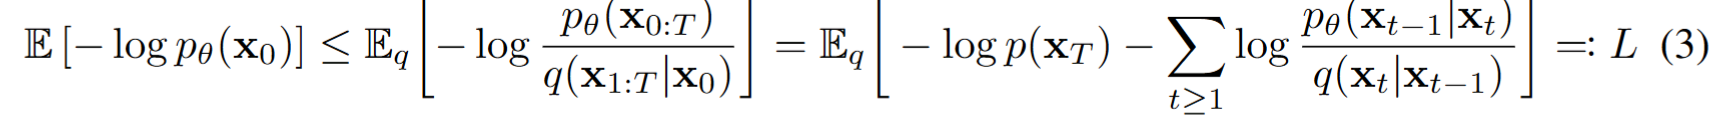
먼저, 앞에 보이는 수식(사진)은 DDPM 논문의 3번 수식이고, −logpθ(x0)를 최소화 하는 대신 Variatoinal Bound를 최소화 하는 식으로 바뀌게 됩니다. 위 수식에서는 logpθ(x0)에 음수가 곱해졌기에 ELBO(Evidence Lower Bound)에도 음수가 곱해진 형태라서 ELBO라는 표현 대신 Variational Bound라는 표현을 사용했습니다.
KL의 비음수성을 이용한 ELBO 유도
DDPM과 같은 확률 모델에서는 관측 데이터 x0에 대한 우도 pθ(x0)를 직접 최적화하기 어렵습니다.
대신, 변분 추론(Variational Inference) 기법을 통해 Evidence Lower Bound (ELBO) 또는 변분 하한을 최적화하여 모델을 학습합니다.
이 글에서는 KL 발산의 비음수성(non-negativity)을 이용해 ELBO를 유도하는 전개 과정을 단계별로 설명합니다.
우선, pθ(x0)는 잠재 변수 x1,x2,…,xT에 대해 마진화된 값(상수)입니다.
즉,
pθ(x0)=∫pθ(x0,x1,…,xT)dx1:T.
상수의 기댓값은 그 상수와 같으므로,
Ex1:T∼q(⋅∣x0)[−logpθ(x0)]=−logpθ(x0).
전개 과정에서는 잠재 변수 x1:T에 대한 확률분포에 대한 기댓값을 이용해서 수식을 전개합니다.
1. 음의 로그 우도와 기댓값 도입
모델 학습의 목표는 logpθ(x0)를 최대화하는 것이며,
실제 구현에서는 이를 −logpθ(x0)를 최소화하는 문제로 전환합니다.
우리는 샘플링이 용이한 분포 q(x1,x2,…,xT∣x0)를 도입하여,
우도를 아래와 같이 기댓값 형태로 표현합니다.
Ex1:T∼q(⋅∣x0)[−logpθ(x0)].
여기서 x0는 주어지고, x1,x2,…,xT에 대한 적분(평균)을 q로 수행하는 것입니다.
2. 조건부 분포를 통한 분해
우도 pθ(x0)는 잠재 변수에 대해 마진화된 결과이므로,
pθ(x0)=∫pθ(x0,x1,…,xT)dx1:T.
조건부 분포의 정의에 따라,
pθ(x1,…,xT∣x0)=pθ(x0)pθ(x0,x1,…,xT).
따라서 로그를 취하면,
logpθ(x0)=logpθ(x0,x1,…,xT)−logpθ(x1,…,xT∣x0).
음수 부호를 붙이면,
−logpθ(x0)=−logpθ(x0,x1,…,xT)+logpθ(x1,…,xT∣x0).
이 식을 x1:T∼q(⋅∣x0)에 대해 기댓값으로 취하면,
Ex1:T∼q(⋅∣x0)[−logpθ(x0)]=Ex1:T∼q(⋅∣x0)[−logpθ(x0,x1,…,xT)+logpθ(x1,…,xT∣x0)].
3. q/q=1 삽입으로 로그 항 분해
이제, logpθ(x1,…,xT∣x0)를 다루기 쉽게 하기 위해,
"1"을 의미하는
q(x1,x2,…,xT∣x0)q(x1,x2,…,xT∣x0)
를 삽입합니다.
logpθ(x1,…,xT∣x0)=log(q(x1,x2,…,xT∣x0)pθ(x1,…,xT∣x0)⋅q(x1,x2,…,xT∣x0)).
로그의 성질에 따라 분리하면,
logpθ(x1,…,xT∣x0)=logq(x1,x2,…,xT∣x0)pθ(x1,…,xT∣x0)+logq(x1,x2,…,xT∣x0).
따라서 전체 전개는
Ex1:T∼q(⋅∣x0)[−logpθ(x0)]=Ex1:T∼q(⋅∣x0)[−logpθ(x0,x1,…,xT)+logq(x1,x2,…,xT∣x0)pθ(x1,…,xT∣x0)+logq(x1,x2,…,xT∣x0)].
4. KL 발산 도입과 부등호 형성
위 식에서 두 번째 항,
Ex1:T∼q(⋅∣x0)[logq(x1,x2,…,xT∣x0)pθ(x1,…,xT∣x0)],
는 정의에 따라
−KL(q(x1,x2,…,xT∣x0)∥pθ(x1,…,xT∣x0))
가 됩니다.
KL 발산은 항상 0 이상이므로,
−KL(⋅)≤0.
따라서 전체 식은 다음과 같이 부등호가 형성됩니다.
Ex1:T∼q(⋅∣x0)[−logpθ(x0)]≤Ex1:T∼q(⋅∣x0)[−logpθ(x0,x1,…,xT)+logq(x1,x2,…,xT∣x0)].
5. Markov Chain 인수분해
마지막 단계에서는 모델과 forward process를 각각 Markov Chain 가정하에 인수분해합니다.
-
Reverse Process (모델):
pθ(x0,x1,…,xT)=pθ(xT)t=1∏Tpθ(xt−1∣xt).
따라서,
−logpθ(x0,x1,…,xT)=−logpθ(xT)−t=1∑Tlogpθ(xt−1∣xt).
-
Forward Process:
q(x1,x2,…,xT∣x0)=t=1∏Tq(xt∣xt−1),
so,
logq(x1,x2,…,xT∣x0)=t=1∑Tlogq(xt∣xt−1).
대입하면 최종적으로,
Ex1:T∼q(⋅∣x0)[−logpθ(x0)]≤Ex1:T∼q(⋅∣x0)[−logpθ(xT)−t=1∑Tlogpθ(xt−1∣xt)+t=1∑Tlogq(xt∣xt−1)].
이 식이 바로 DDPM 논문의 식 (3)에 해당하는 Variational Bound (음의 ELBO)입니다.
다음은 ELBO (3) 에서 DDPM의 수식 5번으로 가는 과정을 다뤄보겠습니다.
