Kubernetes를 이해하기 위한 Linux Networking: Namespace부터 Netfilter까지
이 글은 Kubernetes Networking 시리즈의 첫 번째 글이다. Kubernetes에 들어가기 전에 Pod 통신을 가능하게 만드는 Linux 기능부터 정리한다.
Kubernetes는 독자적인 Network Kernel을 가지고 있지 않다. Pod Network도 결국 Linux의 Network Namespace, virtual interface, routing, forwarding, Netfilter 같은 기능을 이용해 구현한다.
따라서 Kubernetes Network를 이해하려면 먼저 다음 질문에 답할 수 있어야 한다.
- Container마다 어떻게 독립적인 Network Interface를 가질까?
- 서로 다른 Namespace의 process는 어떻게 통신할까?
- 한 Node의 packet이 다른 Node의 Pod까지 어떻게 이동할까?
- NAT와 firewall rule은 어느 지점에서 적용될까?
1. Network Namespace
Linux Network Namespace는 Network Resource를 논리적으로 분리한다.
Namespace마다 다음 항목을 독립적으로 가질 수 있다.
- Network Interface
- IP address
- Routing table
- ARP와 neighbor table
- Netfilter ruleset
- Port와 socket
Host Network Namespace
  eth0: 192.168.147.111

Pod A Network Namespace
  eth0: 10.244.1.10

Pod B Network Namespace
  eth0: 10.244.1.11
Pod마다 같은 이름의 eth0을 가질 수 있는 이유도 서로 다른 Network Namespace에 있기 때문이다.
간단한 Network Namespace는 다음 명령으로 생성할 수 있다.
# Namespace 생성
sudo ip netns add pod-a

# Namespace 목록 조회
sudo ip netns list

sudo ip netns list 실행 결과. pod-a가 정상적으로 생성됐다.
새로 생성된 Namespace에는 기본적으로 loopback interface만 존재한다. IP address와 route는 아직 설정되지 않았으며 loopback도 DOWN 상태다.
sudo ip netns exec pod-a ip link
sudo ip netns exec pod-a ip route
Namespace만 생성하면 외부와 연결되지 않는다. 격리된 공간을 Host와 연결할 virtual cable이 필요하다.
2. veth pair
veth pair는 항상 두 개가 한 쌍으로 만들어지는 virtual Ethernet interface다. 한쪽 interface로 들어간 packet은 반대쪽 interface로 나온다.
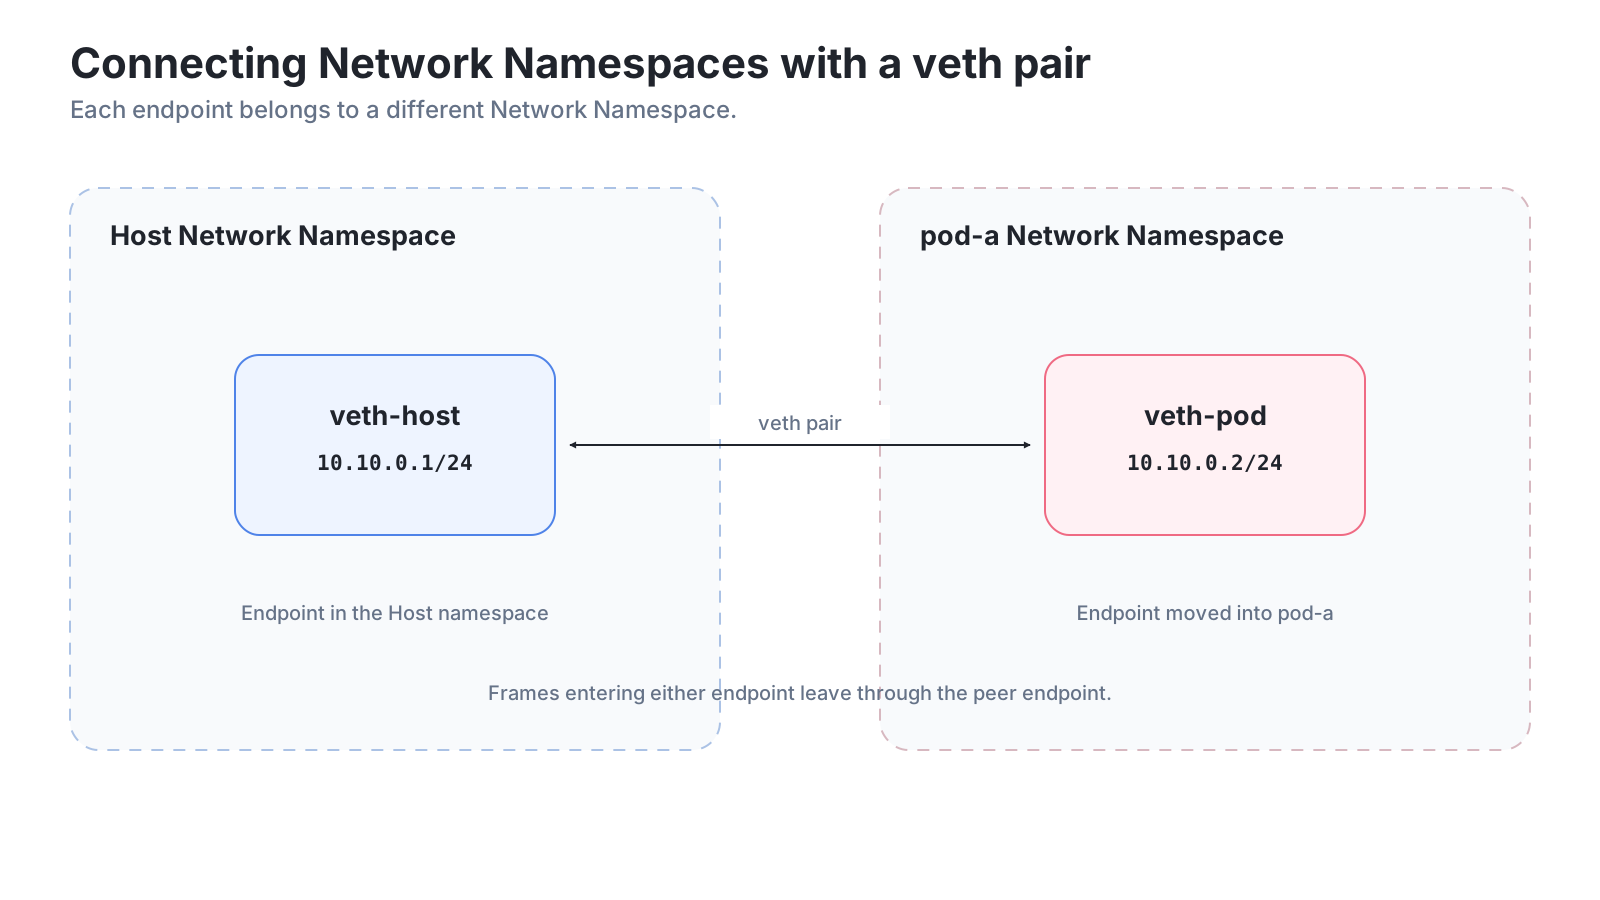
현재 실습에서는 Host 쪽 interface 이름을 veth-host, Namespace 쪽 interface 이름을 veth-pod로 사용한다.
# veth pair 생성
sudo ip link add veth-host type veth peer name veth-pod

# veth-pod를 pod-a Namespace로 이동
sudo ip link set veth-pod netns pod-aveth-pod를 pod-a로 이동한 뒤에는 일반적인 Host의 ip link 결과에서 보이지 않는다. 해당 interface는 이제 pod-a의 Network Namespace에 속하기 때문이다.
다음으로 Host와 Namespace 양쪽 interface에 IP를 할당하고 link를 활성화한다.
# Host 쪽 설정
sudo ip addr add 10.10.0.1/24 dev veth-host
sudo ip link set veth-host up

# pod-a 쪽 설정
sudo ip netns exec pod-a ip addr add 10.10.0.2/24 dev veth-pod
sudo ip netns exec pod-a ip link set veth-pod up

# pod-a 내부 localhost 통신을 위한 loopback 활성화
sudo ip netns exec pod-a ip link set lo up
loopback은 활성화돼도 ip -br addr에서 UNKNOWN으로 표시될 수 있다. loopback에는 물리적인 cable이나 carrier 상태가 없기 때문이다. 다음 명령에서 <LOOPBACK,UP,LOWER_UP> flag가 보이면 정상적으로 활성화된 상태다.
sudo ip netns exec pod-a ip link show lo양쪽의 IP와 route를 확인한다.
# Host 측 interface 확인
ip -br addr show veth-host

# pod-a 내부 interface 확인
sudo ip netns exec pod-a ip -br addr

# pod-a 내부 route 확인
sudo ip netns exec pod-a ip route
다음 route는 10.10.0.0/24 대역이 veth-pod에 직접 연결되어 있다는 의미다.
10.10.0.0/24 dev veth-pod proto kernel scope link src 10.10.0.2이제 pod-a에서 Host의 veth-host로 Ping을 실행한다.
sudo ip netns exec pod-a ping -c 3 10.10.0.1
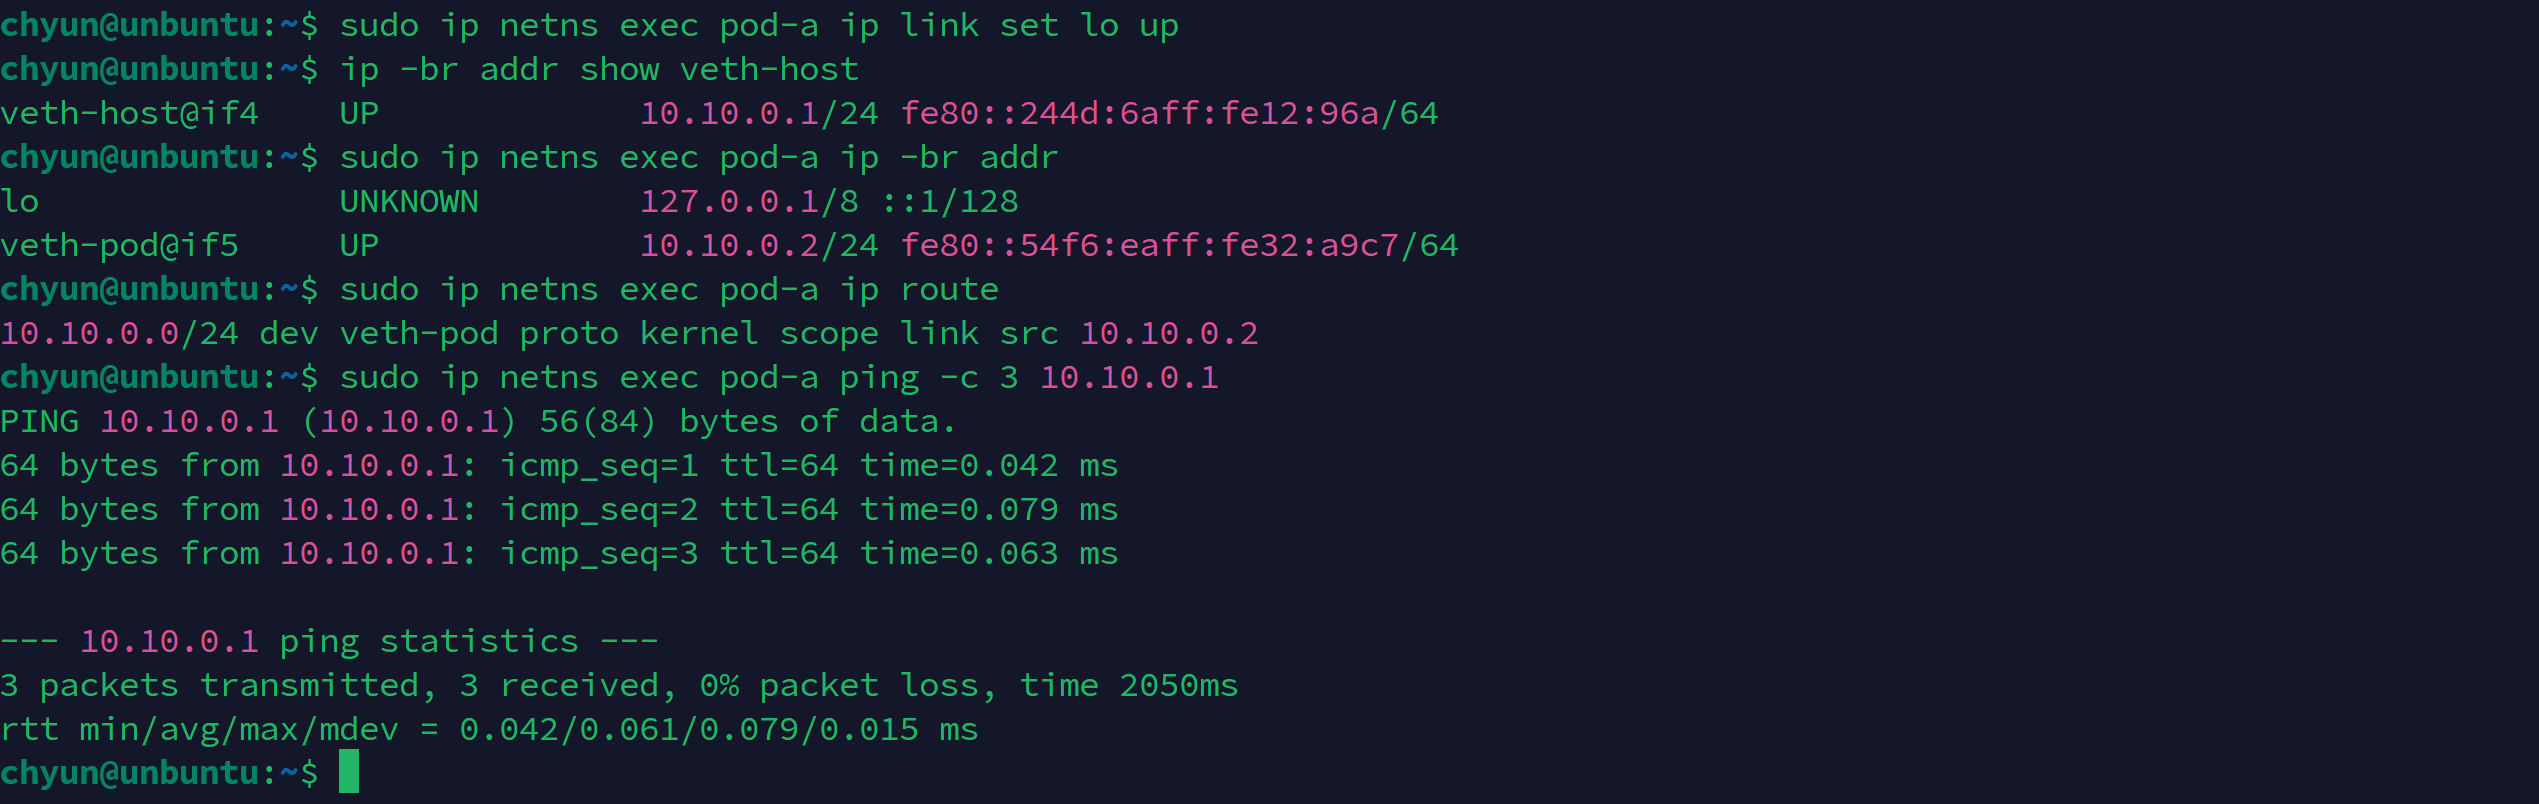
pod-a에서 Host의 veth-host(10.10.0.1)로 Ping을 실행한 결과, packet 손실 없이 통신에 성공했다.
현재 구성된 경로는 다음과 같다.
Host Network Namespace                  pod-a Network Namespace

veth-host                               veth-pod
10.10.0.1/24  <────── veth pair ─────> 10.10.0.2/24
Kubernetes에서는 Container Runtime이 Pod Sandbox와 Network Namespace를 준비하고 CNI Plugin을 호출한다. CNI Plugin은 전달받은 Namespace 안에 interface를 만들거나 설정하고 IP와 route 같은 Network Attachment를 구성한다.
실습을 종료한 뒤 Namespace를 삭제하려면 다음 명령을 사용한다.
sudo ip netns delete pod-aNamespace가 실제로 제거되면 그 안의 veth-pod와 연결된 veth-host도 함께 사라진다. Namespace 안에 실행 중인 process가 있으면 Namespace가 즉시 완전히 제거되지 않을 수 있다.
3. Linux Bridge와 Routing
동일한 Node에 존재하는 여러 Network Namespace를 연결하는 대표적인 방법은 Linux Bridge다.
다음 그림은 앞에서 만든 단일 pod-a 실습을 그대로 이어서 실행한 결과가 아니라, 두 Namespace를 하나의 Linux Bridge에 연결한 개념적인 예시다.
각 Namespace의 veth pair에서 Host 쪽 interface를 br0에 연결하면 Bridge가 MAC address table을 이용해 frame을 전달할 수 있다.
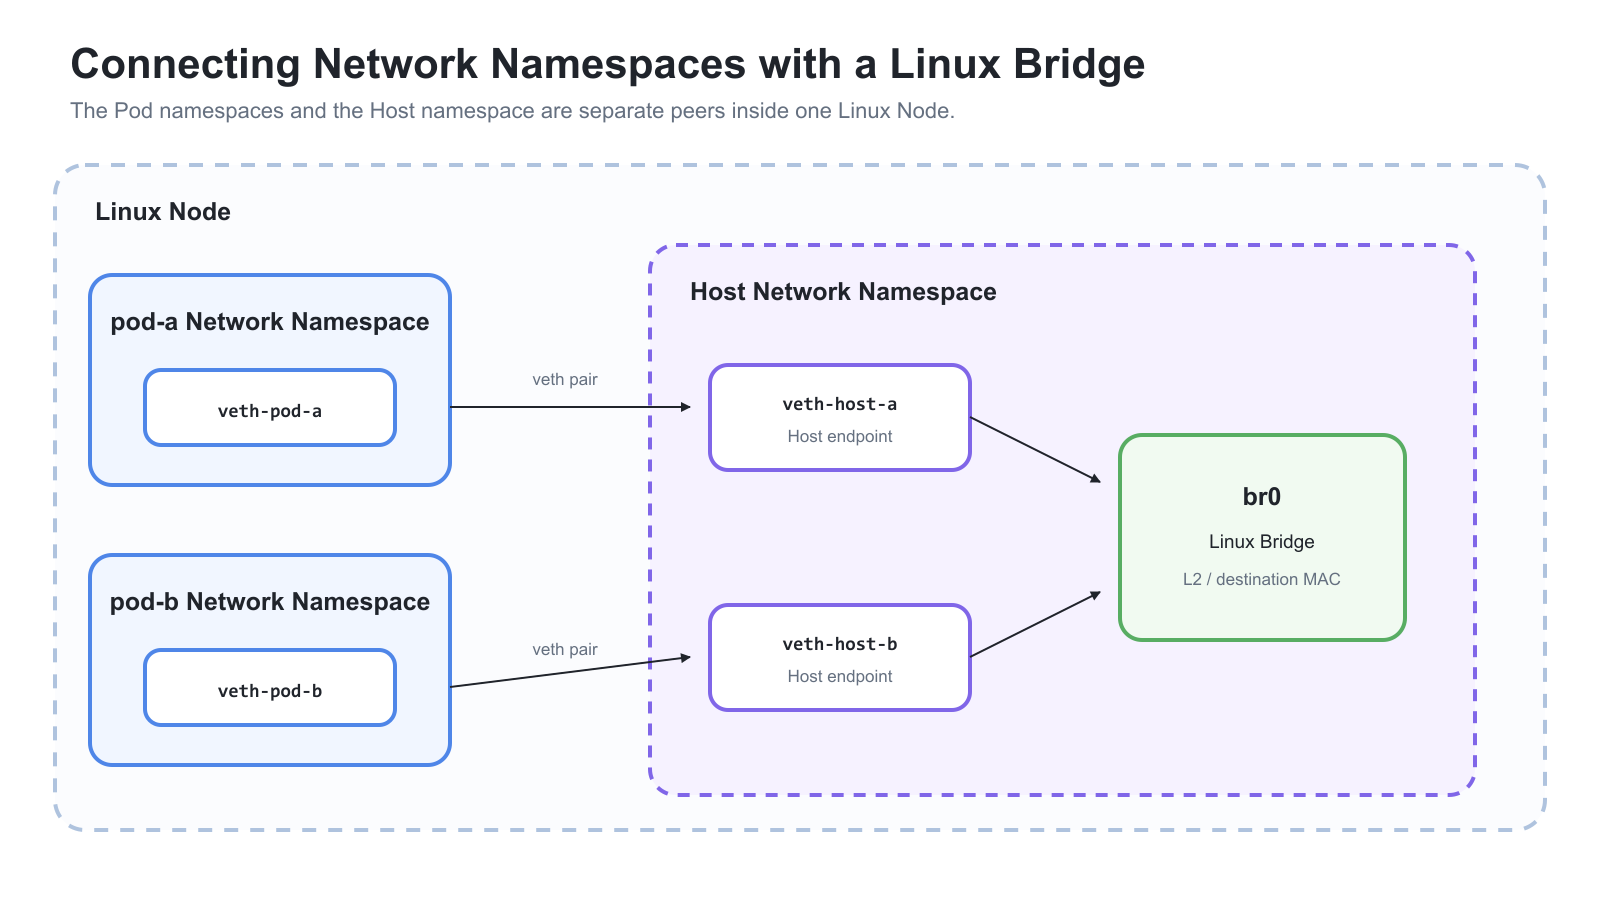
Bridge와 Router는 packet을 판단하는 계층이 다르다.
Linux Bridge
  → L2에서 destination MAC address를 기준으로 frame 전달

Linux Routing
  → L3에서 destination IP와 routing table을 기준으로 packet 전달
다음 명령으로 Host의 interface, route, Bridge port와 Forwarding Database를 확인할 수 있다. 이 명령들은 조회 명령이며 Bridge를 새로 생성하지 않는다.
ip -br link
ip route
bridge link
bridge fdb show
모든 Kubernetes Network 구현체가 Linux Bridge를 사용하는 것은 아니다.
- 일부 구현은 Linux Bridge와 VXLAN을 조합한다.
- 일부 구현은 Host Routing과 BGP를 사용한다.
- 일부 구현은 eBPF를 이용해 packet forwarding과 policy를 처리한다.
따라서 Pod Network = Linux Bridge라고 일반화하면 안 된다.
4. IP Forwarding
Linux Host가 packet의 최종 목적지가 아니면서, 한 interface로 받은 packet을 다른 interface로 전달해야 한다면 IP Forwarding이 활성화돼야 한다.
아래 그림에서 Node A는 Pod A가 보낸 packet의 최종 목적지가 아니다. Node A는 Pod 측 virtual interface로 packet을 받은 뒤 routing 결과에 따라 물리 interface 또는 다른 virtual interface로 전달한다. 이후 packet은 Node B에 도착해 최종 목적지인 Pod B로 전달된다.
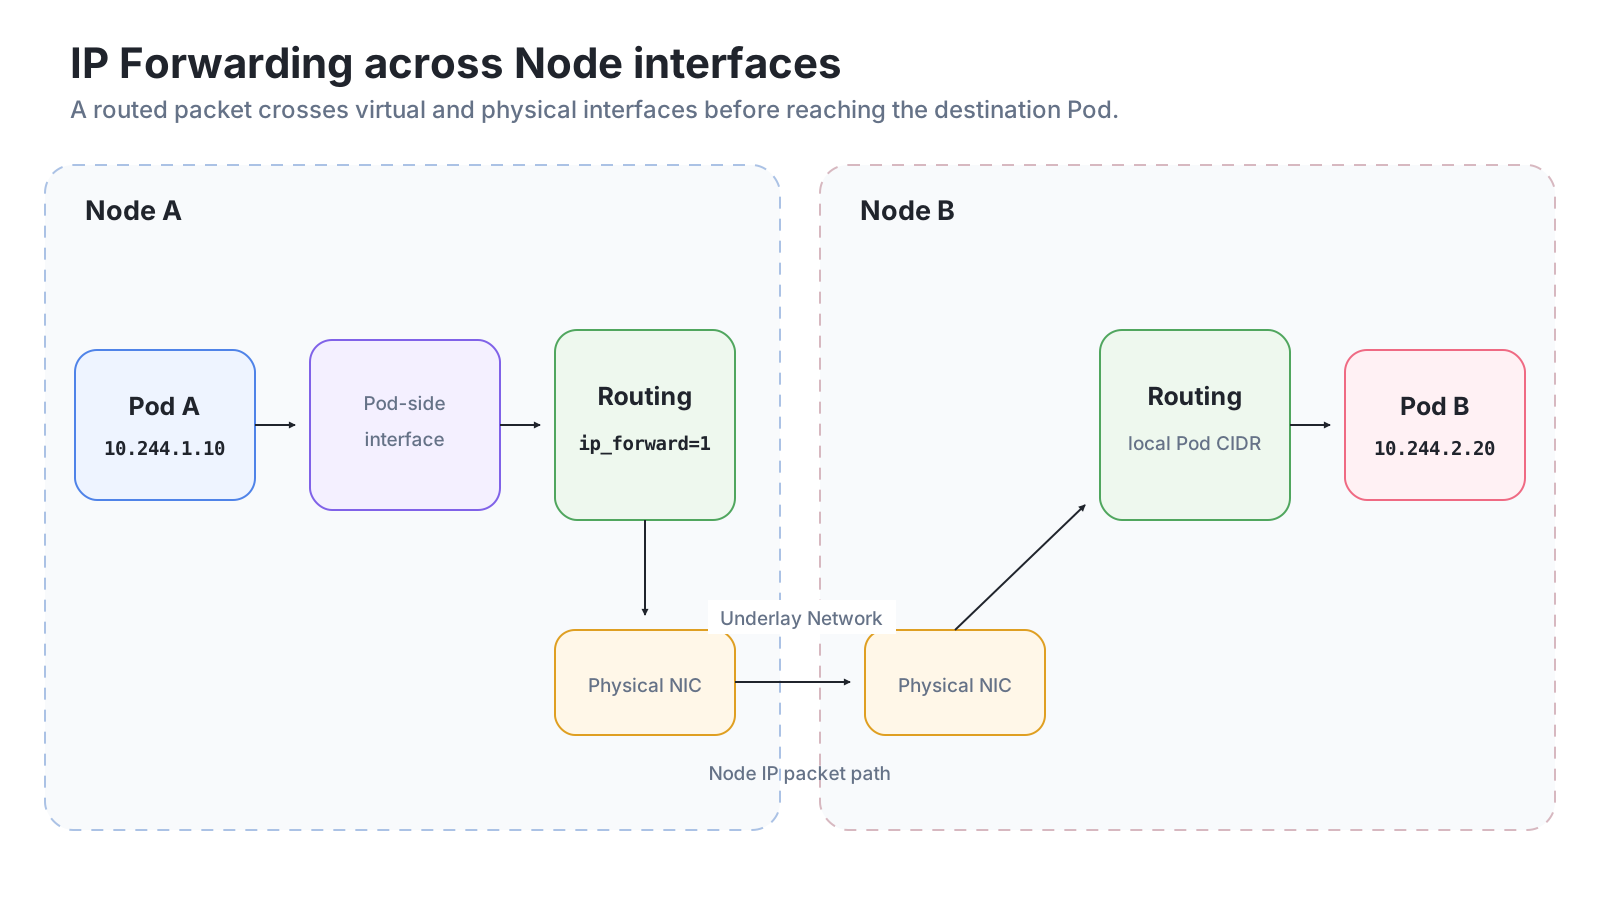
Pod A의 packet이 Node A의 Pod 측 interface로 들어온 뒤, routing과 물리 interface를 거쳐 다른 Node의 Pod B로 전달되는 과정이다.
현재 IPv4 Forwarding 설정은 다음 명령으로 확인할 수 있다.
sysctl net.ipv4.ip_forward출력이 1이면 IPv4 packet forwarding이 활성화된 상태다.
net.ipv4.ip_forward = 1다음 명령으로 실행 중인 Kernel의 값을 즉시 변경할 수 있다.
sudo sysctl -w net.ipv4.ip_forward=1sysctl -w로 변경한 값은 현재 boot session에만 적용된다. 재부팅 후에도 유지하려면 뒤에서 설명할 /etc/sysctl.d 설정 파일에 값을 저장해야 한다.
net.ipv4.ip_forward=1은 Linux가 packet을 전달하도록 허용할 뿐 목적지까지의 route를 자동으로 만들지는 않는다.
net.ipv4.ip_forward=1
  → Host가 자신이 최종 목적지가 아닌 IPv4 packet을 전달하도록 허용

Routing table, tunnel, Network Provider
  → packet을 실제로 어디로 전달할지 결정
실제 전달 경로는 Linux routing table, CNI 기반 Network 구현체, BGP daemon, Cloud Router 또는 관리자가 구성한 route 등에 의해 결정될 수 있다.
5. Node 간 Pod Network 구성
여러 Node에 분산된 Pod를 연결하려면 Node 사이의 기반 Network와 Pod packet 전달 방식이 필요하다.
5.1 기반 네트워크: Underlay Network
Underlay Network는 Kubernetes Node들이 실제로 연결된 기반 Network다.
현재 VM 환경에서는 VMware의 Host-only Network와 각 Node에 할당한 다음 IP 대역이 Underlay Network로 사용될 수 있다.
Node A: 192.168.147.111
Node B: 192.168.147.112
Node A
→ VM Network Adapter
→ VMware Host-only Network
→ VM Network Adapter
→ Node B실제로 어떤 interface와 Network가 Node 간 traffic에 사용되는지는 routing table과 CNI 설정을 확인해야 한다.
ip route
ip route get 192.168.147.112
Pod packet을 이 Underlay Network 위에서 다른 Node로 전달하는 대표적인 방식은 Overlay Networking과 Direct Routing이다.
5.2 전달 방식 1: Overlay Networking
Overlay Networking은 원래 Pod packet 또는 frame에 외부 tunnel header를 추가해 Node 사이로 전송한다. 이를 Encapsulation이라고 한다.
VXLAN을 예로 들면 전체 frame 구조는 다음과 같다.
Encapsulated VXLAN frame
├─ Outer Ethernet header
├─ Outer IP header
│  ├─ Source: Node A IP 192.168.147.111
│  └─ Destination: Node B IP 192.168.147.112
├─ Outer UDP header
├─ VXLAN header
└─ Inner Ethernet frame
   └─ Inner IP packet
      ├─ Source: Pod A IP 10.244.1.10
      └─ Destination: Pod B IP 10.244.2.20
Geneve도 외부 IP와 UDP header 및 Geneve header를 이용하는 Overlay Encapsulation protocol이다. Geneve payload의 protocol type에 따라 Ethernet frame이나 IP packet 등을 운반할 수 있다.
구조를 단순화하면 다음과 같다.
원래 Pod traffic
  10.244.1.10 → 10.244.2.20
           ↓ Encapsulation
Outer Node traffic
  192.168.147.111 → 192.168.147.112
  UDP + VXLAN/Geneve header
  Payload: 원래 Pod traffic
Underlay Network의 switch와 router는 가장 바깥쪽에 있는 Node IP를 기준으로 packet을 전달한다.
192.168.147.111 → 192.168.147.112Underlay Network는 내부에 들어 있는 다음 Pod IP의 route를 알 필요가 없다.
10.244.1.10 → 10.244.2.20Node B의 tunnel endpoint에 packet이 도착하면 외부 header를 제거하는 Decapsulation이 수행되고, 원래 Pod traffic이 Pod B로 전달된다.
전체 흐름은 다음과 같다.
Pod A
  → 원래 Pod traffic 생성
Node A tunnel endpoint
  → Outer IP + UDP + VXLAN/Geneve header 추가
Underlay Network
  → Outer Node IP를 기준으로 전달
Node B tunnel endpoint
  → Outer tunnel header 제거
Pod B
  → 원래 Pod traffic 수신
Overlay의 장점은 Underlay Network가 Pod CIDR을 몰라도 된다는 것이다. 대신 tunnel header가 추가되므로 Encapsulation과 Decapsulation 처리 비용 및 MTU 감소를 고려해야 한다.
5.3 전달 방식 2: Direct Routing
Direct Routing은 Pod traffic을 VXLAN이나 Geneve로 감싸지 않고 Linux routing table과 기존 Network의 routing 기능을 이용해 전달한다.
Pod A
  → Node A routing table
  → Node A Network Interface
  → Underlay Network
  → Node B Network Interface
  → Node B routing table
  → Pod B
이 방식에서는 각 Node 또는 Underlay Router가 다른 Node의 Pod CIDR로 가는 경로를 알고 있어야 한다.
두 Node가 192.168.147.0/24의 동일한 L2 Network에 있고 다음 Pod CIDR을 사용한다고 가정한다.
Node A Pod CIDR: 10.244.1.0/24
Node B Pod CIDR: 10.244.2.0/24
개념적으로 양쪽 Node에는 다음과 같은 route가 필요하다.
Node A
  10.244.2.0/24 via 192.168.147.112

Node B
  10.244.1.0/24 via 192.168.147.111
Node A의 route는 목적지가 10.244.2.0/24인 packet을 Node B의 192.168.147.112로 전달한다는 의미다. Node B에는 응답 packet을 Node A로 돌려보낼 반대 방향의 route가 필요하다.
위 예시는 next hop Node IP가 동일한 L2 Network에서 직접 도달할 수 있다는 가정이다. 실제 환경에서는 Static Route, BGP, Cloud Provider의 VPC Route 또는 Network 구현체의 route 관리 기능을 사용할 수 있다.
Direct Routing은 별도의 tunnel header가 없으므로 Encapsulation overhead와 MTU 감소를 피할 수 있다. 대신 Pod CIDR route를 Underlay Network에서 관리할 수 있어야 한다.
5.4 Overlay Networking과 Direct Routing 비교
| 항목 | Overlay Networking | Direct Routing |
|---|---|---|
| Pod traffic | VXLAN 또는 Geneve 등으로 Encapsulation | 원래 traffic을 직접 Routing |
| Node 간 기반 Network | Underlay Network 사용 | Underlay Network 사용 |
| Pod CIDR 인식 | Underlay가 몰라도 됨 | Node 또는 Router가 알아야 함 |
| MTU | Tunnel header만큼 감소 | 추가 tunnel header 없음 |
| 구성 | 상대적으로 단순 | Route 관리가 필요함 |
개념의 관계를 정리하면 다음과 같다.
Underlay Network
  └─ Node를 실제로 연결하는 기반 Network

Node 간 Pod traffic 전달 방식
  ├─ Overlay Networking
  └─ Direct Routing
6. Netfilter와 conntrack
Netfilter는 Linux Kernel의 packet 처리 framework다. packet은 상황에 따라 PREROUTING, INPUT, FORWARD, OUTPUT, POSTROUTING 같은 hook을 통과한다.
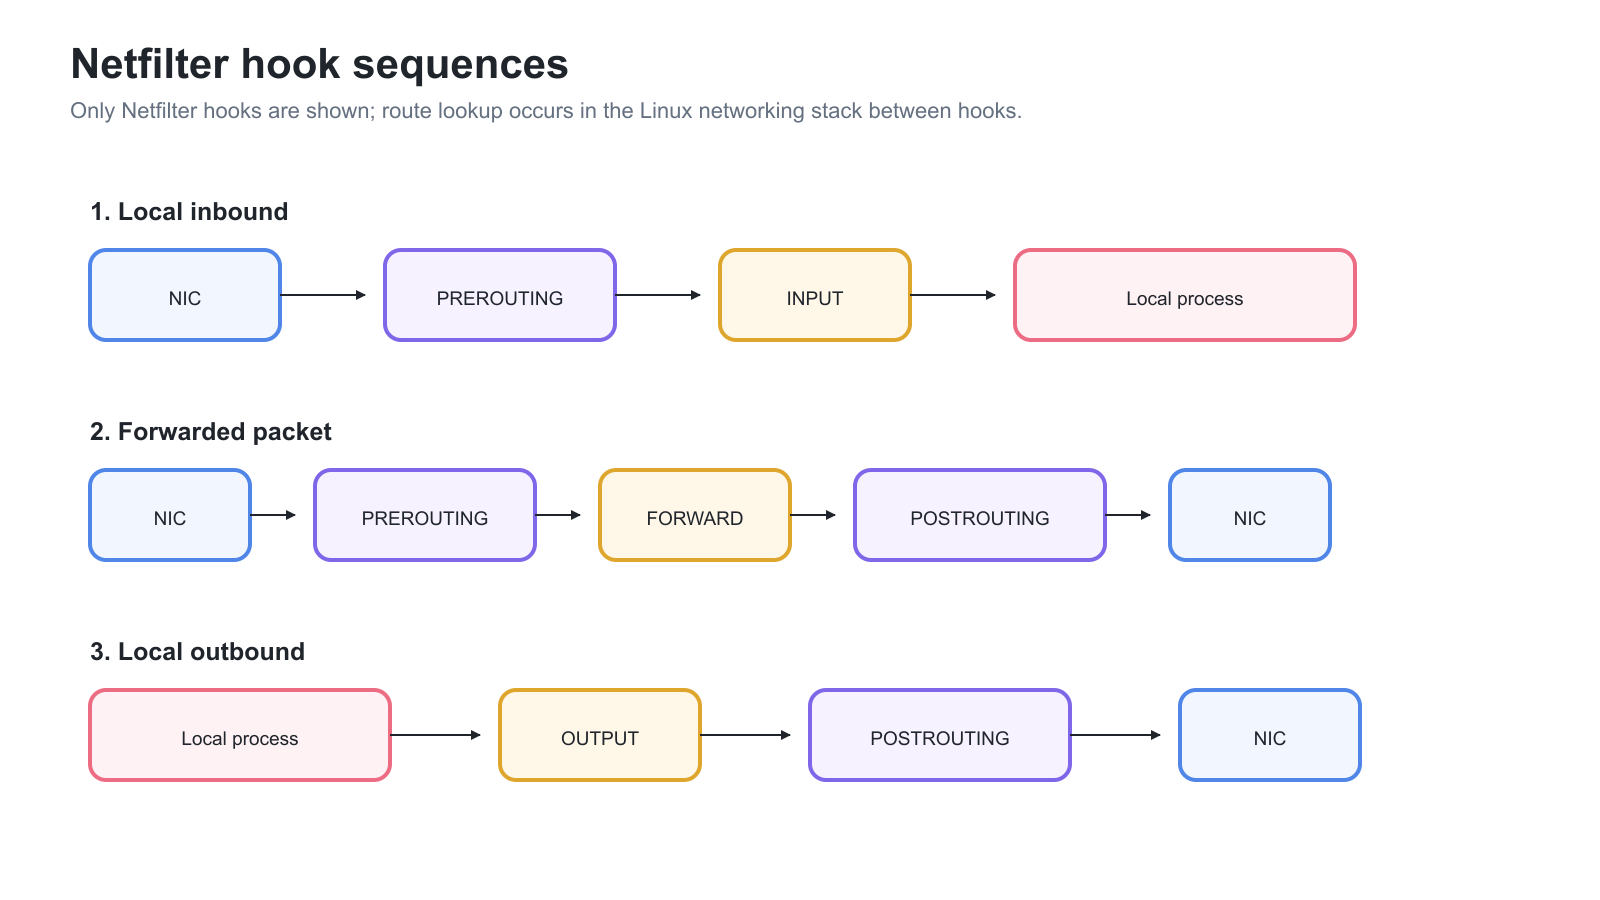
iptables와 nftables는 Netfilter hook에 적용할 rule을 구성하는 서로 다른 userspace interface다.
conntrack은 Linux Kernel에서 connection과 관련된 packet 상태를 추적한다. 다음 값은 순서대로 반드시 전환되는 하나의 상태 흐름이 아니라 packet을 분류하는 대표적인 conntrack state다.
NEW
  → 새 connection을 시작했거나 아직 양방향 packet이 확인되지 않은 상태

ESTABLISHED
  → 양방향 packet이 확인된 기존 connection

RELATED
  → 기존 connection과 관련되어 새로 시작된 별도의 connection

INVALID
  → 기존 connection에 정상적으로 연결할 수 없는 packet

UNTRACKED
  → 명시적으로 conntrack 대상에서 제외된 packet
일반적인 TCP connection의 단순화된 흐름은 다음과 같이 표현할 수 있다.
NEW → ESTABLISHEDRELATED는 ESTABLISHED 다음 단계가 아니다. 예를 들어 기존 connection과 관련된 ICMP error나 FTP control connection에 의해 별도로 만들어진 data connection이 RELATED로 분류될 수 있다.
NAT는 일반적으로 connection의 첫 packet에서 translation을 결정하고, 이후 같은 connection의 packet에는 conntrack에 저장된 정보를 활용한다. 따라서 kube-proxy의 iptables Service rule 탐색 비용도 주로 신규 connection의 첫 packet을 설명할 때 중요하게 다뤄진다.
현재 conntrack과 Netfilter ruleset은 다음 명령으로 확인할 수 있다.
sudo conntrack -L
sudo nft list ruleset
sudo iptables-save
conntrack 명령이 없다면 Ubuntu에서 다음 package를 설치해야 한다.
sudo apt update
sudo apt install -y conntrack
7. 이번 Kubernetes 환경에서 적용한 Kernel Module과 sysctl
이번 Kubernetes Node 구성에서는 다음 Kernel Module과 sysctl을 적용했다.
다만 모든 Kubernetes와 CNI 환경에서 아래 설정이 동일하게 필요한 것은 아니다. 사용하는 Container Runtime의 snapshotter, CNI 및 datapath mode의 공식 요구사항을 확인해야 한다.
Kernel Module을 재부팅 후에도 load하도록 설정
cat <<'EOF' | sudo tee /etc/modules-load.d/kubernetes.conf
overlay
br_netfilter
EOF

sudo modprobe overlay
sudo modprobe br_netfilter
overlay Kernel Module은 containerd가 OverlayFS snapshotter를 사용할 때 container image layer를 구성하는 filesystem 기능과 관련 있다.
이 overlay는 앞에서 설명한 VXLAN 또는 Geneve 기반 Overlay Networking과 전혀 다른 개념이다.
br_netfilter는 Linux Bridge를 통과하는 traffic을 IPv4 및 IPv6 Netfilter hook에서 처리할 수 있게 한다.
sysctl을 영구 저장하고 즉시 적용
cat <<'EOF' | sudo tee /etc/sysctl.d/99-kubernetes-network.conf
net.bridge.bridge-nf-call-iptables  = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward                 = 1
EOF

sudo sysctl --system
각 설정의 의미는 다음과 같다.
| 설정 | 의미 |
|---|---|
overlay | OverlayFS snapshotter가 사용할 수 있는 filesystem Kernel Module |
br_netfilter | Bridge traffic을 Netfilter hook에서 처리할 수 있게 하는 Module |
bridge-nf-call-iptables | Bridged IPv4 traffic을 Netfilter IPv4 hook으로 전달 |
bridge-nf-call-ip6tables | Bridged IPv6 traffic을 Netfilter IPv6 hook으로 전달 |
ip_forward | Interface 사이의 IPv4 packet forwarding 허용 |
적용 결과를 확인한다.
lsmod | grep -E 'overlay|br_netfilter'
sysctl net.bridge.bridge-nf-call-iptables
sysctl net.bridge.bridge-nf-call-ip6tables
sysctl net.ipv4.ip_forwardbridge-nf-call-iptables라는 이름에 iptables가 포함돼 있어도 legacy iptables backend를 선택하는 option은 아니다. Bridge traffic을 IPv4 Netfilter hook으로 전달할지를 결정하는 오래된 sysctl 이름이다.
8. Kubernetes에 대응시키기
앞에서 확인한 Linux 기능은 Kubernetes에서 다음과 같이 활용된다.
| Linux 기능 | Kubernetes에서의 활용 |
|---|---|
| Network Namespace | Pod Sandbox의 Network 격리 |
| veth 또는 virtual device | Pod Network Namespace와 Host 연결 |
| Routing 또는 Bridge | Pod packet 전달 |
| VXLAN 또는 Geneve | Node 간 Overlay Network 구성 |
| IP Forwarding | Node가 목적지가 아닌 packet을 중계 |
| Netfilter | NAT와 firewall rule 처리 |
| conntrack | Connection 상태 및 NAT 정보 추적 |
| eBPF | Cilium 같은 구현체의 programmable datapath |
Kubernetes가 이 기능을 직접 하나씩 구성하는 것은 아니다.
Container Runtime
  → Pod Sandbox와 Network Namespace 준비
  → CNI Plugin 호출

CNI Plugin
  → Pod의 Network Interface와 Network Attachment 구성

CNI 기반 Network 구현체와 관련 Agent
  → Node 간 route, tunnel, policy, datapath 등을 구현할 수 있음

Linux Kernel과 Underlay Network
  → 실제 packet 전달 수행
세부 책임은 선택한 Container Runtime, CNI 구현체, Cloud Provider 및 Network 구성에 따라 달라질 수 있다.
결론
Pod Network는 Kubernetes가 별도의 Network Kernel을 만들어 제공하는 기능이 아니다.
Kubernetes Pod Network는 Container Runtime이 준비한 Pod Sandbox와 Network Namespace에 CNI Plugin이 Network Interface를 연결하고, CNI 기반 Network 구현체와 Linux Kernel 및 Underlay Network가 실제 packet 전달 경로를 구성한 결과다.
핵심 관계를 다시 정리하면 다음과 같다.
Pod 격리
  → Network Namespace

Pod와 Host 연결
  → veth 또는 virtual interface

같은 Node의 Network 연결
  → Bridge 또는 Host Routing

다른 Node의 Pod 연결
  → Overlay Networking 또는 Direct Routing

Packet Forwarding 허용
  → net.ipv4.ip_forward

Firewall, NAT, Connection 추적
  → Netfilter와 conntrack
다음 글에서는 이 Linux 기능을 누가 요청하고 관리하는지 이해하기 위해 Kubernetes의 Control Plane과 Node Component를 살펴본다.
참고 자료