
안녕하세요! 메랜샵 개발자로서 좌충우돌 개발 및 운영을 하고있는 이삭입니다.
지난번 협업 규칙에 대한 이야기에 이어, 이번에는 서비스의 성능과 사용자 경험을 한 단계 끌어올렸던 검색 자동완성 기능 최적화 경험을 공유해 보려고 합니다.
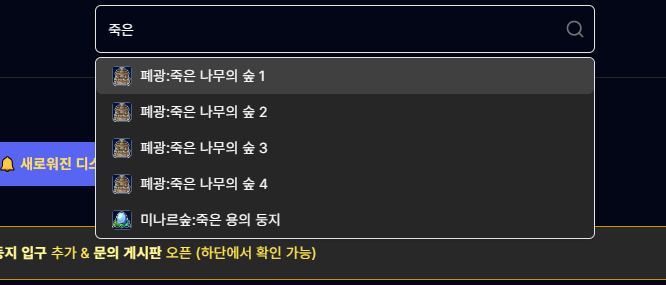
현재 메랜샵에는 유저들이 원하는 맵을 쉽게 찾을 수 있도록 검색 자동완성 기능이 있습니다.
하지만 이 기능이 미래에 우리 서비스의 발목을 잡을 수 있겠다는 생각이 들었습니다.
문제 상황: 타자 하나하나가 서버 부하를 만드는 구조
기존의 검색 자동완성 기능은 아래와 같이 동작하고 있었습니다.
(아래 코드, 엔티티명, API 경로, 데이터 값은 모두 임의의 예시입니다.)
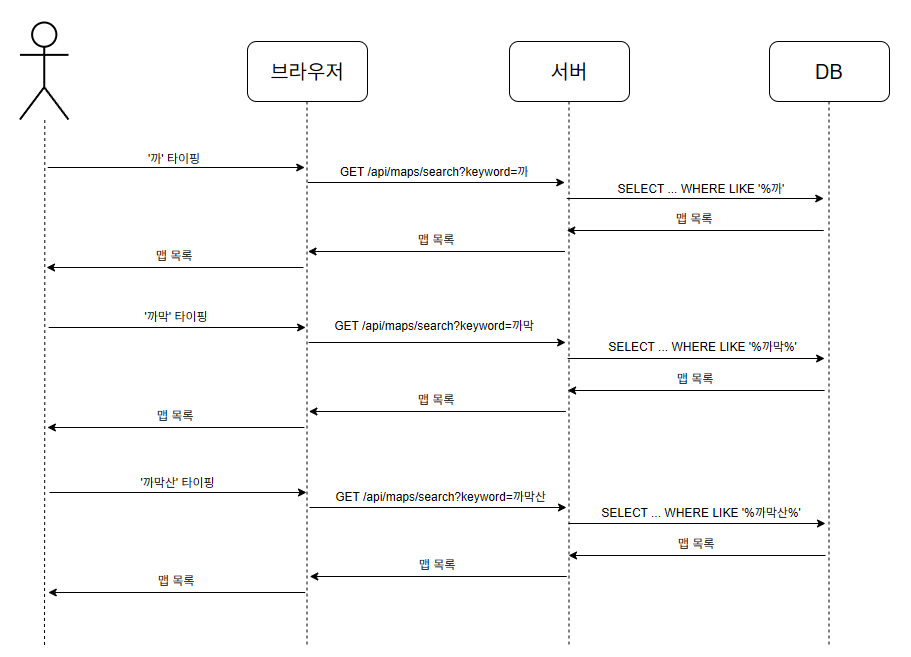
1. 사용자가 검색창에 글자를 입력할 때마다 검색 API 호출
@RestController
public class GameMapController {
    private final SaerchService searchService;

    @GetMapping("/api/maps/search")
    public List<GameMap> autoComplete(@RequestParam(defaultValue = "") String keyword) {
        return searchService.getGameMapNames(keyword);
    }
}
'까' -> '까막' -> '까막산' -> '까막산 입' -> '까막산 입구'
사용자가 '까막산 입구'를 검색하면, '까' -> '까막' -> '까막산' ... 이렇게 타자를 칠 때마다 서버로 API 요청이 계속해서 전송됩니다.
2. 서버는 매 요청마다 DB에 LIKE '%검색어%' 쿼리 실행
더 큰 문제는 DB였습니다. 모든 요청이 인덱스를 사용하지 못하는 LIKE '%검색어%' 쿼리를 실행했습니다.
@Service
public class SearchService {
    private final GameMapRepository gameMapRepository;

    public List<GameMap> getGameMapNames(String keyword) {
        List<GameMap> GameMapList = gameMapRepository.findByMapName(keyword); // LIKE %keyword%
        return GameMapList;
    }
}
이 구조의 문제점은 명확했습니다.
- 서버 부하: 사용자가 많아지면 잦은 API 호출로 서버의 커넥션이 금방 고갈될 수 있습니다.
- DB 부하: 데이터가 늘어날수록
LIKE검색으로 인한 성능 저하가 예상됩니다.
해결책: 자동완성은 브라우저에서, DB는 한 번만
문제 해결을 위해 발상을 전환했습니다.
"모든 짐을 서버가 짊어질 필요가 있을까?"
맵 데이터의 특성을 분석했을 때, 게임이 맵 업데이트를 하지 않는 이상 거의 변경되지 않는 정적인 데이터라는 특성에 주목했습니다.
서버에서 매 요청을 처리할 필요가 없다는 결론이 나왔습니다.
최적화 전략
- 최초 1회, 전체 맵 목록 응답
- 사용자가 페이지에 진입할 때 전체 맵 이름 목록을 전달
- 프론트엔드는 전달받은 이름 목록을 캐싱(저장)
- 로컬 스토리지에 저장
- 이후 자동완성은 캐싱된 데이터로 프론트엔드에서 자체 처리
- 사용자가 검색창에 무언가를 입력하면, 브라우저가 가지고 있는 이름 목록을 활용하여 자동 완성 목록을 표시
- 서버단 캐싱
- 서버 기동 시 미리 맵 목록 캐싱 (캐시 워밍) -> 운영중 실제 DB 조회 0회
결과: 사용자 경험과 서버 성능, 두 마리 토끼를 잡다
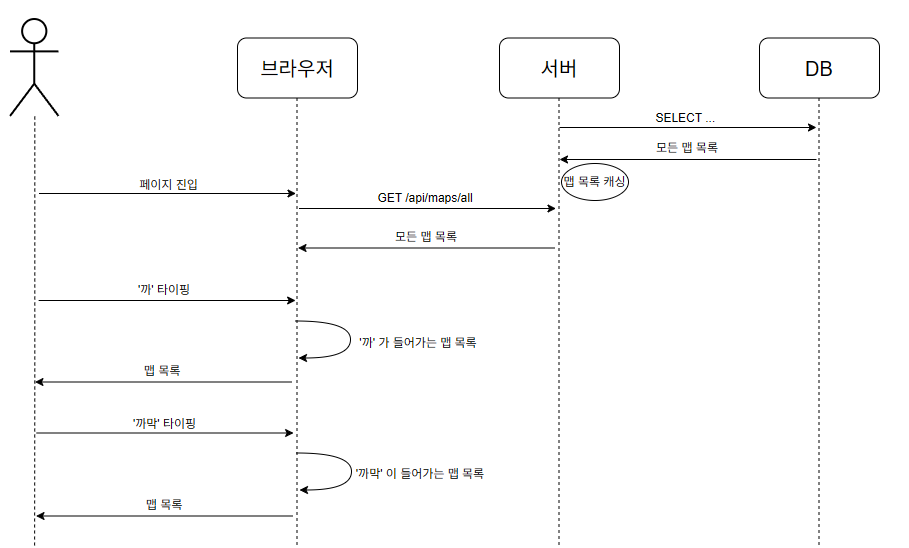
이 간단한 구조 변경은 매우 큰 효과를 가져왔습니다.
API 요청 수 감소(유저당 n회 -> 유저당 최초 1회)
- (기존) 검색 자동 완성을 사용할 때마다 유저당 n회의 서버 API 요청
- (변경 후) 유저당 최초 1회의 API 요청
획기적인 DB 부하 감소(유저당 n회 Like 쿼리 요청 -> 서버 기동 시 1회)
- (기존) 유저당 n회의
Like쿼리 요청 - (변경 후) 캐시워밍하는 순간 딱 한 번 요청
향상된 사용자 경험
사용자는 더 이상 키보드를 입력하며 네트워크 응답을 기다릴 필요가 없어졌습니다.
모든 자동완성이 사용자의 브라우저 안에서 즉각적으로 일어나기 때문에
훨씬 빠르고 쾌적한 검색 경험을 제공할 수 있게 되었습니다.
마무리하며
이번 최적화는 '데이터의 특성을 파악하고 그에 맞는 최적의 구조를 고민하는 것' 이 얼마나
중요한지 다시 한번 깨닫게 된 계기였습니다.
무조건 백엔드에서 모든 것을 처리하는 것이 정답이 아닐 수 있으며, 때로는 프론트엔드와의
적절한 역할 분담이 훨씬 더 효율적인 결과를 낳을 수 있다는 것을 배웠습니다.
메랜샵에 대한 저의 두 번째 이야기를 읽어주셔서 감사합니다!
4개의 댓글

글 너무 잘읽었습니다!!
몇가지 질문이있는데요.!
먼저 현재는 맵데이터가 그렇게 많지않아 문제될것 같아 보이지 않지만 만약 캐싱해두어야할 데이터가 많아진다면 클라이언트 로컬스토리지 캐싱 방식의 변화를 줄것인지 궁금합니다.!
또한 운영진의 새로운 맵 데이터 업데이트시 클라이언트 캐싱데이터와의 동기화 문제도 어떻게 해결했는지 궁금합니다!!
그리고 검색에 디바운싱을 적용하게된다면 지연 로딩이긴하지만 api를 여러번 호출하는 부하는 줄일 수 있을것 같습니다!!
감사합니다.
정말 재밌는 글이네요 ㅋㅋㅋ