Intro.
머신러닝에서 분류 문제의 결과를 해석하는 것은 중요하다. 머신러닝은 개발보다는 실험에 가까우며 블랙박스 모델인 경우가 많다. 그러한 점에서 결과에 대한 해석은 해당 모델이 어떤 부분에서 잘못되었는지, 학습 데이터가 이상하지는 않은지와 같은 여러 의미를 담고 있는 만큼 제대로 해석할 필요가 있다.
혼동행렬(Confusion Matrix).
분류 문제에서 가장 쉽게 결과를 확인할 수 있는 것은 혼동행렬일 것이다. 혼동행렬의 여러 지표를 확인하는 것으로 모델의 성능을 수치적으로 쉽게 가늠할 수 있다. 이진분류의 혼동행렬은 여기저기서 많이 다루니 멀티 클래스에 대한 혼동행렬을 보고 해석해보려 한다.
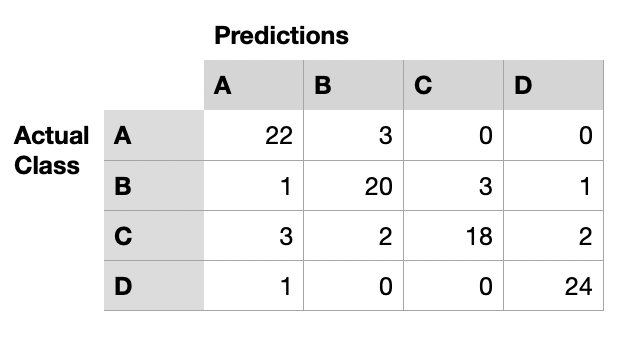
혼동행렬에서 볼 수 있는 값은 TP(True Positive), TN(True Negative), FN(False Negative), FP(False Positive) 4가지가 있고 이 4가지를 바탕으로 다음과 같은 지표를 확인할 수 있다.
-
정확도(Accuracy):
-
정밀도(Precision):
-
재현율(Recall), 민감도(Sensitivity):
-
특이도(Specificity):
-
F1 Score:
멀티 클래스에 대한 부분이므로 A에 대한 지표들과 B에 대한 지표들... D에 대한 지표들까지 실제로 계산을 통해 구해 볼 수 있다. A클래스의 대한 지표를 구하기 위해 A클래스에 대한, TP, TN, FN, FP값을 먼저 구하면 다음과 같다.
- A클래스의 TP =
- A클래스의 TN =
- A클래스의 FN =
- A클래스의 FP =
해당 값들을 바탕으로 지표를 구하면 다음과 같다.
-
정확도(Accuracy): (정확도에 경우 모든 클래스에서 동일하다)
-
정밀도(Precision):
-
재현율(Recall), 민감도(Sensitivity):
-
특이도(Specificity):
-
F1 Score:
이와 같이 정확도부터 재현율, F1 Score까지 특이한 수준 없이 높은 값을 가진다면 우리는 해당 모델이 A클래스를 잘 분류 하고 있다고 말 할 수 있다.
얼핏 보면 정확도가 일반적으로 생각하기에 모델의 성능을 대변하기에 대표적인 지표로 보이는데(식만 봐도 그럴듯 하다.) 왜 이렇게 여러한 지표들을 동시에 봐야하는 것일까?
예를 들어, 위의 모델을 모델 아래의 모델을 모델이라고 할때 모델과 모델의 정확도는 0.92로 동일하지만 모델의 A클래스에 대한 정밀도는 를 가진다.
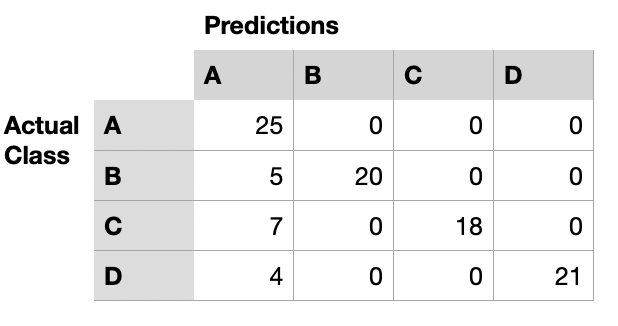
모델과 모델은 정확도는 같지만 정밀도는 20% 가까이 차이 나는 것이고 우리는 모델이 클래스B, C, D를 구별하는 특별한 피쳐가 아니라면 대부분의 경우에 대해 A클래스로만 분류한다는 오류를 의심 해볼수 있다. 실제로 머신러닝의 많은 모델이 이러한 문제를 겪고 이보다 더한 경우도 빈번히 발생한다. 따라서 우리는 정확도 뿐 아니라 다른 지표들 또한 면밀하게 관찰할 필요가 있다.
ROC곡선과 AUC.
우리의 모델이 잘 학습 되었는지 또, 다른 비교할 모델들보다 성능이 얼마나 우위에 있는지를 측정하는 다른 방법은 ROC(Receiver Operating Characteristic)곡선을 활용하는 것이다.
ROC곡선은 X축에 FPR(False Positive Rate), Y축에 TPR(True Positive Rate)로 이루어진 곡선이다. 여기서 FPR은 (1 - 특이도)이며, TPR은 민감도가 된다.
예들들어, 우리의 모델이 사진을 보고 '고양이'와 '강아지'를 분류하는 문제를 푼다고 한다면 우리는 어떠한 기준(하나의 피쳐이거나 딥러닝 결과에 대한 사후 확률이거나)에 의해 클래스를 분류하게 될텐데 그 기준점이 낮아 모든 클래스를 '고양이'라고 분류하는 경우와 그 기준점이 높아 모든 클래스를 '강아지'라고 분류할 수도 있다.
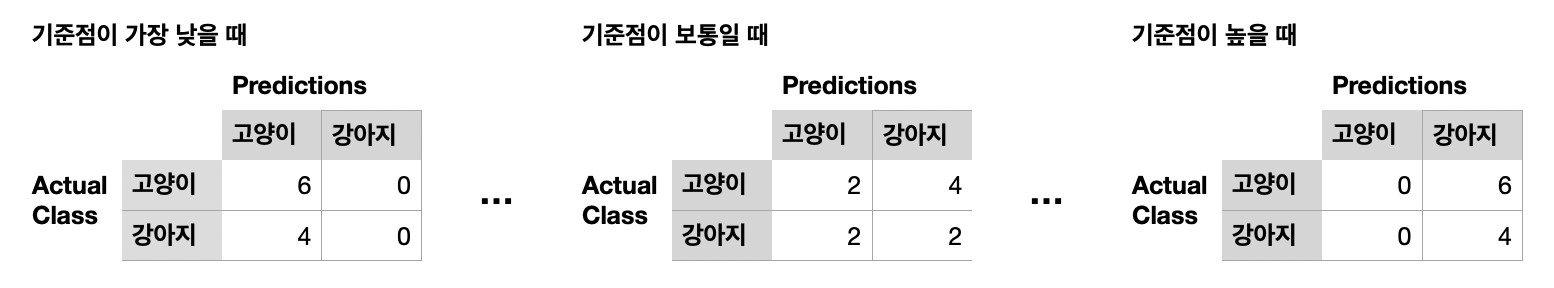
모든 경우를 '고양이'라고 분류 하는 첫번째 표의 경우 민감도는 1이 되고 특이도는 0이 된다. 따라서 FPR=1, TPR=1을 가진다. 두번째 표의 경우 FPR=0.33, TPR=0.5가 된다. 마지막으로 모두 '강아지'라고 분류한다면 FPR=0, TPR=0이 된다.
10개의 데이터에 대해 3가지의 케이스를 살펴보았지만 100개의 데이터에 대해 100개의 케이스로 이차원 평면에 점을 찍는다면 계단 모양에 ROC곡선을 그릴수 있을 것이다. 수천, 수만개의 데이터를 대상으로 한다면 ROC곡선은 점점 곡선에 형태를 띄게 된다.
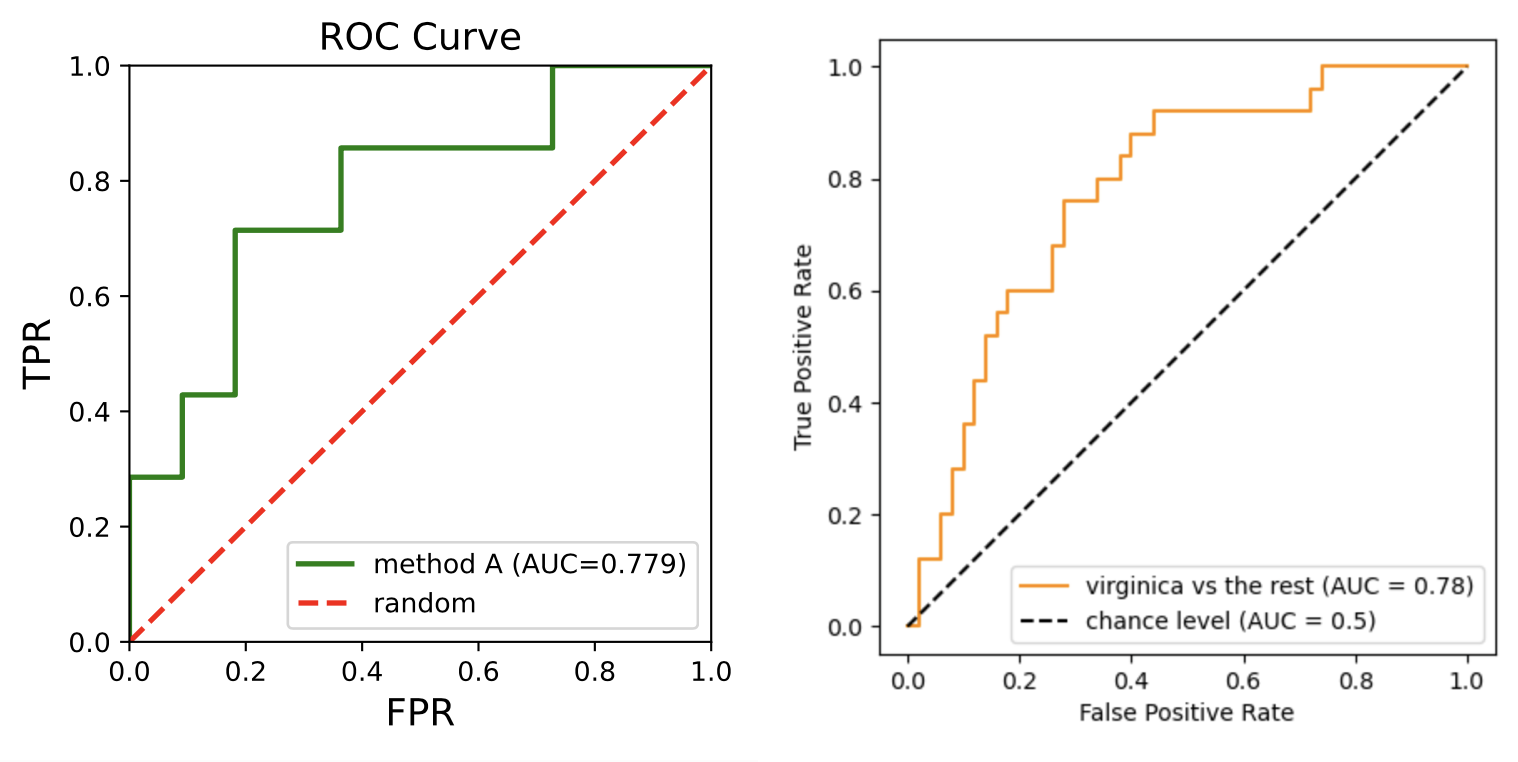
그렇다면 ROC곡선을 통해 모델의 성능을 측정한다면 어떻게 하면 될까? 이 경우 ROC곡선의 아랫면적을 비교하는 것이 타당할 수 있다. 실제로는 여러 모델을 하나의 좌표평면에 놓고 모델별로 각각의 ROC곡선을 그린 뒤에 면적을 비교하는 것이 모델간의 성능을 비교하는 방법이다. 우리는 이 ROC곡선의 면적을 AUC(Area Under Curve)라고 부른다.