Intro.
부스팅 모델, 신경망 모델 그리고 딥러닝까지 머신러닝이란 분야는 계속해서 발전하며 많은 모델들을 탄생시켰고 많은 모델들을 사장시켰다. 그 중에서 선형 모형은 간단하고 대중적이지만 그 활용도가 높은 통계학의 꽃으로 꼽히는 모형이다. 수 많은 모형이 생겨나고 없어져 왔는데 어떻게 가장 단순한 모형이 이리 오랫동안 사랑받고 또 쓰여지고 있는지 정리해 볼까 한다.
정의.
선형 모델은 최대한 정확하게 실제 데이터를 예측하는 선형 모델을 학습 시키는 것을 그 목표로 한다. 간단한 회귀식부터 시작하자면 다음과 같다.
X값은 독립변수 Y값은 종속변수 일때, 결국 이 간단한 모형의 와 값을 추정하는 것으로 선형 회귀 모델은 완성된다.
학습 방법.
선형 회귀가 학습하는 방법을 해를 구해가는 과정이라고 보고 주로 최소제곱법(least square method)이라 부른다. 최소제곱법은 평균제곱의 오차를 최소화 하는 것으로 하는데 기하학적인 의미를 가진다. 식 자체가 유클리드 거리(Eucliden distance)를 가지기 때문이다.
여기서 와 는 와 의 해이다. 즉 위의 식을 최소화 하는 것이 선형 회귀 모델의 목적인 것이다.
실제로 코드 상에서 선형 회귀 모델에 학습 과정은 다음과 같다.
import sklearn.linear_model as skl_lm

# Load Advertising dataset
ad_data = pd.read_csv('파일 위치', index_col=0)

# sklearn linear regression model 객체화
regr = skl_lm.LinearRegression()

# X값, y값 선별
# sales = 𝛽0 + 𝛽1*TV
X = ad_data['독립 변수'].values.reshape(-1, 1)
y = ad_data['종속 변수']

# linear regression 학습
regr.fit(X, y)

# 회귀계수, 절편 값 출력
print('intercept: ', regr.intercept_)    # 절편: 𝛽0
print('coefficient: ', regr.coef_[0])    # 회귀계수: 𝛽1
이런 간단한 코드 정도로 선형 모델을 학습하고 그 결과를 확인할 수 있다.
회귀의 정확한 학습 과정에 이해와 해석을 위해서 우리는 기하학 적으로 접근하는 것이 좋고 SST, SSE, SSR, MSE 등의 차이와 개념을 정립하는게 중요하다. 우선은 SST, SSE 등과 같은 개념을 알기 전에 편차, 오차, 잔차에 차이를 알아보자.
-
편차(Deviation): 관측치가 평균으로부터 떨어져 있는 정도, 즉 평균과의 차이
-
오차(Error): 예측하기 위하여 추정된 값과 실제값의 차이, 즉 예측값이 정확하지 못한 정도
-
잔차(residual): 평균이 아니라 회귀식 등으로 추정된 값과의 차이, 즉 추정된 값이 설명할 수 없어서 아직 남아있는 편차로 편차의 일부
비슷한 개념이지만 통계학적으로 분명한 차이를 가진다는 점을 알아야 한다. 해당 내용을 바탕으로 선형회귀를 정리하면 다음과 같다.
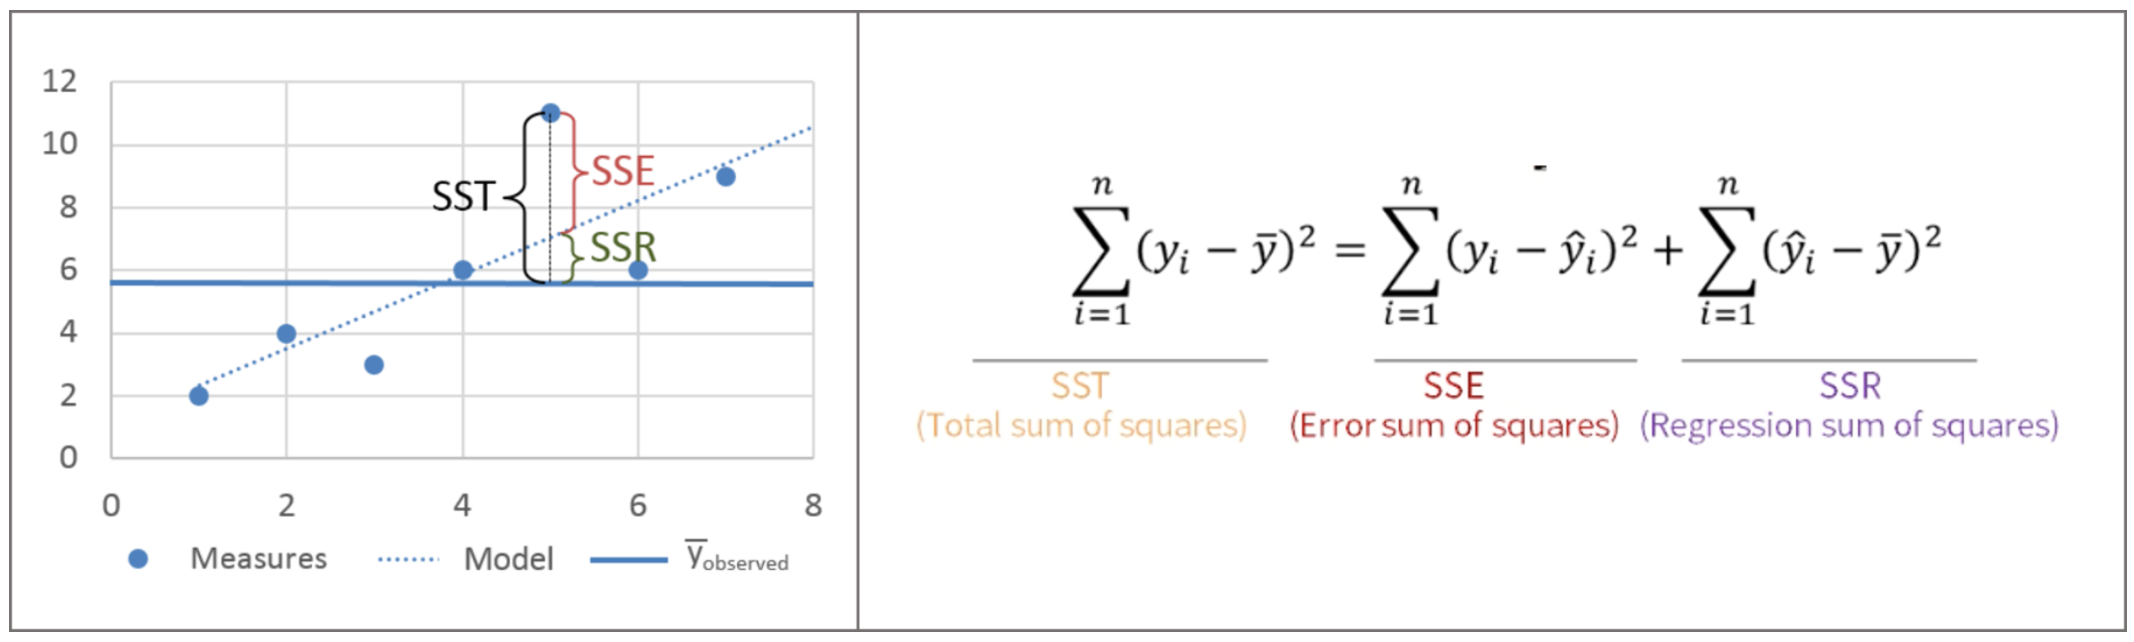
-
(Total sum of squares): 의 총 변동 ()
-
(Error sum of squares): 추정값과 실제값 차이(오차)의 제곱, 오차에 대한 변동
-
(Regression sum of squares): 직선으로 설명이 불가능한 변동, 직선에 대한 변동
-
(Mean Squares Error): 오차가 커서 값이 커지는 건지 데이터가 많아 값이 커지는지 알 수 없는 SSE의 문제를 해결 ()
-
(Regression Mean Squares): 잔차 평균 제곱의 합 ()
-
(결정계수): 독립변수가 종속변수를 얼마만큼 설명 해주는지를 가리키는 지표, 즉 설명력이며 높을 수록 독립변수가 종속변수를 많이 설명하는 것. 독립변수의 수가 증가하는 것만으로 상승하므로 결정계수만을 가지고 유용성 판단은 무리가 있음 ()
-
(조정된 결정계수): 독립 변수의 단순 증가가 결정계수를 상승시키는 것을 방지 (, : 독립변수)
회귀 모형은 결론적으로 MSE를 최소화 하는 방향으로 학습이 이루어지게 된다.
RSS(Resiual Sum of Squares)과 SSR(Regression Sum of Squares)은 다르다는 것을 알아야 한다. 많은 곳에서 RSS와 SSR을 혼용하는 경우가 있는데 RSS는 설명 불가능한 수치에 관한 것이고 SSR은 설명 가능한 수치에 관한 것이다.
해석 방법.
언제나 모형을 만들고 학습 시키는 것보다 모형을 해석하고 최적화 하는 과정이 더 힘들고 어려운 일이다. 그나마 선형 회귀 모형은 그 모형 자체가 간단하여 해석이 용이 한 편이지만 최소한 몇가지 알아야 할 개념은 존재한다. 위에서 이야기한 와 같은 값들이 이에 해당한다.
실제 코드상에서는 다음과 같이 확인 할 수가 있다.
# 잔차 계산
y_pred = regr.predict(np.array(ad_data['TV']).reshape(-1, 1))
rasiduals = ad_data['sales'] - y_pred
rasiduals.describe()    # 잔차 통계치 확인

# SST, SSE, SSR 값 확인
sst = ((ad_data['sales'] - ad_data['sales'].mean())**2).sum()
sse = ((ad_data['sales'] - y_pred)**2).sum()
ssr = ((y_pred - ad_data['sales'].mean())**2).sum()
print('SST: ', sst)
print('SSE: ', sse)
print('SSR: ', ssr)
print('SSE+SSR: ', sse+ssr)

# R^2, Adjusted R^2 값 확인
r2 = ssr/sst
adjusted_r2 = 1 - (len(ad_data['sales']) - 1)*(1 - r2)/(len(ad_data['sales']) - 1 - 1)
print('R2: ', r2)
print('Adjusted R2: ', adjusted_r2)
코드 전문에서 실제 데이터에 대한 해석을 볼 수 있으니 궁금하다면 확인해볼 수 있다.
다항 선형 회귀.
다중 선형 회귀라고 해서 단순 선형 회귀와 크게 달라지는 것은 없다 수식으로 보아도 단순 베타의 값이 늘어나는 정도니까 말이다.
예시로써 2개의 변수를 사용하여 선형회귀를 표현하면 다음과 같을 것이다.
# TV, radio 2가지 변수를 활용한 모델
# sklearn linear regression 객체화
regr2 = skl_lm.LinearRegression()

# TV, radio 두 변수의 대한 sales 회귀
# 독립, 종속 변수 분할
# sales = 𝛽0 + 𝛽1*TV + 𝛽2*radio
X = ad_data[['TV', 'radio']]
y = ad_data[['sales']]

# linear regression 학습
regr2.fit(X, y)

# TV, radio 독립 변수에 대한 sales 종속변수 시각화
fig = plt.figure(figsize=(8, 6))
ax3d = plt.axes(projection="3d")
fig.suptitle('Regression: TV, radio -> sales', fontsize=14)

# 평면 시각화
tv = np.arange(ad_data['TV'].min(), ad_data['TV'].max())             # TV 변수 분포
radio = np.arange(ad_data['radio'].min(), ad_data['radio'].max())    # radio 변수 분포
x1, x2 = np.meshgrid(tv, radio, indexing='xy')    # TV, radio 변수 2차원 격자로 변환
z = np.zeros((radio.size, tv.size))
for (i, j), _ in np.ndenumerate(z):
    z[i, j] = x1[i, j]*regr2.coef_[0][0] + x2[i, j]*regr2.coef_[0][1] + regr2.intercept_[0]    # 학습된 회귀결과에 따라 sales값 결정
ax3d.plot_surface(x1, x2, z)

# 산점도 시각화
ax3d.scatter3D(ad_data['TV'], ad_data['radio'], ad_data['sales'], c='r')

ax3d.set_xlabel('TV')
ax3d.set_ylabel('radio')
ax3d.set_zlabel('sales')

plt.show()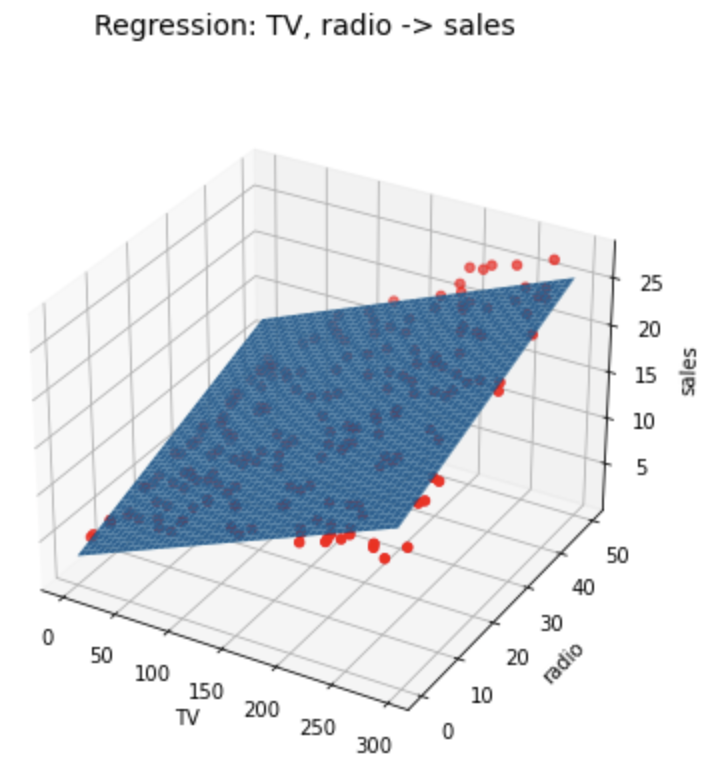
과적합 방지.
선형 회귀 모형 자체가 단순성이 강점인지라 과적합을 크게 신경쓸 부분은 아니지만, 어쨌든 머신러닝에서 과적합은 뗄레야 뗄 수 없는 항상 맞서 싸워야 하는 적과도 같다. 선형 회귀 모형에서의 과적합 방지 중 규제(Regulation)에 대해 이야기 해볼까 한다.
규제를 활용한 선형 회귀에 대표적 모형은 L2 규제를 사용하는 릿지(Ridge)와 L1 규제를 사용하는 라쏘(Lasso)가 있다.
기존의 회귀식을 값을 추정한다 할 때 다음 식과 같다면
=
릿지와 라쏘 규제의 식은 다음과 같게 된다.
Ridge
+
Rasso
+
릿지와 라쏘 회귀식은 모두 패널티 항을 더하는 것으로 이루어져있다. 릿지 회귀식은 제곱의 값을 더한다는 것과 라쏘 회귀식은 절댓값을 더해준다는 차이만 있다.
이러한 제약 조건은 가중치의 모든 원소가 0이 되거나 0에 가깝게 하는 것에 있다. 제곱의합을 최소화 하기 때문에 계수의 크기가 줄어들고 과적합이 방지되게 된다.
라쏘는 가중치들이 0이 될 수 있지만 릿지는 0에 가까워질 뿐 0이 되지는 않는 차이도 가지기 때문에 특성(독립 변수)의 중요도가 비슷하다면 릿지가, 중요한 변수가 일부 특정되어 있다면 라쏘가 더 괜찮은 모델이라 할 수 있다.
하이퍼파라미터인 가 작으면 오버피팅, 너무 크면 언더피팅이 일어날 수 있으므로 적당한 을 찾아주어야 한다. 보통 Cross-validation으로 찾을 수 있다.