본 블로그 글은 <Do it! 정직하게 코딩하며 배우는 딥러닝 입문>을 기반으로 요점 정리하는 형식으로 만들었습니다.
3-1 선형 회귀에 대해 알아보고 데이터를 준비합니다
선형 회귀란
선형 회귀(Linear Regression)는 통계학과 머신 러닝에서 가장 기본적이며 널리 사용되는 예측 모델 중 하나입니다. 이 모델은 종속 변수와 하나 이상의 독립 변수 간의 관계를 나타내기 위해 사용됩니다. 주로 연속적인 값을 가지는 변수들 간의 관계를 분석하고 예측하는 데에 활용됩니다.
선형 회귀는 '선형'이라는 이름에서 알 수 있듯이, 독립 변수와 종속 변수 사이의 관계를 선형적으로 가정합니다. 이는 독립 변수의 값이 변할 때 종속 변수도 일정한 비율로 변화한다는 가정을 의미합니다. 선형 회귀는 주어진 데이터 포인트들과 가장 잘 맞는 직선(선형 함수)을 찾는 과정입니다.
간단한 단변량 선형 회귀의 경우를 예로 들어보겠습니다. 여기서 독립 변수는 하나만 있으며, 종속 변수와의 관계를 직선으로 모델링하려고 합니다. 이 관계를 수식으로 나타내면 다음과 같습니다
y = ax + b
- y는 종속 변수의 값,
- x는 독립 변수의 값,
- a은 직선의 기울기(회귀 계수)
- b는 y 절편입니다.
선형 회귀 모델을 만들 때 목표는 주어진 데이터에 가장 적합한 회귀 계수 a와 절편 b를 찾는 것입니다. 이를 위해 주로 최소제곱법(Least Squares Method)이나 경사 하강법(Gradient Descent)과 같은 방법을 사용합니다. 최소제곱법은 관측된 데이터와 모델 예측치 간의 오차를 최소화하는 회귀 계수를 찾는 방법이며, 경사 하강법은 비용 함수를 최소화하기 위해 반복적으로 회귀 계수를 조정하는 방법입니다.
선형 회귀는 예측, 분석, 추세 예측 등 다양한 분야에서 활용되며, 머신 러닝의 기반이 되는 중요한 개념 중 하나입니다.
문제 해결을 위해 당뇨병 환자의 데이터 준비하기
머신러닝, 딥러닝 패키지에는 인공지능 학습을 위한 데이터 세트가 있는데, 사이킷런과 케라스에서 다양한 데이터 세트를 제공합니다.
사이킷런 설치
실습에 앞서서 사이킷런을 설치하겠습니다.
명령 프롬프트에 다음과 같은 코드를 입력합니다.
pip install scikit-learn사이킷런에서 당뇨병 환자 데이터 가져오기
1. load_diabets() 함수로 당뇨병 데이터 준비하기
사이킷런의 datasets 모듈에 있는 load_diabetes() 함수를 import 한 후 매개변수 값을 넣지 않은 채로 호출하면 diabetes에 당뇨병 데이터가 저장됩니다.
from sklearn.datasets import load_diabetes
diabetes = load_diabetes()
2. 입력과 타깃 데이터 크기 확인하기
diabetes의 속성 중 data 속성과 target 속성에는 우리에게 필요한 입력과 타깃 데이터가 넘파이 배열로 저장되어 있습니다. 넘파이 배열의 크기는 shape 속성에 저장되어 있으므로 다음과 같이 shape의 속성을 출력하여 입력 데이터와 타깃 데이터의 크기를 확인할 수 있습니다.
print(diabetes.data.shape, diabetes.target.shape)결과값은 다음과 같습니다.
(442, 10) (442,)
결과를 통해서 알 수 있는 점은 442 X 10 크기의 2차원 배열이고 442개의 요소를 가진 1차원 배열이라는 것을 알 수 있습니다.
여기서 행은 샘플(sample)이고, 열은 샘플의 특성(feature)입니다.
이때 입력 데이터의 특성은 다른 말로 속성, 독립 변수(independent varibale), 설명 변수(explanatory variable) 등으로 부릅니다.
3. 입력 데이터 자세히 보기
diabetes.data에 저장된 입력데이터 일부만을 출력해보겠습니다.
print(diabetes.data[0:3])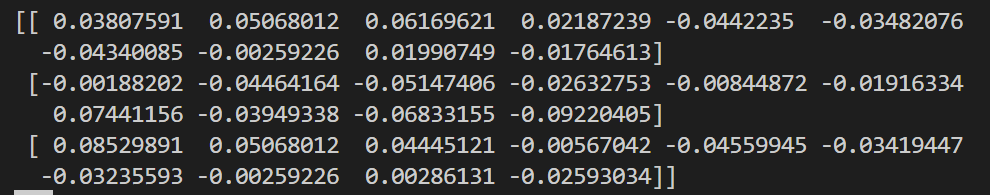
결과는 위에 사진과 같은데 [ ]로 각각 하나의 샘플들의 특성들을 담고 있는 것을 알 수 있습니다.
4. target 데이터 자세히 보기
diabetes.data와 마찬가지로 인덱스를 슬라이싱 해서 출력해 보겠습니다.
print(diabetes.target[0:3])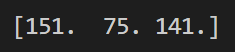
위의 결과에서 151. 은 샘플 [ 0.03807591 0.05068012 0.06169621 0.02187239 -0.0442235 -0.03482076
-0.04340085 -0.00259226 0.01990749 -0.01764613] 과 대응하는 관계입니다. 수치에 대한 해석은 전문가의 영역이고, 우리가 할 일은 둘 사이의 규칙(모델)을 찾으면 되는 일입니다.
당뇨병 환자 데이터 시작화하기
입력 데이터와 타깃 데이터의 관계를 알기 쉽게 이해하려면 데이터를 시각화 하는 것이 좋습니다.
그래서 matplotlib를 활용하여 시각화를 진행합니다.
matplotlib도 마찬가지로 명령프롬프트에 다음과 같은 코드를 입력합니다.
pip install matplotlib최종적으로 다음과 같은 메세지가 나오면 성공한 것 입니다.

- 맷플롯립의 scatter() 함수로 산점도 그리기
각 샘플마다 10개의 특성이 있었지만 이 특성들을 모두 그래프로 표현하려면 3차원 이상의 그래프를 요구 합니다. 하지만 3차원 이상의 그래프는 그릴 수 없으므로 실습은 1개의 특성만을 사용합니다. 여기서는 세 번째 특성과 타깃
import matplotlib.pyplot as plt

plt.scatter(diabetes.data[:,2], diabetes.target)
plt.xlabel('x')
plt.ylabel('y')
plt.show()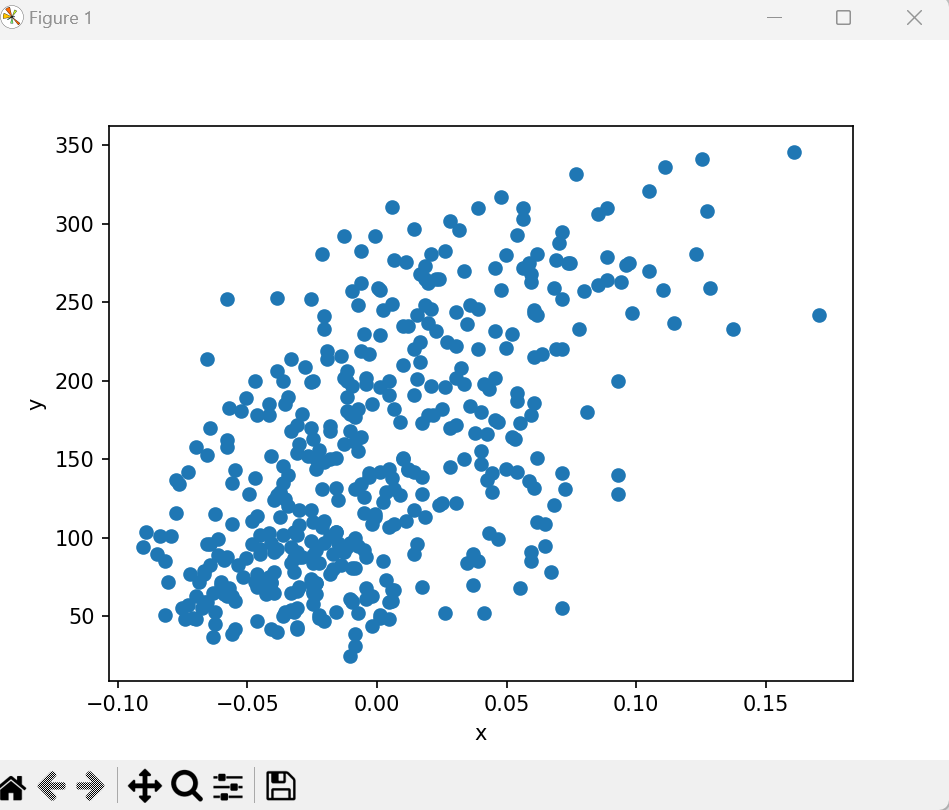
결과는 다음 사진과 같은데 x축은 diabetes.data의 세번째 특성이고, y축은 diabetes.target입니다. 그래프를 보면 세번째 특성과 타깃 데이터는 정비례 관계가 있음을 알 수 있습니다.
