1. Project Overview (프로젝트 개요)
1.1 프로젝트 명과 개발 배경
| 항목 | 내용 |
|---|---|
| 프로젝트 명 | Malware Detection |
| 서비스 형태 | React 기반 웹 UI와 FastAPI 기반 분석 API로 구성된 Windows PE 정적 분석 서비스 |
| 분석 대상 | 단일 PE 파일 또는 폴더 안의 다중 파일 |
| 분석 원칙 | 업로드 파일을 실행·치료·수정·삭제하지 않고 바이트와 PE 헤더를 읽기 전용으로 처리 |
| 핵심 접근 | 1차 XGBoost 선별 → 필요 시 2차 MalConv2 계열 패밀리 분류 |
| 최종 목적 | 정상으로 보이는 파일과 위험 의심 파일을 구분하고, 검토 우선순위와 유형 정보를 제공 |
Windows 실행 파일은 .exe처럼 보이는 확장자만으로 신뢰할 수 없다. 또한 다운로드 폴더나 공유 폴더에는 문서·이미지·실행 파일이 섞여 있어, 사용자는 어떤 파일부터 확인해야 하는지 빠르게 판단하기 어렵다.
이 프로젝트는 이러한 문제를 대상으로 다음 질문에 답하는 보조 분석 서비스를 목표로 한다.
- 입력 파일이 실제 Windows PE 구조를 가진 파일인가?
- 유효한 PE라면 1차 정적 특징 기준에서 위험 신호가 낮은가, 의심되는가, 높은가?
- 위험 방향의 결과라면 2차 원시 바이트 모델은 어떤 악성 유형을 가장 높게 보는가?
- 두 모델이 불일치하거나 유형 점수가 낮을 때, 이를 단정하지 않고 어떻게 표현할 것인가?
따라서 본 서비스는 Windows Defender·EDR·샌드박스를 대체하는 보안 제품이 아니다. 파일 실행 전 선별과 결과 해석을 돕는 교육용·보조 정적 분석 서비스로 범위를 명확히 둔다.
1.2 문제 정의
초기 문제는 “악성코드를 탐지할 수 있는 분류 모델을 만든다”였지만, 최종적으로는 아래처럼 구체화했다.
정상 파일과 악성 의심 PE 파일을 읽기 전용 정적 분석으로 우선 선별하고, 위험 파일에 한해 유형 분류와 불확실성 정보를 함께 제공한다.
이 정의에는 두 가지 제약을 포함한다.
- 정적 분석만으로 실제 실행 행위, 감염 여부, 정보 유출, 네트워크 통신을 확정하지 않는다.
- 모델의 점수는 보정(calibration) 전 분류 점수이므로 실제 악성 확률이나 자동 차단 근거로 표현하지 않는다.
2. 기획 변경 및 문제 해결 과정
2.1 초기 접근법: 파일 이미지화 기반 분류
초기 기획은 실행 파일의 바이트를 Grayscale 이미지 등 2차원 이미지로 변환한 뒤, 컴퓨터 비전 분류 모델로 정상·악성 또는 악성 유형을 구분하는 방식이었다.
이 방식은 바이트를 0~255의 픽셀 값으로 대응시키고, 일정한 폭으로 줄바꿈해 이미지로 재배열한다. CNN이나 Vision Transformer는 이미지에서 질감·반복 패턴·국소 구조를 학습하므로, 원시 바이트를 즉시 이미지 모델에 넣을 수 있다는 장점이 있다.
초기에는 서로 다른 귀납 편향(inductive bias)을 비교하기 위해 아래 모델을 후보로 검토했다.
| 후보 모델 | 핵심 구조 |
|---|---|
| EfficientNetV2 | Fused-MBConv·MBConv, 복합 스케일링 |
| ResNet | Skip Connection을 가진 잔차 블록 |
| Swin Transformer | Window Attention·Shifted Window |
| VGG16 | 작은 3×3 합성곱을 깊게 쌓는 단순 CNN |
| ConvNeXt | 현대화한 CNN 블록·큰 커널·LayerNorm |
2.2 초기 방식의 한계
이미지화 접근은 모델을 빠르게 실험할 수 있지만, 파일 보안 분석 서비스의 핵심 질문에는 다음 한계가 있었다.
| 관찰된 한계 | 기술적 이유 | 서비스 관점의 영향 |
|---|---|---|
| PE 구조 의미의 약화 | 바이트를 줄 단위로 재배열하면 헤더·섹션·Import Table·Overlay 같은 파일 구조의 경계가 이미지 좌표에서 명시적으로 보존되지 않음 | “왜 이 파일이 위험한가?”를 PE 구조와 연결해 설명하기 어려움 |
| 이미지 폭 선택에 따른 표현 변화 | 같은 바이트라도 이미지 너비·리사이즈·정규화 방식에 따라 서로 다른 시각 패턴이 생성됨 | 모델 결과가 파일 의미보다 변환 규칙에 영향을 받을 수 있음 |
| Grad-CAM 해석의 한계 | 중요도 지도는 이미지상 영향 위치를 보여 줄 뿐, 해당 픽셀이 실제 어떤 PE 코드·데이터·행위를 뜻하는지는 바로 알 수 없음 | 악성 행위를 증명하는 근거처럼 제시할 수 없음 |
| 단일 분류 결과의 정보 부족 | 정상/악성 한 번의 결과만으로는 검토 우선순위, 유형, 불확실성을 표현하기 어려움 | 사용자가 후속 확인을 결정하기 어려움 |
| 기존 이미지 분류와의 차별성 부족 | 악성 바이트 이미지 분류는 기존 연구·예제가 많은 접근 | 프로젝트만의 파일 분석 흐름과 기술 의사결정이 약하게 보일 수 있음 |
특히 Grad-CAM 결과는 “모델이 이미지의 어디에 반응했는가”에는 도움이 되지만, 그 위치가 실제 악성 행위나 특정 악성 코드 패턴이라는 사실을 보장하지 않는다. 이 문제는 단순히 더 높은 정확도의 이미지 모델을 선택해서 해결되지 않는다.
2.3 피드백 수용과 최종 기획 전환
초기 피드백의 핵심은 다음과 같았다.
단순히 파일을 이미지로 변환해 분류하는 방식만으로는 기존 접근과 차별성이 부족하며, 파일 구조와 원시 데이터의 의미를 더 직접적으로 반영할 필요가 있다.
이에 따라 프로젝트는 “이미지 분류 성능 비교”에서 “PE 파일을 안전하게 선별하고, 위험 결과를 단계적으로 해석하는 서비스”로 범위를 재정의했다.
| 초기 방향 | 최종 방향 | 전환의 논리 |
|---|---|---|
| 바이트 이미지를 하나의 이미지 모델에 입력 | PE 구조 검증 후 1차·2차 계층형 추론 | 유효하지 않은 파일을 먼저 분리하고, 비용이 큰 다중 클래스 모델을 필요한 파일에만 실행 |
| 이미지 패턴 중심 분류 | 1차는 PE 정적 특징, 2차는 원시 바이트 | 구조적 신호와 원시 바이트 문맥을 역할에 맞게 분리 |
| Normal/Malware 단일 결론 | Normal, 악성 유형 의심, 판정 충돌, 분류 불확실 | 모델 불일치와 낮은 신뢰도를 숨기지 않음 |
| Grad-CAM 기반 이미지 중요도 | 요청 시 단계적 가림(occlusion) 재추론 | 모델 점수 변화가 큰 파일 오프셋 후보를 제시하되 실제 행위 증거로 과장하지 않음 |
| 모델 실험 중심 | React·FastAPI 웹 서비스와 분석 흐름 중심 | 사용자가 파일 선택부터 결과 확인·방어적 안내까지 경험할 수 있게 구성 |
2.4 MalConv2 학습 문제와 데이터 관점의 개선
2차 다중 클래스 모델에서는 원시 바이트 입력의 용량과 클래스 분포가 중요한 과제였다. 원시 PE 파일은 길이가 균일하지 않고, 악성 유형별 표본 수 차이가 클 수 있어 다음 문제가 발생한다.
- 긴 원시 바이트 입력은 GPU 메모리·I/O·학습 시간을 크게 사용한다.
- 다중 클래스 데이터가 불균형하면 빈도가 높은 유형 중심으로 학습되어 macro F1이 낮아질 수 있다.
- 악성 유형별 파일 길이·패킹 방식·수집 시점 차이가 모델이 학습하는 분포에 영향을 준다.
이에 팀은 BODMAS를 2차 분류의 기준 데이터셋으로 유지했다. 현재 웹 서비스에 연결된 2차 모델 번들도 config.json의 DATASET_NAME과 class_mapping.txt 기준으로 BODMAS의 benign 1개와 악성 유형 16개, 총 17개 클래스 체계를 사용한다. 다만 BODMAS 내부에서 유형별 표본 수가 고르지 않아, 일부 클래스가 충분한 학습 신호를 갖지 못하는 문제가 있었다.
이를 보완하기 위해 RawMal-TF를 함께 사용했다. RawMal-TF는 악성코드 타입과 패밀리 라벨이 부여된 원시 Windows PE 악성 바이너리와 사전 추출 특징 벡터를 제공하는 공개 데이터셋이다. 팀은 RawMal-TF에서 BODMAS의 부족한 악성 유형에 대응하는 샘플을 선별하고, BODMAS의 17개 클래스 매핑에 맞춰 라벨을 정렬한 뒤 학습 데이터에 보완했다. 즉, BODMAS는 최종 분류 체계와 번들의 기준이며, RawMal-TF는 클래스 불균형을 완화하기 위한 보완 데이터 소스다.
현재 저장된 2차 학습 실행 정보는 다음을 확인할 수 있다.
| 항목 | 기록된 값 | 해석 |
|---|---|---|
| 클래스 수 | 17개 | benign 1개와 악성 유형 16개 |
| 데이터 크기 | 약 29.8GB | 원시 바이트 기반 학습 데이터 규모 |
| 학습 환경 | NVIDIA A100 80GB, bf16 | 대용량 원시 바이트 학습을 위한 GPU 환경 |
| 학습 설정 | 30 epoch, batch size 128 | 현재 저장된 학습 실행 기준 |
| 최적 epoch | 29 | 검증 macro F1이 가장 높았던 시점 |
| 최고 검증 macro F1 | 0.8674 | 클래스 불균형을 고려하는 거시 평균 F1 기준 |
3. 시스템 아키텍처 및 파이프라인
3.1 전체 데이터 흐름
flowchart TD
    A[사용자: 단일 파일 또는 폴더 업로드] --> B[FastAPI: 임시 사본 저장]
    B --> C{PE 구조 검증\nMZ / e_lfanew / PE\0\0 / COFF}
    C -- 비 PE --> U[미지원 결과]
    C -- 손상 또는 읽기 실패 --> E[오류 결과]
    C -- 유효 PE --> D[1차 XGBoost\n341개 PE 정적 특징]
    D -- 점수 < 0.10 --> N[Normal]
    D -- 0.10 이상 --> F[2차 MalConv2 계열\n원시 바이트 전체]
    F --> G{최고 클래스 점수}
    G -- 0.70 미만 --> Q[Unknown\n분류 불확실]
    G -- benign --> R[판정 충돌\n1차 위험 / 2차 정상]
    G -- 악성 유형 --> S[악성 유형 의심]
    S --> T[선택: 악성 유형 안내 / Gemini 조언]
    S --> V[선택: 단계적 전체 가림 재추론\n64KB → 4KB → 256B]
    V --> W[상위 3개 영향 후보 구간]
분석 작업은 FastAPI의 메모리 기반 작업 관리자가 순차적으로 처리한다. 폴더 분석에서 한 파일이 비-PE·손상·추론 오류여도 다음 파일의 분석은 계속한다. 프런트엔드는 REST API로 작업을 만들고, 초기 분석 진행률은 SSE(Server-Sent Events)로 수신한다.
3.2 입력 검증과 읽기 전용 정책
분석 전에는 확장자를 신뢰하지 않고 다음을 순서대로 확인한다.
- DOS 헤더의
MZ서명 - DOS 헤더
0x3C위치의e_lfanew가 가리키는 PE 헤더 오프셋 범위 - NT 헤더의
PE\0\0시그니처 - COFF 헤더의 Machine 필드
검증 결과는 다음처럼 분리한다.
| 결과 | 의미 | 모델 실행 여부 |
|---|---|---|
| 유효 PE | 최소 PE 헤더 구조가 확인됨 | 1차 모델 실행 |
| 미지원 | MZ 서명이 없거나 PE 형식이 아님 | 실행하지 않음 |
| 오류 | MZ는 있으나 헤더가 손상됐거나, 읽기·추론에 실패함 | 해당 파일만 중단 |
3.3 1차 모델: XGBoost 기반 정상/악성 선별
채택 이유
1차는 모든 유효 PE 파일을 빠르게 통과하는 관문이므로, 구조화된 정적 특징에 강하고 추론 비용이 낮은 XGBoost를 채택했다.
- 표 형식 특징에 적합: 파일 크기·엔트로피·헤더·섹션·Import/Export·데이터 디렉터리·Overlay·바이트 히스토그램처럼 서로 성격이 다른 수치 특징을 함께 다룰 수 있다.
- 비선형 상호작용 학습: 단일 특징 하나가 아니라 “섹션 수, 엔트로피, 실행 권한, Import 구조” 등의 조합에서 나타나는 위험 신호를 트리 앙상블로 학습한다.
- 실무형 선별 비용에 적합: 2차 원시 바이트 딥러닝보다 가벼워, 모든 PE에 먼저 적용하고 위험 방향 결과만 다음 단계로 넘길 수 있다.
- 특징 계약 검증: 실제 서비스는 학습 당시의 341개 특징 이름·순서·특징 추출기 해시를 번들에서 확인한다. 웹 서버에서 특징을 임의로 다시 구현해 잘못된 열 순서로 예측하는 위험을 줄인다.
341개 정적 특징 구성
| 특징 그룹 | 개수 | 예시 |
|---|---|---|
| 일반 파일 통계 | 5 | 파일 크기, 전체 엔트로피, 0 바이트 비율 |
| 헤더·Entry Point | 20 | Machine, 섹션 수, Entry Point 위치, 정렬 크기 |
| 섹션 통계 | 19 | 섹션 크기·엔트로피·권한·RWX 개수 |
| Import·Export | 5 | Import DLL 수, 심볼 수, Export 수 |
| 데이터 디렉터리 | 32 | Import·Resource·TLS·IAT 등 존재 여부와 크기 |
| Overlay | 4 | 섹션 뒤 후행 데이터 존재·크기·엔트로피 |
| 정규화 바이트 히스토그램 | 256 | 값 0~255 각각의 빈도 |
| 합계 | 341 | 학습·추론에서 동일한 순서 유지 |
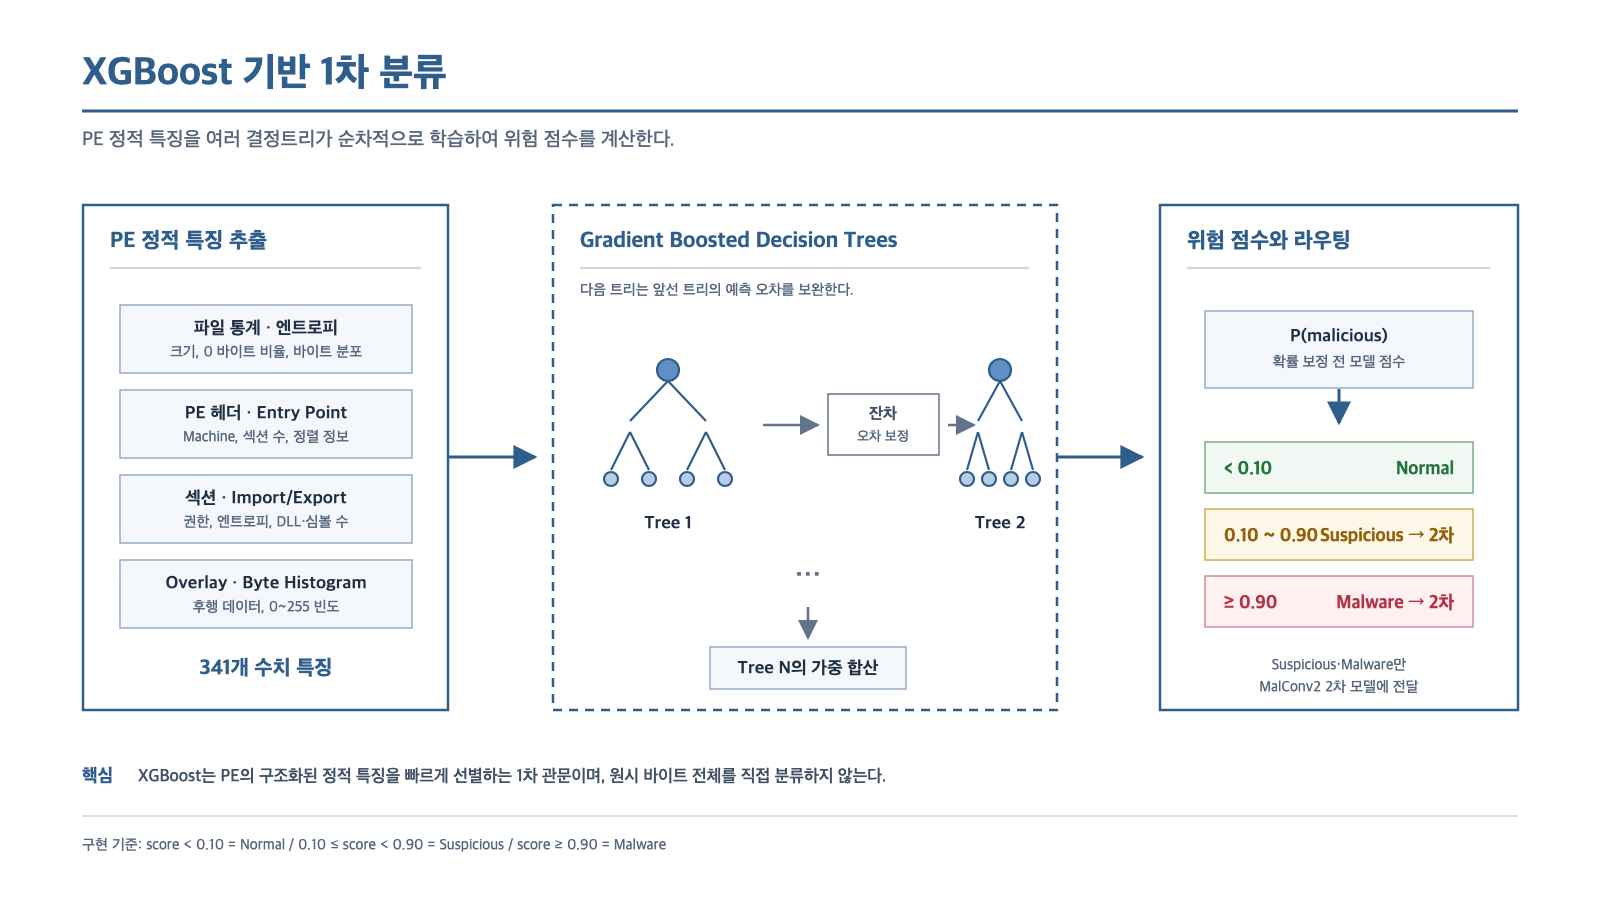
XGBoost는 파일의 원시 바이트 전체를 바로 신경망에 넣지 않는다. PE 헤더·섹션·Import/Export·Overlay·바이트 히스토그램에서 만든 341개 수치 특징을 입력으로 받고, 여러 결정트리가 앞선 트리의 오차를 순차적으로 보완한 뒤 위험 점수를 계산한다. 이 점수를 임계값과 비교해
Normal·Suspicious·Malware로 나누며, 뒤의 두 결과만 MalConv2 2차 분류로 전달한다.
1차 라우팅 정책
| 점수 구간 | 1차 결과 | 2차 전달 | 의미 |
|---|---|---|---|
< 0.10 | Normal | 전달하지 않음 | 현재 정적 특징 기준 위험 점수가 낮음 |
0.10 이상 ~ 0.90 미만 | Suspicious | 전달 | 의심 구간이므로 유형 분류로 추가 확인 |
0.90 이상 | Malware | 전달 | 1차 모델의 위험 점수가 높은 구간 |
임계값은 validation 분할에서 결정됐으며, 1차 점수는 확률 보정 전 값이다. 따라서 UI에서는 점수 자체보다 구간 결과와 후속 단계 여부를 중심으로 해석한다.
3.4 2차 모델: MalConv2 계열 악성 유형 분류
채택 이유
2차 모델은 1차에서 Suspicious 또는 Malware로 분류된 파일만 대상으로 한다. 이 단계는 사람이 설계한 PE 정적 특징만으로 충분하지 않을 수 있는 원시 바이트 문맥을 학습해, 세부 유형을 구분하는 역할을 맡는다.
- 원시 바이트 직접 입력: 이미지를 만들거나 수작업 특징만으로 치환하지 않고 파일 바이트
0~255를 직접 입력한다. - 긴 파일 처리:
LowMemConv계열의 청크 스캔 방식을 사용한다. 현재65,536 bytes는 파일을 그 길이로 자르는 최대 길이가 아니라 내부 스캔 청크 크기다. - 다중 클래스 분류:
benign과 16개 악성 유형, 총 17개 클래스의 softmax 점수를 계산한다. - 모델 구조 검증: 가중치·클래스 매핑·설정의 일치를 확인한 뒤 추론한다. 현재 체크포인트에
context_net가중치가 있으면 Global Context 계열 MalConv 구조를 선택해 strict loading을 수행한다.
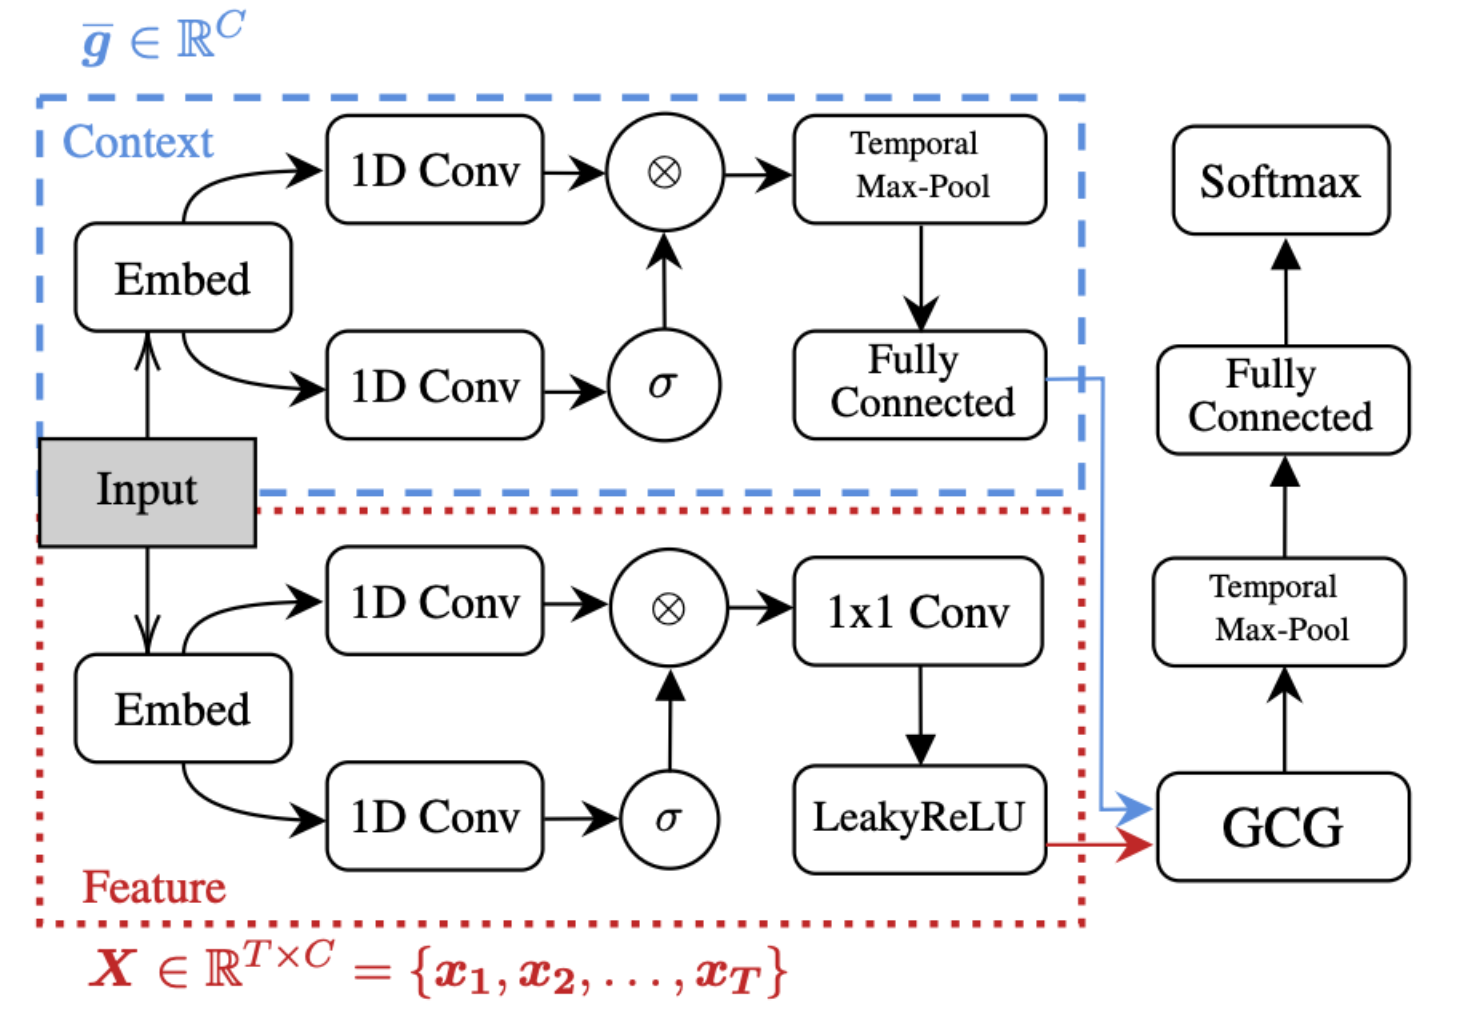
MalConv2-GCG는 파일을 이미지로 바꾸지 않고 원시 바이트를 토큰으로 입력한다. Context Path는 파일 전체의 문맥을 요약하고, Feature Path는 1D Convolution으로 지역 바이트 패턴을 추출한다. 전역 문맥 게이트는 유형 분류에 덜 중요한 채널을 낮추고 중요한 패턴을 상대적으로 강조한다. 이후 시간 축 최대 풀링과 완전연결 계층을 거쳐 17개 클래스 점수를 계산한다.
원시 바이트 전처리와 내부 구조
파일 원시 바이트 0~255
        ↓
토큰 1~256으로 이동 (0은 Padding 전용으로 예약)
        ↓
Byte Embedding
        ↓
병렬 1D Convolution / Gating 또는 Context 경로
        ↓
Temporal Max Pooling
        ↓
Fully Connected Layer
        ↓
17개 클래스 Softmax
현재 서비스는 원본 파일 전체 바이트를 보존해 모델 어댑터에 전달한다. 바이트 값에 1을 더해 1~256 토큰으로 바꾸고, 0은 모델의 padding에만 사용한다. 이 처리는 실제 0x00 바이트와 패딩이 혼동되는 문제를 방지한다.
2차 결과와 최종 상태 정책
| 1차 결과 | 2차 최고 클래스·점수 | 최종 표시 | 해석 |
|---|---|---|---|
Normal | 2차 미실행 | Normal | 1차 기준 위험도가 낮음 |
Suspicious/Malware | 악성 유형, 점수 0.70 이상 | 악성 유형 의심 | 두 단계가 위험 방향으로 이어짐 |
Suspicious/Malware | benign, 점수 0.70 이상 | 판정 충돌 | 1차 위험 결과와 2차 정상 최고 클래스가 불일치 |
Suspicious/Malware | 최고 점수 < 0.70 | 분류 불확실 | 유형을 특정할 근거가 부족하여 Unknown 처리 |
2차 0.70 임계값은 현재 검증 데이터 기반 확률 보정 전의 Unknown 처리 기준이다. 이 값은 설정 파일로 분리되어 있어 향후 calibration 또는 재평가 결과에 따라 API를 바꾸지 않고 조정할 수 있다.
3.5 결과 해석 보조 기능
악성 유형 의심 결과에는 아래 보조 기능을 제공한다.
| 기능 | 입력 | 동작 | 제한 |
|---|---|---|---|
| 악성 유형 안내 | 2차 유형·최종 상태 | 서버가 유형별 일반 방어 안내를 반환 | 실제 감염·행위를 확정하지 않음 |
| Gemini AI 전문가 조언 | 1·2차 결과와 사용자가 고른 제한된 상황 메타데이터 | 사용자가 요청할 때만 방어적 조언 생성 | 원시 바이트·파일명·경로·문자열을 외부 LLM에 보내지 않음 |
| 단계적 영향 구간 분석 | 악성 유형 의심 파일과 2차 기준 점수 | 64KB → 4KB → 256B 단위로 가리고 재추론해 상위 3개 후보 반환 | 영향 위치는 모델 점수 변화 후보일 뿐, 실제 악성 행위 증거가 아님 |
3.6 FastAPI 백엔드 구현 구조
백엔드는 React 화면에서 업로드한 단일 파일 또는 폴더 파일 목록을 받아, PE 검증과 두 단계 모델 추론을 순서대로 수행한다. 분석 시간이 파일마다 다를 수 있으므로 업로드 요청을 받자마자 분석 작업 ID를 반환하고, 이후 진행 상태와 결과를 작업 단위로 조회하는 방식으로 구성했다.
React 브라우저
  │ 파일·폴더 업로드 / 작업 상태·진행률 요청
  ▼
FastAPI Router
  │ /api/v1/analyses/file, /folder
  ▼
AnalysisManager
  ├─ PE Validator
  ├─ 1차 XGBoost
  ├─ 필요 시 2차 MalConv2-GCT
  └─ 최종 상태 조합
  ▼
작업 결과 반환 → React 결과 화면
앱 시작점과 API 연결
main.py는 FastAPI 애플리케이션을 만들고, React 개발 서버의 요청을 위한 CORS와 분석 라우터를 등록한다. lifespan에는 프로세스 전체가 공유할 분석 관리자를 연결해 요청마다 모델 관리 객체가 새로 만들어지지 않도록 했다.
app = FastAPI(
    title=resolved_settings.title,
    version=resolved_settings.version,
    lifespan=create_analysis_lifespan(manager_factory),
)

app.add_middleware(CORSMiddleware, ...)
app.include_router(analyze_router, prefix="/api/v1")
분석 작업 생성 API
단일 파일 분석 API는 파일을 받은 뒤 전체 추론이 끝날 때까지 HTTP 연결을 붙잡지 않는다. 대신 작업을 생성해 202 Accepted와 작업 정보를 반환한다. 폴더 분석도 같은 방식으로 여러 파일과 상대 경로를 작업 대기열에 넣는다.
| 엔드포인트 | 역할 | 응답 |
|---|---|---|
POST /api/v1/analyses/file | 단일 파일 분석 작업 생성 | 작업 ID와 초기 진행 상태, 202 Accepted |
POST /api/v1/analyses/folder | 폴더의 다중 파일 분석 작업 생성 | 작업 ID와 초기 진행 상태, 202 Accepted |
GET /api/v1/analyses/{job_id} | 현재 진행 상태와 결과 조회 | 파일별 결과·집계·오류 상태 |
GET /api/v1/analyses/{job_id}/events | 진행 상태 변경 이벤트 수신 | SSE(Server-Sent Events) 스트림 |
@router.post("/file", response_model=AnalysisJob,
             status_code=status.HTTP_202_ACCEPTED)
async def create_single_file_analysis(
    manager: AnalysisManagerDependency,
    file: UploadFile = File(...),
) -> AnalysisJob:
    return await manager.create_job(
        input_kind="file",
        uploads=[file],
        relative_paths=[file.filename or "uploaded-file"],
    )
읽기 전용 PE 검증
모델 호출 이전에 MZ 서명, DOS 헤더의 PE 오프셋(e_lfanew), PE\0\0 시그니처를 확인한다. 따라서 확장자만 .exe로 변경한 문서 파일은 모델까지 전달되지 않는다.
if file_bytes[:2] != b"MZ":
    return PeValidationResult(is_valid=False)

pe_offset = int.from_bytes(file_bytes[0x3C:0x40], "little")

if file_bytes[pe_offset : pe_offset + 4] != b"PE\x00\x00":
    return PeValidationResult(is_valid=False)
1차·2차 모델 연결과 최종 상태 결정
유효한 PE 파일은 먼저 1차 XGBoost로 분석한다. 1차 결과가 Normal이면 종료하고, Suspicious 또는 Malware이면 원시 바이트 시퀀스를 준비해 2차 MalConv2-GCT로 전달한다. 이후 두 모델 결과를 조합해 Normal, 악성 유형 의심, 판정 충돌, 분류 불확실 중 하나의 최종 상태로 반환한다.
validation = validate_pe(file_bytes)
stage1 = self.stage1.analyze_file(file_path)

if stage1.needs_stage2:
    sequence = prepare_malconv2_byte_sequence(file_bytes)
    stage2 = self._get_stage2()
    family_class, family_confidence, is_unknown = \
        stage2.predict_stage2(sequence)

final_status = self._final_status(
    stage1.result, family_class, is_unknown
)
이 흐름은 main.py, analyze.py, pe_validator.py, analysis_service.py를 기준으로 정리했다.
4. 모델 분석 및 시각화 가이드
4.1 모델별 핵심 구조·장단점 비교
| 모델 | 핵심 구조 | 강점 | 한계 | 프로젝트에서의 위치 |
|---|---|---|---|---|
| EfficientNetV2 | Fused-MBConv·MBConv과 효율적 스케일링 | 정확도·속도 균형, 이미지 분류에 효율적 | 이미지 변환 규칙에 따라 입력 의미가 변할 수 있음 | 초기 이미지 기반 후보 |
| ResNet | 잔차 연결(Residual Connection) | 깊은 네트워크 학습 안정성, 풍부한 기준선 | 바이트 이미지의 픽셀 중요도를 PE 의미로 바로 해석하기 어려움 | 초기 이미지 기반 후보 |
| Swin Transformer | Shifted Window Self-Attention | 지역 창과 창 간 문맥을 계층적으로 학습 | 데이터·GPU 비용이 크며 이미지화 한계는 남음 | 초기 이미지 기반 후보 |
| VGG16 | 반복되는 3×3 Convolution | 구조가 직관적이고 비교 기준으로 좋음 | 파라미터·연산량이 크고 현대 모델 대비 효율이 낮음 | 초기 이미지 기반 후보 |
| ConvNeXt | 현대화한 CNN 블록, 큰 커널·LayerNorm | CNN 기반에서 강한 표현력 | 여전히 2D 이미지 표현에 의존 | 초기 이미지 기반 후보 |
| XGBoost | Gradient Boosted Decision Trees | 341개 구조화 특징의 비선형 조합 학습, 빠른 선별, 특징 계약 검증 | 사람이 정의한 특징 범위 밖의 원시 바이트 문맥은 제한적 | 최종 1차 기본 모델 |
| MalConv2 계열 | Byte Embedding·1D Conv·Gating/Context·Temporal Max Pooling | 긴 원시 바이트를 직접 보고 악성 유형 다중 분류 | 학습 비용이 크고 클래스 불균형·분포 변화에 민감 | 최종 2차 패밀리 모델 |
5. 결론 및 회고
5.1 프로젝트를 통해 얻은 기술적 인사이트
-
입력 표현은 모델 선택만큼 중요하다.
- 이미지 모델의 성능을 비교하는 것보다, 바이트를 왜 이미지로 바꾸는지와 그 과정에서 어떤 의미가 사라지는지를 먼저 검토해야 했다.
-
악성코드 분석은 단일 정확도보다 역할 분리가 중요하다.
- 1차는 빠르게 위험 파일을 선별하고, 2차는 비용이 큰 원시 바이트 다중 클래스 분류를 담당한다. 두 모델의 목적이 다르므로 동일한 지표만으로 선택하지 않았다.
-
불확실성을 결과로 설계해야 한다.
- 2차 최고 클래스가
benign인 경우를 단순 정상으로 덮지 않고판정 충돌로, 최고 점수가 낮은 경우를Unknown·분류 불확실로 표현했다. 이는 모델 결과를 과신하지 않기 위한 제품 정책이다.
- 2차 최고 클래스가
-
설명 가능성은 곧 행위 증명이 아니다.
- Grad-CAM이나 단계적 가림 분석은 모델이 반응한 위치를 보조적으로 보여 줄 수 있다. 그러나 해당 위치가 실제 감염 사실이나 악성 행위를 증명한다고 해석해서는 안 된다.
-
운영 가능한 ML 서비스에는 모델 외 계층이 필요하다.
- PE 검증, 업로드 임시 파일 관리, 오류 분리, 모델 번들 무결성 검사, 진행률, API 계약, UI 상태 표현, 외부 LLM 전송 최소화가 모델 추론만큼 중요했다.
5.2 향후 발전 방향
| 개선 방향 | 기대 효과 |
|---|---|
| 동적 분석 샌드박스 연계 | 프로세스·파일·레지스트리·네트워크 행위를 관찰해 정적 분석 한계 보완 |
| 점수 보정과 임계값 재평가 | 점수를 현실 확률처럼 오해하지 않도록 calibration·운영 비용 기반 임계값 정책 도입 |
| 시간 분리·외부 데이터 평가 | 특정 데이터셋에 맞춘 과적합과 데이터 분포 변화를 더 엄격히 검증 |
| 클래스 불균형 대응 고도화 | 재표본화, class weight, focal loss, 유형별 F1·혼동행렬 분석으로 소수 클래스 성능 개선 |
| 모델 버전·실험 추적 체계화 | 데이터셋 버전, 특징 계약, 가중치 해시, 임계값, 평가 리포트를 한 실행 단위로 보존 |
| 영향 구간 분석 최적화 | 재추론 횟수와 세분화 기준을 모델·파일 크기별로 조절해 응답 시간 개선 |
| 결과 이력의 영속 저장 | 사용자 동의·보존 정책을 전제로 분석 이력과 모델 버전을 감사 가능하게 관리 |
5.3 최종 회고
이 프로젝트의 핵심 성과는 “이미지 분류 모델 하나를 학습했다”는 데 있지 않다. 피드백을 통해 초기 접근의 한계를 인정하고, PE 구조 검증 → 1차 선별 → 2차 원시 바이트 분류 → 불확실성 표현 → 방어적 안내라는 전체 분석 경험으로 문제를 재정의했다는 데 있다.
향후에는 동적 분석과 외부 보안 도구 검증을 결합해 실제 악성 행위 판단에 가까워질 수 있다. 그러나 현재 단계에서도 모델 결과를 과장하지 않고, 어떤 파일을 먼저 검토해야 하는지와 무엇을 추가 확인해야 하는지를 제공하는 정적 분석 보조 서비스로서 명확한 역할을 가진다.
