랭체인 AI 영상객체탐지분석 플랫폼 구축
1.[1일차] OT

하루 약 6~8시간 수업 + 2~3시간 자습,실습,과제실질적인 정보를 많이 강의열심히 교육에 참여하고 좋은 기록을 내면 평가받는 자리에서 좋은 영향을 받을 수 있음현재 중소기업 CTO링크Git-hub : https://github.com/ryuzyproject
2.[2일차] Python
Python은 간결하고 가독성이 높은 문법을 특징으로 하는 고수준 프로그래밍 언어입니다. 코드의 표현력이 뛰어나 개발 생산성이 높으며, 데이터 처리, 자동화, 웹 개발, 인공지능 등 다양한 분야에서 활용됩니다.고수준 프로그래밍 언어는 사람이 이해하기 쉬운 형태로 프로그
3.[3일차] Python
변수는 프로그램에서 데이터를 저장하고 사용하기 위해 붙이는 이름이다.Python에서 변수는 값을 직접 저장하는 공간이라기보다, 메모리에 생성된 객체를 참조하는 이름에 가깝다.위 코드는 "memory" 라는 문자열 객체를 메모리에 생성하고, 변수 a가 그 객체를 참조하도
4.[과제1] 컴퓨터의 숫자 표현 방법
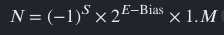
우리는 일상에서 10진수 를 사용한다.하지만 컴퓨터는 내부적으로 모든 정보를 0과 1 로 표현한다. 숫자도 예외가 아니다. 정수, 음수, 실수까지 모두 결국 비트의 조합으로 저장된다.그렇다면 컴퓨터는 왜 2진수를 사용할까? 음수는 어떻게 표현할까? 1.1 + 0.1 =
5.[4일차] Python
input()은 사용자로부터 키보드 입력을 받는 파이썬 내장 함수다.사용자가 값을 입력하고 Enter를 누르면, 입력한 값이 프로그램으로 전달된다.예를 들어 다음 코드를 실행한다고 하자.사용자가 김사과를 입력하면 다음과 같이 출력된다.input()으로 입력받은 값은 항
6.[5일차] Python
파이썬을 배우며 가장 먼저 익숙해져야 할 부분은 데이터를 어떻게 저장할지와 어떤 흐름으로 코드를 실행할지이다.이번 글에서는 컬렉션 자료형인 tuple, set, dict와 제어문인 조건문, 반복문을 예제와 함께 정리한다.예제는 Python 3 기준이며, match-ca
7.[6일차-1] Python
제어문-반복문
8.[6일차-2] Python
사용자 정의 함수
9.[7일차-1] Python
사용자 정의 함수
10.[7일차-2] Python
객체지향 프로그래밍
11.[7일차-3] Python
객체지향 프로그래밍 4대 패러다임(캡슐화, 상속)
12.[8일차-1] Python
객체지향 프로그래밍 4대 패러다임(다형성, 추상화)
13.[8일차-2] Python
예외 처리
14.[8일차-3] Python
매직 메서드(magic method) 와 제너레이터
15.[과제 2]
자료구조(Data Structure)는 데이터를 효율적으로 저장하고 사용하기 위한 방식이다.프로그램은 데이터를 다루기 위해 만들어진다. 이때 데이터를 아무렇게나 저장하면 추가, 삭제, 조회, 정렬, 검색 같은 작업이 비효율적이 될 수 있다.자료구조는 다음과 같은 문제를
16.[9일차-1] Python, 데이터분석
모듈, 패키지, 가상환경 그리고 NumPy 기초 정리 이번 글에서는 파이썬 코드를 파일 단위로 재사용하는 모듈(module), 여러 모듈을 폴더 단위로 묶는 패키지(package), 외부 라이브러리를 관리하는 가상환경과 requirements.txt, 그리고 데이터 분석의 핵심 라이브러리인 NumPy를 정리한다. 파이썬을 어느 정도 익히고 나면 코드가 ...
17.[9일차-2] Python, 데이터분석
NumPy는 Python에서 수치 계산과 데이터 분석을 효율적으로 수행하기 위해 사용하는 대표적인 라이브러리이다.NumPy의 핵심은 ndarray라는 다차원 배열 객체이다.NumPy가 자주 사용되는 이유는 다음과 같다.일반 Python 리스트보다 대량 연산이 빠르다.다
18.[과제3] Linked List
링크드 리스트(Linked List)는 여러 데이터를 노드(Node)라는 단위로 저장하고, 각 노드가 다음 노드를 가리키는 방식으로 연결된 선형 자료구조이다.배열은 데이터가 메모리상에 연속적으로 저장되는 구조인 반면, 링크드 리스트는 각 데이터가 흩어져 있어도 다음 데
19.[10일차] 데이터분석
Pandas
20.[과제 4] Tree
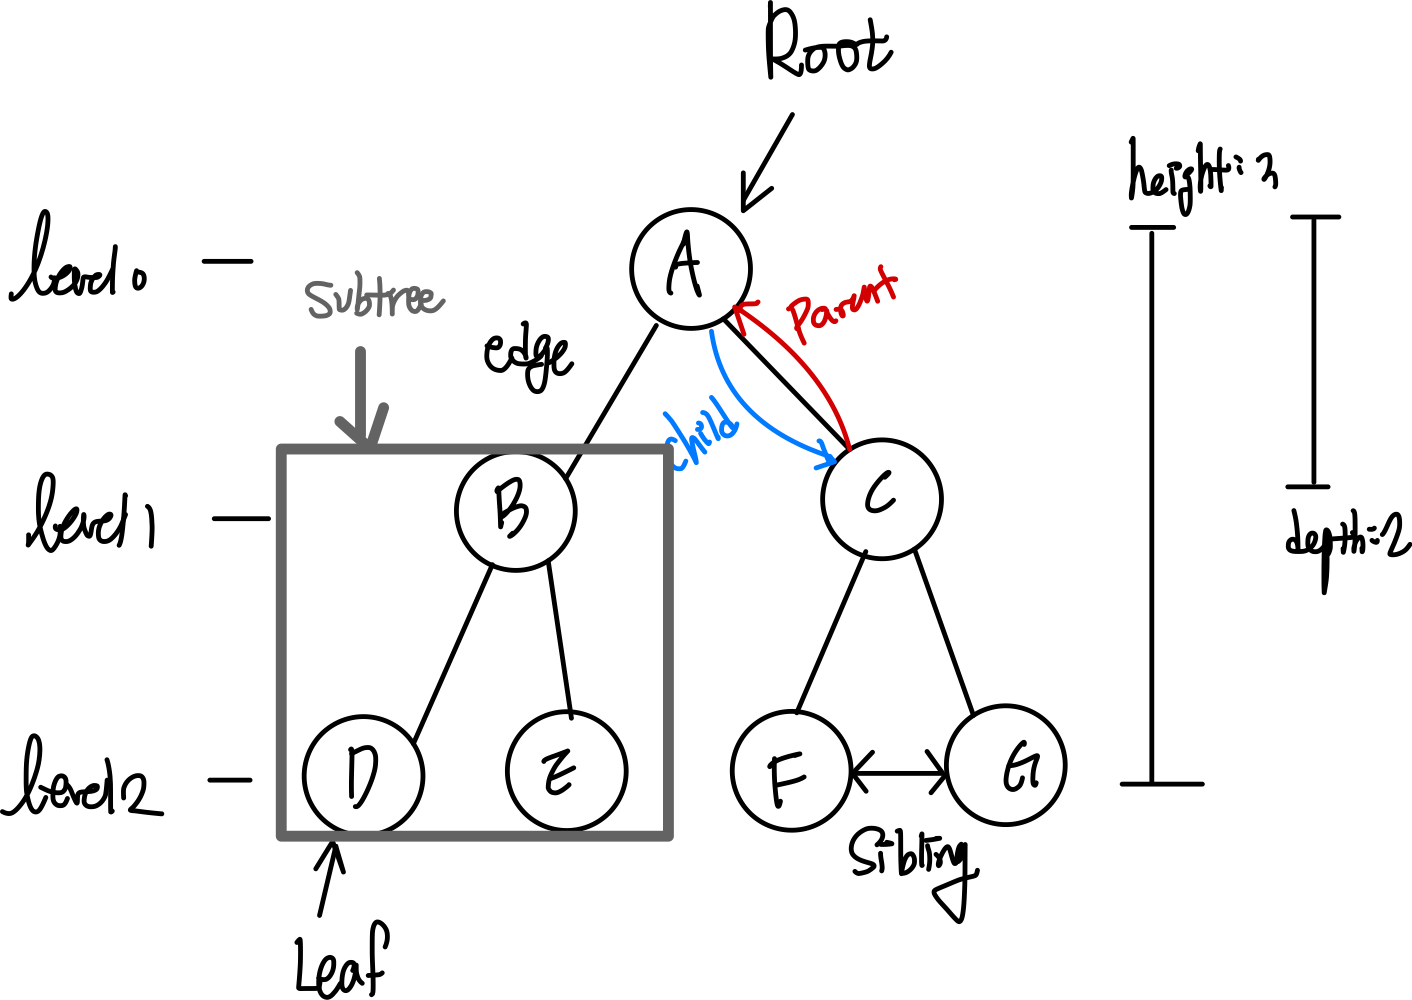
트리(Tree)
21.[과제4] 이진트리, 이진탐색트리
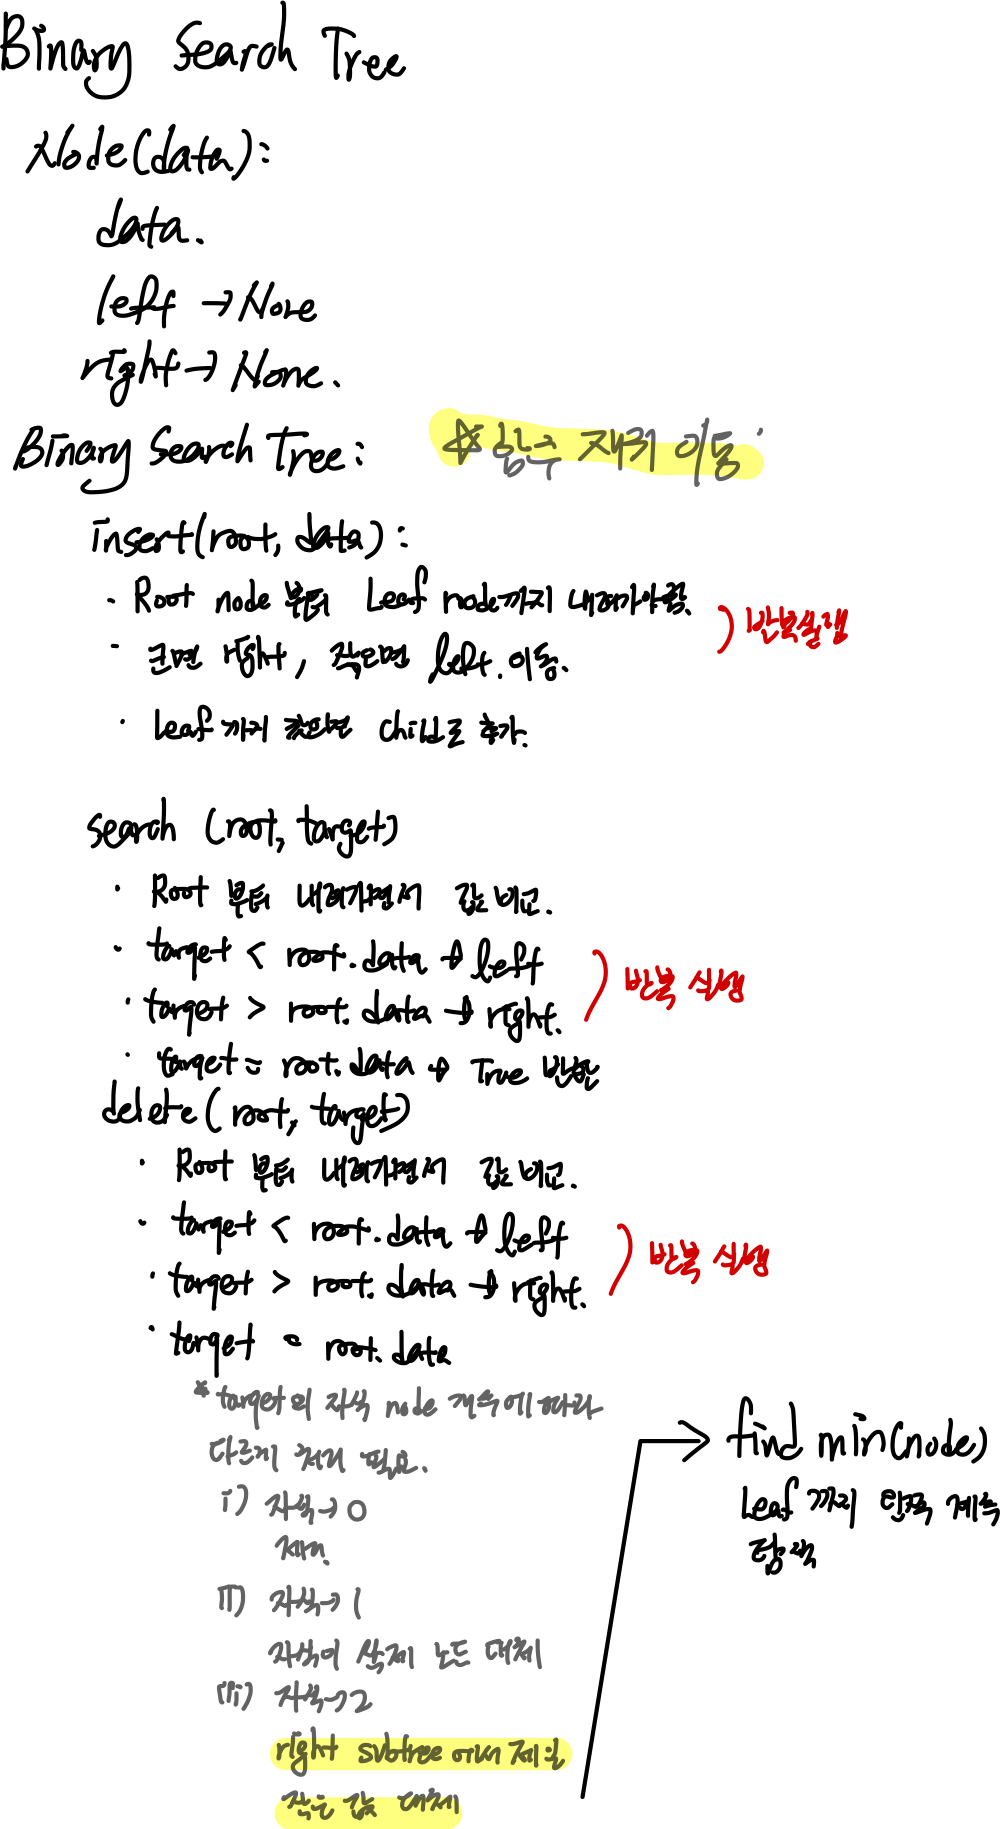
이지트리, 이진탐색트리
22.[과제5] Hash Table
Hash Table
23.Mac 에 MySQL 과 Workbench 설치 및 설정
MySQL, Workbench 설치 및 설정
24.[11일차] Data Analysis
Data Analysis(MySQL)
25.해시 테이블의 충돌 해결 방식: Chaining
해시 테이블의 충돌 해결 방식: Chaining
26.[12일차] Data Analysis
주요 내용은 `INSERT`, `SELECT`, `UPDATE`, `DELETE` 같은 DML, 조건 검색, 정렬, 그룹화, 정규화, 외래키, JOIN이다.
27.[과제 6] 시간 복잡도 (Time Complexity) 와 공간 복잡도 (Space Complexity)
시간 복잡도 와 공간 복잡도
28.해시 테이블의 충돌 해결 방식: Open Addressing(Linear Probing)
Open Addressing (Linear Probing)
29.해시 테이블의 충돌 해결 방식: Open Addressing (Quadratic Probing)
Open Addressing (Quadratic Probing)
30.해시 테이블의 충돌 해결 방식: Open Addressing (Double Hashing)
해시 테이블의 충돌 해결 방식: Open Addressing (Double Hashing)
31.[13일차] Data Analysis
- 서브쿼리 - `UNION` - 테이블 복사 - 사용자 계정과 권한 - MySQL 내장 함수
32.[과제 7] 힙(Heap)
힙(Heap)
33.[14일차] Data Analysis
View
34.Python과 MySQL 연동
Python에서 MySQL 데이터베이스에 접속하고 데이터를 조회·삽입·수정·삭제하는 과정을 정리한다. 이번 실습에서는 mysqlclient 라이브러리를 사용한다. 설치하는 패키지 이름은 mysqlclient이지만, Python 코드에서는 MySQLdb라는 이름으로 불러온다. 1. mysqlclient mysqlclient는 Python에서 MySQL ...
35.MySQL을 활용한 단어장 프로그램
Python과 MySQL을 연결해 단어를 등록·조회·검색·수정·삭제하는 콘솔 단어장 프로그램을 구현한다.
36.[과제 8] 기본 정렬 알고리즘
- 버블 정렬(Bubble Sort) - 선택 정렬(Selection Sort) - 삽입 정렬(Insertion Sort)
37.[15일차] HTML과 CSS 기초 정리
웹 페이지는 크게 구조, 표현, 동작으로 구성된다. | 기술 | 역할 | 예시 | | ---------- | ---------------------------------- | ------------------------ | | HTML | 웹 페...
38.[과제 9] 병합 정렬, 퀵 정렬과 재귀 함수
병합 정렬, 퀵 정렬, 재귀 함수
39.[16일차] HTML 표와 CSS 레이아웃 정리
HTML의 표와 시맨틱 구조를 살펴보고, CSS의 박스 모델과 float, 텍스트 스타일, position을 이용해 요소를 배치하는 방법을 정리한다. | 구분 | 주요 내용 | | ---- | --------------------------------------------- | | HTML ...
40.[17일차] Flexbox, Grid와 CSS 효과 정리
Flexbox, Grid, CSS 효과 정리
41.[18일차] Git과 GitHub 기초 정리
Git 과 GitHub 기초 정리
42.[18일차] JavaScript 기초
JavaScript 기초: 실행 방법, 콘솔 출력, 변수와 자료형
43.[19일차] JavaScript 기초 2
JavaScript 기초 : 연산자, 조건문, 반복문, 함수, 스코프, 배열
44.[과제 10] 탐색 알고리즘(Search Algorithm)
Linear Search, Binary Search, DFS, BFS
45.[20일차] JavaScript
JavaScript 객체, 클래스, 프로토타입 정리
46.[21일차] JavaScript
JavaScript BOM, DOM, 화살표 함수, 콜백 함수, 이벤트 정리
47.[과제] Greedy 알고리즘
1. Greedy 알고리즘이란? 1.1 Greedy 알고리즘의 의미 Greedy 알고리즘은 현재 상황에서 가장 좋아 보이는 선택을 반복해서 문제를 해결하는 알고리즘이다. 전체 경우를 모두 비교하지 않고, 매 순간 가장 이득이 되는 선택을 한다. 예를 들어 거스름돈을 줄 때 가장 큰 동전부터 사용하는 방법이 greddy 방식이다. 500원, 100원...
48.[23일차] JavaScript
JavaScript 정규식과 회원가입 폼 검증 정리
49.[24일차] JavaScript
JavaScript TODO 앱과 브라우저 저장소 정리
50.[과제] 다익스트라(Dijkstra) 알고리즘
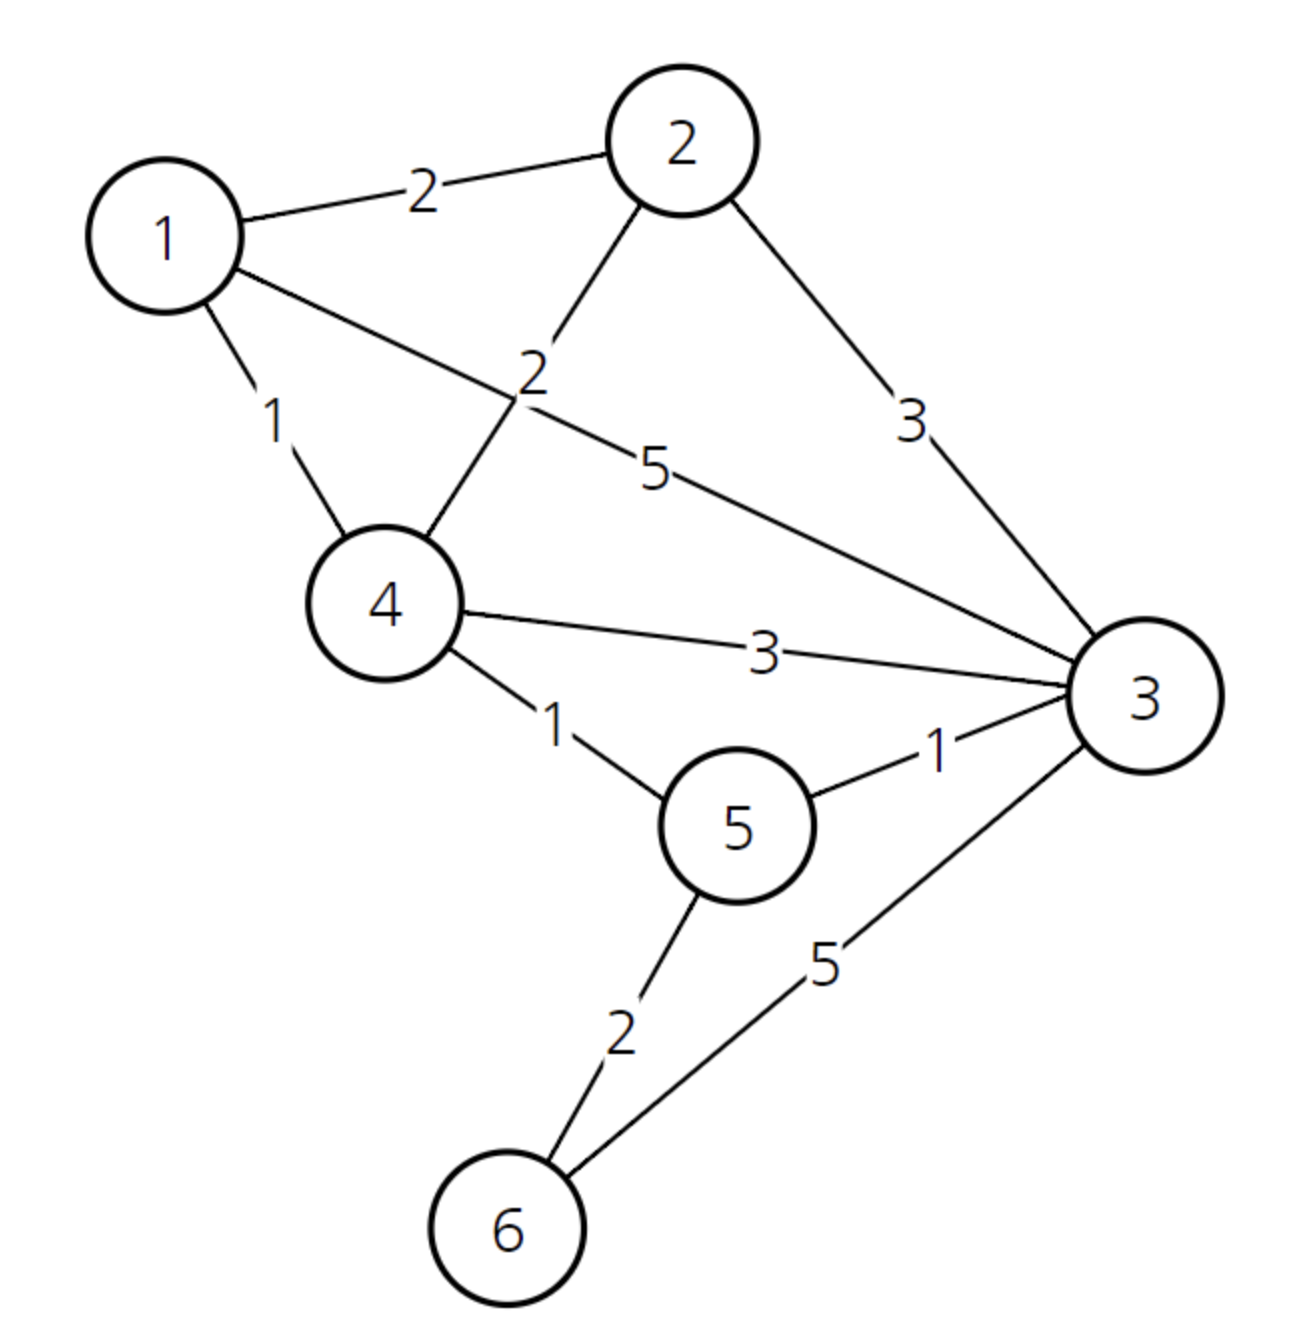
1. 최단 경로 알고리즘이란? 최단 경로 알고리즘은 그래프에서 한 정점에서 다른 정점까지 이동할 때, 가장 적은 비용으로 이동하는 경로를 찾는 알고리즘이다. 여기서 비용은 거리, 시간, 요금, 위험도처럼 이동할 때 필요한 값을 의미한다. 예를 들어 지도 앱에서 현재 위치에서 목적지까지 가장 빠른 길을 찾는 기능도 최단 경로 알고리즘과 관련이 있다. ...
51.[25일차] Crawling
이번 글에서는 로컬 HTML 예제를 대상으로 크롤링의 기본 흐름을 익히고, 실제 웹사이트에서 데이터를 수집해 `DataFrame`과 CSV 파일로 저장하는 방법까지 정리한다.
52.[26일차] Crawling
이번 글에서는 Selenium이 필요한 이유부터 동적 페이지 크롤링, 멜론 검색 결과 수집, 스타벅스 매장 정보 크롤링까지 정리한다.이번 글에서는 Selenium이 필요한 이유부터 동적 페이지 크롤링, 멜론 검색 결과 수집, 스타벅스 매장 정보 크롤링까지 정리한다.
53.[27일차] Node.js
Node.js는 브라우저 밖에서도 JavaScript를 실행할 수 있게 해주는 런타임이다. 브라우저에서 JavaScript가 화면 조작이나 이벤트 처리에 많이 사용된다면, Node.js에서는 서버 생성, 파일 입출력, 데이터 처리, API 서버 개발 같은 작업을 할 수 있다. 1. Node.js와 서버 서버는 클라이언트의 요청을 받고, 그 요청에 맞는...
54. [28일차] Node.js
Node.js Express 정리: 게시물 작성, JSON 요청, 라우팅 분리
55.[30일차] Node.js, MongoDB
MongoDB는 대표적인 NoSQL 데이터베이스 중 하나로, 데이터를 테이블이 아닌 문서(Documnet) 형태로 저장한다. Express 서버와 MongoDB를 연결하면 클라이언트가 보낸 데이터를 데이터베이스에 저장하고, 다시 조회하거나 수정, 삭제하는 API를 만들 수 있다. 1. MongoDB란? MongoDB는 NoSQL 데이터베이스 시스템 중...
56.[31일차] X_Project 1일차 정리
X_Project : Node.js 기반 Express 서버에서 회원가입, 로그인, JWT 인증, MongoDB 연결, 환경변수 관리를 학습하기 위한 예제 프로젝트 전체 코드 주소 : https://github.com/Songjeongkeun/Server 1. 프로
57.[32일차] X_Project 2일차 정리
2일차에서는 post에 대한 CRUD 기능을 구현하고, 로그인한 사용자만 게시글 기능을 사용할 수 있도록 연결한다. post 기능은 크게 세 파일로 나뉜다. 전체 흐름은 다음과 같다. 1. Post 라우터 구조 router/posts.mjs는 게시글 관련 API 주소를 정의한다. API를 표로 정리하면 다음과 같다. | 메서드 | 주소 ...
58.[33일차] Socket.IO
Socket.IO는 클라이언트와 서버가 실시간으로 데이터를 주고받을 수 있게 해주는 라이브러리다. 일반적인 HTTP 요청/응답 방식은 클라이언트가 요청해야 서버가 응답하지만, Socket.IO를 사용하면 서버도 클라이언트에게 즉시 이벤트를 보낼 수 있다. 1. HTTP 요청/응답 방식 일반적인 웹 요청은 클라이언트가 서버에 요청을 보내고, 서버가 그 요...
59.[35일차] React
1. React란? React는 사용자 인터페이스(UI)를 만들기 위한 JavaScript 라이브러리다. 화면을 하나의 큰 덩어리로 작성하지 않고, 버튼, 카드, 입력창, 리스트처럼 작은 단위의 컴포넌트(Component) 로 나누어 개발한다. 컴포넌트 단위로 화면을 구성하면 같은 UI를 여러 곳에서 재사용할 수 있고, 코드의 역할이 분리되어 유지보수가...
60.[36일차] React
1. React Developer Tools React Developer Tools는 브라우저에서 React 앱의 컴포넌트 구조와 상태를 확인할 수 있는 확장 프로그램이다. 일반 개발자 도구의 Elements 탭은 실제 HTML DOM 구조를 보여준다. 반면 React Developer Tools의 Components 탭은 React 컴포넌트 기준으로 ...
61.[37일차] React
1. Context API Context API는 여러 컴포넌트가 함께 사용해야 하는 데이터를 전역처럼 공유할 수 있게 해주는 React 기능이다. React에서는 일반적으로 부모 컴포넌트가 자식 컴포넌트에게 데이터를 전달할 때 props를 사용한다. 하지만 여러 단계 아래에 있는 컴포넌트까지 데이터를 전달해야 한다면, 중간 컴포넌트들이 실제로 사용하지...
62.[38일차] React - TodoList 프로젝트 정리
1. TodoList 프로젝트 구조 TodoList 프로젝트는 하나의 큰 컴포넌트에 모든 코드를 작성하지 않고, 역할에 따라 컴포넌트를 나누어 구성한다. 각 컴포넌트의 역할은 다음과 같다. | 컴포넌트 | 역할 | | ---------...
63.[39일차] React - CRUD 프로젝트 정리
1. 이번 정리에서 다루는 내용 이번 내용은 React 프론트엔드와 Express 백엔드, MongoDB를 연결해 상품 관리 CRUD 프로젝트를 만드는 흐름을 정리한다. 주요 내용은 다음과 같다. CRUD의 의미 프론트엔드와 백엔드 역할 분리 React에서 상품 등록 폼 만들기 fetch()로 API 요청 보내기 Express 서버 만들기 CORS 설...
64.[40일차] FastAPI 기초 정리
1. FastAPI란? FastAPI는 Python으로 웹 API를 만들기 위한 웹 프레임워크다. Python의 타입 힌트를 적극적으로 사용하며, 작성한 코드에서 요청 데이터의 형식을 검사하고 API 문서를 자동으로 생성한다. FastAPI의 주요 특징은 다음과 같다. Python 문법과 타입 힌트를 사용해 API를 작성한다. 경로 매개변수, 쿼리 매...
65.[41일차] GPT API와 Gradio 정리
[41일차] GPT API와 Gradio 정리 1. 생성형 AI API란? 생성형 AI API는 Python이나 JavaScript 같은 프로그램에서 AI 모델에 요청을 보내고 결과를 받아 사용할 수 있게 해주는 인터페이스다. ChatGPT 웹 화면에서는 사용자가 직접 메시지를 입력한다. API를 사용하면 프로그램이 대신 요청을 보내고 응답을 받아 웹...
66.[42일차] Matplotlib와 Online Retail 데이터 분석
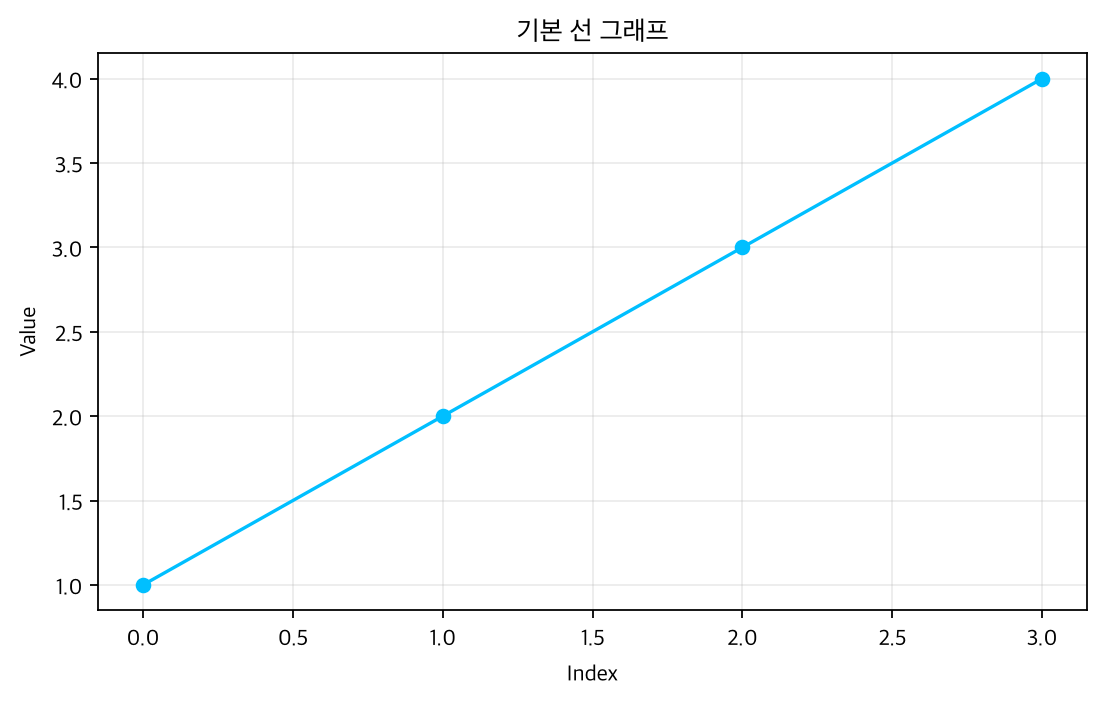
1. 전체 흐름 이번 내용은 Matplotlib으로 기본 그래프를 그리고, Online Retail 데이터를 전처리한 뒤 매출을 분석하는 과정을 정리한다. 2. Matplotlib Matplotlib은 Python에서 데이터를 그래프로 표현할 때 사용하는 시각화 라이브러리다. NumPy 배열과 Pandas 데이터프레임을 함께 사용할 수 있다. 기본 ...
67.[43일차] 프랜차이즈 입점 전략 분석
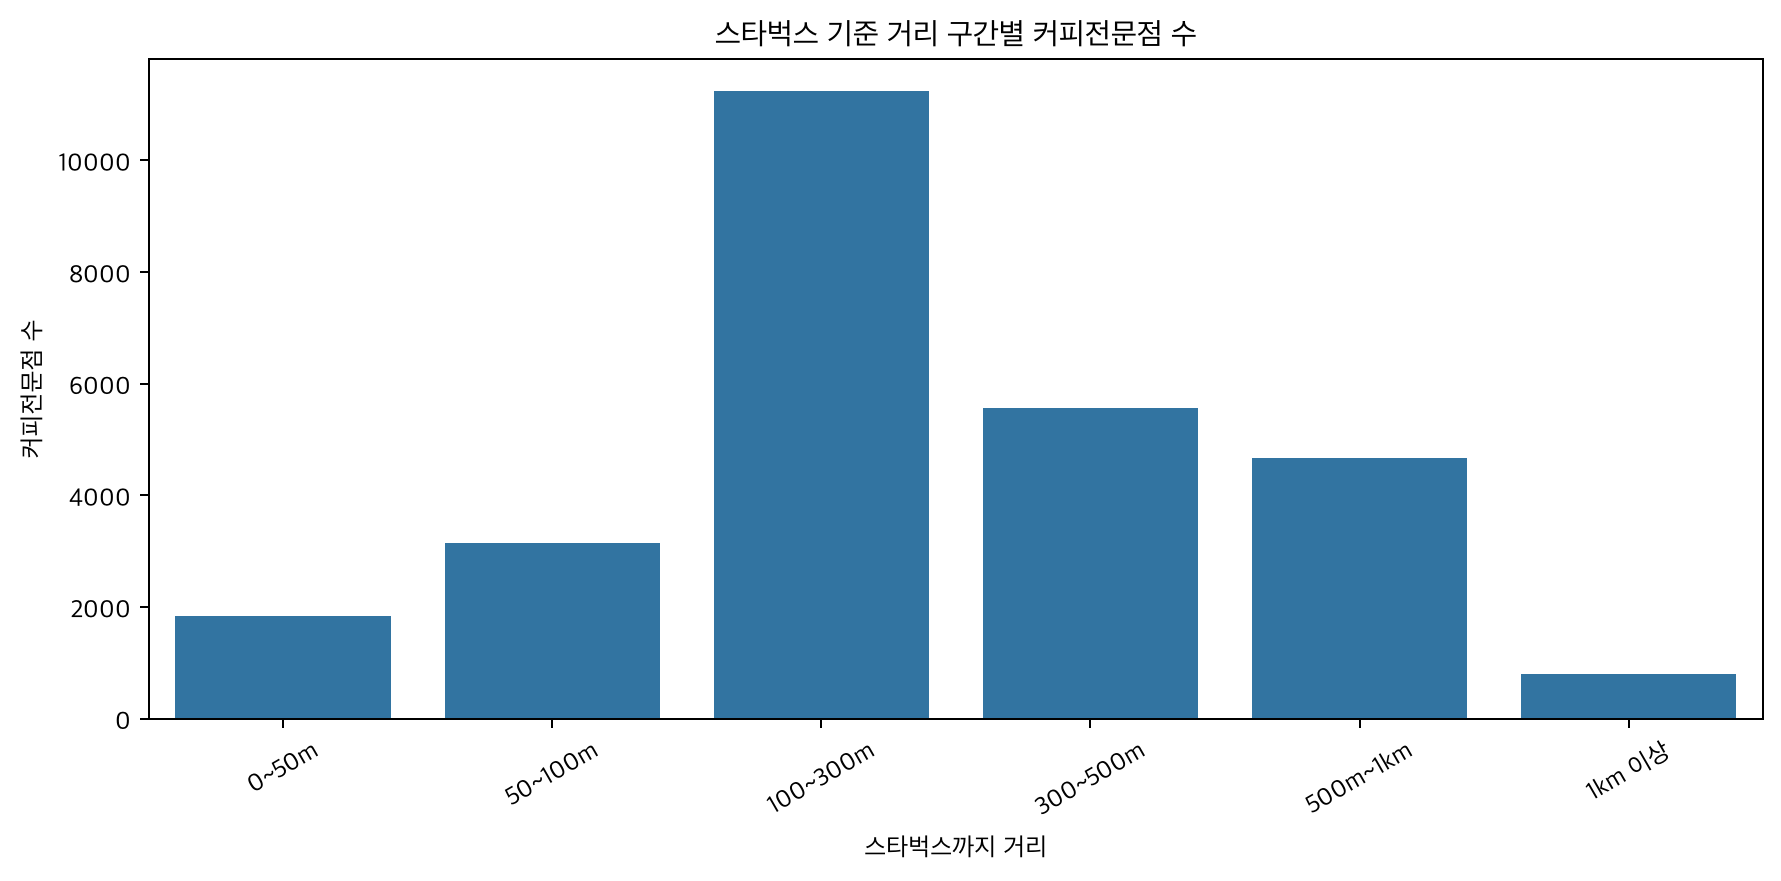
1. 분석 주제 서울의 스타벅스와 커피전문점 위치 데이터를 이용해 커피 매장이 스타벅스 주변에 얼마나 밀집되어 있는지 분석한다. 주요 질문은 다음과 같다. 스타벅스 주변에 커피전문점이 많이 분포하는가? 특정 프랜차이즈가 스타벅스 근처에 입점하는 경향이 있는가? 스타벅스와 커피전문점이 함께 밀집된 지역은 어디인가? 거리 구간별 분포에서 어떤 특징을 확인...
68.[45일차] 머신러닝 기초
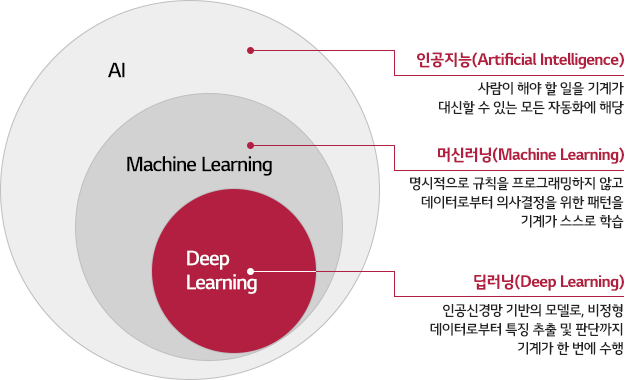
1. 인공지능, 머신러닝, 딥러닝
69.[44일차] 서울시 공공자전거 실시간 대여정보 API
1. 분석 개요 서울 열린데이터광장의 서울시 공공자전거 실시간 대여정보 API를 호출해 대여소별 자전거 현황을 수집하고, Pandas로 데이터프레임을 만든 뒤 Folium 지도에 대여소 위치를 표시한다. 이 데이터는 호출 시점의 현황을 제공하는 실시간 데이터다. 같은 코드를 실행해도 시간에 따라 대여 가능 자전거 수와 거치율이 달라질 수 있다. 분석 ...
70.[46일차] 사이킷런과 주택 임대료 데이터셋 탐색
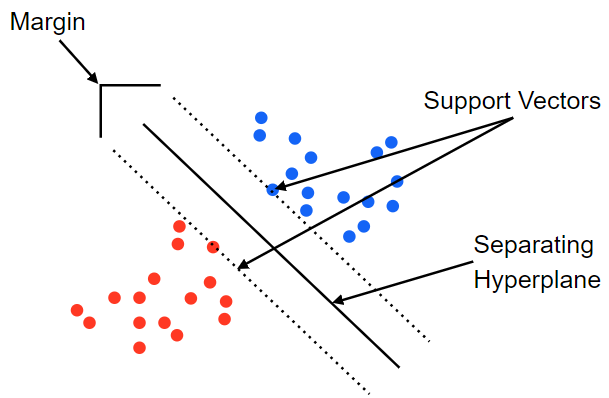
1. 사이킷런(scikit-learn) 사이킷런은 Python에서 머신러닝 모델을 학습하고 평가할 때 널리 사용하는 오픈소스 라이브러리다. 분류, 회귀, 군집화, 차원 축소, 전처리, 데이터 분할, 모델 평가를 일관된 인터페이스로 제공한다. 사이킷런에서 대부분의 모델은 다음 흐름으로 사용한다. | 메서드 | 역할 ...
71.[47일차] 데이터 전처리와 회귀, 자전거 수요 분석
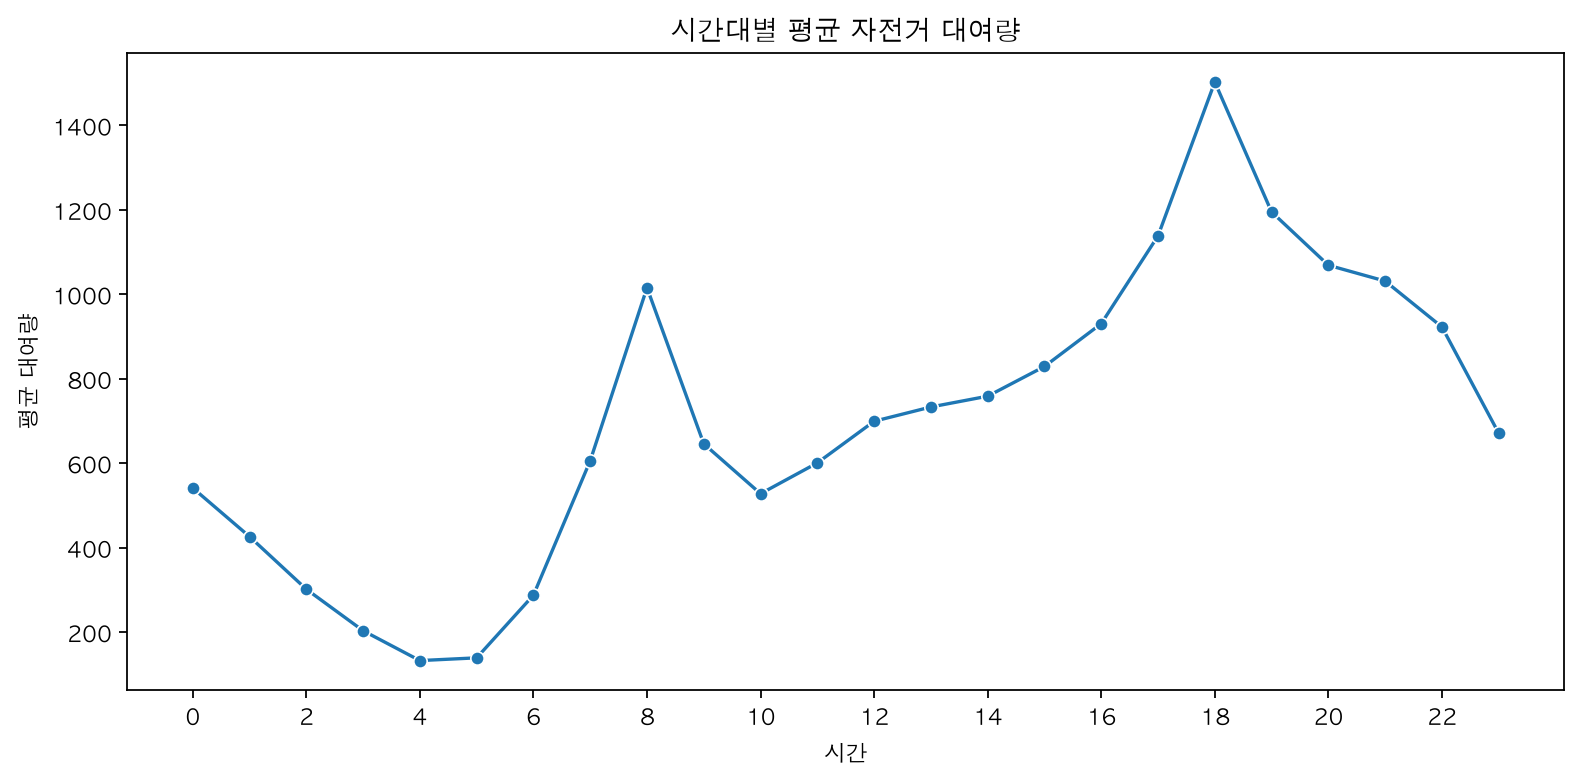
1. 정리 범위 이번 내용은 두 데이터셋을 통해 머신러닝 전처리와 회귀 분석의 흐름을 익힌다. | 데이터셋 | 주요 내용 | | --------------------- | --------------------------------------...
72.[48일차] 자전거 수요 회귀 모델 평가와 해석
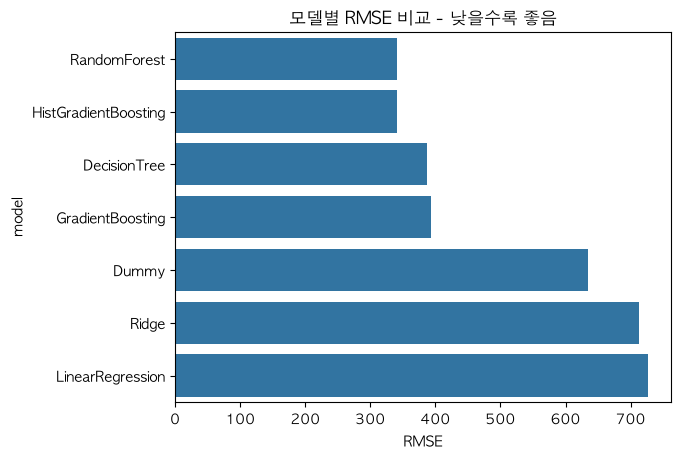
1. 정리 범위 기준 모델과 여러 회귀 모델을 비교하는 방법 결정트리 회귀의 분할 원리와 하이퍼파라미터 튜닝 실제값과 예측값을 시각화해 오차를 확인하는 방법 시간 흐름에 따른 예측 결과 비교 트리 계열 모델의 피처 중요도와 결정트리 구조 해석 2. 여러 회귀 모델을 비교하는 이유 하나의 모델만 사용하면 그 모델의 성능이 좋은지 판단하기 어렵다. 먼저...
73.[49일차] 호텔 예약 취소 예측과 분류 모델 평가
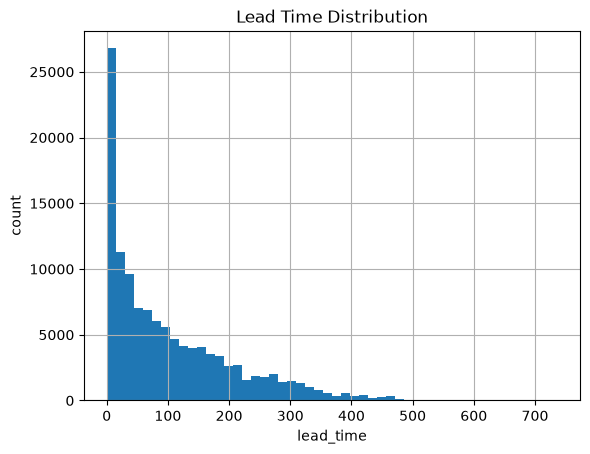
1. 문제 정의 호텔 예약 수요 데이터셋은 예약 정보와 고객 특성을 이용해 예약 취소 여부를 예측하는 데이터셋이다. 이 글에서는 is_canceled를 타깃으로 사용하는 이진 분류 문제를 다룬다. | 타깃값 | 의미 | | -----: | ---------------- | | 0 | 예약이 유지됐다. | | 1 | 예약이...
74.[50일차] PyTorch 텐서와 자동 미분, 선형 회귀 구현
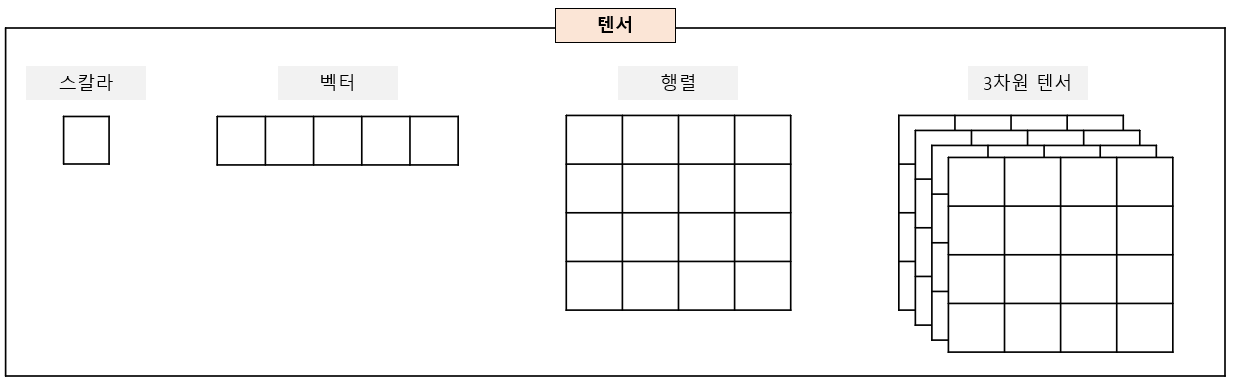
1. PyTorch란 무엇인가 PyTorch는 Python 기반의 오픈소스 딥러닝 프레임워크다. 다차원 배열인 텐서로 데이터를 표현하고, 자동 미분과 GPU 가속을 이용해 모델의 파라미터를 학습한다. PyTorch는 코드를 실행하면서 계산 그래프를 만드는 동적 계산 그래프(dynamic computational graph) 방식을 사용한다. 따라서 일반...
75.[51일차] PyTorch 논리 회귀와 손글씨 숫자 데이터셋
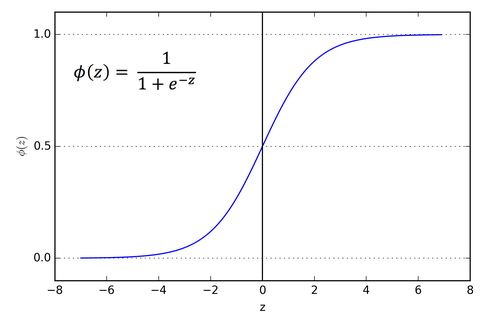
1. 분류 문제와 논리 회귀 논리 회귀(Logistic Regression)는 입력값을 바탕으로 클래스에 속할 확률을 예측하는 지도학습 모델이다. 이름에 회귀가 들어가지만, 주로 분류 문제에 사용한다. | 문제 유형 | 예측 대상 | 예시 | | --------- | -----...
76.[52일차] 데이터 증강과 퍼셉트론, 다층 퍼셉트론
1. 데이터 증강이 필요한 이유 데이터 증강(Data Augmentation)은 기존 학습 데이터를 조금씩 변형하여, 모델이 더 다양한 입력을 경험하도록 만드는 방법이다. 새 레이블을 만들지 않아도 회전, 이동, 확대·축소, 밝기 변화 같은 변형으로 학습 데이터의 다양성을 높일 수 있다. 손글씨 숫자 3은 사람마다 기울기와 크기가 다르다. 원본 모양만 ...
77. [53일차] CNN의 구조와 합성곱, 풀링
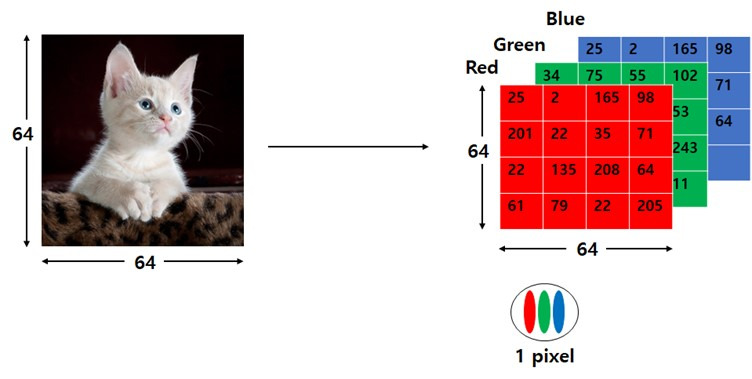
CNN(Convolutional Neural Network, 합성곱 신경망)은 이미지처럼 가로·세로 위치 관계가 중요한 데이터를 처리하기 위한 신경망이다. 이전의 완전 연결 신경망(DNN)은 이미지를 한 줄로 펼쳐 모든 픽셀을 연결하지만, CNN은 작은 필터를 이미지 위로 움직이며 선, 모서리, 질감 같은 특징을 찾아낸다. 이번 내용은 CNN이 이미지에 ...
78.[54일차] 손글씨 도형 분류와 CNN 학습 과정
이번 예제는 사람이 손으로 그린 원(cir), 삼각형(tri), X(x) 이미지를 CNN으로 분류한다. 학습 데이터는 240장, 테스트 데이터는 60장이며 세 클래스가 같은 수만큼 포함되어 있다. 전체 흐름 : 1. 문제와 데이터 구성 이 문제는 세 가지 중 하나를 고르는 다중 분류(multi-class classification) 문제다. | ...
79. [54일차] 손글씨 도형 분류와 CNN 학습 과정
이번 예제는 사람이 손으로 그린 원(cir), 삼각형(tri), X(x) 이미지를 CNN으로 분류한다. 학습 데이터는 240장, 테스트 데이터는 60장이며 세 클래스가 같은 수만큼 포함되어 있다. 전체 흐름 : 1. 문제와 데이터 구성 이 문제는 세 가지 중 하나를 고르는 다중 분류(multi-class classification) 문제다. | 폴더...
80.[55일차] AlexNet과 CIFAR-10 컬러 이미지 분류
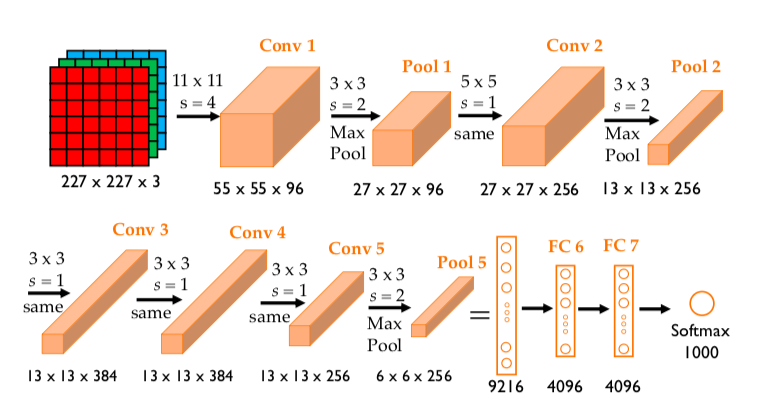
1. AlexNet이 중요한 이유 AlexNet은 Alex Krizhevsky, Ilya Sutskever, Geoffrey Hinton이 발표한 합성곱 신경망이다. 5개의 합성곱 레이어와 3개의 완전 연결 레이어, 총 8개의 학습 레이어로 구성된다. 논문은 ImageNet의 대규모 이미지 분류 문제에서 ReLU, Dropout, 데이터 증강, GPU...
81.[56일차] AlexNet 학습 루프와 모델 성능 평가
1. 학습 전 출력 형태 확인하기 학습을 시작하기 전에 임의의 입력을 모델에 넣어 특징 맵과 최종 출력 형태가 의도대로 나오는지 확인한다. 실제 학습을 돌린 뒤에 형태 오류를 찾는 것보다 훨씬 빠르고 안전하다. | 결과 | 의미 | | ------- | ----------------...
82.[57일차] 전이 학습으로 에일리언과 프레데터 이진 분류
alien과 predator 이미지를 구분하는 이진 이미지 분류 모델을 만든다. 데이터는 학습 이미지 694장, 검증 이미지 200장으로 많지 않다. 이런 상황에서 CNN을 처음부터 학습하면 데이터가 부족해 과적합되기 쉽고 학습 시간도 길어진다. 따라서 ImageNet으로 이미 학습된 AlexNet을 불러온 뒤, 기존 특징 추출기는 고정하고 마지막 분류기...
83.AlexNet 논문 리뷰
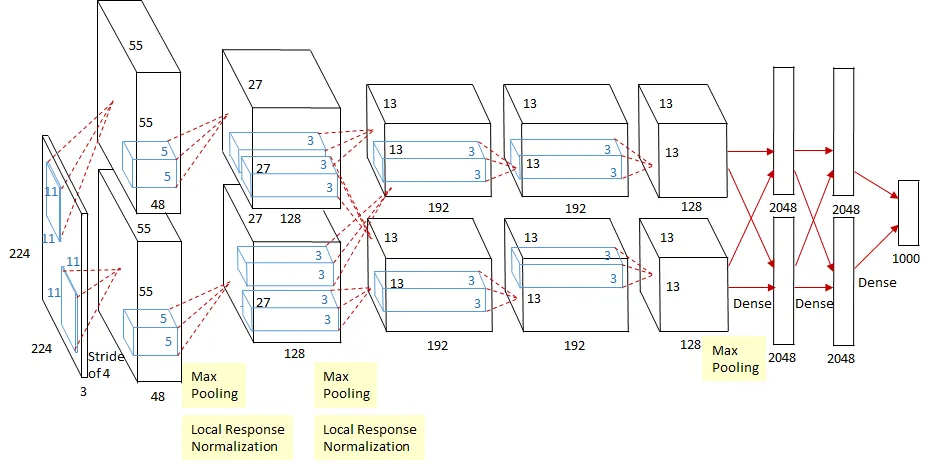
논문: ImageNet Classification with Deep Convolutional Neural Networks (2012) > 저자: Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton AlexNet은 2012년 I
84.[58일차] 컴퓨터 비전과 OpenCV
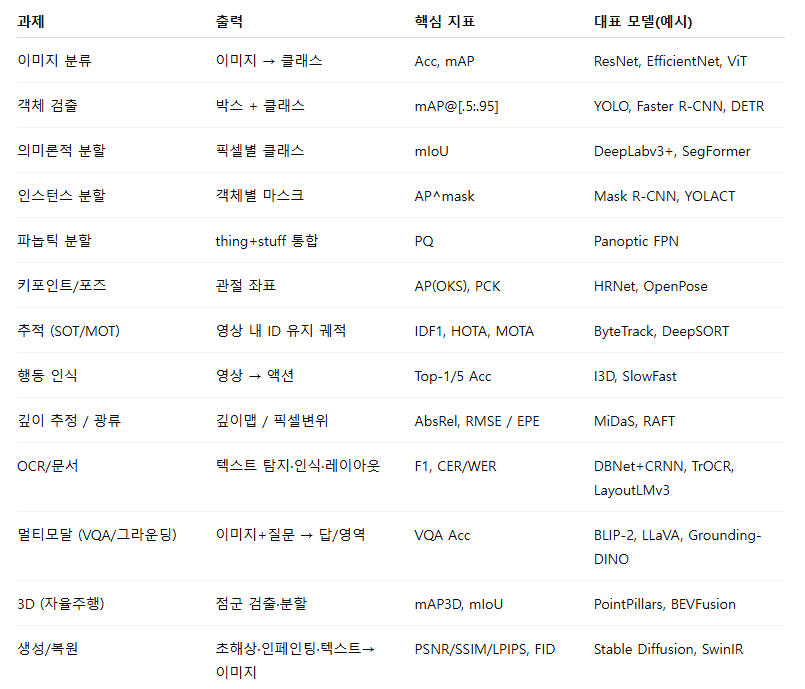
컴퓨터 비전(Computer Vision)은 컴퓨터가 이미지와 영상에서 의미 있는 정보를 읽고 해석하도록 만드는 분야다. 사람에게는 자연스러운 사진 한 장도 컴퓨터 입장에서는 숫자로 이루어진 배열일 뿐이다. 컴퓨터 비전은 이 숫자 배열에서 물체, 위치, 윤곽, 움직임 같은 정보를 찾아내는 기술이다. 1. 컴퓨터 비전이란 컴퓨터 비전은 이미지나 영상 데이...
85.[59일차] OpenCV 영상 입출력과 이미지 산술 연산
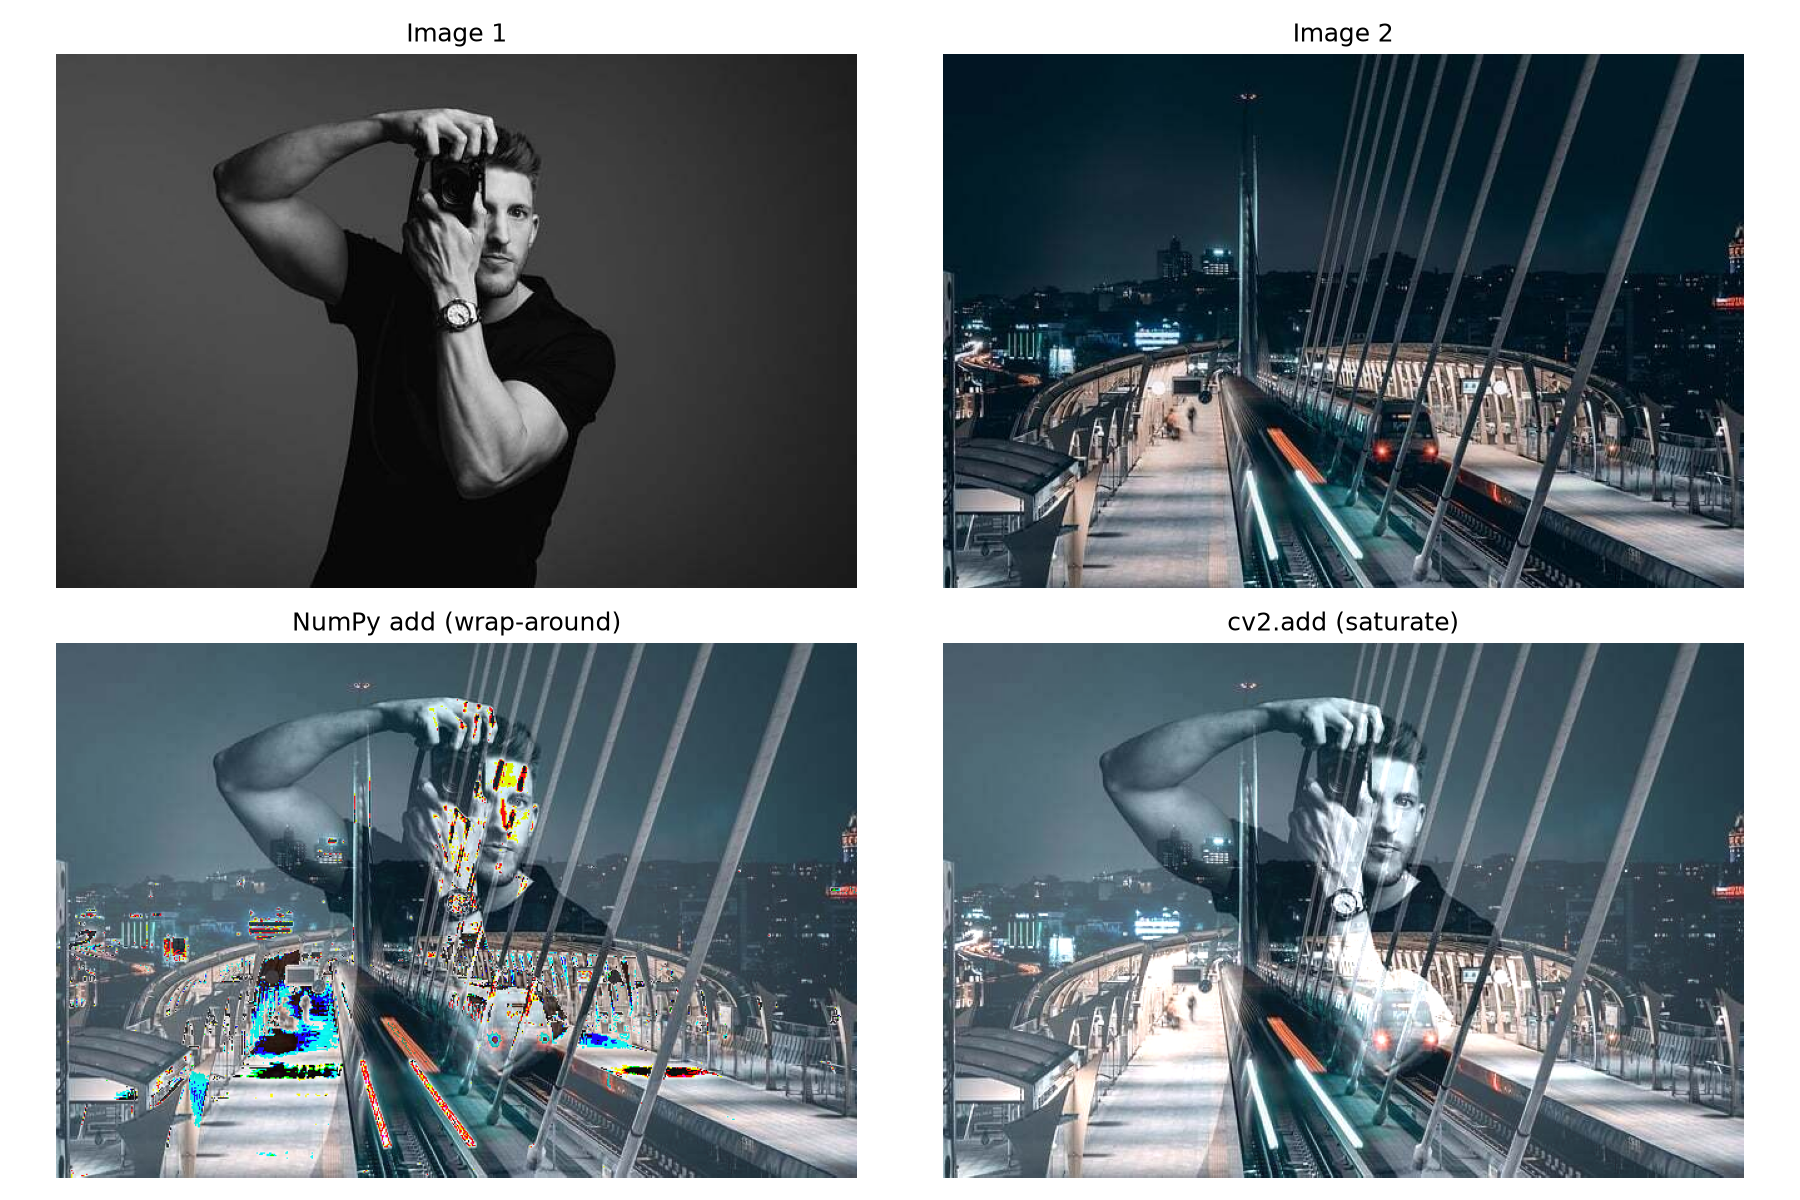
1. 영상과 카메라는 프레임의 연속이다 동영상은 시간 순서대로 이어진 이미지, 즉 프레임(frame) 의 집합이다. OpenCV의 cv2.VideoCapture는 동영상 파일이나 카메라에서 프레임을 하나씩 읽는다. | 반환값 | 의미 | | -----...
86.OpenCV 히스토그램 평활화와 HSV, 크로마키
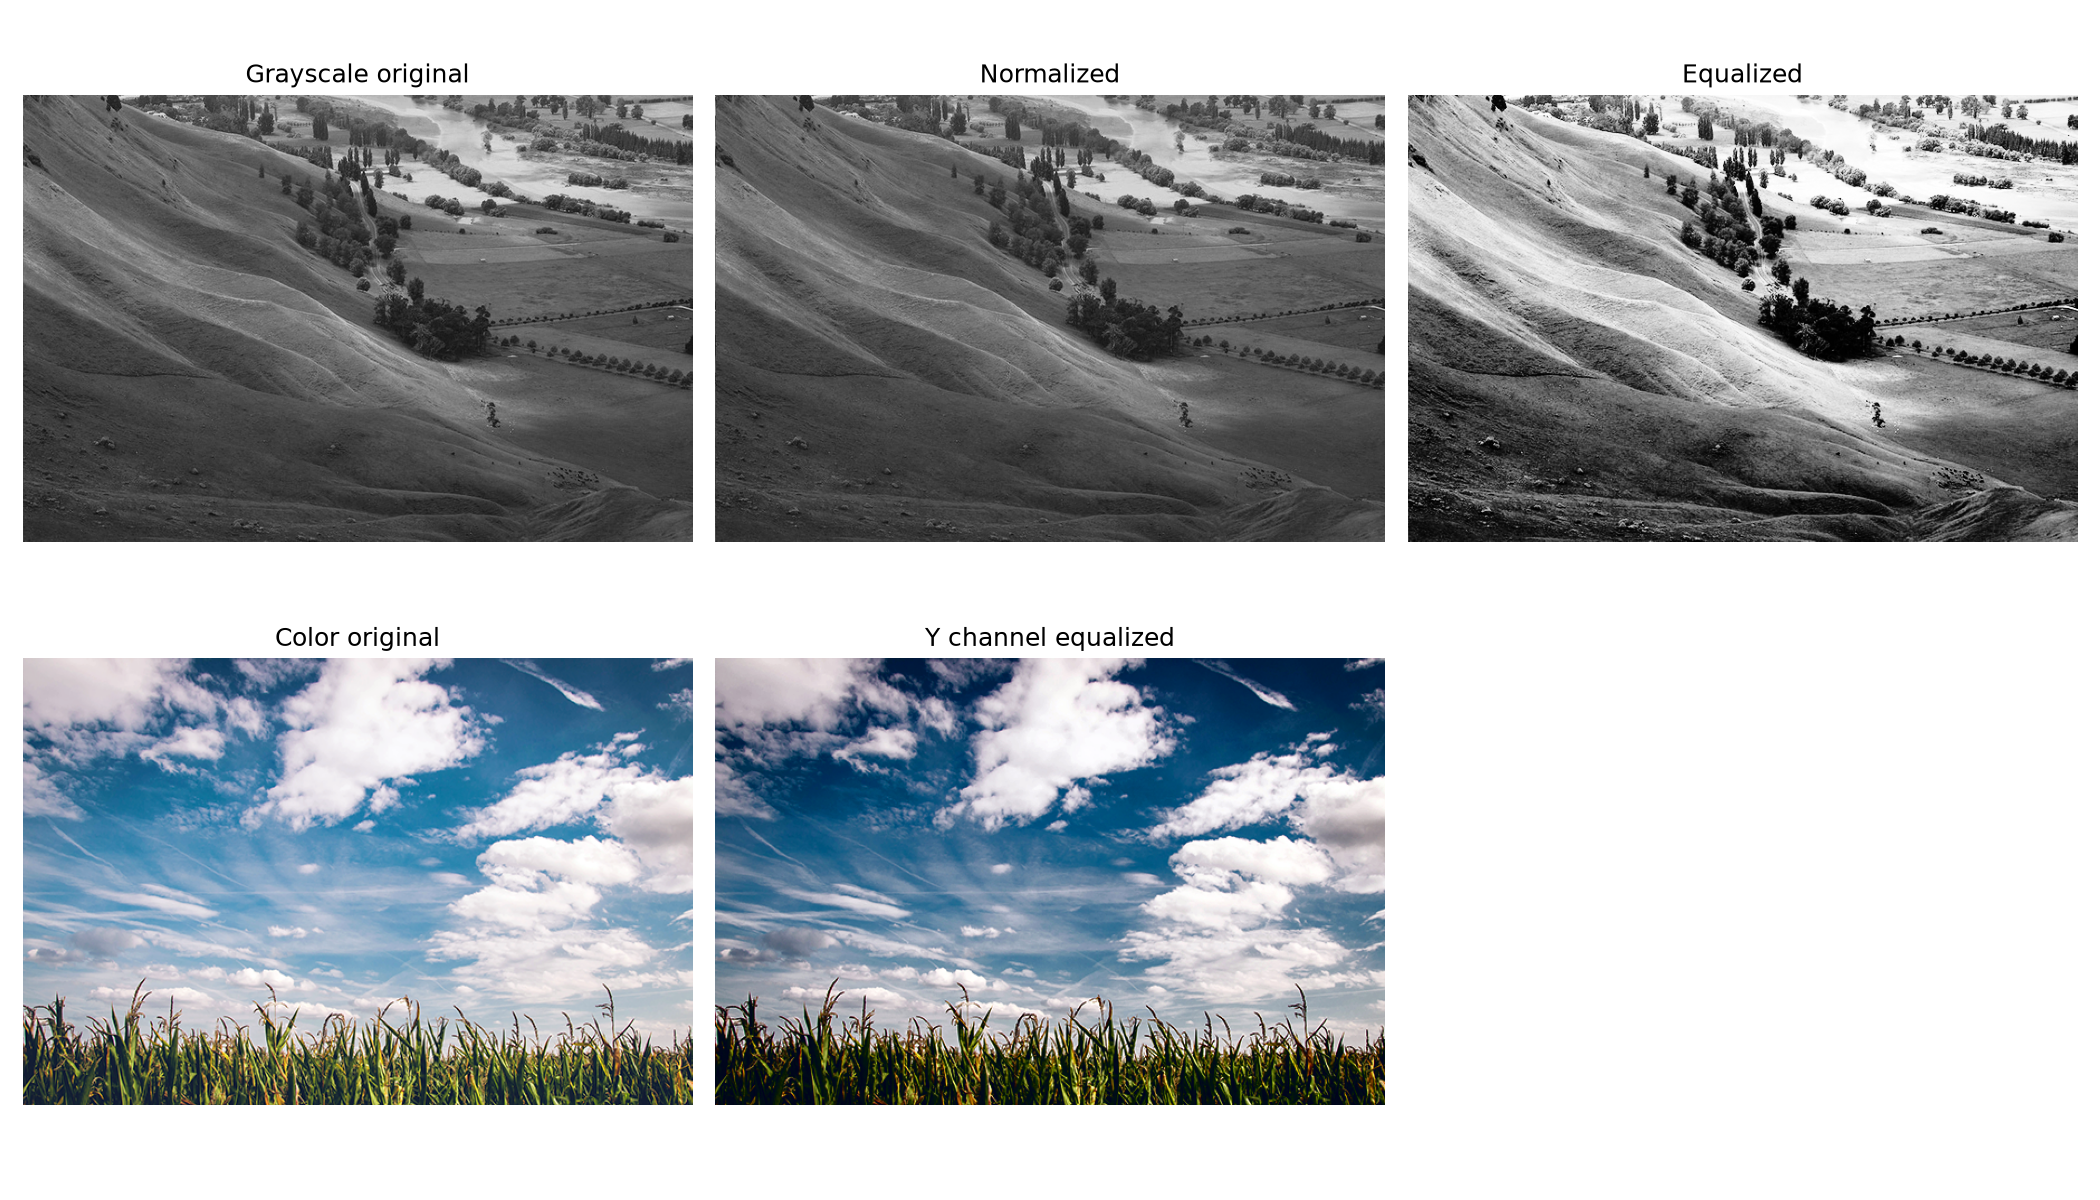
이미지의 밝기와 색상은 단순한 장식이 아니라, 객체를 찾고 분리하는 데 사용하는 중요한 정보다. 이번에는 히스토그램으로 픽셀 분포를 읽고, 정규화와 히스토그램 평활화로 명암 대비를 보정한다. 이어서 HSV 색상 공간으로 특정 색을 마스크로 분리하고, 이를 활용해 크로마키 영상을 합성한다. 1. 히스토그램: 이미지의 밝기 분포 그레이스케일 이미지의 픽셀 ...
87.[61일차] OpenCV ROI, 이진화와 기하 변환
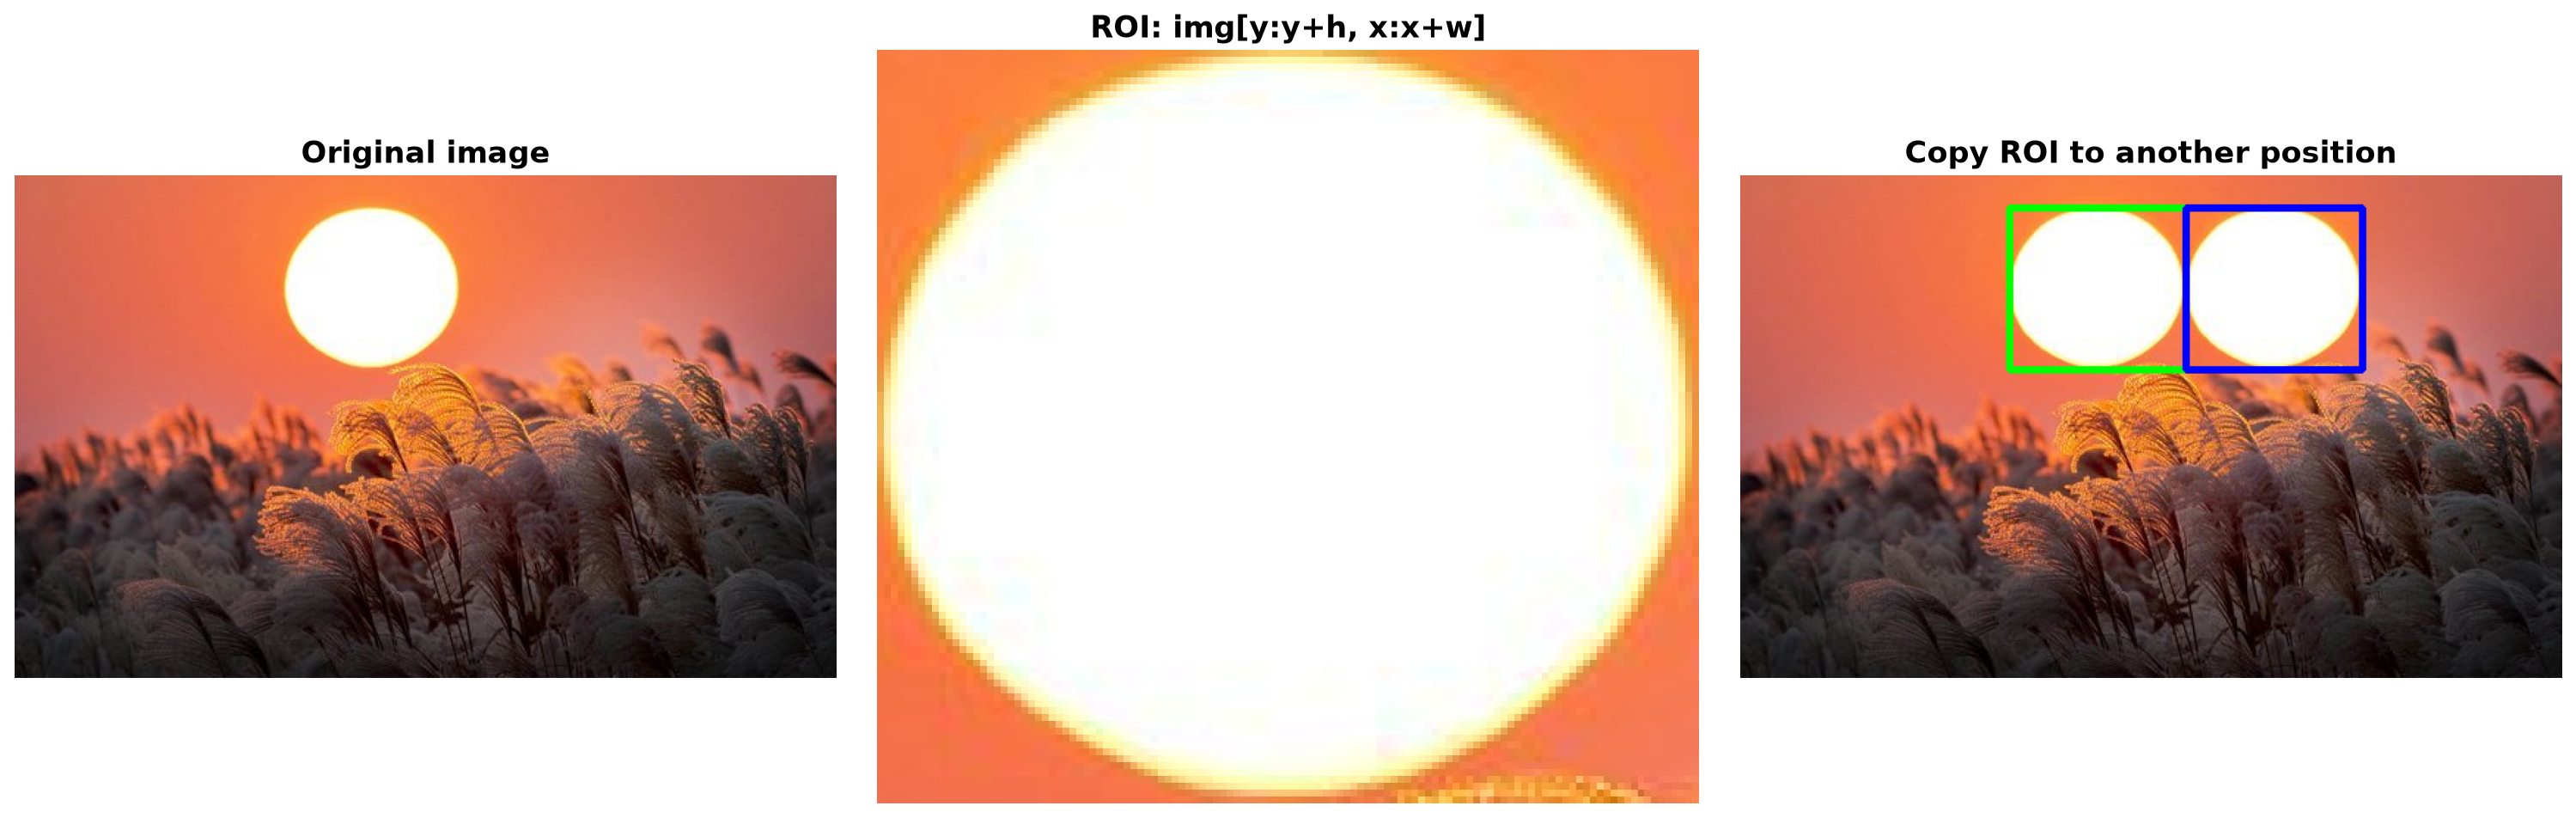
이미지 전체를 그대로 처리할 필요는 없다. 필요한 부분만 잘라 분석하거나, 밝기 기준으로 대상을 분리하고, 기울어진 문서를 정면처럼 보정할 수 있다. 이번에는 ROI(관심 영역), 이진화, 이동·크기 변경·회전·투시 변환을 다룬다. 1. ROI란 무엇인가 ROI(Region of Interest)는 이미지 전체 중에서 의미 있는 일부 영역만 선택한 것...
88.[62일차] OpenCV 명함 보정, 블러링과 모폴로지
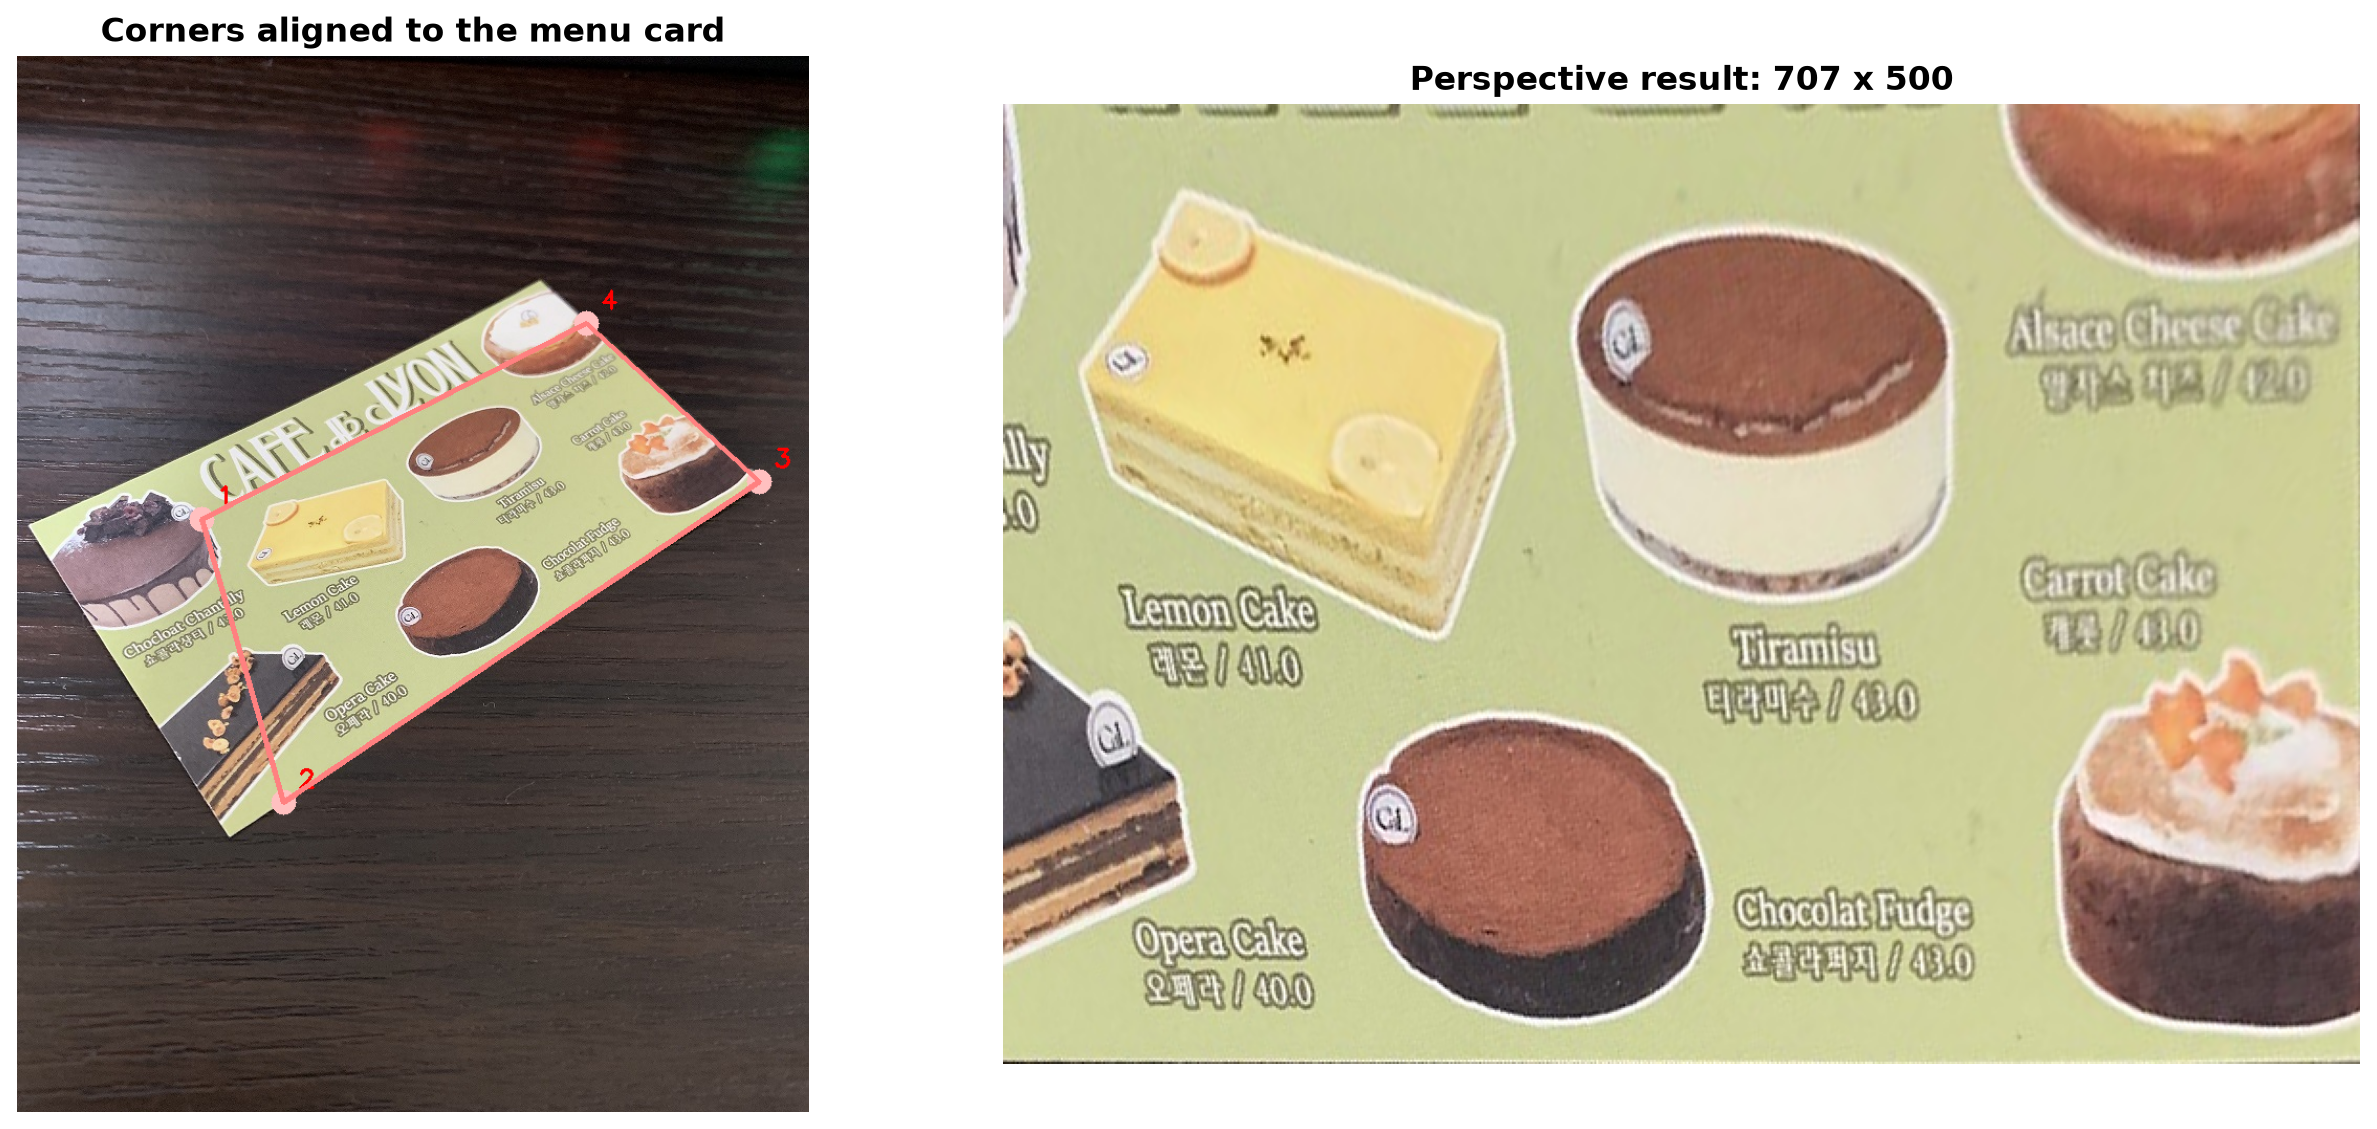
1. 마우스로 카드 영역 선택 후 투시 보정하기 비스듬히 촬영한 명함이나 메뉴판은 사다리꼴처럼 보인다. 이때 대상의 네 꼭짓점을 선택하고, 직사각형의 네 꼭짓점에 대응시키면 cv2.warpPerspective()로 정면에서 본 것처럼 보정할 수 있다. 전체 동작 흐름 꼭짓점과 선 그리기 draw_roi() 함수는 원본을 훼손하지 않도록 copy()...
89.[63일차] OpenCV 연결 요소, 윤곽선과 도형 분류
연결 요소 레이블링으로 객체 정보를 얻고, 윤곽선으로 경계를 추적하며, 다각형 근사와 원형도로 간단한 도형을 분류한다.
90.[64일차] 객체 탐지와 YOLO, VOC 데이터셋 변환
객체 탐지와 YOLO의 기본 개념을 살펴보고, Pascal VOC의 XML 어노테이션을 YOLO가 읽을 수 있는 텍스트 라벨로 변환한다. 제공된 노트북의 범위는 **학습·검증·테스트 데이터 준비까지**이며, 모델 학습이나 추론 성능 측정은 포함하지 않는다.
91.[66일차] YOLO 데이터셋 설정, 학습과 성능 평가
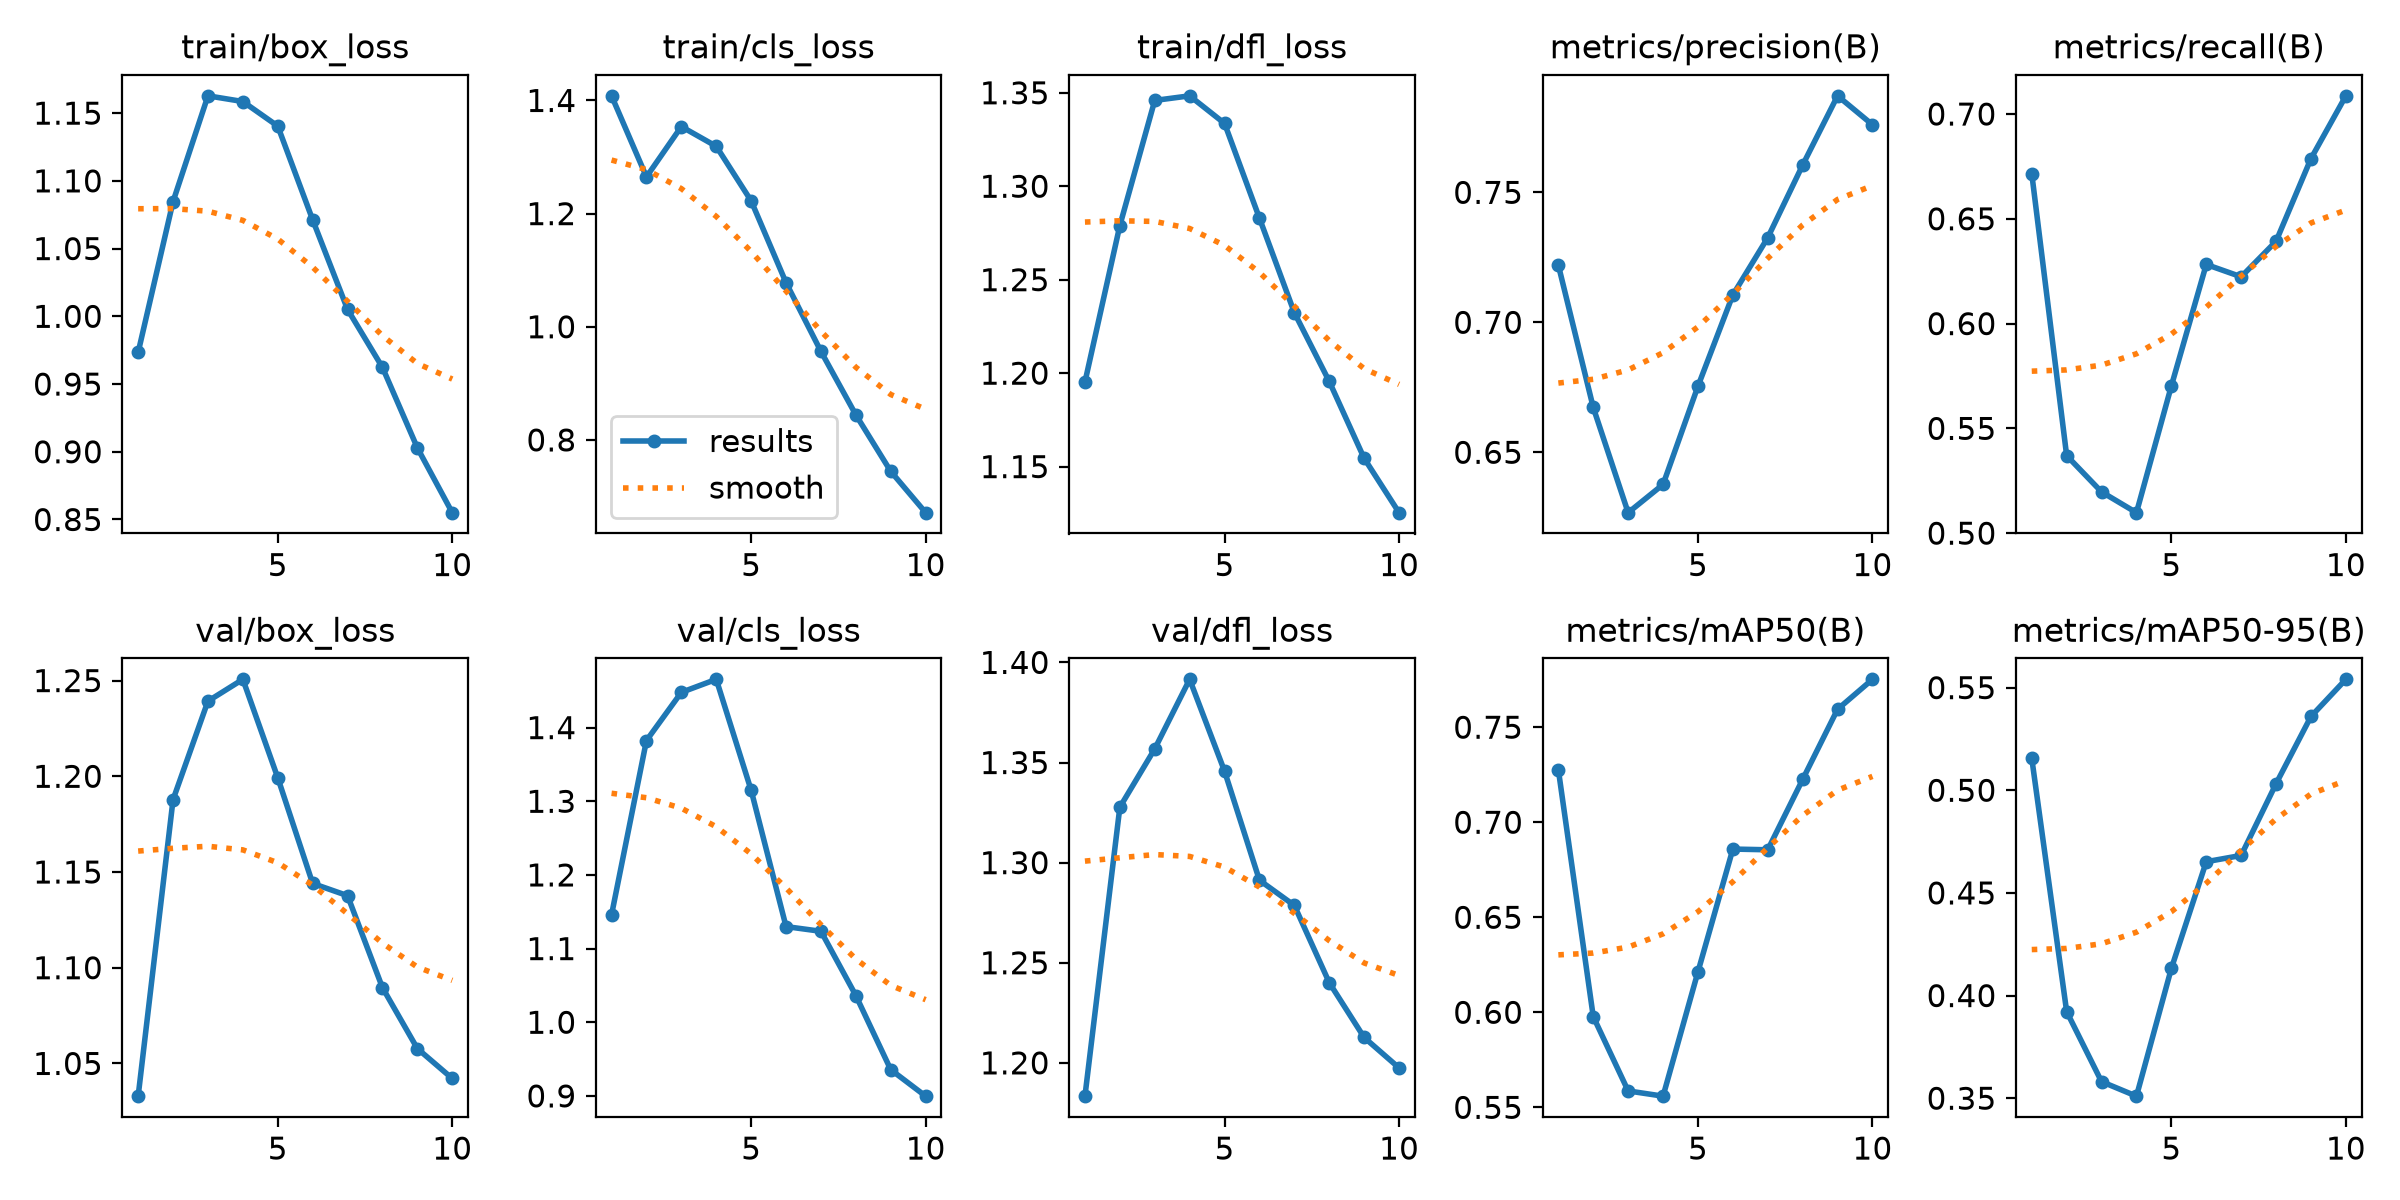
64일차에서는 Pascal VOC XML을 YOLO 라벨로 변환하고 학습 이미지를 준비했다. 이번에는 이어서 검증·테스트 분할을 준비하고, Dataset YAML로 데이터셋을 연결한 뒤 사전 학습된 YOLO 모델을 학습·검증·테스트·추론하는 흐름을 정리한다. 1. 전체 흐름 train은 가중치를 학습하는 용도, val은 학습 과정에서 모델을 비교하는 용...
92.[67일차] YOLO 인스턴스 세그멘테이션과 COCO 라벨 변환
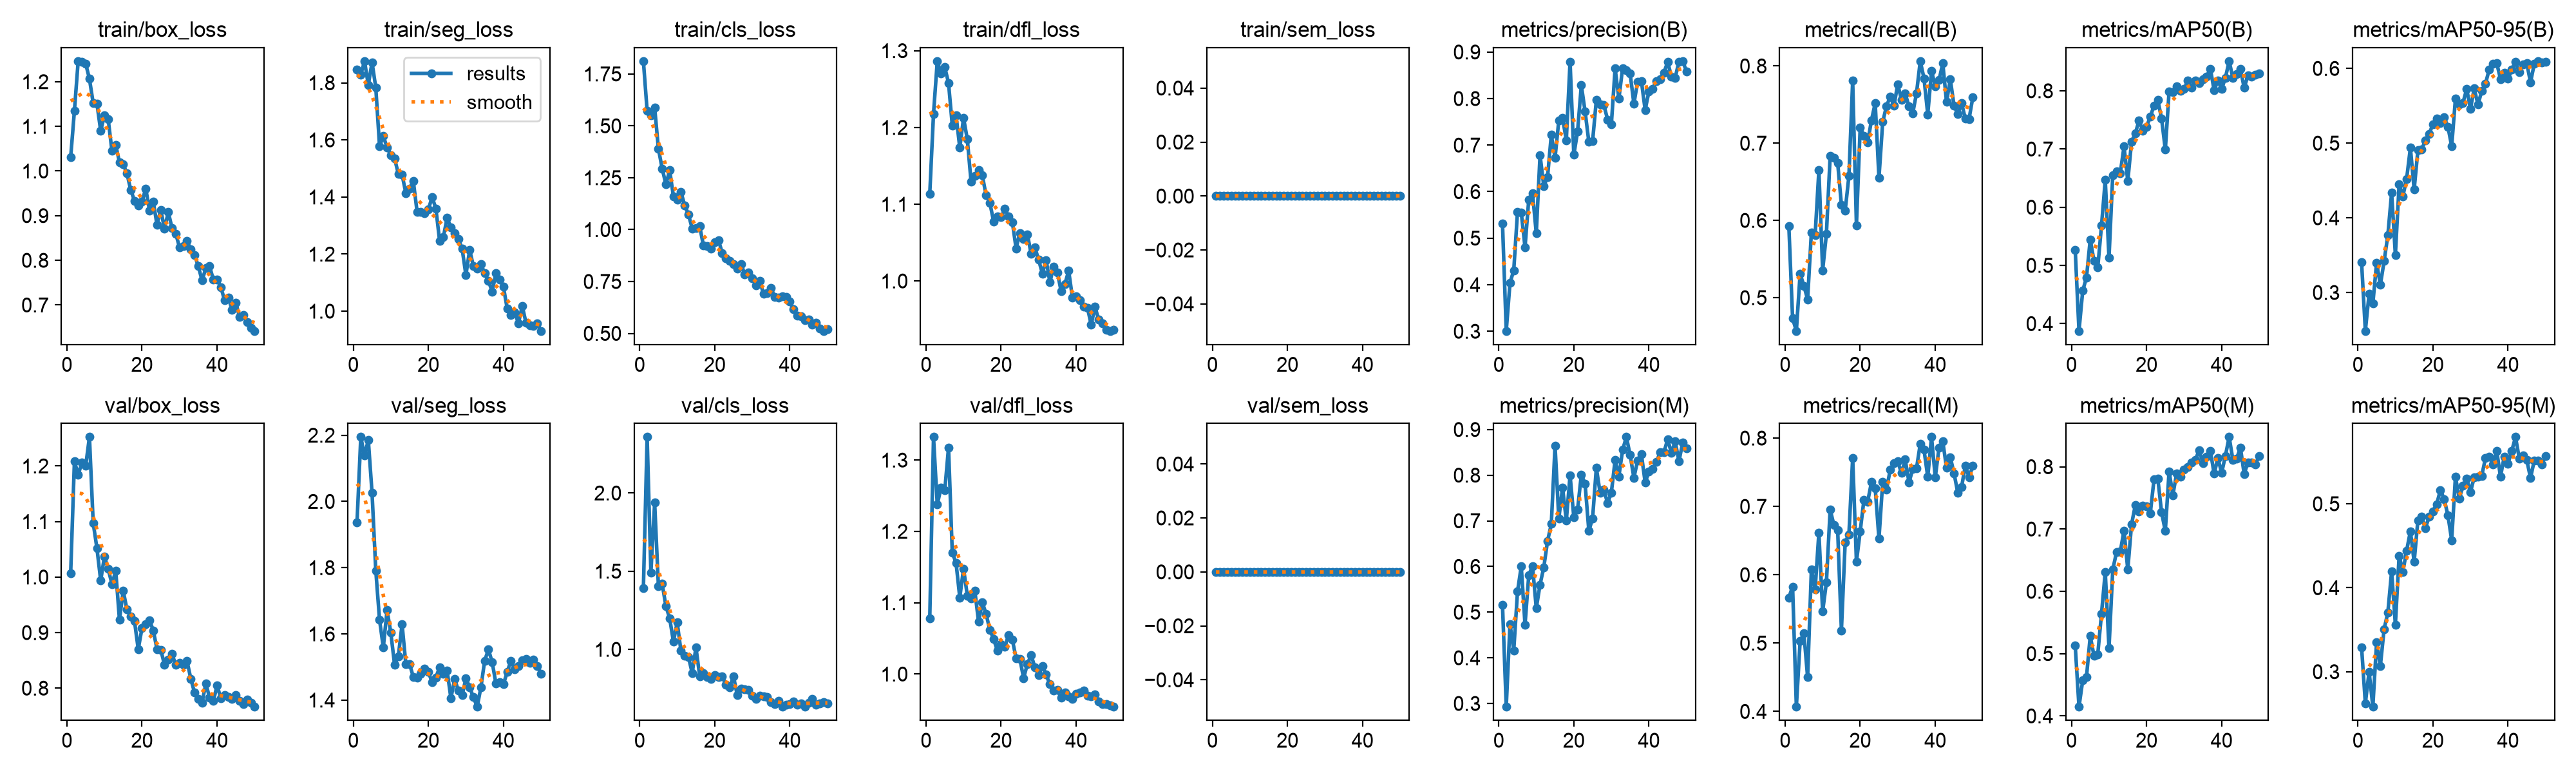
객체 탐지가 물체의 위치를 사각형 박스로 찾는 기술이라면, 세그멘테이션은 물체의 실제 윤곽을 픽셀 단위로 구분하는 기술이다.
93.[68일차] 자연어 처리 기초와 토큰화
자연어 처리(Natural Language Processing, NLP)는 컴퓨터가 사람이 사용하는 언어를 분석하고 이해하며 생성할 수 있게 만드는 인공지능 분야다. 컴퓨터는 문장을 그대로 이해하지 못하므로, 텍스트를 토큰(Token)으로 나누고 숫자 ID로 바꾸는 전
94.[68일차] 자연어 처리 기초와 토큰화
자연어 처리(Natural Language Processing, NLP)는 컴퓨터가 사람이 사용하는 언어를 분석하고 이해하며 생성할 수 있게 만드는 인공지능 분야다.
95.Malware Detection 정리
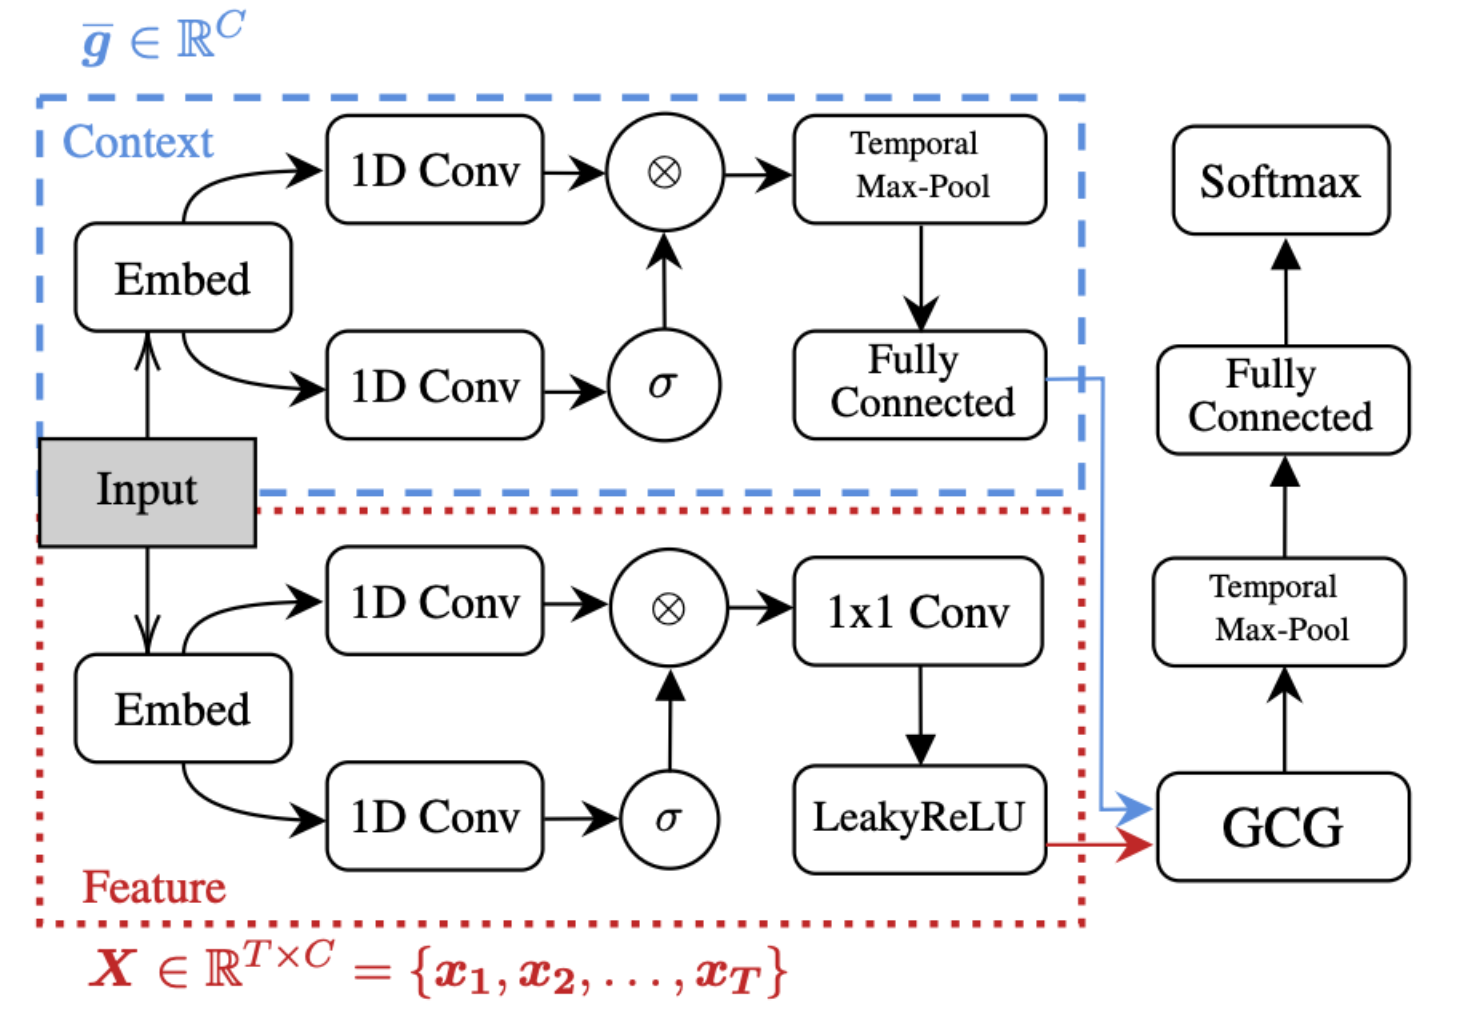
1. Project Overview (프로젝트 개요) 1.1 프로젝트 명과 개발 배경 | 항목 | 내용 | | ----------- | -----------------------------------------------------------...
96.[69일차] 텍스트 벡터화와 RNN 시계열 예측
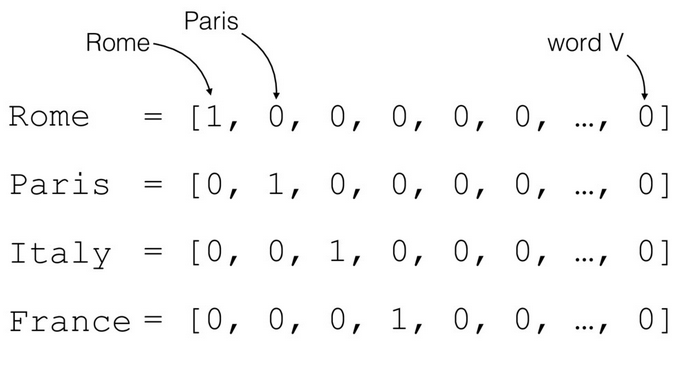
텍스트 벡터화와 워드 임베딩을 살펴보고, 순서가 중요한 데이터를 처리하는 RNN(Recurrent Neural Network)으로 다음 거래일의 KOSPI 종가를 예측한다. 1. 텍스트 벡터화 벡터화(Vectorization)는 텍스트를 머신러닝과 딥러닝 모델이 계산할 수 있는 숫자 벡터로 바꾸는 과정이다. 텍스트를 숫자로 표현하는 대표적인 방법은...
97.[70일차] LSTM, GRU와 트랜스포머의 Attention
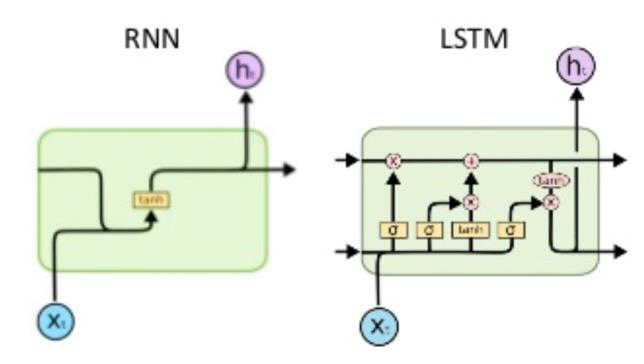
기본 RNN은 이전 시점의 정보를 hidden state에 담아 다음 시점으로 전달한다. 하지만 시퀀스가 길어지면 오래전 정보가 제대로 학습되지 않는 장기 의존성 문제가 발생할 수 있다. 이번에는 기본 RNN의 한계를 보완한 LSTM과 GRU를 살펴보고, 입력 시퀀스를 출력 시퀀스로 바꾸는 Seq2Seq, 필요한 정보에 직접 집중하는 Attention까...
98.[71일차] Transformer 구조와 AutoEncoder
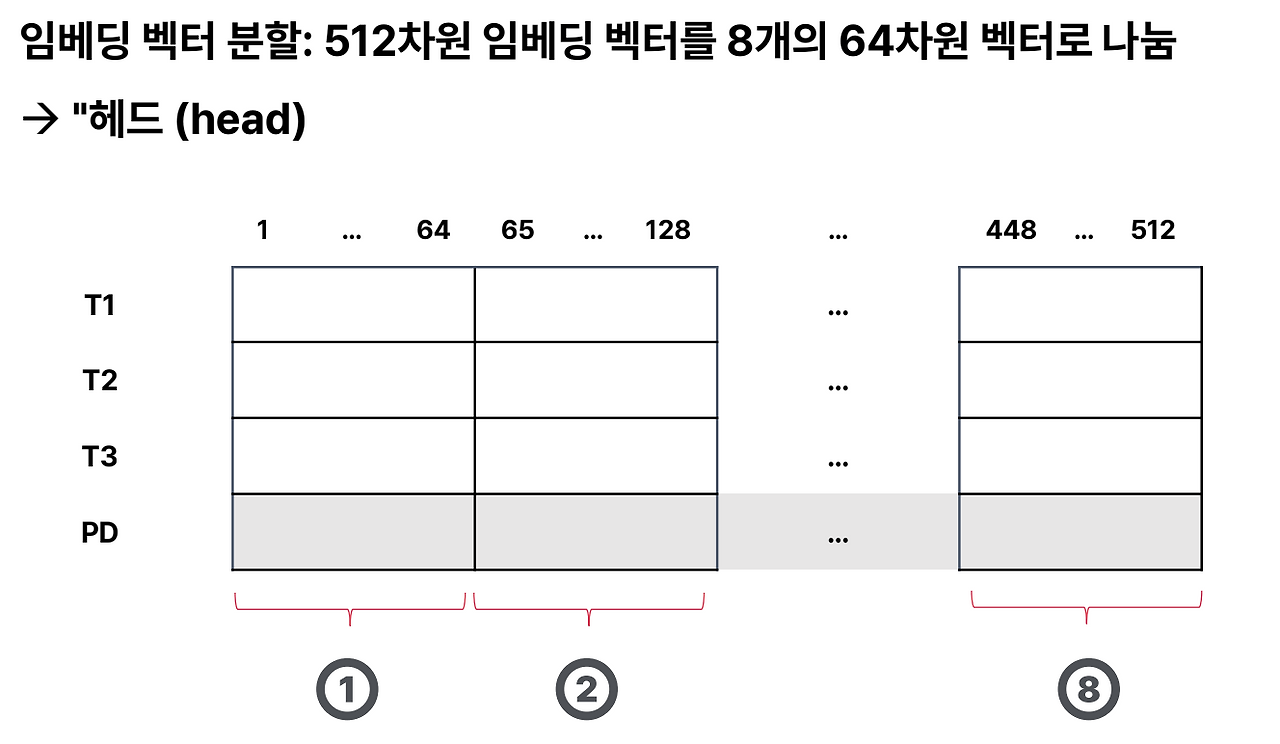
Transformer는 RNN처럼 Token을 순서대로 처리하지 않고, Attention을 이용해 시퀀스 전체의 관계를 한 번에 계산한다. AutoEncoder는 입력 데이터를 압축한 뒤 다시 복원하면서 데이터의 핵심 특징을 학습한다. 이번에는 Transformer의 Multi-Head Attention, 위치 정보, Encoder와 Decoder 구조를...
99.[72일차] Denoising AutoEncoder, VAE와 GAN
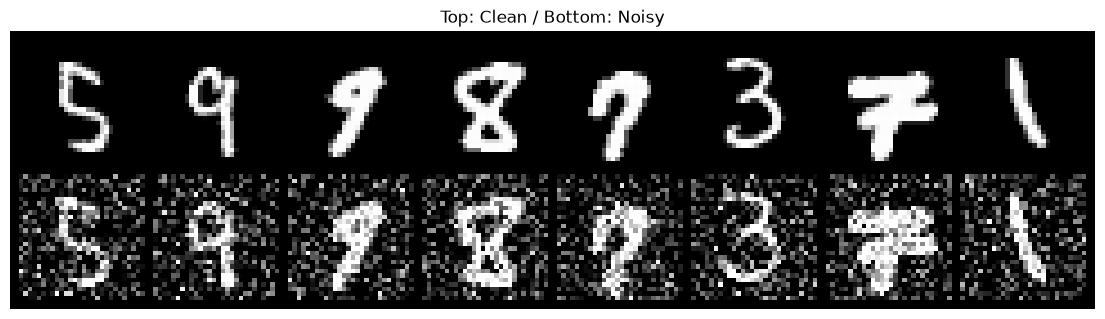
기본 AutoEncoder는 입력을 잠재 표현으로 바꾼 뒤 원본과 비슷하게 복원한다. 여기서 입력에 노이즈를 추가하거나 잠재 공간에 제약을 주면 다른 목적의 모델로 확장할 수 있다. 이번에는 Denoising AutoEncoder, Sparse AutoEncoder, VAE(Variational AutoEncoder)를 살펴본다. 이어서 생성자와 판별자가...
100.LSTM 논문 리뷰
LSTM 논문 리뷰 > Hochreiter, S. & Schmidhuber, J. (1997). > Long Short-Term Memory. Neural Computation, 9(8), 1735-1780.
101.LSTM 논문 과제
1. 기존 RNN에는 어떤 문제가 있었는가? 기존 RNN(Recurrent Neural Network)은 이전 시점의 은닉 상태를 다음 시점으로 전달하므로, 순서가 있는 데이터를 처리할 수 있다. 예를 들어 문장, 음성, 주가처럼 앞의 정보가 뒤의 결과에 영향을 주
102.[73일차] PLM과 KLUE-BERT 멀티라벨 분류
PLM(Pre-trained Language Model)은 대규모 텍스트로 언어의 일반적인 패턴을 먼저 학습한 모델이다. 학습이 끝난 PLM을 가져와 원하는 문제에 맞게 추가 학습하면 처음부터 모델을 만드는 것보다 적은 데이터와 시간으로 높은 성능을 얻을 수 있다. 이번에는 한국어 사전 학습 모델인 KLUE-BERT를 K-MHaS 데이터셋에 Fine-tu...
103.[74일차] Vision Transformer와 번호판 숫자 분류 준비
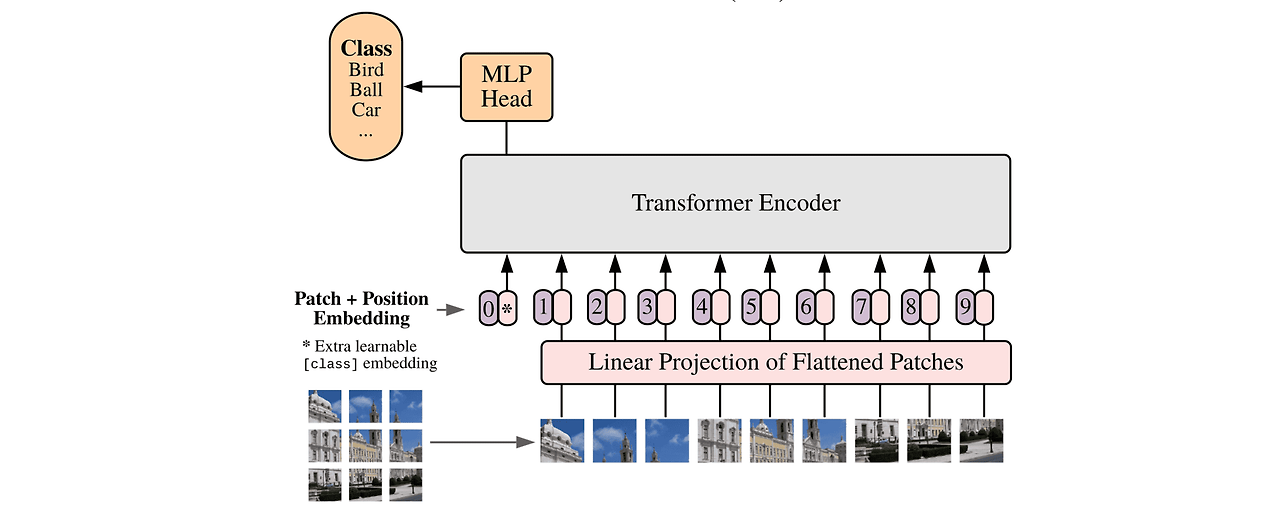
1. Vision Transformer란? Vision Transformer(ViT)는 자연어 처리에서 사용하던 Transformer 구조를 이미지 분류에 적용한 모델이다. Transformer는 문장을 여러 개의 토큰으로 나누어 처리한다. ViT는 이 아이디어를 이미지에 적용하여, 이미지를 작은 패치(patch)로 나눈 뒤 각 패치를 하나의 토큰처럼 ...
104.Attention Is All You Need 논문 리뷰
원 논문: Vaswani, A. et al. (2017). > Attention Is All You Need. NeurIPS 2017. 목차 Introduction Transformer: 무엇이 달라졌는가 Scaled Dot-Product Attention Mult
105.Attention Is All You Need 과제
1. 기존 RNN/LSTM과 Transformer의 차이 RNN과 LSTM은 시퀀스를 앞에서 뒤로 순서대로 처리한다. 즉, t번째 단어를 계산하려면 t-1번째의 은닉 상태가 먼저 준비되어야 한다. $$ ht = f(h{t-1}, x_t) $$ 이 방식은 단어 순서를 자연스럽게 반영한다는 장점이 있다. 반면 문장 전체를 동시에 계산할 수 없어서 학습 병...