1. 최단 경로 알고리즘이란?
최단 경로 알고리즘은 그래프에서 한 정점에서 다른 정점까지 이동할 때, 가장 적은 비용으로 이동하는 경로를 찾는 알고리즘이다.
여기서 비용은 거리, 시간, 요금, 위험도처럼 이동할 때 필요한 값을 의미한다. 예를 들어 지도 앱에서 현재 위치에서 목적지까지 가장 빠른 길을 찾는 기능도 최단 경로 알고리즘과 관련이 있다.
사용 예시
- 지도 앱에서 가장 빠른 길 찾기
- 지하철 또는 버스 환승 경로 찾기
- 네트워크에서 데이터가 가장 빠르게 이동하는 경로 찾기
- 게임에서 캐릭터가 목적지까지 이동하는 경로 찾기
- 물류 시스템에서 배송 비용이 가장 적은 경로 찾기
2. 다익스트라 알고리즘의 동작 원리
다익스트라 알고리즘은 하나의 시작 정점에서 다른 모든 정점까지의 최단 거리를 구하는 알고리즘이다.
단, 간선의 가중치가 음수가 아니어야 한다. 즉, 이동 비용이 0 이상인 그래프에서 사용할 수 있다.
동작 방식
- 시작 정점의 거리를 0으로 설정한다.
- 나머지 정점의 거리는 무한대(
INF)로 설정한다. - 아직 방문하지 않은 정점 중 최단 거리가 가장 짧은 정점을 선택한다.
- 선택한 정점과 연결된 정점들의 거리를 확인한다.
- 더 짧은 경로를 찾으면 최단 거리 값과 이전 정점을 갱신한다.
- 모든 정점을 확인할 때까지 반복한다.
3. 가중치(Graph Weight)란?
가중치(Weight)는 그래프에서 간선을 이동할 때 드는 비용을 의미한다.
그래프에서 정점은 장소나 대상을 의미하고, 간선은 정점 사이의 연결 관계를 의미한다. 이때 간선에 붙어 있는 숫자가 바로 가중치이다.
| 상황 | 정점 | 간선 | 가중치 |
|---|---|---|---|
| 지도 | 도시 | 도로 | 거리 또는 이동 시간 |
| 지하철 | 역 | 연결 구간 | 이동 시간 |
| 네트워크 | 컴퓨터 | 통신 경로 | 전송 시간 |
| 게임 | 위치 | 이동 가능 경로 | 이동 비용 |
4. BFS와 다익스트라 알고리즘의 차이점
| 비교 항목 | BFS | 다익스트라 알고리즘 |
|---|---|---|
| 사용하는 상황 | 모든 간선의 비용이 같은 그래프 | 간선마다 비용이 다른 가중치 그래프 |
| 기준 | 이동 횟수 | 이동 비용 |
| 자료구조 | 큐(Queue) | 우선순위 큐, 힙 |
| 가중치 처리 | 가중치 고려 불가 | 가중치 고려 가능 |
| 결과 | 최소 이동 횟수 | 최소 이동 비용 |
BFS는 모든 간선의 비용이 같을 때 사용할 수 있다. 하지만 길마다 이동 비용이 다르다면 단순히 적은 횟수로 이동하는 것이 가장 좋은 경로가 아닐 수 있다.
따라서 가중치가 있는 그래프에서는 다익스트라 알고리즘을 사용한다.
5. 우선순위 큐와 힙이 사용되는 이유
다익스트라 알고리즘에서는 현재까지 발견한 정점 중 최단 거리가 가장 짧은 정점을 먼저 선택해야 한다.
이때 우선순위 큐를 사용하면 거리가 가장 짧은 정점을 빠르게 꺼낼 수 있다. 파이썬에서는 heapq 모듈을 사용하여 최소 힙을 구현할 수 있다.
우선순위 큐 예시

삽입: (거리 7, 정점 3), (거리 2, 정점 2), (거리 5, 정점 4)

꺼내는 순서:
(거리 2, 정점 2) → (거리 5, 정점 4) → (거리 7, 정점 3)
6. 다익스트라 알고리즘의 시간복잡도
| 구현 방식 | 시간복잡도 | 설명 |
|---|---|---|
| heapq 사용 안 함 | O(V²) | 방문하지 않은 모든 정점을 매번 확인 |
| heapq 사용 | O((V + E) log V) | 우선순위 큐로 가장 짧은 정점을 빠르게 선택 |
V는 정점의 개수, E는 간선의 개수를 의미한다. 정점과 간선이 많아질수록 heapq를 사용하는 방식이 더 효율적이다.
7. 예시 그래프
아래 그래프를 사용하여 다익스트라 알고리즘을 구현한다.
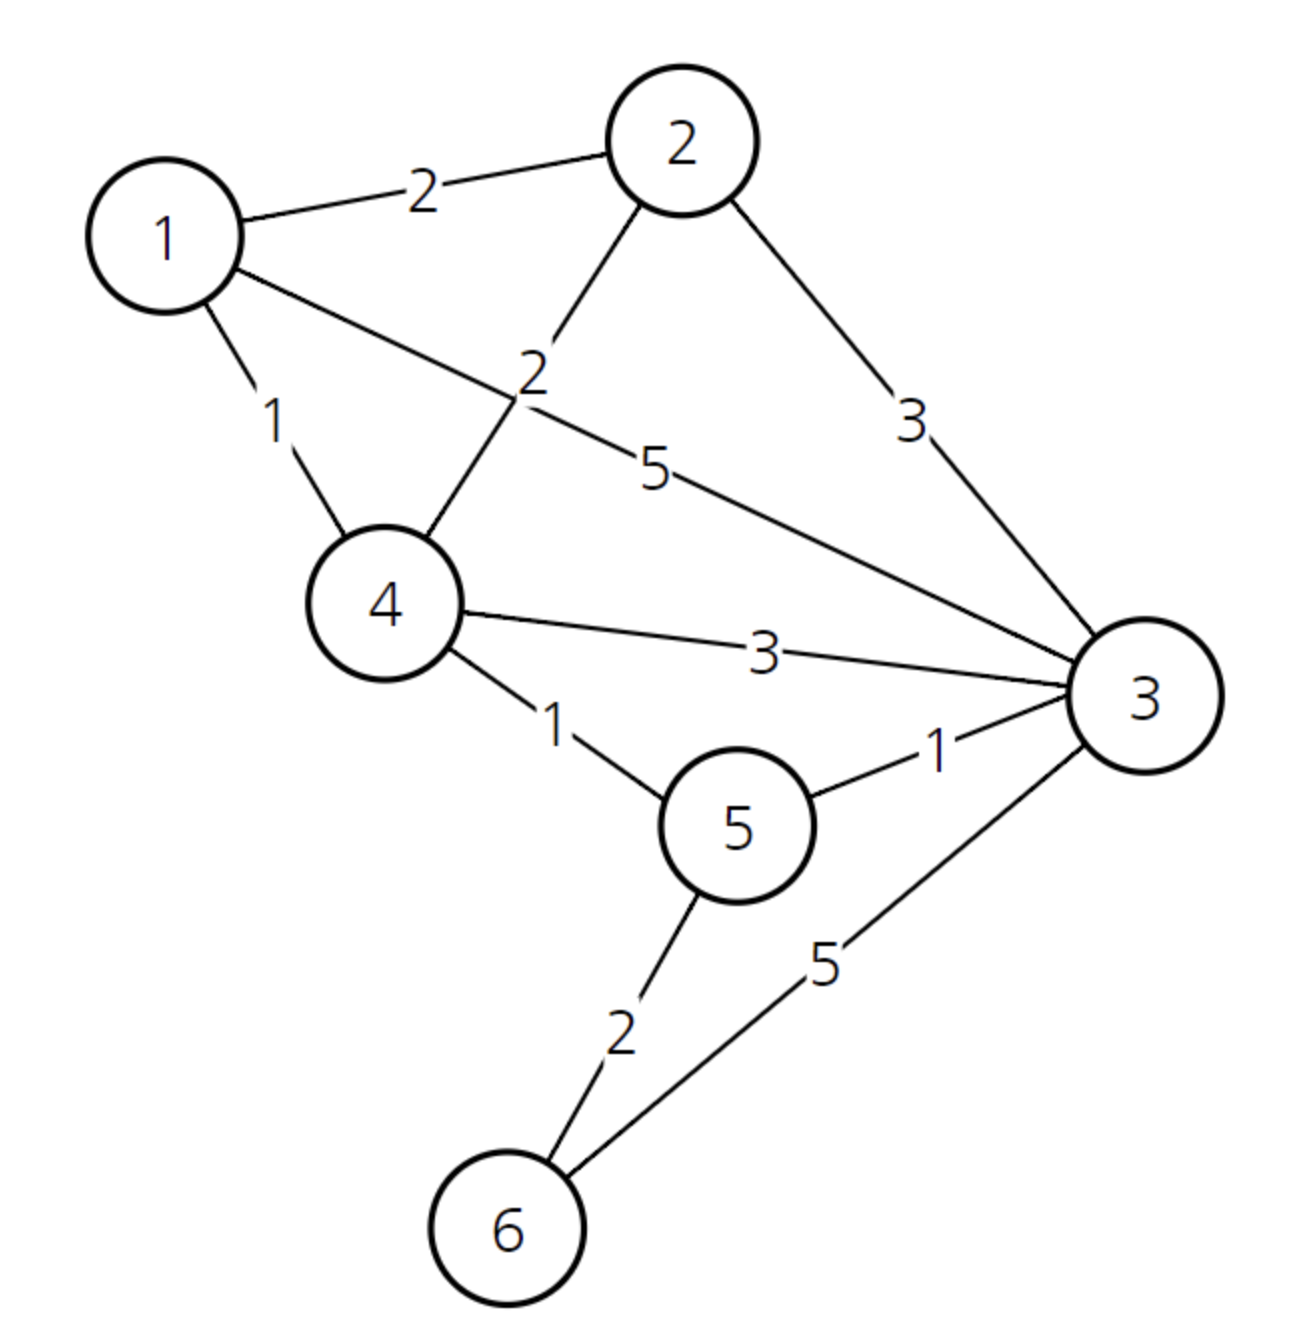
사진 속 그래프는 정점 1, 2, 3, 4, 5, 6으로 이루어진 가중치 그래프이다. 간선 위의 숫자는 두 정점 사이를 이동할 때 필요한 비용이다.
그래프 데이터
graph = {
    1: {2: 2, 3: 5, 4: 1},
    2: {1: 2, 3: 3, 4: 2},
    3: {1: 5, 2: 3, 4: 3, 5: 1, 6: 5},
    4: {1: 1, 2: 2, 3: 3, 5: 1},
    5: {3: 1, 4: 1, 6: 2},
    6: {3: 5, 5: 2}
}
이 그래프에서 정점 1을 시작 정점으로 두고, 정점 1에서 다른 모든 정점까지의 최단 거리와 실제 이동 경로를 구한다.
8. heapq를 사용한 다익스트라 구현
import heapq


def dijkstra_heapq(start, graph):
    distances = {_: float("inf") for _ in graph}
    distances[start] = 0
    path = {_: None for _ in graph}
    hq = []
    heapq.heappush(hq, (distances[start], start))

    while hq:
        cur_distance, cur_node = heapq.heappop(hq)

        if cur_distance > distances[cur_node]:
            continue
        for next_node, weight in graph[cur_node].items():
            new_distance = cur_distance + weight

            if distances[next_node] > new_distance:
                distances[next_node] = new_distance
                path[next_node] = cur_node
                heapq.heappush(hq, (new_distance, next_node))

    return distances, path
9. 최단 경로 출력 함수
def get_path(path, start, end):
    actual_path = []
    cur = end

    while cur is not None:
        actual_path.append(cur)
        cur = path[cur]

    actual_path.reverse()

    if actual_path[0] == start:
        return actual_path

    return 0
10. 실행 코드
graph = {
    1: {2: 2, 3: 5, 4: 1},
    2: {1: 2, 3: 3, 4: 2},
    3: {1: 5, 2: 3, 4: 3, 5: 1, 6: 5},
    4: {1: 1, 2: 2, 3: 3, 5: 1},
    5: {3: 1, 4: 1, 6: 2},
    6: {3: 5, 5: 2}
}

def print_shortest_paths(start, distances, path):
    print(f"\n[{start}번 정점에서 각 정점까지의 최단 거리]")

    for node in distances:
        actual_path = get_path(path, start, node)
        path_text = " -> ".join(map(str, actual_path))

        print(f"{start} -> {node}")
        print(f"최단 거리: {distances[node]}")
        print(f"이동 경로: {path_text}")
        print()


start = 1
distances, path = dijkstra_heapq(start, graph)
print_shortest_paths(start, distances, path)
실행 결과
1 -> 1
최단 거리: 0
이동 경로: 1

1 -> 2
최단 거리: 2
이동 경로: 1 -> 2

1 -> 3
최단 거리: 3
이동 경로: 1 -> 4 -> 5 -> 3

1 -> 4
최단 거리: 1
이동 경로: 1 -> 4

1 -> 5
최단 거리: 2
이동 경로: 1 -> 4 -> 5

1 -> 6
최단 거리: 4
이동 경로: 1 -> 4 -> 5 -> 6
11. heapq를 사용하지 않은 방식
def get_node(distances, visited):
    min_distance = float("inf")
    min_node = None

    for node in distances:
        if node not in visited and distances[node] < min_distance:
            min_distance = distances[node]
            min_node = node

    return min_node


def dijkstra(start, graph):
    distances = {_: float("inf") for _ in graph}
    path = {_: None for _ in graph}
    visited = set()
    distances[start] = 0

    while len(visited) < len(graph):
        cur_node = get_node(distances, visited)

        if cur_node is None:
            break

        visited.add(cur_node)

        for next_node, weight in graph[cur_node].items():
            new_distance = distances[cur_node] + weight

            if distances[next_node] > new_distance:
                path[next_node] = cur_node
                distances[next_node] = new_distance

    return distances, path
12. heapq 방식과 heapq를 사용하지 않은 방식 비교
| 비교 항목 | heapq 사용 | heapq 사용 안 함 |
|---|---|---|
| 최단 정점 선택 방식 | 힙에서 가장 짧은 거리의 정점 꺼냄 | 모든 정점을 반복해서 확인 |
| 시간복잡도 | O((V + E) log V) | O(V²) |
| 구현 난이도 | 조금 더 복잡함 | 상대적으로 단순함 |
| 큰 그래프 성능 | 좋음 | 느려질 수 있음 |
| 사용하기 좋은 상황 | 정점과 간선이 많은 그래프 | 정점 수가 적은 간단한 그래프 |
성능 비교 코드
dijkstra.py에서는 하나의 작은 그래프만 비교하지 않고, 노드 수와 간선 수가 다른 테스트 그래프를 만들어 성능을 비교한다.
@timer 데코레이터는 함수의 실행 결과와 실행 시간을 함께 반환한다.
import time


def timer(func):
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)
        end_time = time.time()
        elapsed_time = end_time - start_time

        return result, elapsed_time

    return wrapper


@timer
def run_dijkstra_heapq(start, graph):
    return dijkstra_heapq(start, graph)


@timer
def run_dijkstra(start, graph):
    return dijkstra(start, graph)
테스트 그래프 생성 함수
def make_test_graph(node_count, edge_count):
    graph = {node: {} for node in range(1, node_count + 1)}

    # 모든 노드가 연결되도록 먼저 일자 형태의 기본 간선을 만든다.
    for node in range(1, node_count):
        weight = (node % 9) + 1
        graph[node][node + 1] = weight
        graph[node + 1][node] = weight

    current_edges = node_count - 1
    from_node = 1
    to_node = 3

    # 원하는 간선 개수까지 규칙적으로 간선을 추가한다.
    while current_edges < edge_count:
        if from_node != to_node and to_node not in graph[from_node]:
            weight = ((from_node * 3 + to_node * 5) % 9) + 1
            graph[from_node][to_node] = weight
            graph[to_node][from_node] = weight
            current_edges += 1

        to_node += 1
        if to_node > node_count:
            from_node += 1
            to_node = from_node + 2

        if from_node > node_count:
            break

    return graph
노드/간선 개수별 성능 비교 함수
def compare_performance_by_size():
    test_cases = [
        (10, 15),
        (100, 300),
        (1000, 300),
        (10000, 30000),
        (100000, 300000)
    ]

    print("\n[노드/간선 개수별 성능 비교]")
    print("노드 수 | 간선 수 | heapq 사용 | heapq 미사용")
    print("-" * 48)

    for node_count, edge_count in test_cases:
        graph = make_test_graph(node_count, edge_count)
        start = 1

        _, heapq_time = run_dijkstra_heapq(start, graph)
        _, normal_time = run_dijkstra(start, graph)

        print(
            f"{node_count:>6} | "
            f"{edge_count:>6} | "
            f"{heapq_time:.8f}초 | "
            f"{normal_time:.8f}초"
)make_test_graph()는 모든 노드가 서로 이어진 그래프가 되도록 먼저 1-2-3-... 형태의 기본 간선을 만든다.
따라서 입력한 edge_count가 node_count - 1보다 작더라도 실제 그래프에는 최소 node_count - 1개의 간선이 들어간다.
출력 예시
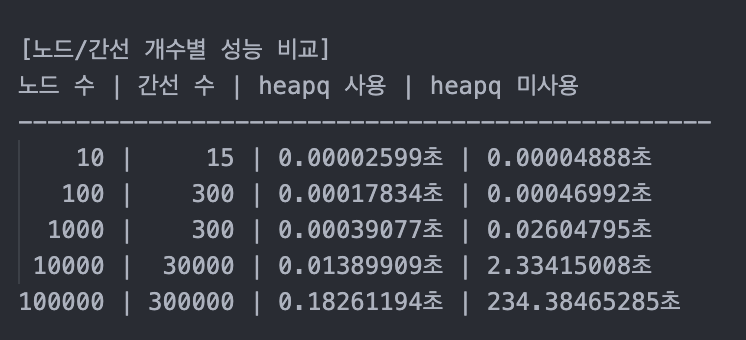
실행 시간은 컴퓨터 상태나 실행 환경에 따라 매번 달라진다.
특히 노드 수가 큰 경우 heapq를 사용하지 않는 방식은 시간이 오래 걸릴 수 있다.
데코레이터를 사용한 이유
- 실행 시간 측정 코드를 함수마다 반복해서 작성하지 않아도 된다.
- 알고리즘 함수의 내부 코드를 건드리지 않고 성능을 측정할 수 있다.
- 여러 함수의 실행 시간을 같은 형식으로 비교할 수 있다.
작은 그래프에서는 실행 시간이 너무 짧아서 차이가 크게 보이지 않을 수 있다. 하지만 노드와 간선이 많아질수록 heapq를 사용하는 방식이 더 효율적이다.
13. main 함수
def main():
    graph = get_graph()
    start = 1

    distances, path = dijkstra_heapq(start, graph)
    print_shortest_paths(start, distances, path)

    compare_performance_by_size()


if __name__ == "__main__":
    main()
main() 함수는 먼저 예시 그래프에서 정점 1 기준 최단 거리와 이동 경로를 출력한다.
그 다음 노드 수와 간선 수가 다른 그래프들을 만들어 heapq 방식과 일반 방식을 비교한다.
정리
다익스트라 알고리즘은 가중치가 있는 그래프에서 시작 정점으로부터 다른 모든 정점까지의 최단 거리를 구하는 알고리즘이다.
BFS는 모든 간선의 비용이 같을 때 사용할 수 있지만, 다익스트라는 간선마다 비용이 다른 그래프에서 사용할 수 있다.
다익스트라 알고리즘은 최단 거리가 가장 짧은 정점을 반복해서 선택해야 하므로 우선순위 큐와 힙을 사용하면 효율적이다. 파이썬에서는 heapq를 사용하여 우선순위 큐를 구현할 수 있다.
