AI models collapse when trained on recursively generated data
Shumailov, I., Shumaylov, Z., Zhao, Y., Papernot, N., Anderson, R., & Gal, Y. (2024). AI models collapse when trained on recursively generated data. Nature, 631(8022), 755-759.
초록
모델이 생성한 데이터를 다음 세대 모델의 학습에 무분별하게 사용하면, 원래 데이터 분포의 꼬리가 사라지고 분포 재현 능력이 저하됨. -> 모델 붕괴(model collapse).
LLM, VAE, GMM에서 이 현상 확인. 이론적 분석과 실험을 통해 재귀적 학습에서 오차가 누적되는 과정 설명. -> 실제 인간이 생성한 데이터에 대한 접근을 유지하는 것이 중요.
서론
현재 LLM은 주로 인간이 생성한 텍스트로 학습되었지만, 향후 웹에서 수집하는 데이터에는 이전 LLM이 생성한 콘텐츠가 대량 포함될 수 있음.
연구 질문: 이전 모델이 생성한 데이터가 후속 모델의 학습 데이터 대부분을 구성하면, 세대를 거치면서 어떤 일이 발생하는가?
모델이 생성한 데이터로 반복 학습 -> 실제 기저 분포에 관한 정보 손실. 발생 확률이 낮은 사건부터 사라지고, 이후 학습된 분포가 매우 작은 분산을 가진 점 추정치로 수렴. 시간에 따른 실제 데이터 분포 변화가 없어도 발생함.
함수 추정 오차가 없는 이상적인 조건에서도 발생 가능. 기존의 catastrophic forgetting, data poisoning과 관련은 있지만, 설정이 달라 동일한 현상으로 설명하기는 어려움.
-> 인터넷에 LLM 생성 콘텐츠가 확산되면 후속 모델의 학습 데이터가 오염될 수 있음. 원래 데이터, 실제 인간과 시스템 간 상호작용 데이터의 가치 증가.
모델 붕괴란 무엇인가?
모델 붕괴: 생성 모델이 만든 데이터가 다음 세대의 학습 데이터를 오염시키고, 이를 학습한 모델이 실제 분포를 잘못 인식하게 되는 퇴행적 과정.
• 초기 모델 붕괴: 분포의 꼬리, 즉 발생 확률이 낮은 사건에 관한 정보 손실.
• 후기 모델 붕괴: 원래 분포와 거의 닮지 않은 분포로 수렴. 대체로 분산이 크게 감소함.
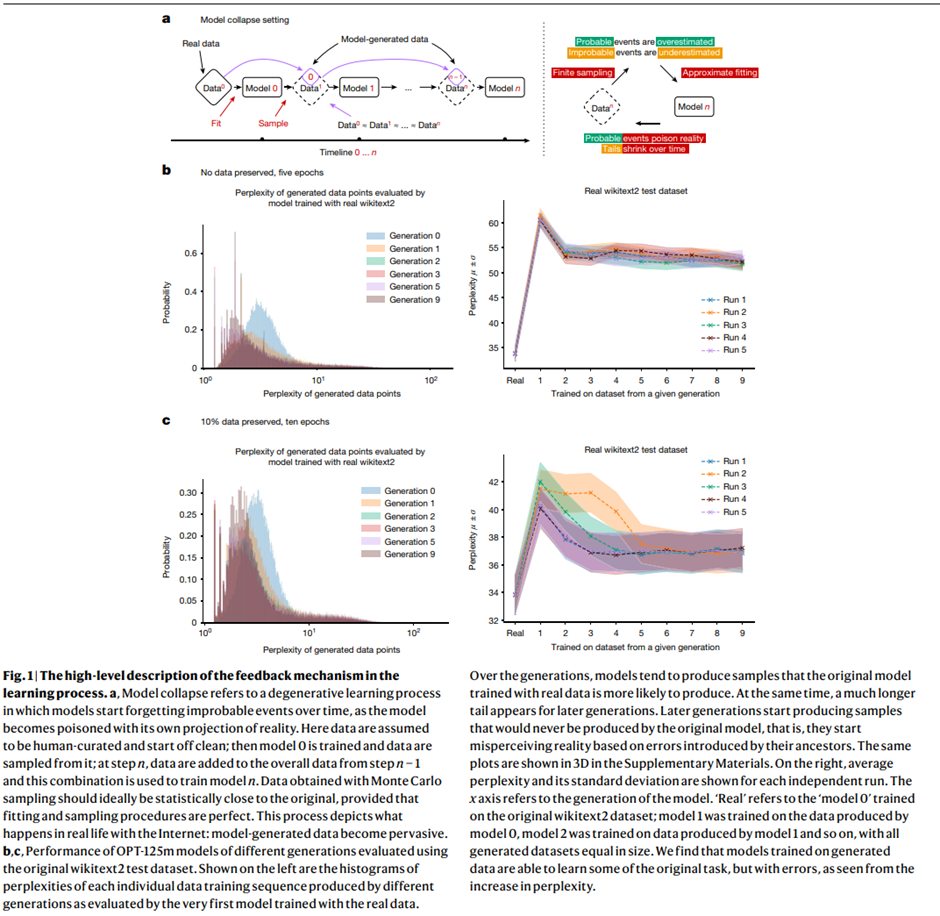
a: 모델 붕괴 과정 / b: 원래 데이터 미보존 / c: 원래 데이터 10% 보존
• a: 실제 데이터로 모델 학습 -> 모델에서 데이터 생성 -> 다음 세대 학습에 사용. 유한 표집과 근사 적합이 반복되면서 발생 확률이 높은 사건은 과대평가되고, 낮은 사건은 과소평가됨. -> 꼬리 축소.
• b: 원래 데이터를 보존하지 않고 5 에포크씩 학습. 후속 세대에서 생성 분포 변화와 실제 테스트 데이터에 대한 성능 저하 나타남.
• c: 원래 데이터의 10%를 보존하고 10 에포크씩 학습. 분포 변화는 나타나지만 성능 저하는 상대적으로 작음.
• 왼쪽: 최초 모델로 평가한 생성 시퀀스의 perplexity 분포. 후속 세대는 낮은 perplexity의 시퀀스에 집중하면서, 동시에 높은 perplexity의 긴 꼬리도 생성함.
• 오른쪽: 실제 wikitext2 테스트 데이터에 대한 평균 perplexity와 표준편차. 낮을수록 좋은 성능. 각 조건을 서로 다른 seed로 5회 실행함.
모델 붕괴를 일으키는 오차:
• 통계적 근사 오차: 표본 수가 유한하여 재표집할 때마다 정보가 손실될 수 있음. 표본 수가 무한대로 가면 사라짐.
• 함수 표현력 오차: 모델이 실제 분포를 표현할 능력이 제한됨. 예: 두 Gaussian의 혼합을 하나의 Gaussian으로 적합 -> 무한한 데이터가 있어도 정확한 표현 불가능.
• 함수 근사 오차: 학습 절차의 한계에서 발생. 예: SGD의 구조적 편향, 목적함수 선택. 무한한 데이터와 충분한 표현력이 있어도 발생 가능.
모델 표현력이 높아지면 통계적 잡음을 상쇄할 수도 있지만, 잡음을 더 잘 학습하여 오차를 누적시킬 수도 있음. -> 개별 오차가 결합하면서 전체 분포의 이탈 증가.
이론적 직관
이전 세대가 생성한 데이터로 재귀적으로 학습하는 생성 모델에서 모델 붕괴가 발생하는 과정 분석. 이산분포와 다차원 Gaussian을 사용하며, 더 복잡한 설정은 보충자료에서 다룸.
세대별 학습 과정: 현재 데이터의 분포를 모델로 근사 -> 모델에서 표집하여 다음 세대 데이터 생성.
다음 세대 데이터는 원래 데이터, 이전 세대가 사용한 데이터, 새 모델이 생성한 데이터를 혼합할 수 있음. 다만 이론 분석에서는 직전 모델이 생성한 데이터만 사용하는 경우를 고려함.
정확한 근사가 이루어지는 이산분포
모델이 분포를 완벽하게 표현하고 근사해도, 유한 표집만으로 모델 붕괴 발생 가능.
표본 수가 M일 때 확률이 q≤1/M인 사건의 기대 표본 수는 1이하. -> 희귀한 사건은 표집되지 않을 수 있으며, 반복하면서 분포의 지지집합 축소.
이 과정을 Markov chain으로 보면, 모든 표본이 동일한 값을 가지는 상태가 흡수 상태가 됨. -> 결국 확률 1로 특정 상태의 delta function에 수렴. 해당 상태에 도달할 확률은 원래 분포에서 그 상태가 갖는 확률과 같음.
-> 초기에는 희귀 사건 소실, 후기에는 하나의 모드로 붕괴. 완벽한 함수 근사만으로 이를 방지할 수 없음.
다차원 Gaussian
고정된 표본 수를 사용하여 이전 세대의 불편 표본평균과 표본분산으로 Gaussian을 반복 적합.
세대 수가 무한대로 증가하면:
• 원래 분포와 근사 분포 사이의 기대 제곱 Wasserstein-2 거리가 무한대로 증가.
• 공분산은 확률 1로 0에 수렴.
-> 분포의 위치는 원래 분포에서 크게 벗어날 수 있으면서, 분포 자체는 분산 0으로 붕괴함. 초기 분포가 반드시 Gaussian일 필요는 없음.
언어 모델에서의 모델 붕괴
GMM, VAE는 보통 처음부터 학습하지만, LLM은 비용 때문에 사전학습 모델을 파인튜닝하는 경우가 많음. -> 다른 모델이 생성한 데이터로 순차적으로 파인튜닝해도 모델 붕괴가 발생하는지 평가.
각 세대의 학습은 사전학습 모델에서 시작함. 이전 세대의 파인튜닝 모델이 생성한 데이터를 다음 세대의 파인튜닝에 사용.
실험 설정
OPT-125m을 wikitext2 데이터셋으로 파인튜닝.
학습 데이터를 64토큰씩 나누고, 각 블록을 입력으로 다음 64토큰 생성. Beam search의 폭은 5. 원래 학습 데이터 전체를 순회하여 동일한 크기의 합성 데이터셋 구성.
실제 데이터로 파인튜닝한 모델의 평균 perplexity: 115(zero-shot) -> 34. 각 실험은 서로 다른 seed로 5회 실행. 원래 검증 데이터에서 가장 성능이 좋은 모델을 후속 세대의 기본 모델로 사용함.
비교 조건:
• 5 에포크, 원래 데이터 미보존: 후속 세대는 생성 데이터로 학습. 원래 과제의 일부를 학습하지만 성능 저하가 큼.
• 10 에포크, 원래 데이터 10% 보존: 매 세대 원래 데이터의 10%를 무작위로 표집하여 포함. 성능 저하가 상대적으로 작음.
두 조건 모두 생성 데이터로 과제의 일부를 학습할 수 있지만, 실제 데이터로 학습한 모델보다 성능 저하 나타남.
세대가 진행될수록 원래 모델이 높은 확률로 생성할 시퀀스에 집중. -> 출력 다양성 축소. 동시에 원래 모델이 거의 생성하지 않을 시퀀스도 나타남. -> 세대별 학습에서 누적된 오차.
여기서 원래 데이터 분포의 희귀 사건 소실과 생성 시퀀스의 높은 perplexity 꼬리 증가는 다른 의미임. 후자는 실제 분포의 다양성을 보존한 결과가 아니라, 모델이 새로운 오류를 생성한 결과.
이론은 주로 세대 수가 무한대로 가는 경우를 다루지만, 실험은 유한한 세대만 평가함. 완전한 붕괴의 발생 여부와 속도는 문제에 따라 다르며, 몇 세대만으로도 원래 분포에서 상당히 벗어날 수 있음.
출력 예시(Example 1)
교회 건축에 관한 동일한 입력을 제공.
• 세대 0–1: 건축 관련 내용을 생성하지만 사실 오류와 불완전한 문장 포함.
• 세대 5: 여러 언어를 나열하는 내용으로 이탈.
• 세대 9: 서로 다른 색의 꼬리를 가진 jackrabbit을 반복 나열.
-> 세대를 거치면서 입력 맥락에서 벗어나고 반복적·부정확한 출력 생성.
반복에 대한 Ablation Study
생성 데이터에 반복 구절이 많아, 반복 자체가 모델 붕괴의 원인인지 확인. 반복 페널티를 2.0으로 설정하여 반복되지 않는 출력 유도.
반복을 피하기 위해 점수가 낮은 후속 시퀀스를 생성 -> 후속 모델의 성능이 더 나빠짐. 해당 실험에서 perplexity는 원래 대비 두 배로 증가.
-> 반복을 억제해도 모델 붕괴가 해결되지 않음. 미세조정 역시 모델 붕괴를 막지 못함.
Discussion
Click farm, content farm, troll farm처럼 검색·추천 알고리즘을 오도하는 데이터 오염은 기존에도 존재했음. LLM의 등장으로 달라지는 것은 이러한 오염을 자동화할 수 있는 규모.
발생 확률이 낮은 사건은 소외된 집단과 관련되는 경우가 많음. -> 이를 모델링하는 능력을 보존하는 것은 예측의 공정성과 복잡한 시스템 이해에 중요.
다른 생성 모델의 표본으로 학습 -> 분포 변화 누적 -> 모델 붕괴 -> 기저 과제에 대한 잘못된 학습. 따라서 모델 학습에는 오염 전 데이터에 접근할 수 있는 선발자 우위(first mover advantage)가 있을 수 있음.
장기적으로 학습을 유지하려면 원래 데이터 출처에 대한 접근을 보존하고, LLM이 생성하지 않은 데이터를 계속 확보해야 함.
LLM 생성 콘텐츠를 대규모로 추적하는 방법은 불분명. 개발·배포 주체 간 출처 정보 공유와 협력이 한 가지 방안.
-> 기술 확산 이전에 수집한 데이터나 실제 인간이 생성한 대규모 데이터에 접근하지 못하면, 향후 새로운 LLM을 학습시키기가 점점 어려워질 수 있음.