[Python] 전처리 2주차 숙제
iris 데이터셋
Q1. 'species' 열 값이 'setosa'인 데이터 선택하기
코드import seaborn as sns
iris_data = sns.load_dataset('iris')
#iris_data
#iris[iris['species']=='setosa']
setosa_data = iris_data.loc[iris_data['species'] == 'setosa']
print("Setosa 데이터:")
print(setosa_data.head())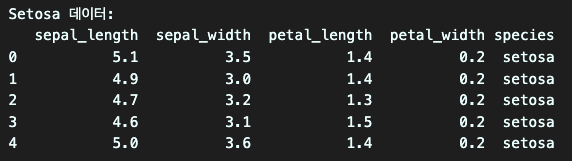
Q2. 10부터 20까지의 행과 1부터 3까지의 열 선택하기
코드# 10부터 20까지의 행과 1부터 3까지의 열 선택하기
subset = iris.iloc[10:21, 1:4]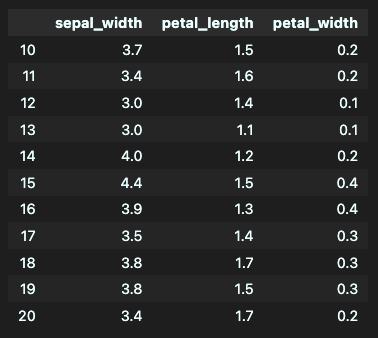
tips 데이터셋
Q1. total_bill이 30 이상인 데이터만 선택하기
코드# 1 total_bill 이 30 이상인 데이터만 선택하기
over_30 = tips_data[tips_data['total_bill'] >= 30]
over_30.head()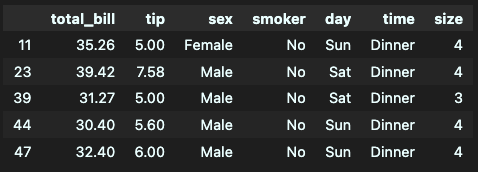
Q2. 성별을 기준으로 데이터 그룹화하여 팁(tip)의 평균 계산
코드# 2. 성별('sex')을 기준으로 데이터 그룹화하여 팁(tip)의 평균 계산
tip_avg = tips_data.groupby('sex')['tip'].mean()
tip_avg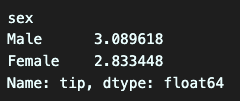
Q3. 'day' 와 'time'을 기준으로 데이터 그룹화하여 전체 지불 금액(total_bill)의 합 계산
코드# 3. 'day'와 'time' 을 기준으로 데이터 그룹화하여 전체 지불 금액(total_bill)의 합 계산
sum_total_bill = tips_data.groupby(['day', 'time'])['total_bill'].sum()
print("\n요일과 시간별 전체 지불 금액 합계:")
print(sum_total_bill)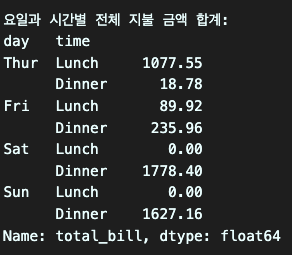
Q4. 'day' 열을 기준으로 각 요일별로 팁의 평균을 새로운 데이터프레임으로 만든 후, 이를 기존의 tip 데이터셋에 합치기
코드
# 'day'열을 기준으로 각 요일별로 팁'tip'의 평균을 새로운 데이터프레임으로 만든 후,
# 이를 기존의 tip 데이터셋에 합쳐보자

tip_groupby_day = tips_data.groupby('day')['tip'].mean().reset_index()
tip_groupby_day.columns = ['day', 'avg_tip']
tip_groupby_day

merged_data = pd.merge(tips_data, tip_groupby_day, on='day', how='left')
print("\n병합된 데이터")
print(merged_data)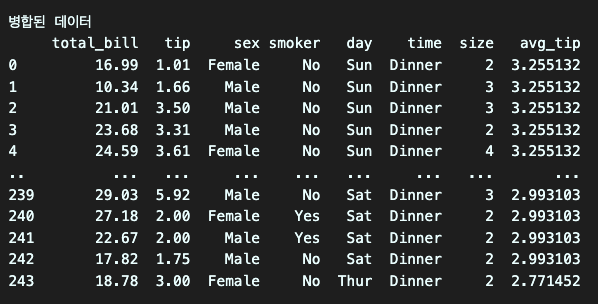
데이터 애널리스트가 되고 싶은