상품 목록이나 상품 상세처럼 같은 데이터를 반복해서 조회하는 API가 모든 요청마다 DB에 접근하면 불필요한 조회가 계속 발생합니다.
캐시는 이런 반복 조회 데이터를 더 빠른 저장소에 임시로 보관하여 응답 속도를 높이고 DB 접근을 줄이는 기술입니다. 캐시에 데이터가 있으면 바로 반환하고(Cache Hit), 없다면 DB에서 조회한 뒤 캐시에 저장합니다(Cache Miss).
캐시는 DB 대신 사용하는 저장소가 아니다
캐시는 카페의 원두 선반처럼 생각하면 이해하기 쉽습니다.
모든 원두를 지하 창고(DB)에 보관하면 안전하지만, 주문이 들어올 때마다 지하까지 내려가야 합니다. 그래서 자주 사용하는 원두만 카운터 옆 선반(Cache)에 올려둡니다.
선반에 원하는 원두가 있음
→ Cache Hit
→ 바로 사용

선반에 원하는 원두가 없음
→ Cache Miss
→ 창고에서 가져옴
→ 선반에도 올려둠DB가 정확한 원본 데이터를 담당한다면, 캐시는 빠르게 꺼내 쓰기 위한 임시 복사본에 가깝습니다. 따라서 캐시가 없어져도 DB에서 다시 데이터를 만들 수 있어야 합니다.
로컬 캐시와 분산 캐시
| 구분 | 로컬 캐시 | 분산 캐시 |
|---|---|---|
| 예시 | Caffeine | Redis |
| 저장 위치 | 애플리케이션 내부 메모리 | 별도 서버 |
| 장점 | 네트워크 통신이 없어 빠름 | 여러 서버가 같은 캐시 공유 가능 |
| 한계 | 서버마다 서로 다른 캐시를 가짐 | 네트워크 통신 필요 |
Caffeine은 어플리케이션 내부에 저장하는 로컬 캐시이고, Redis는 여러 서버가 공유할 수 있는 분산 캐시입니다.
최근에 진행했던 커머스 프로젝트에서는 Caffeine을 사용했습니다.
Spring Cache를 이용한 캐싱 구조
Spring Cache는 캐시 저장소 자체가 아닙니다.
Caffeine이나 Redis 같은 구현체를 직접 다루는 대신, 캐싱 동작을 @Cacheable, @CacheEvict, @CachePut 등의 어노테이션으로 선언할 수 있도록 제공하는 캐시 추상화 계층입니다.
@Cacheable / @CacheEvict
          ↓
     Spring Cache
          ↓
     CacheManager
          ↓
       Caffeine
메뉴판 옆에 붙이는 스티커처럼 생각할 수 있습니다.
@Cacheable
→ "이 메서드는 캐시부터 확인"

@CacheEvict
→ "데이터가 바뀌었으니 기존 캐시 삭제"
프로젝트 설정
build.gradle에는 Spring Cache와 Caffeine 의존성이 추가되어 있습니다.
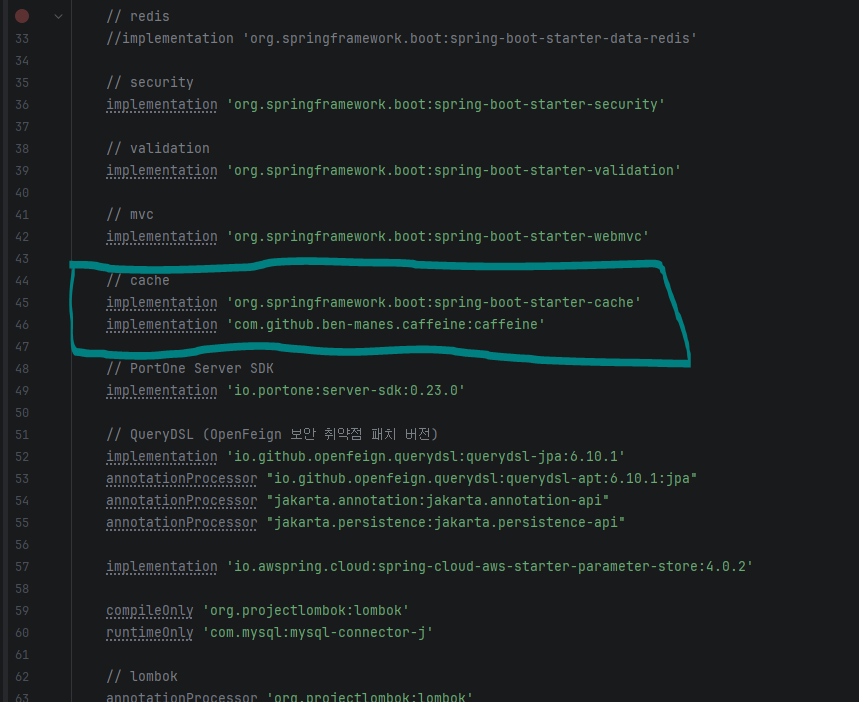
Spring Cache와 Caffeine 의존성 추가
Spring의 캐시 추상화가 실제 로컬 캐시 구현체인 Caffeine을 함께 사용한 설정.
그리고 어플리케이션에는 캐시 기능을 활성화하는 @EnableCachin이 설정되어 있습니다.
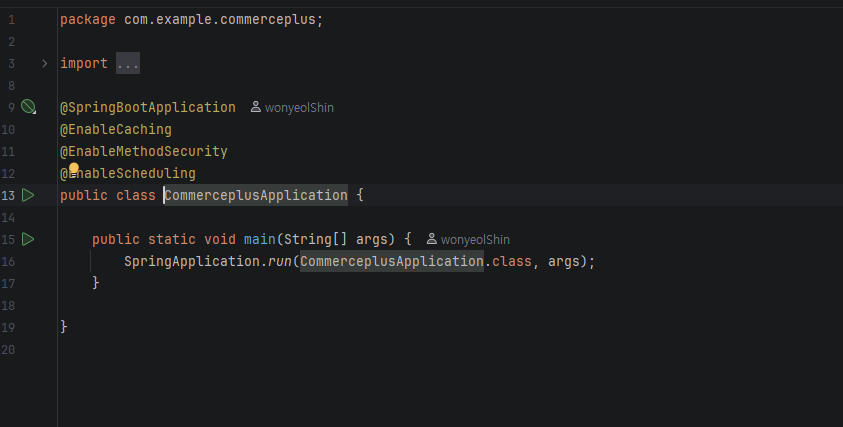
@EnableCaching을 통한 Spring Cache 활성화
캐시 관련 어노테이션을 Spring이 처리할 수 있도록 캐싱 기능을 활성화한 부분.
@EnableCaching이 없다면 @Cacheable등을 붙여도 캐싱 기능이 활성화되지 않습니다.
상품 조회 결과를 캐시에 저장하기
프로젝트에서는 캐시 적용 여부를 비교할 수 있도록 상품 조회 API를 분리했습니다.
GET /products
→ 일반 조회

GET /products/cache
→ 캐시 적용 조회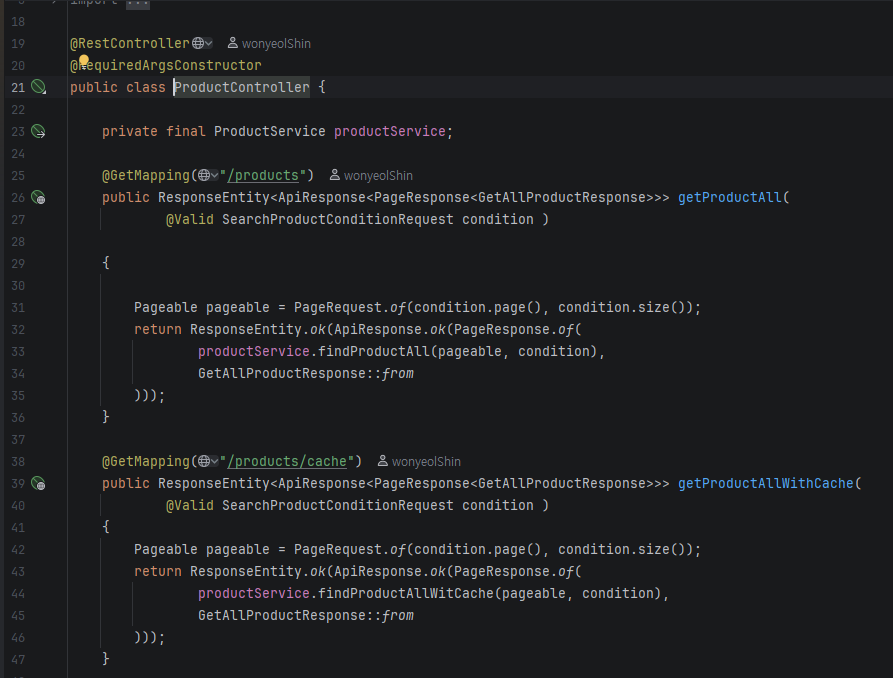
캐시 적용 전·후 상품 조회 API 분리
동일한 상품 조회 기능을 일반 조회와 캐시 적용 조회로 분리하여 비교할 수 있도록 구성한 Controller.
실제 캐싱은 ProductService의 조회 메서드에 적용되어 있습니다.
@Cacheable(
    value = "product_condition",
    key = "#condition.getCacheKey()"
)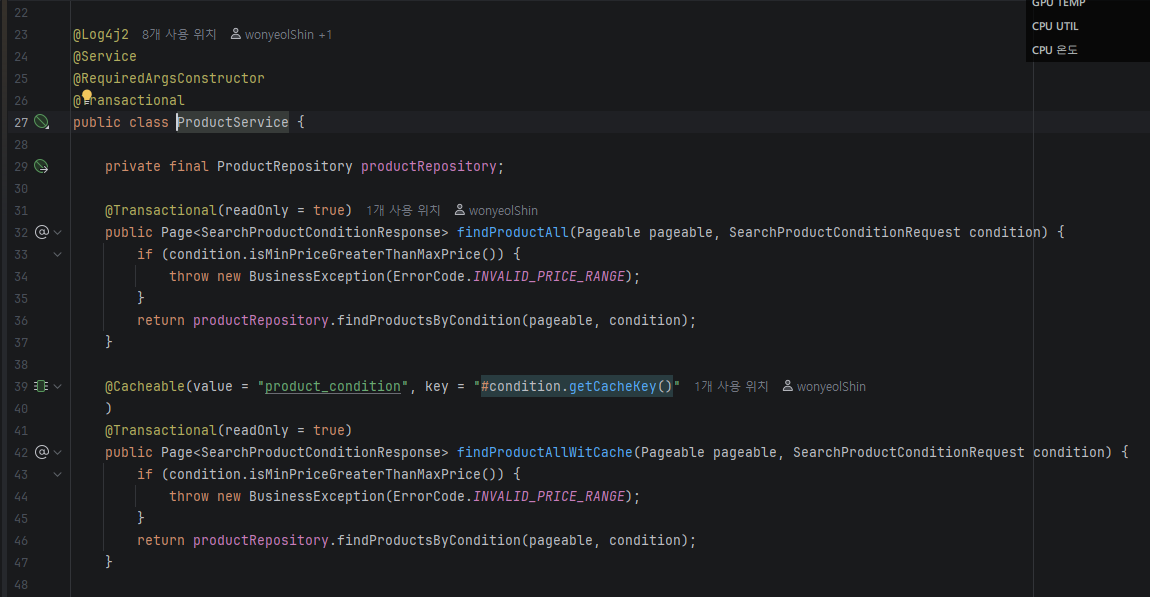
상품 조건 조회에 @Cacheable 적용
동일한 검색 조건으로 다시 조회할 경우 DB 대신 캐시의 결과를 사용할 수 있도록 적용한 부분.
@Cacheable은 최초 요청에서는 메서드를 실행하여 결과를 캐시에 저장하고, 이후 동일한 Key가 존재하면 메서드 실행 대신 캐시 값을 반환합니다.
흐름은 다음과 같습니다.
상품 조회
   ↓
캐시 확인
   ↓
┌ Cache Hit ─────────→ 바로 반환
│
└ Cache Miss
       ↓
     DB 조회
       ↓
    결과 캐싱
       ↓
      반환
검색 조건마다 다른 Key가 필요한 이유
상품 목록은 같은 API를 호출하더라도 검색 조건에 따라 결과가 달라집니다.
예를 들어 다음 두 요청은 서로 다른 결과입니다.
1페이지 / 1만원~5만원 / FOOD
1페이지 / 가격 제한 없음 / 전체 카테고리
따라서 프로젝트에서는 SearchProductConditionRequest#getCacheKey()에서 검색 조건을 조합하여 Key를 만들었습니다.
page:size:minPrice:maxPrice:category예:
0:9:10000:50000:FOOD
0:9:null:null:ALL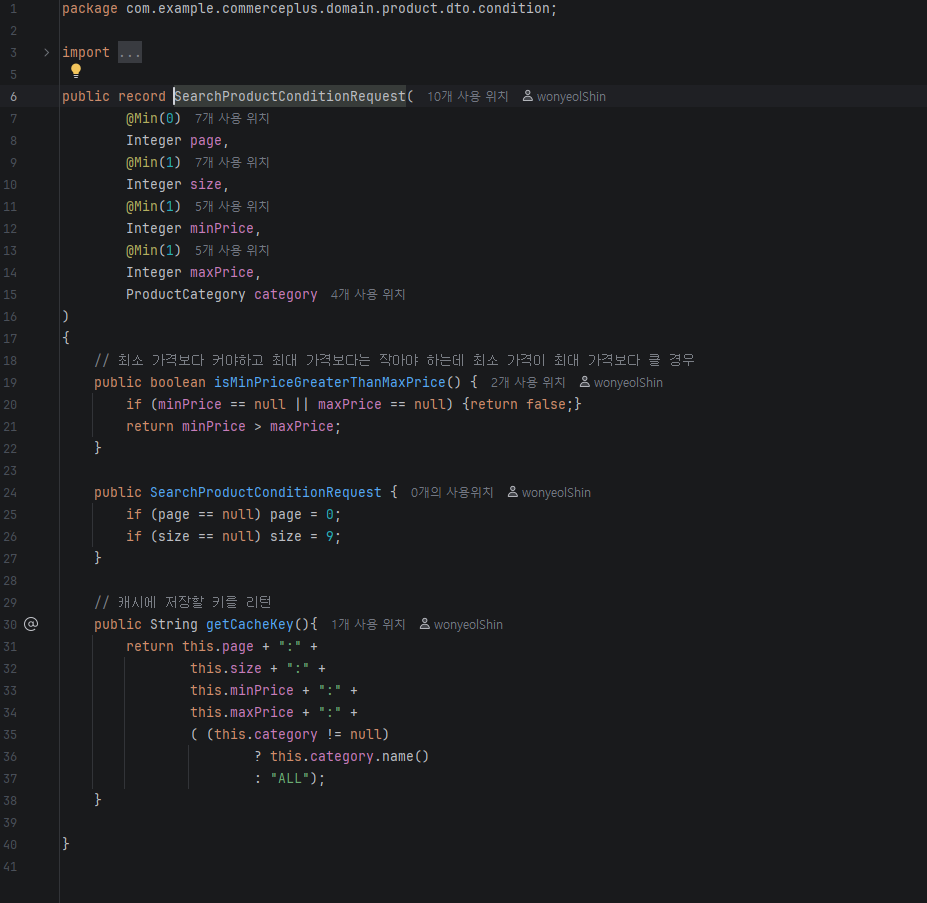
검색 조건을 조합한 캐시 Key 생성
페이지, 크기, 가격, 범위, 카테고리를 조합해 서로 다른 조회 조건이 같은 캐시 데이터를 사용하지 않도록 구분한 부분.
Spring Cache 에서 value는 캐비닛 이름, key는 그 안의 서류 번호처럼 볼 수 있습니다.
Key가 충돌하면 전혀 다른 요청이 같은 캐시 값을 사용할 수 있기 때문에 Key 설계가 매우 중요합니다.
빠르게 조회하는 것보다 어려운 문제: 오래된 캐시
캐시를 적용하면 새로운 문제가 생깁니다.
DB 상품 가격 = 20,000원

Cache 상품 가격 = 15,000원
DB를 수정했는데 캐시를 그대로 두면 사용자는 예전 데이터를 받을 수 있습니다. 이것이 캐시 일관성 문제입니다.
프로젝트에서는 두 가지 방식으로 이 문제를 줄이고 있었습니다.
TTL
application.yaml:
maximumSize=100
expireAfterWrite=300s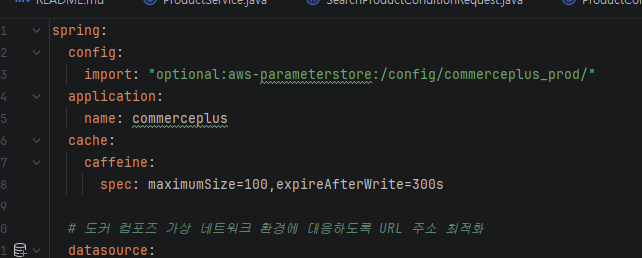
Catteine 캐시 최대 크기와 TTL 설정
캐시를 최대 100개까지 보관하고, 저장한 후 300초가 지나면 만료하도록 설정.
즉, 원두 선반에:
"이 원두는 5분 뒤 버리고 새것으로 교체한다."
라는 유통기한을 붙인 셈입니다.
TTL이 너무 짧으면 캐시 활용도가 떨어지고, 너무 길면 오래된 데이터가 남을 가능성이 높아집니다.
캐시 무효화
상품이 수정되면 updateProduct()에서 기존 검색 캐시를 삭제합니다.
@CacheEvict(
    value = "product_condition",
    allEntries = true
)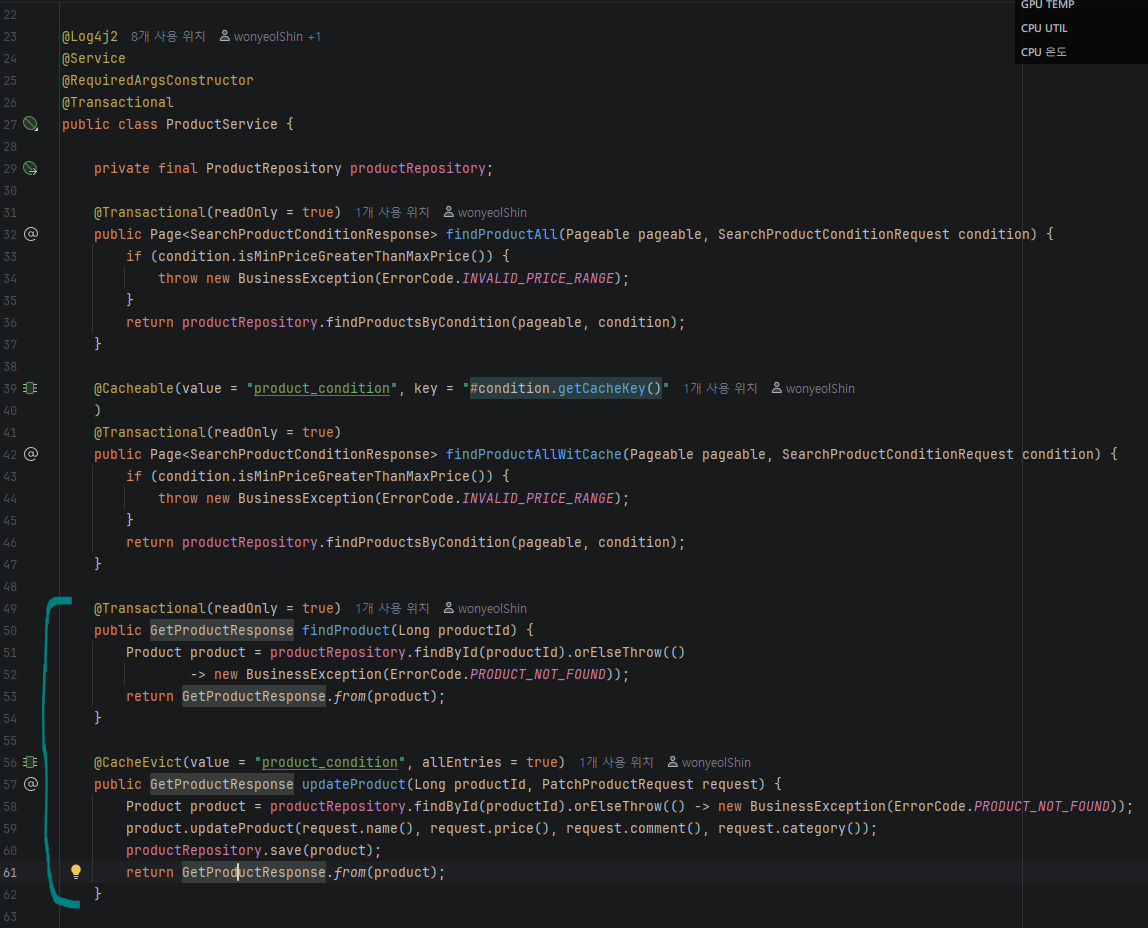
상품 수정 시 @CacheEvict로 캐시 무효화
상품 정보가 변경된 뒤 이전 검색 결과가 남지 않도록 product_condition 캐시를 제거한 부분.
상품 수정
   ↓
DB 변경
   ↓
기존 상품 검색 캐시 삭제
   ↓
다음 조회는 DB에서 최신 값 조회
   ↓
새 캐시 생성@CacheEvict는 캐시 데이터를 삭제하는 역할을 합니다.
따라서 캐시는 단순히 저장하는 것보다 다음 네 가지를 함께 생각해야 합니다.
무엇을 저장할까?
어떤 Key로 구분할까?
얼마나 오래 보관할까??
원본이 바뀌면 언제 버릴까?
적용 결과와 다시 확인한 부분
README에서는 캐시 적용 전·후 상품 조회 응답 시간을 비교했습니다.
| 반복 조회 | 캐시 미적용 | Caffeine 적용 |
|---|---|---|
| 1회차 | 651ms | 508ms |
| 2회차 | 66ms | 25ms |
| 3회차 | 35ms | 6ms |
프로젝트의 로컬 테스트 환경에서는 반복 조회가 진행되면서 35ms → 65ms까지 감소한 결과를 확인했습니다.
이는 특정 환경에서 측정한 결과이므로 Caffeien 자체의 일반적인 성능 수치로 볼 수는 없지만, Cache Hit 가 발생했을 때 반복적인 DB 접근을 줄일 수 있다는 점을 확인하는 데 의미가 있습니다.
코드를 다시 보며 확인한 점
현재 @CacheEvict는 updateProduct()에서 확인됩니다.
따라서 실제 서비스에서는 상품과 관련된 다른 변경 경로에서도 기존 캐시가 오래 남을 가능성이 없는지 확인해야 합니다.
특히 캐시 설계에서 중요한 기준은:
조회가 많고 변경이 적은 데이터를 우선 캐싱한다.
캐시는 모든 데이터를 무조건 넣는 저장소가 아니라, 데이터의 조회 빈도·변경 빈도·오래된 값이 반환되었을 때의 영향을 고려해 적용해야 합니다.
마무리
캐시는 단순히 데이터를 메모리에 넣어 조회 속도를 높이는 기술이 아닙니다.
이번 상품 조회 코드를 다시 확인하면서 캐싱에는 다음 과정이 함께 필요하다는 것을 정리할 수 있었습니다.
조회 결과 저장
   ↓
검색 조건별 Key 구분
   ↓
TTL로 유효기간 설정
   ↓
원본 변경 시 캐시 무효화
Spring Cache는 이런 캐시 로직을 비즈니스 코드에 직접 작성하지 않고
@Cacheable, @CacheEvict 같은 어노테이션으로 선언할 수 있게 해줍니다.
이번 프로젝트에서는 Caffeine 로컬 캐시를 사용했습니다. 다음 단계에서는 같은 캐싱 목적을 Redis 분산 캐시로 직접 적용해보고, 서버 내부에 존재하는 로컬 캐시와 여러 서버가 공유하는 분산 캐시의 차이를 코드와 실행 결과로 비교해볼 예정입니다.